

Krok Table Extract
Służy do wyodrębniania danych z istniejącej tabeli danych Analyze do innej tabeli danych. Przykłady obejmują między innymi:
- Sortowanie
- Grupowanie
- Podsumowywanie
- Filtrowanie/wybór podzbioru wierszy
- Usuwanie zbędnych kolumn
- Operacje matematyczne
- Operacje na ciągach znaków
Parametry ekstrakcji
Dział zatytułowany „Parametry ekstrakcji”Źródło i cel
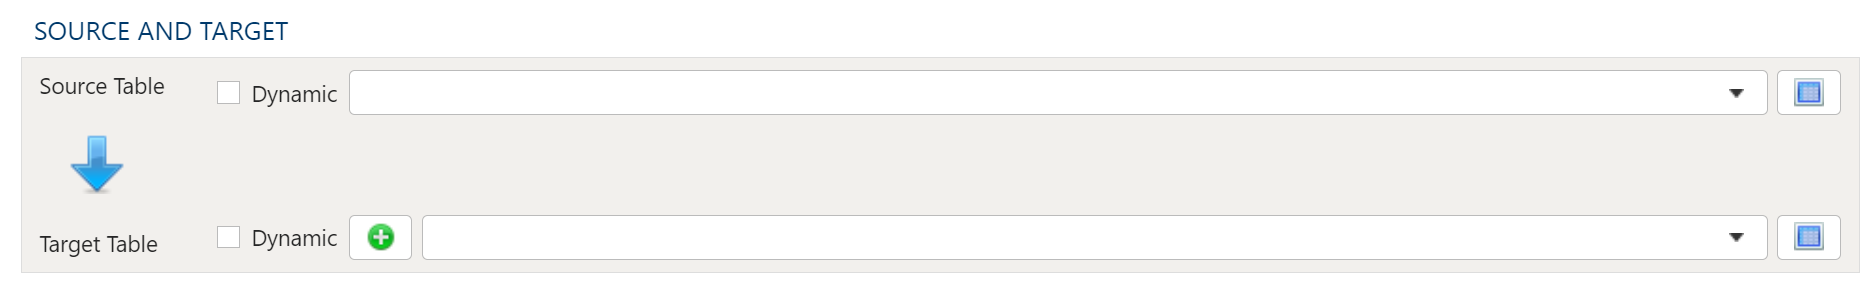
Aby określić tabelę źródłową i docelową, najpierw wybierz tabelę danych, z której nastąpi wyodrębnienie, za pomocą menu rozwijanego Tabela źródłowa. Następnie wybierz istniejącą tabelę jako tabelę docelową za pomocą menu rozwijanego Tabela docelowa albo kliknij zielony znak „+“, aby utworzyć nową tabelę docelową.
Tworzenie tabeli
Podczas tworzenia nowej tabeli możesz utworzyć ją jako Widok lub jako Tabelę.
Widoki:
Zaletą widoków jest to, że czas wykonania kroku jest znacznie krótszy niż w przypadku tabeli. Wadą widoków jest to, że nie nadają się do eksploracji danych w trybie szczegółów tabeli.
Tabele:
Gdy celem jest tabela, krok wykonuje się dłużej, ale eksploracja danych w trybie szczegółów jest znacznie szybsza niż w przypadku widoku.
Wybór danych tabeli
Dział zatytułowany „Wybór danych tabeli”Konfiguracja Data Mapper
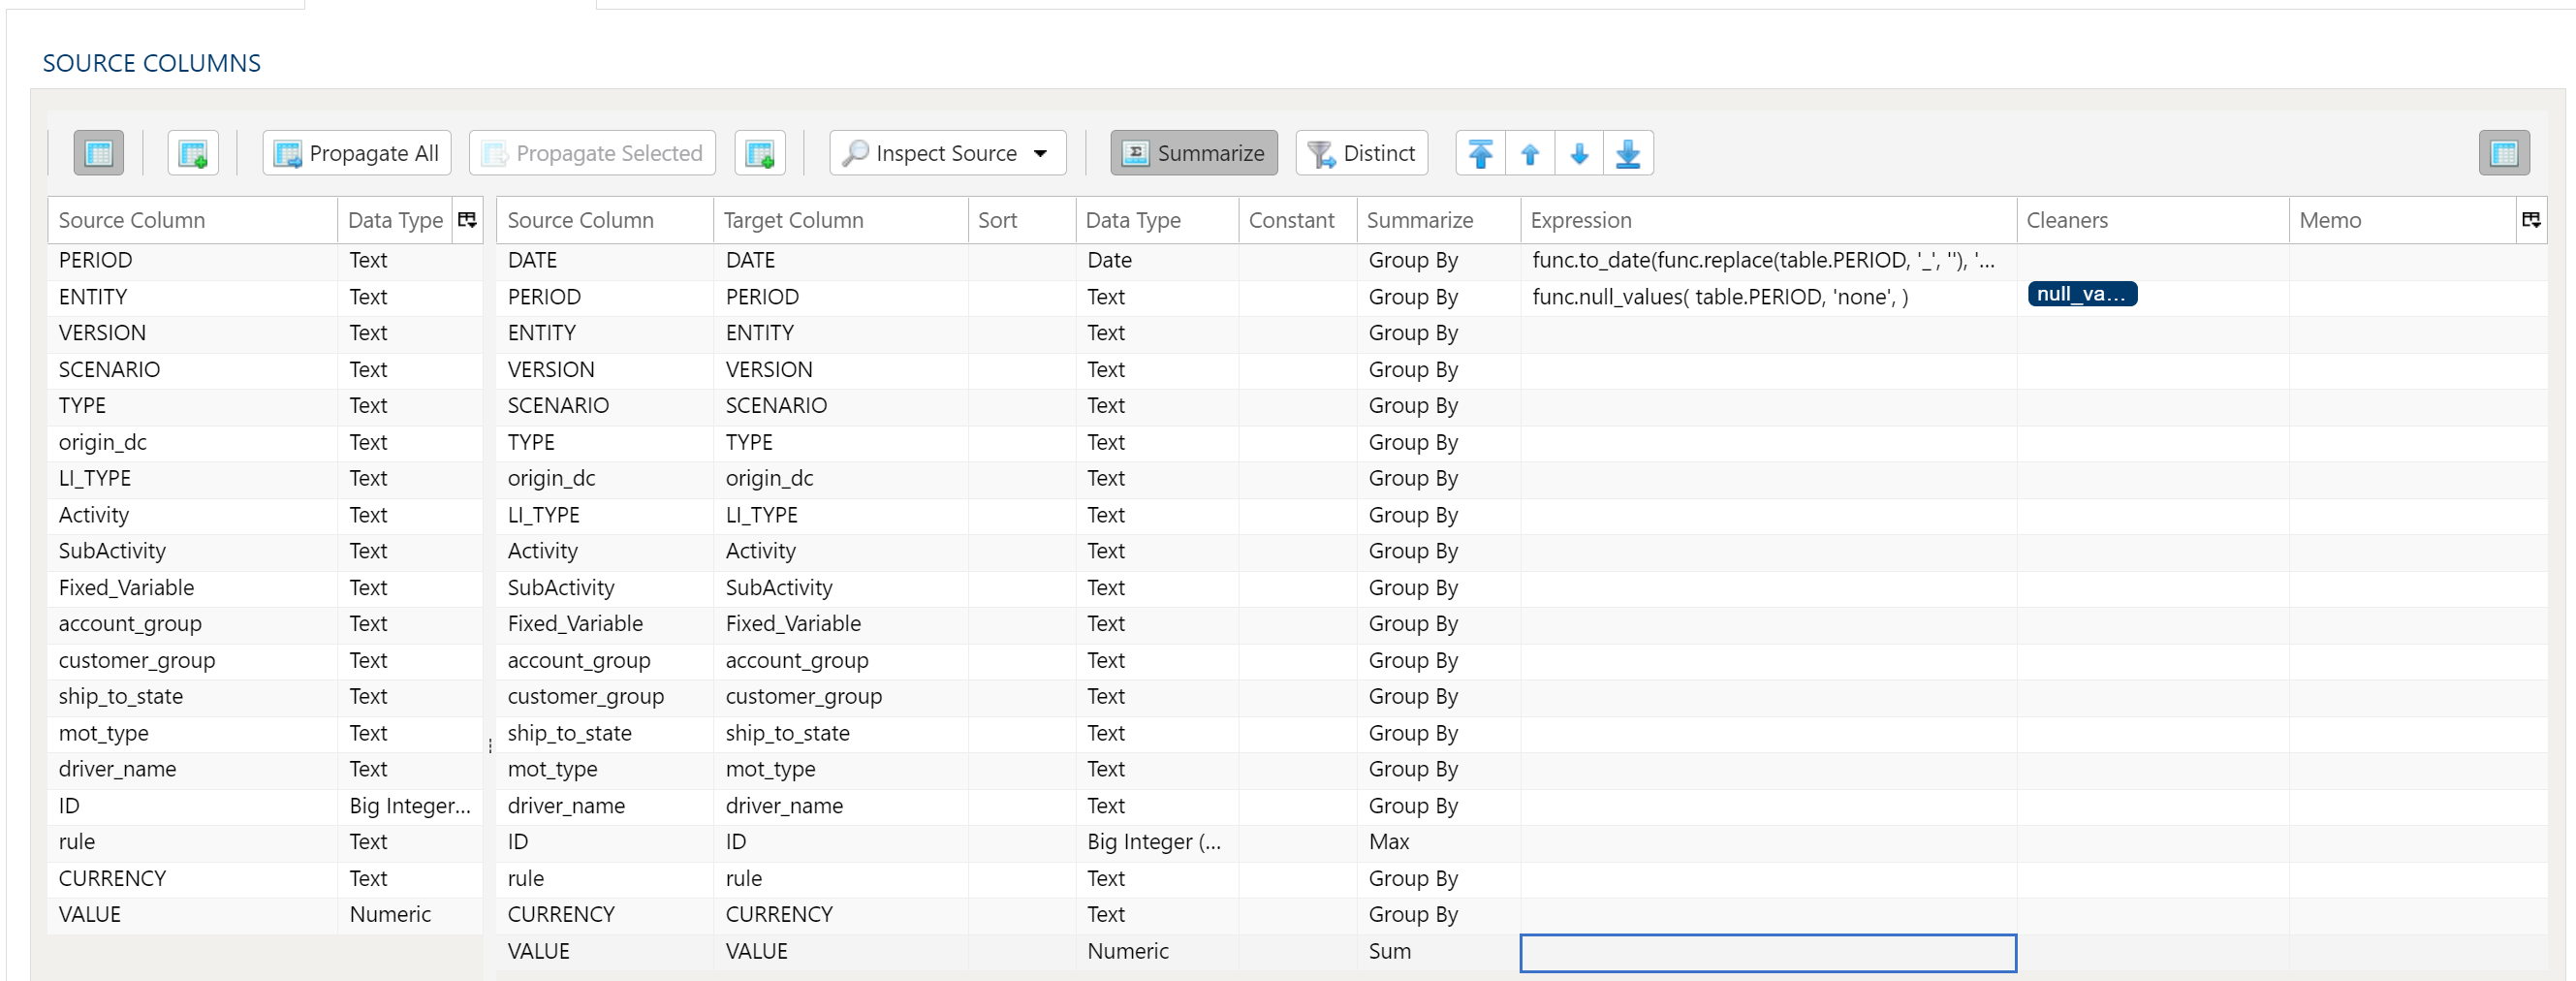
Data Mapper służy do mapowania kolumn z danych źródłowych na tabelę danych docelowych.
Sprawdzanie źródła i wypełnianie mappera
Przycisk menu Sprawdź źródło udostępnia dodatkowe sposoby mapowania kolumn ze źródła na cel:
- Wypełnij obie tabele mapowania: propaguje wszystkie wartości z tabeli danych źródłowych do tabeli danych docelowych. Jest to ustawienie domyślne.
- Wypełnij tylko tabelę mapowania źródła: mapuje wszystkie wartości wyłącznie w tabeli danych źródłowych. Jest to przydatne przy modyfikowaniu istniejącego przepływu pracy, gdy zmieniła się struktura kolumn źródłowych.
- Wypełnij tylko tabelę mapowania celu: propaguje wszystkie wartości wyłącznie do tabeli danych docelowych.
Jeśli opcje kolumn źródłowych i docelowych nie wystarczą, kolejne kolumny można dodać do tabeli danych docelowych na kilka sposobów:
- Propaguj wszystko wstawia wszystkie kolumny źródłowe do tabeli danych docelowych, niezależnie od tego, czy już w niej istniały.
- Propaguj zaznaczone wstawia tylko zaznaczone kolumny źródłowe.
- Kliknij prawym przyciskiem myszy po stronie docelowej i wybierz Wstaw wiersz, aby wstawić wiersz bezpośrednio nad aktualnie zaznaczonym wierszem.
- Kliknij prawym przyciskiem myszy po stronie docelowej i wybierz Dołącz wiersz, aby wstawić wiersz na dole (z prawej strony) tabeli danych docelowych.
Usuwanie kolumn
Aby usunąć kolumny z tabeli danych docelowych, zaznacz wybrane kolumny, kliknij prawym przyciskiem myszy i wybierz Usuń.
Kolumny źródłowe, których nie ma już na liście
Wiersz docelowy może wskazywać Kolumnę źródłową, której tabela danych źródłowych już nie zawiera, na przykład po ponownym sprawdzeniu źródła. Krok nigdy sam nie usuwa takiego wiersza. Zamiast tego nazwa kolumny jest wyświetlana na czerwono, za znakiem ostrzegawczym ⚠, a po najechaniu na nią kursorem pojawia się informacja, że kolumny nie ma wśród kolumn źródłowych. W kroku z kilkoma tabelami, takim jak unia, każda tabela jest sprawdzana względem własnych kolumn źródłowych.
Wiersz ze Stałą, Wyrażeniem lub podsumowaniem Liczba (z wartościami null) nigdy nie jest oznaczany, ponieważ krok nie odczytuje jego kolumny źródłowej. Nic nie jest oznaczane, dopóki tabela danych źródłowych nie zawiera żadnych kolumn, na przykład przed pierwszym sprawdzeniem źródła.
Podczas zapisywania kroku, który nadal ma oznaczone wiersze, okno Znaleziono nieaktualne kolumny wyświetla je pod kartą lub tabelą, do której należą, i oferuje trzy opcje:
- Usuń wszystkie i zapisz — usuń oznaczone wiersze, a następnie zapisz.
- Zapisz mimo to — zapisz krok bez zmian.
- Anuluj — wróć do kroku bez zapisywania.
Aby zachować wiersz i usunąć jego ostrzeżenie, dodaj kolumnę z powrotem do tabeli danych źródłowych albo wybierz kolumnę, którą ta tabela zawiera.
Kolumny brakujące w tabeli źródłowej
Podczas zapisywania sama tabela danych źródłowych jest sprawdzana w jej obecnym stanie. Kolumna, którą krok wymienia wśród kolumn źródłowych, a której tabela nie ma, na przykład zmieniona lub usunięta przez wcześniejszy krok, oznacza, że kolumny kroku są nieaktualne, a krok odczytujący taką kolumnę zakończy się błędem podczas uruchomienia. Zapisywanie otwiera wtedy okno dialogowe Brakujące kolumny źródłowe, które wymienia każdą tabelę i brakujące w niej kolumny, i oferuje dwa wybory:
- Zapisz mimo to — zapisuje krok bez zmian.
- Anuluj — wraca do kroku bez zapisywania.
Nic nie jest usuwane automatycznie, ponieważ błąd może leżeć po stronie tabeli, a ta może się jeszcze zmienić przed uruchomieniem kroku. Gdy oznaczone są także wiersze, których już nie ma na liście, oba komunikaty pojawiają się razem w oknie dialogowym Znaleziono nieaktualne kolumny, a opcja Usuń wszystkie i zapisz usuwa tylko oznaczone wiersze. Gdy lista kolumn źródłowych jest pusta, sprawdzane są zamiast niej kolumny mapowane przez krok, z wyjątkiem wierszy z podsumowaniem Stała, Wyrażenie lub Liczba (z wartościami null), które nie odczytują żadnej kolumny.
Źródło nazwane za pomocą zmiennej, takie jak {year}/Sales, jest sprawdzane w stanie zmiennej z chwili zapisywania, a okno dialogowe podaje nazwę sprawdzonej tabeli, na przykład 2026/Sales (from {year}/Sales). Zmienna ustawiana przez pętlę przechowuje wartość z jej ostatniej iteracji, więc pętla po tabelach o różnej strukturze może ostrzegać o tabeli, której następne uruchomienie nie odczyta. Nie jest sprawdzana tabela, która jeszcze nie istnieje, na przykład tworzona przez wcześniejszy krok przepływu pracy, ani źródło, którego zmienna nie ma wartości, tabela wyszukiwana przez krok podczas uruchomienia, ani tabela, której w danej chwili nie można odczytać.
Kiedy krok jest uruchamiany
Kroki Table Extract, Table Lookup, Table Inner Join, Table Cross Join, Table Outer Join, Table Anti Join, Złączenie wielu tabel, Table Union Distinct, Table Union All, Table Pivot, Table Melt, Table In-Place Delete, Table Upsert i Table Append sprawdzają swoje tabele źródłowe podczas uruchomienia, zanim cokolwiek zapiszą. Sprawdzenie porównuje zapytanie zbudowane przez krok z każdą tabelą źródłową w jej stanie z tej chwili:
- Kolumna, którą krok odczytuje, a której nie ma w tabeli, klucz złączenia, którego tabela nie ma lub którego nie ma w kolumnach źródłowych kroku, albo tabela źródłowa odczytywana przez krok, która nie została zbudowana, zatrzymują krok. Jeden błąd wymienia każdy problem wraz z jego własnym sposobem naprawy. Tabela docelowa, która już istniała, pozostaje bez zmian, a ta, którą krok musiał utworzyć, pozostaje pusta.
- Kolumna, którą krok wymienia, ale nie odczytuje, a której tabela już nie ma, dodaje ostrzeżenie. Krok działa bez niej.
- Wyjątkiem są Table Union Distinct i Table Union All w przypadku tabeli źródłowej, która nie została zbudowana: tak jak dotąd pomijają ją bez ostrzeżenia i łączą pozostałe. Jeśli żadna z ich tabel źródłowych nie została zbudowana, kończą się ostrzeżeniem zamiast błędem.
Krok, którego celem jest widok, tylko tworzy ten widok, więc wymienione w nim kolumny i klucze złączenia są sprawdzane względem jego tabel tylko tam, gdzie hurtownia danych i tak odmówiłaby utworzenia tego widoku. W pozostałych przypadkach zatrzymuje go wyłącznie tabela źródłowa, która nie została zbudowana, lub klucz złączenia, którego krok nie wymienia, i nie jest dodawane żadne ostrzeżenie.
Tam, gdzie to możliwe, błąd wymienia krok, który buduje tabelę, a gdy tabela ma kolumnę o nazwie zbliżonej do brakującej, na przykład różniącej się tylko wielkością liter, wymienia także tę kolumnę.
Typ danych kolumny
Każda kolumna docelowa ma Typ. Kolumna propagowana ze źródła zachowuje typ kolumny źródłowej; dodany ręcznie wiersz ma początkowo typ Tekst, a w polu Typ określasz, czym kolumna ma faktycznie być — kolumna, którą zamierzasz sumować lub sortować, wymaga typu liczbowego albo daty, ponieważ tekst jest sortowany i sumowany jako tekst.
Krok zapisany z kolumną bez żadnego typu nadal się uruchamia. Typ jest ustalany w chwili rozpoczęcia kroku na podstawie kolumny źródłowej, którą ta kolumna odczytuje. Jeśli nie ma z czego go odczytać, traktowany jest jako tekst: kolumny kroku Wyodrębnij SQL pochodzą z napisanego przez Ciebie zapytania, a nie z zmapowanego źródła, a gdy kilka źródeł zawiera kolumnę o tej samej nazwie, lecz o niezgodnych typach, używany jest tekst zamiast zgadywania jednego z nich — błędne odgadnięcie powoduje konwersję, którą magazyn danych może odrzucić, a wszystko można przekonwertować na tekst.
Samodzielne ustawienie pola Typ nadal jest sposobem na określenie, czym kolumna ma być. Pozostawienie go nieustawionego oznacza zgodę na to, czym akurat jest kolumna źródłowa.
Zmiana kolejności kolumn
Aby zmienić kolejność kolumn w tabeli danych docelowych, zaznacz wybrane kolumny. Możesz użyć jednej z poniższych metod:
- Strzałki przenoszenia zbiorczego: wybierz odpowiednią opcję przenoszenia za pomocą strzałek w prawym górnym rogu
- Menu kontekstowe: kliknij prawym przyciskiem myszy i wybierz Przenieś na początek, Przenieś w górę, Przenieś w dół lub Przenieś na koniec.
Ograniczanie wyniku do unikalnych rekordów
Aby zwrócić tylko unikalne wartości, wybierz opcję menu Unikalne. Spowoduje to wyświetlenie zestawu pól wyboru dla każdej kolumny źródła. Wystarczy zaznaczyć pole obok odpowiedniej kolumny, aby zwrócić tylko unikalne wyniki.
W zależności od sytuacji warto rozważyć zastosowanie podsumowania.
Proces usuwania duplikatów zachowuje pierwszy znaleziony unikalny rekord, a pozostałe odrzuca. Jeśli spójność między uruchomieniami jest ważna, warto zastosować sortowanie danych.
Agregacja i grupowanie
Aby agregować wyniki, wybierz opcję menu Podsumuj. Spowoduje to wyświetlenie zestawu pól wyboru dla każdej kolumny w tabeli danych docelowych. Wybierz odpowiednią metodę podsumowania dla każdej kolumny.
Gdy Sprawdź źródło wypełnia kolumny, kolumna liczbowa zaczyna jako Grupuj według zamiast Suma, jeśli jej nazwa wygląda na identyfikator, na przykład id, customer_id, Order No lub CustomerKey, jeśli jej tabela ustawia ją jako klucz albo jeśli złączenie używa jej jako klucza.
- Grupuj według
- Suma
- Min
- Maks
- Pierwsza
- Ostatnia
- Liczba
- Liczba (z wartościami null)
- Średnia
- Odchylenie standardowe
- Odchylenie standardowe z próby
- Odchylenie standardowe z populacji
- Wariancja
- Wariancja z próby
- Wariancja z populacji
- Zaawansowane bez grupowania
Informacje o zaawansowanym użyciu Data Mapper, takim jak wyrażenia, czyszczenie i stałe, znajdziesz w artykule Zaawansowane użycie Data Mapper
Kolumny nazwane w czasie wykonania
Dział zatytułowany „Kolumny nazwane w czasie wykonania”Zaznacz Przenieś także kolumny nazwane w czasie wykonania, aby przepuścić bez zmian każdą kolumnę źródłową, której krok nie wymienia, w takiej postaci, jaką ma tabela w chwili uruchomienia kroku. Użyj tego, gdy wcześniejszy krok tworzy kolumny, których nazwy zależą od danych, na przykład przestawienie, więc nie można ich wymienić przy budowaniu kroku. Pozostaw wyłączone, aby zapisywać tylko wymienione kolumny.
Po włączeniu pojawia się sekcja Przenoszone kolumny, a sekcja Kolumny nazwane przez dane jest zawsze dostępna. Mają one następujące pola:
- Przenieś jako (
carry_expression) — zapisz każdą przenoszoną kolumnę jako to wyrażenie zamiast bez zmian, gdzie__column__oznacza przenoszoną kolumnę. W ten sposób krok, który grupuje, włącza kolumny nazwane dopiero w czasie uruchomienia; krok, który agreguje, bez tego nic nie przenosi. Typ przenoszonych kolumn (carry_dtype) ustawia typ danych każdej przenoszonej kolumny (domyślnie jej własny), a Agregacja przenoszonych kolumn (carry_agg) ustawia, jak traktuje ją krok agregujący (dont_group, gdy wyrażenie agreguje). - Zmień nazwy przenoszonych kolumn (
carry_rename) — zmień nazwę każdej przenoszonej kolumny, której nazwę dopasowuje wyrażenie regularnepattern, akeepnie, umieszczającreplacementw miejsce każdego dopasowania (\1dla grupy; pierwszemaxdopasowań, gdy ustawiono).__index__wreplacementto pozycja kolumny wśród kolumn o zmienionych nazwach, liczona odstart. Do nazwy już zajętej dodawane jest(#n). - Kolumny dynamiczne (
dynamic_columns) — kolumny docelowe nazwane przez dane, jeden zestaw dla każdej unikalnej wartości, którą krok odczytuje ze swojego źródła, zapisywany podczas uruchomienia kroku. Każdy wpis podajerows(wyrażeniakey,label,whereiordernad źródłem), kolumnę lub listę kolumntarget, która używa__key__,__label__i__index__, orazafter, kolumnę docelową, po której następują nowe (domyślnie koniec). Wartości muszą być tekstem, liczbą całkowitą, wartością logiczną lub NULL, krok zapisuje co najwyżej 1000 kolumn, a wynik musi być tabelą. Podczas uruchomienia kroku wyrażeniarowsi filtr kroku muszą przestrzegać reguł z sekcji Odrzucane funkcje i operatory, w przeciwnym razie krok kończy się niepowodzeniem.
Filtry danych
Dział zatytułowany „Filtry danych”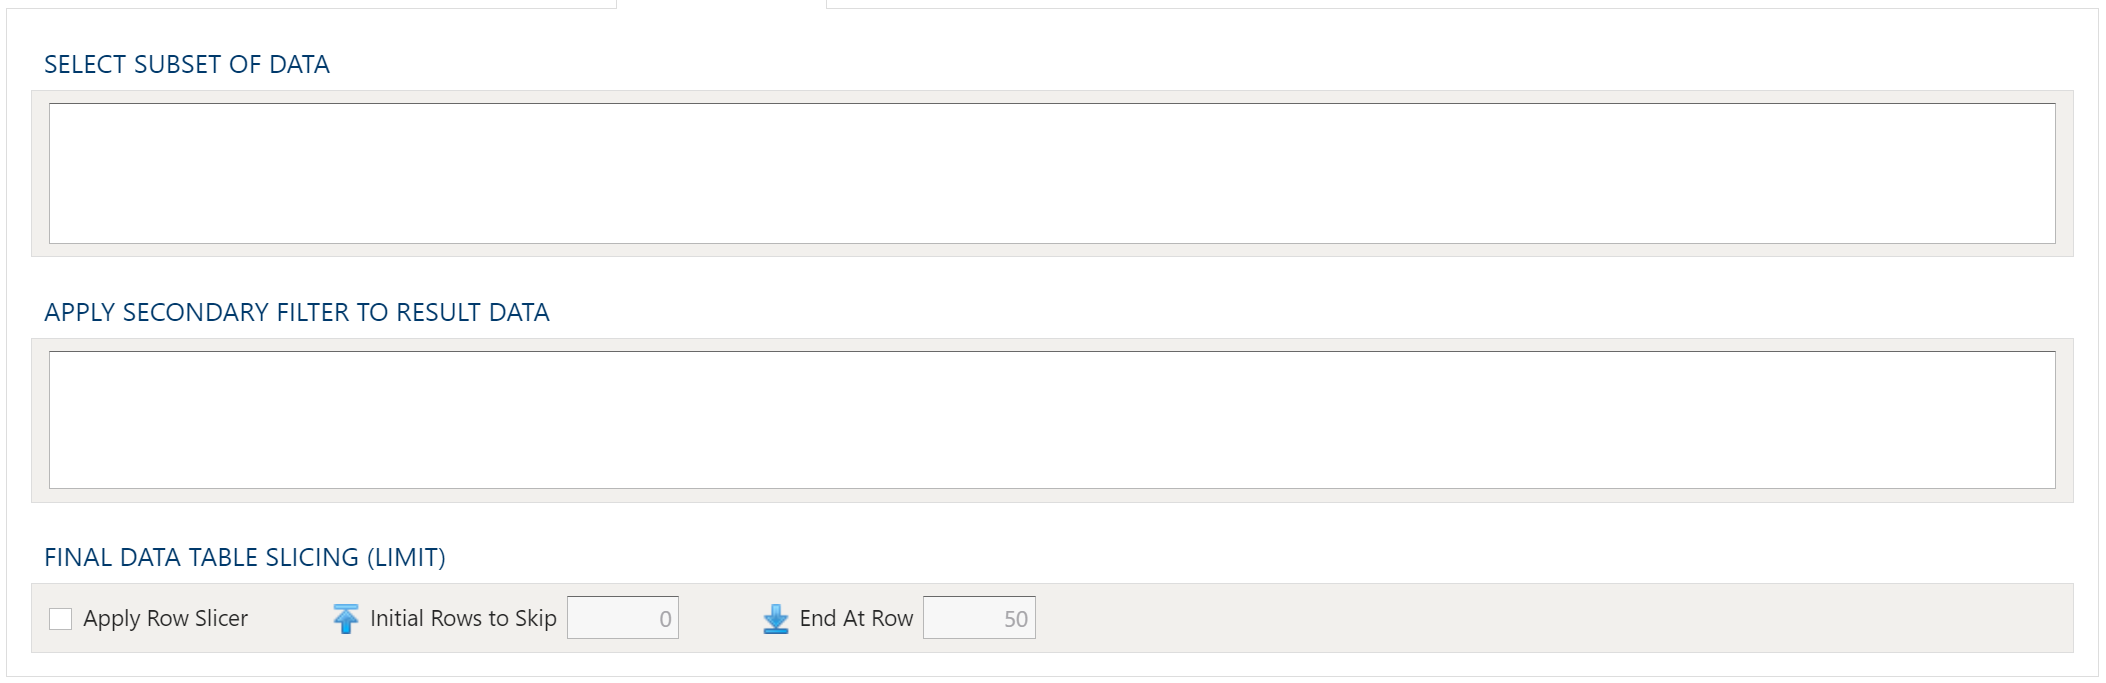
Aby zapewnić maksymalną elastyczność, filtry danych są dostępne zarówno dla danych źródłowych, jak i docelowych. W przypadku większych zbiorów danych szczególnie korzystne może być odfiltrowanie wierszy już na źródle, aby pozostałe operacje były wykonywane na mniejszym zbiorze danych.
Wybierz podzbiór danych
Ten typ filtru umożliwia filtrowanie przychodzących danych źródłowych na podstawie określonych warunków.
Zastosuj filtr wtórny do danych wynikowych
Ten typ filtru umożliwia zastosowanie filtru do danych wynikowych po transformacji na podstawie określonych warunków. Możliwość zastosowania filtru do wyniku po transformacji pozwala na wykluczenia oparte na wynikach złożonych obliczeń, podsumowań lub funkcji okienkowych.
Końcowe wycinanie tabeli danych (limit)
Wycinanie wierszy umożliwia ograniczenie liczby wierszy w zbiorze wynikowym na podstawie zakresu i punktu początkowego.
Składnia filtrów
Składnia filtrów korzysta z Python SQLAlchemy, czyli tej samej składni, która obowiązuje w innych wyrażeniach.
Przykłady i funkcje wyrażeń znajdziesz w obszarze Wyrażenia.