

Wyszukiwanie, uziemianie i ścieżki analizy
„RAG” zwykle oznacza jedno: pociąć korpus na fragmenty, osadzić je w magazynie wektorowym i wkleić najbliższe dopasowania do promptu. PlaidCloud robi tak dla dokładnie jednego korpusu — dokumentacji produktu — i celowo nie robi tego z Twoimi danymi.
Twoje tabele są odczytywane na żywo, w chwili gdy się o nie pyta, z uwzględnieniem Twoich uprawnień. To nie jest decyzja wydajnościowa; dzięki temu odpowiedź zasługuje na zaufanie, a kontrola dostępu ma sens.
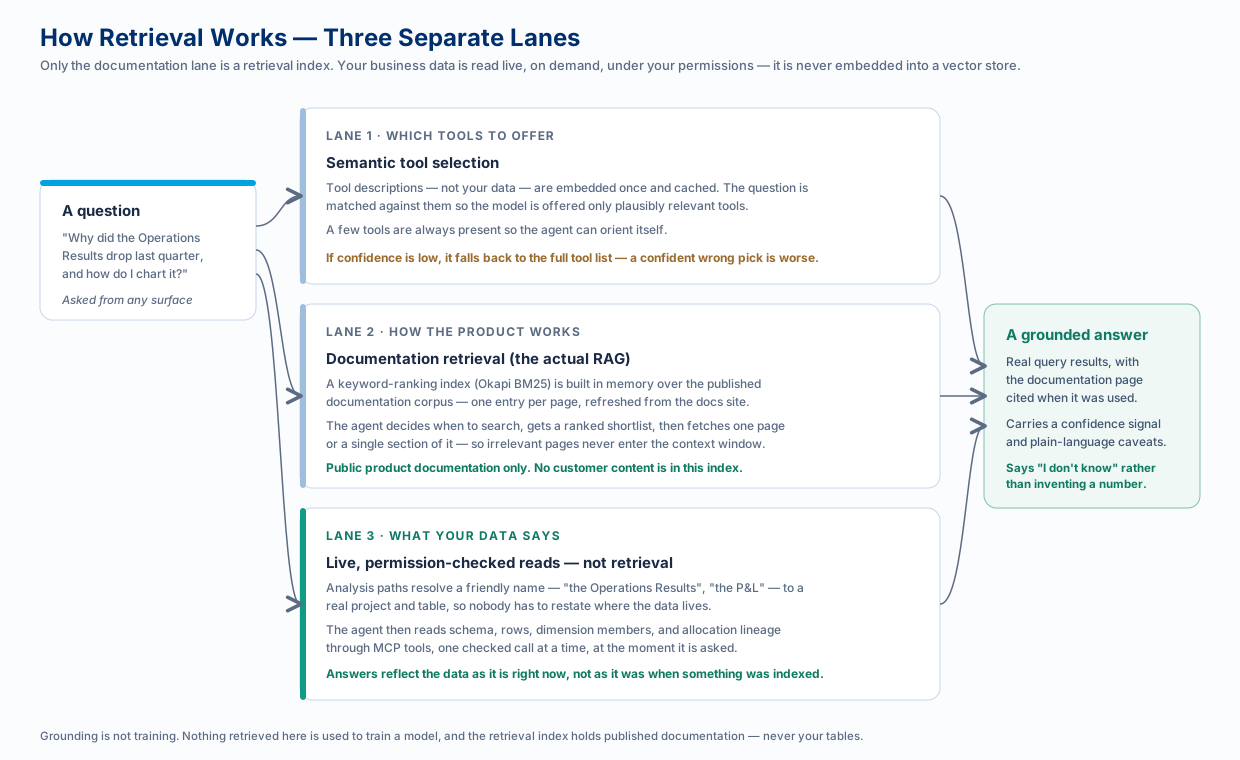
Tor 1 — wybór narzędzi do zaoferowania
Dział zatytułowany „Tor 1 — wybór narzędzi do zaoferowania”Ten tor działa dla asystenta w aplikacji, który ma własny katalog narzędzi. Każdy opis narzędzia, który pokazuje modelowi, kosztuje tokeny promptu w każdej turze, więc zanim model cokolwiek zobaczy, pytanie jest dopasowywane przez podobieństwo semantyczne do opisów narzędzi — nigdy do Twoich danych — i oferowane są tylko narzędzia prawdopodobnie istotne.
Na pozostałych powierzchniach katalogiem narzędzi zajmuje się połączenie MCP: konektor Anthropic zarządza nim po stronie serwera, a pętla po stronie klienta ogranicza deklarowaną powierzchnię. Tory 2 i 3 poniżej obowiązują wszędzie.
Ważne są trzy szczegóły:
- Osadzenia opisują narzędzia, a nie treść. Są obliczane jednorazowo z nazw i opisów narzędzi, przechowywane w pamięci podręcznej i automatycznie przebudowywane, gdy opis się zmienia.
- Kilka narzędzi jest zawsze obecnych, aby agent mógł się zorientować — ustalić, kto pyta i w którym projekcie — nawet jeśli pytanie nie wspomina o żadnym z nich.
- Niska pewność powoduje powrót do pełnej listy. Pewne siebie, błędne zawężenie jest gorsze niż jednorazowe poniesienie pełnego kosztu tokenów, więc niepewne dopasowanie po prostu pokazuje wszystko. Bardzo krótkie tury („dzięki”, „ok”) całkowicie pomijają ten krok.
Tor 2 — uziemianie w dokumentacji
Dział zatytułowany „Tor 2 — uziemianie w dokumentacji”To prawdziwa ścieżka generowania wspomaganego wyszukiwaniem i odpowiada na pytania „jak mam…“, „co to jest…” i „gdzie skonfigurować…“.
Opublikowana dokumentacja jest pobierana jako ustrukturyzowany korpus — jeden wpis na stronę — i indeksowana w pamięci za pomocą Okapi BM25, funkcji rankingowej opartej na słowach kluczowych. Agent działa wtedy w dwóch ruchach:
- Wyszukiwanie zwraca uszeregowaną listę stron: slug, tytuł, opis, wynik.
- Pobranie ściąga jedną stronę albo jedną wskazaną jej sekcję, gdy agent zdecyduje, której faktycznie potrzebuje.
Istotą projektu jest to, że agent decyduje, kiedy szukać i ile przeczytać. Pasywne wstrzykiwanie wkleja coś do każdego promptu, niezależnie od tego, czy pomaga; wyszukiwanie sterowane narzędziami całkowicie wyklucza nieistotne strony z okna kontekstu i pozwala agentowi powołać się na użytą stronę, abyś mógł zajrzeć dalej.
Jeśli korpus dokumentacji jest chwilowo niedostępny, agent odpowiada bez niego, zamiast przerywać turę.
Tor 3 — odczyt Twoich własnych danych
Dział zatytułowany „Tor 3 — odczyt Twoich własnych danych”Pytania o Twoje liczby w ogóle nie są obsługiwane przez wyszukiwanie. Agent odczytuje to, czego potrzebuje, wtedy gdy tego potrzebuje, za pomocą narzędzi z kontrolą uprawnień: schematów tabel, wierszy, członków wymiarów, pochodzenia przepływów pracy, śladów alokacji.
Dlatego odpowiedzi są aktualne — odzwierciedlają dane takie, jakie są teraz, a nie takie, jakie były podczas ostatniego indeksowania — i dlatego kontrola dostępu działa: nie ma gotowego indeksu, który mógłby wyciec przez granicę uprawnień, ponieważ nie ma żadnego indeksu.
Ścieżki analizy — warstwa nazewnicza
Dział zatytułowany „Ścieżki analizy — warstwa nazewnicza”Odczyty na żywo muszą wiedzieć, która to tabela. Ścieżki analizy to wspólne słownictwo, które to ułatwia: przyjazna nazwa — „Wyniki operacyjne”, „rachunek zysków i strat”, „Zatrudnienie” — przypisana jednorazowo do rzeczywistego projektu i tabeli, a następnie dostępna dla wszystkich w obszarze roboczym.
- Pytaj po nazwie zamiast za każdym razem podawać projekt i tabelę.
- Oznacz jedną jako domyślną dla obszaru roboczego, aby pytanie bez wskazania celu, np. „co zmieniło się w zeszłym kwartale?“, trafiało w sensowne miejsce.
- Wszyscy mają na myśli to samo. Gdy cały zespół mówi „rachunek zysków i strat”, trafia do tej samej tabeli.
Rejestruje je administrator; korzystać może każdy; każde pytanie nadal działa z uprawnieniami osoby pytającej. Działają identycznie z asystenta w aplikacji, z Microsoft 365 Copilot i z podłączonego agenta programistycznego. Zobacz Ścieżki analizy, jak je skonfigurować.
Katalog wyrażeń
Dział zatytułowany „Katalog wyrażeń”Gdy asystent pisze wyrażenie, nie zgaduje nazw funkcji z pamięci. Korzysta z ustrukturyzowanego katalogu każdej funkcji wyrażeń PlaidCloud — nazwa, sygnatura, link do dokumentacji, kategoria — porównanego z funkcjami, które faktycznie udostępnia Twoja hurtownia, z sugestiami zbliżonych dopasowań, gdy nazwa jest prawie poprawna. To wyszukiwanie po kluczu, a nie wyszukiwanie podobieństwa, bo w nazwach funkcji „prawie poprawne” oznacza błędne.
Uziemianie to nie trenowanie
Dział zatytułowany „Uziemianie to nie trenowanie”Dwie rzeczy, o które ludzie zasadnie się martwią:
- Nic, co tu jest wyszukiwane, nie trenuje modelu. Uziemianie wprowadza informacje do jednego żądania. Nie zmienia wag modelu, a Twoje treści nie są wykorzystywane do trenowania niczyjego modelu.
- Indeks wyszukiwania zawiera wyłącznie dokumentację publiczną. Nie osadza się w nim żadnych treści klientów.
To, dokąd trafiają Twoje dane — i jak zachować je w infrastrukturze, którą kontrolujesz — opisano w Korzystanie z własnego kontrolowanego LLM.
Dlaczego daje to lepsze odpowiedzi
Dział zatytułowany „Dlaczego daje to lepsze odpowiedzi”Uziemianie pozwala asystentowi powiedzieć „nie wiem” zamiast wymyślać. Ponieważ każda liczba pochodzi z prawdziwego zapytania, a każde twierdzenie o produkcie z prawdziwej strony dokumentacji, odpowiedź można ocenić: każda niesie sygnał pewności i zastrzeżenia w prostym języku, a podsumowanie narracyjne jest sprawdzane, aby nie mogło po cichu pominąć ograniczenia ani przywołać liczby, której analiza nigdy nie wygenerowała. Zobacz Odpowiedzi, którym możesz zaufać.
Powiązane
Dział zatytułowany „Powiązane”- Ścieżki analizy — skonfiguruj wspólne nazwy
- Śledzenie alokacji — pytanie dlaczego wynik się zmienił
- Architektura AI i LLM — powierzchnie i wspólna ścieżka