

Architektura AI i LLM
PlaidCloud nie ma jednej funkcji AI. Ma cztery sposoby dotarcia do modelu — asystenta wewnątrz produktu, Microsoft 365 Copilot, zewnętrzne agenty programistyczne i krok LLM w przepływie pracy — a wszystkie cztery działają na tej samej nadzorowanej ścieżce. Sam model można wymienić: Claude, GPT, Gemini, Grok, zasób Azure OpenAI w Twojej własnej subskrypcji albo model hostowany przez Ciebie.
Ta sekcja wyjaśnia tę architekturę: co działa gdzie, co przekracza granicę i dlaczego.
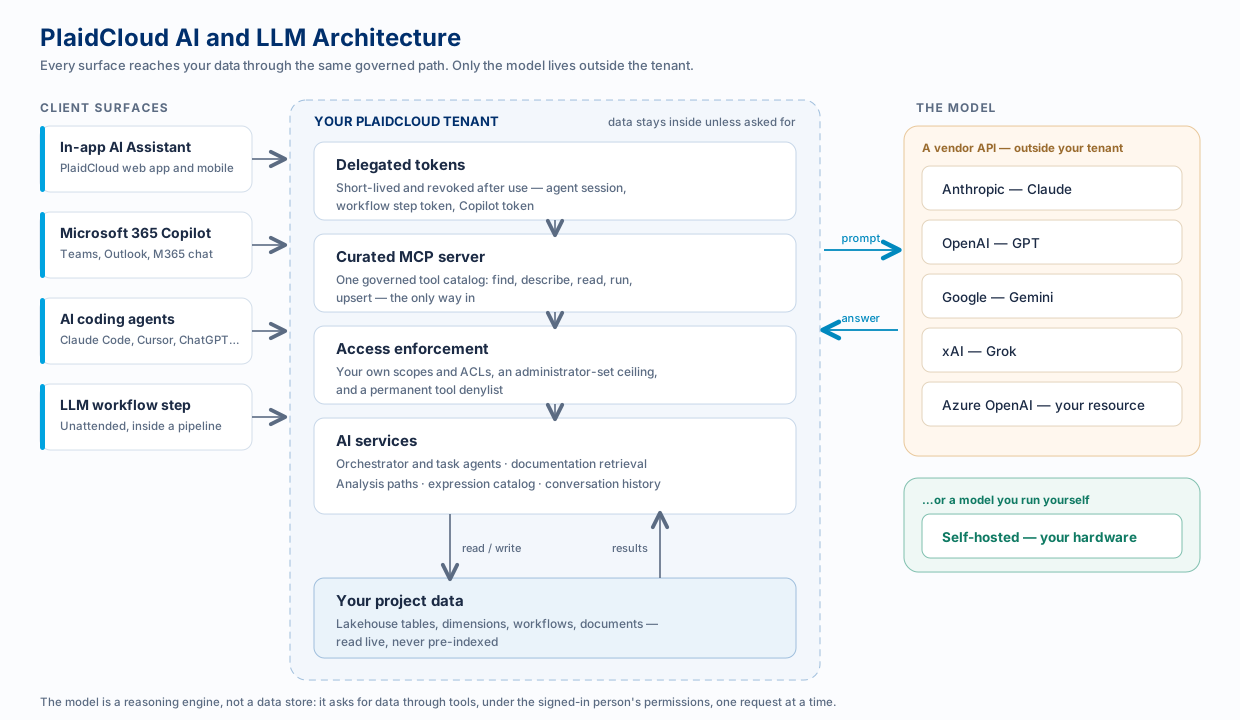
Cztery powierzchnie
Dział zatytułowany „Cztery powierzchnie”| Powierzchnia | Kto z niej korzysta | Jak model uzyskuje dostęp do danych | Od czego zacząć |
|---|---|---|---|
| Asystent AI w aplikacji | Każdy, kto pracuje w PlaidCloud | Własne agenty PlaidCloud wywołują wewnętrzne narzędzia w Twoim imieniu | Weave AI Chat |
| Microsoft 365 Copilot | Całe zespoły, w Teams i Outlooku | Opublikowany agent loguje osobę, a następnie wywołuje serwer MCP | Microsoft 365 Copilot |
| Agenty programistyczne AI | Analitycy i programiści | Ich klient łączy się bezpośrednio z serwerem MCP przez OAuth | Pierwsze kroki |
| Krok przepływu pracy LLM | Potoki działające bez nadzoru | W przypadku Anthropic — token ograniczony wyłącznie do powiązanych obiektów; u pozostałych dostawców — brak dostępu do danych, zobacz reguły kroku | Krok LLM |
Różnią się tym, kto prowadzi rozmowę i gdzie ona się toczy. Nie różnią się tym, czego model może dotykać.
Jedna nadzorowana ścieżka
Dział zatytułowany „Jedna nadzorowana ścieżka”Na której powierzchni by się pytanie nie pojawiło, zawsze obowiązuje tych samych pięć zasad.
-
Model działa jako osoba, a nie jako platforma. Każde żądanie niesie krótkotrwałe poświadczenie, unieważniane po zakończeniu, które reprezentuje zalogowanego użytkownika. Za AI nie stoi żadne współdzielone konto usługi z podwyższonymi uprawnieniami.
-
Narzędzia są jedyną drogą dostępu. Model nie może odpytywać Twojego lakehouse bezpośrednio. Wywołuje wyselekcjonowany katalog narzędzi — find, describe, read, run, upsert — a każde wywołanie jest sprawdzane niezależnie.
-
Twoje własne uprawnienia nadal go ograniczają. Żądanie AI nigdy nie zobaczy ani nie zmieni niczego, czego nie mógłbyś zobaczyć lub zmienić samodzielnie. Warstwa AI zawęża dostęp; nigdy go nie poszerza.
-
Administrator ustala pułap, który domyślnie jest zamknięty. Dostęp agenta w połączeniu LLM zaczyna się od samego odczytu. Microsoft 365 Copilot zaczyna od zera: dopóki administrator nie przypisze komuś poziomu dostępu, zalogowana osoba nie otrzymuje żadnych danych. To dwa osobne mechanizmy, ale podniesienie któregokolwiek z nich jedynie ogranicza to, czego AI może próbować — nigdy nie poszerza tego, do czego i tak masz dostęp.
-
Niektóre rzeczy są trwale poza zasięgiem. Ustawienia poświadczeń i połączeń, zarządzanie tożsamościami i grupami, zmiany kontroli dostępu, publikowanie oraz kod do wdrożenia nigdy nie mogą być wywołane przez poświadczenie AI — bez względu na to, co przyznał administrator, u żadnego dostawcy. Pozostają wyłącznie w gestii człowieka.
Życie pytania
Dział zatytułowany „Życie pytania”Weźmy pytanie „Dlaczego zaalokowany koszt IT dla Atlanty wzrósł w zeszłym kwartale?“, zadane z dowolnej powierzchni:
-
Tworzone jest poświadczenie dla osoby zadającej pytanie, o ograniczonym zakresie i krótkim czasie życia.
-
Narzędzia są udostępniane modelowi — zawężone do tego, czego pytanie prawdopodobnie wymaga, na powierzchniach, które to zawężanie wykonują, albo wykrywane z katalogu na tych, które tego nie robią.
-
Prompt trafia do modelu — pytanie, wszelkie stałe reguły i opisy narzędzi. Jeszcze bez danych.
-
Model prosi o dane za pomocą wywołań narzędzi: ustala ścieżkę analizy, odczytuje schemat, uruchamia śledzenie alokacji, odczytuje wiersze klucza alokacji. Każde wywołanie jest sprawdzane pod kątem uprawnień w chwili otrzymania.
-
Model odpowiada na podstawie tego, co otrzymał, powołuje się na stronę dokumentacji, jeśli z niej korzystał, i dołącza sygnał pewności oraz zastrzeżenia.
-
Poświadczenie jest unieważniane. Przechwyconego tokenu nie można odtworzyć po zakończeniu żądania.
Najważniejszy jest krok 4: model nie ma Twoich danych. Prosi o ich fragmenty, a każda prośba jest rozstrzygana osobno.
Czytaj dalej
Dział zatytułowany „Czytaj dalej”Powiązane
Dział zatytułowany „Powiązane”- Odpowiedzi, którym możesz zaufać — jak odpowiedzi są oceniane i opatrywane zastrzeżeniami
- Ścieżki analizy — przyjazne nazwy tabel, o które pyta Twój zespół
- Architektura platformy — miejsce AI w szerszej platformie