

Importuj SQL
Importuje wynik zapytania SQL do zewnętrznej bazy danych do tabeli projektu PlaidCloud. Zapytanie jest wykonywane w zdalnej bazie danych; do PlaidCloud trafia tylko zestaw wyników.
Różni się od kroku Importuj zewnętrzne tabele bazy danych tym, że SQL piszesz samodzielnie — przydaje się to przy złożonych złączeniach, filtrach lub agregacjach, które ma wykonać źródłowa baza danych, zanim dane trafią do PlaidCloud.
Parametry importu
Dział zatytułowany „Parametry importu”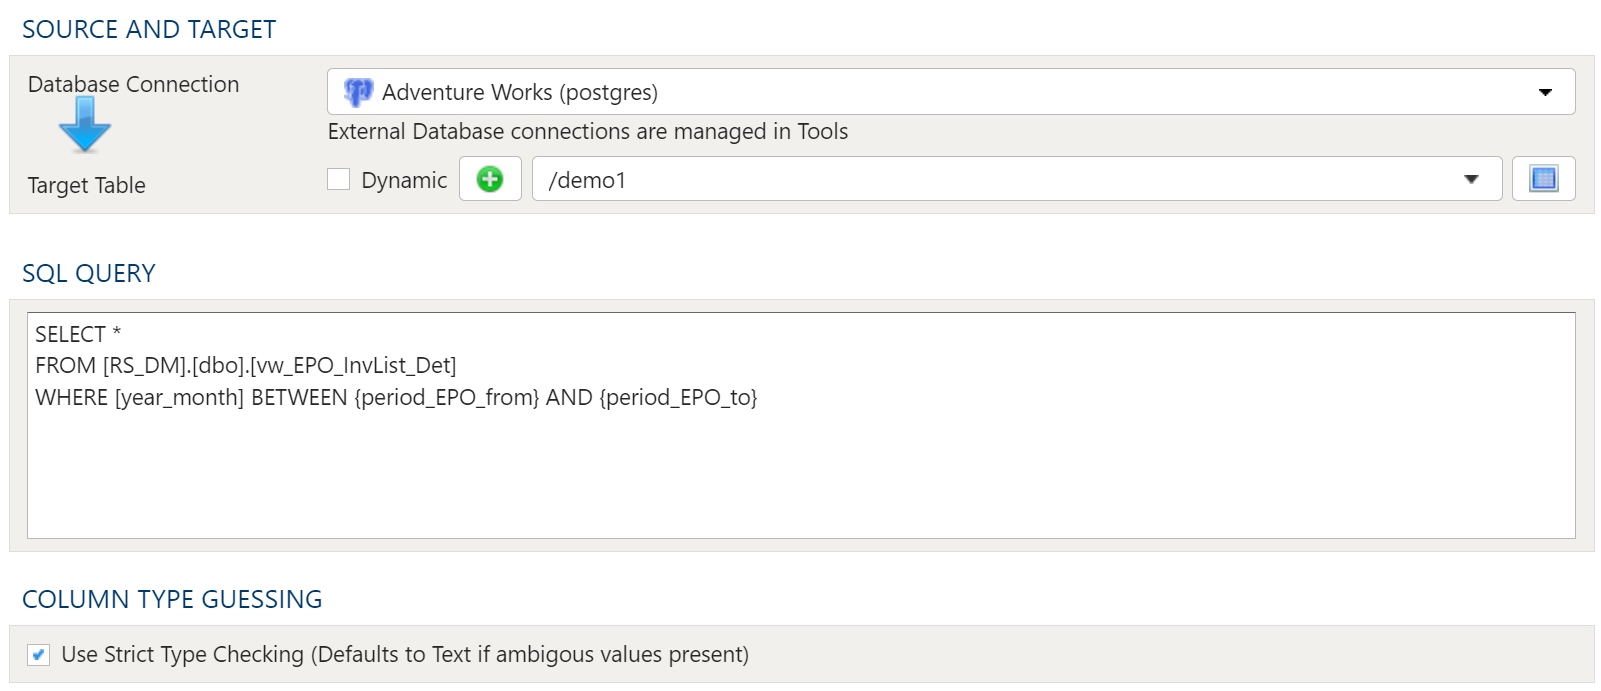
Źródło i cel
Dział zatytułowany „Źródło i cel”Połączenie z bazą danych
Dział zatytułowany „Połączenie z bazą danych”Aby utworzyć Połączenie z bazą danych, zapoznaj się z PlaidCloud Data Connections
Tabela docelowa
Wybór celu importu jest ograniczony wyłącznie do tabel, ponieważ widoki nie zawierają danych źródłowych.
Opcja dynamiczna
Opcja dynamiczna umożliwia określenie tabeli za pomocą tekstu, w tym zmiennych. Jest to przydatne w przepływach pracy sterowanych zmiennymi, w których odwołania do tabel i widoków zależą od określonych zmiennych.
Przykład użycia zmiennej current_month do dynamicznego wskazania tabeli docelowej:
legal_entity/inputs/{current_month}/ledger_valuesOpcja statyczna
Jeśli jako cel importu ma służyć konkretna tabela, pozostaw niezaznaczone pole Dynamiczna i wybierz tabelę docelową.
Jeśli tabela docelowa nie istnieje, wybierz przycisk Utwórz nową tabelę, aby utworzyć tabelę w wybranej lokalizacji.
Funkcja Eksplorator tabel jest zawsze dostępna przy wyborze dowolnej tabeli. Kliknij przycisk Eksplorator tabel po prawej stronie wyboru tabeli, a otworzy się okno Eksploratora tabel.
Zapytanie SQL
Dział zatytułowany „Zapytanie SQL”W tej sekcji napisz zapytanie SQL zwracające wymagane dane.
Zgadywanie typów kolumn
Dział zatytułowany „Zgadywanie typów kolumn”Import SQL może podczas ładowania próbować odgadnąć typ danych albo ustawić wszystkie kolumny na typ Text. Dynamiczne ustawianie typów danych może być szybsze, jeśli dane są czyste, ale w niektórych okolicznościach może powodować problemy.
Na przykład, jeśli większość danych wygląda na liczbową, ale występuje też trochę tekstu, krok może spróbować ustawić typ liczbowy, co powoduje problemy z ładowaniem z powodu niezgodnych typów danych. Problemy mogą też wystąpić, gdy jest na przykład liczbowy kod produktu o długości 16 cyfr. Zostałyby wtedy obcięte zera wiodące, w wyniku czego otrzymasz liczbę zamiast 16-cyfrowego kodu.
Ustawienie wszystkich danych na tekst wymaga jednak późniejszego kroku Extract, który przekonwertuje typy danych, które nie powinny być tekstem, na odpowiednie typy, takie jak daty lub wartości liczbowe.
Rozwiązywanie problemów
Dział zatytułowany „Rozwiązywanie problemów”| Objaw | Prawdopodobna przyczyna |
|---|---|
| Krok trwał zauważalnie dłużej niż zwykle — nawet o pół godziny — a nic innego w zapytaniu, połączeniu ani wolumenie danych się nie zmieniło | Proces roboczy w tle wykonujący import został przerwany w trakcie (restart lub wywłaszczenie po stronie platformy, a nie coś w Twoim przepływie pracy), a platforma ponowiła import tabeli za Ciebie. Ponowienie rozpoczyna się dopiero po wykryciu przerwania, co tłumaczy dodatkowy czas. |
| Krok mimo to zakończył się pomyślnie po tym opóźnieniu | Ponowienie zastępuje zawartość tabeli w całości, więc wynik jest taki sam jak przy jednym czystym uruchomieniu — nie ma nic więcej do sprawdzenia ani powtórzenia. |
| Krok kończy się błędem „has already been attempted and cannot be safely re-run” | W kroku Importuj SQL to odrzucenie już się nie zdarza — przerwanie w trakcie uruchomienia jest ponawiane. Nadal zobaczysz je, z założenia, przy przywracaniu archiwum projektu lub ładowaniu wymiaru, gdzie ponowne uruchomienie utworzyłoby duplikat zamiast czegokolwiek zastąpić. Jeśli widzisz je w samym kroku Importuj SQL, otwórz zgłoszenie w pomocy technicznej. |