

Export to HDF
Eksportuje tabelę danych Analyze do PlaidCloud Document jako plik HDF5.
Więcej informacji o plikach HDF5 znajdziesz na oficjalnej stronie HDF Group: http://www.hdfgroup.org/HDF5/.
Parametry eksportu
Dział zatytułowany „Parametry eksportu”Selektor pliku eksportu
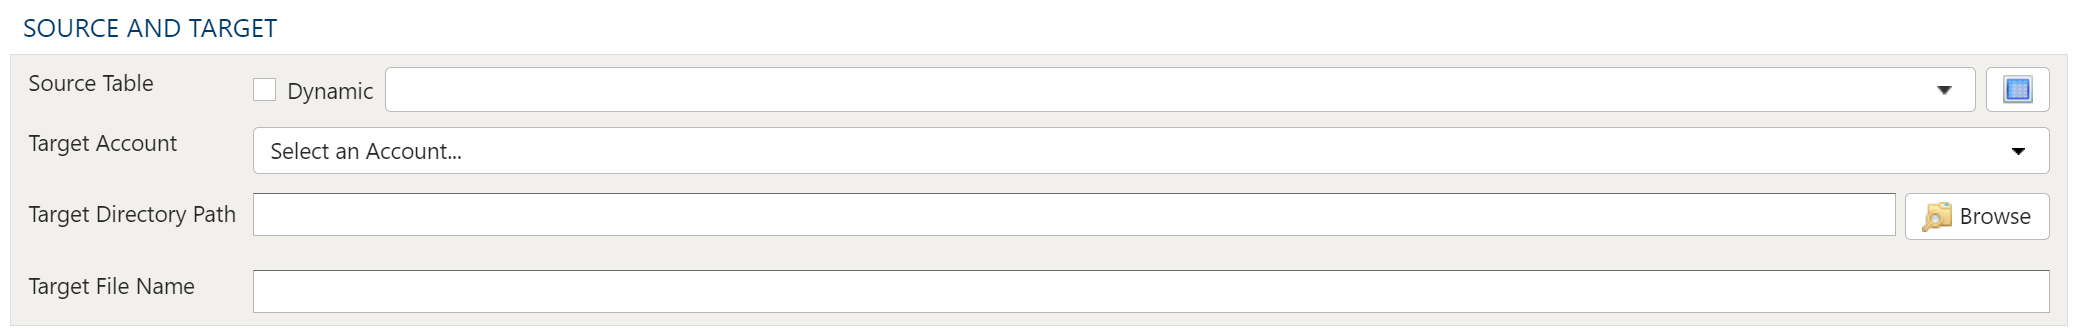
Selektor pliku w tej transformacji umożliwia wybranie miejsca docelowego, w którym zostanie zapisany wyeksportowany wynik, w dokumencie PlaidCloud.
Wybierasz katalog i podajesz nazwę pliku docelowego.
Tabela źródłowa
Opcja dynamiczna
Opcja dynamiczna umożliwia określenie tabeli za pomocą tekstu, w tym zmiennych. Jest to przydatne w przepływach pracy sterowanych zmiennymi, w których odwołania do tabel i widoków zależą od określonych zmiennych.
Przykład użycia zmiennej current_month do dynamicznego wskazania tabeli źródłowej:
legal_entity/inputs/{current_month}/ledger_valuesOpcja statyczna
Jeśli jako źródło eksportu ma służyć konkretna tabela, pozostaw niezaznaczone pole Dynamiczna i wybierz tabelę źródłową.
Funkcja Eksplorator tabel jest zawsze dostępna przy wyborze dowolnej tabeli. Kliknij przycisk Eksplorator tabel po prawej stronie wyboru tabeli, a otworzy się okno Eksploratora tabel.
Wybór konta dokumentów
Wybierz konto dokumentów PlaidCloud, do którego masz dostęp. Umożliwi to wybranie katalogu w następnym kroku.
W projekcie lista zawiera też na górze pozycję Domyślne projektu — zastępuje ona konto, które jest aktualnie ustawione w projekcie jako domyślne. Nowy krok wstępnie wybiera Domyślne projektu, gdy projekt je ma; istniejący krok zachowuje konto, z którym został zapisany, dopóki go nie zmienisz. Krok pozostawiony na Domyślne projektu działa na koncie, które w danym momencie jest domyślne dla projektu — jeśli żadne nie jest ustawione, uruchomienie kończy się niepowodzeniem i wskazuje projekt, zamiast wybrać inne konto.
Ścieżka katalogu docelowego
Wybierz ikonę Przeglądaj po prawej stronie pola Ścieżka katalogu i przejdź do lokalizacji, w której ma zostać zapisany plik.
Nazwa pliku docelowego
Podaj nazwę, pod którą ma zostać zapisany wyeksportowany plik.
Typ pliku wyjściowego
Dział zatytułowany „Typ pliku wyjściowego”Wszystkie eksportowane pliki są nieskompresowane, ale dostępne są następujące opcje kompresji:
- Zip
- GZip
- BZip2
Wybór danych tabeli
Dział zatytułowany „Wybór danych tabeli”Konfiguracja Data Mapper
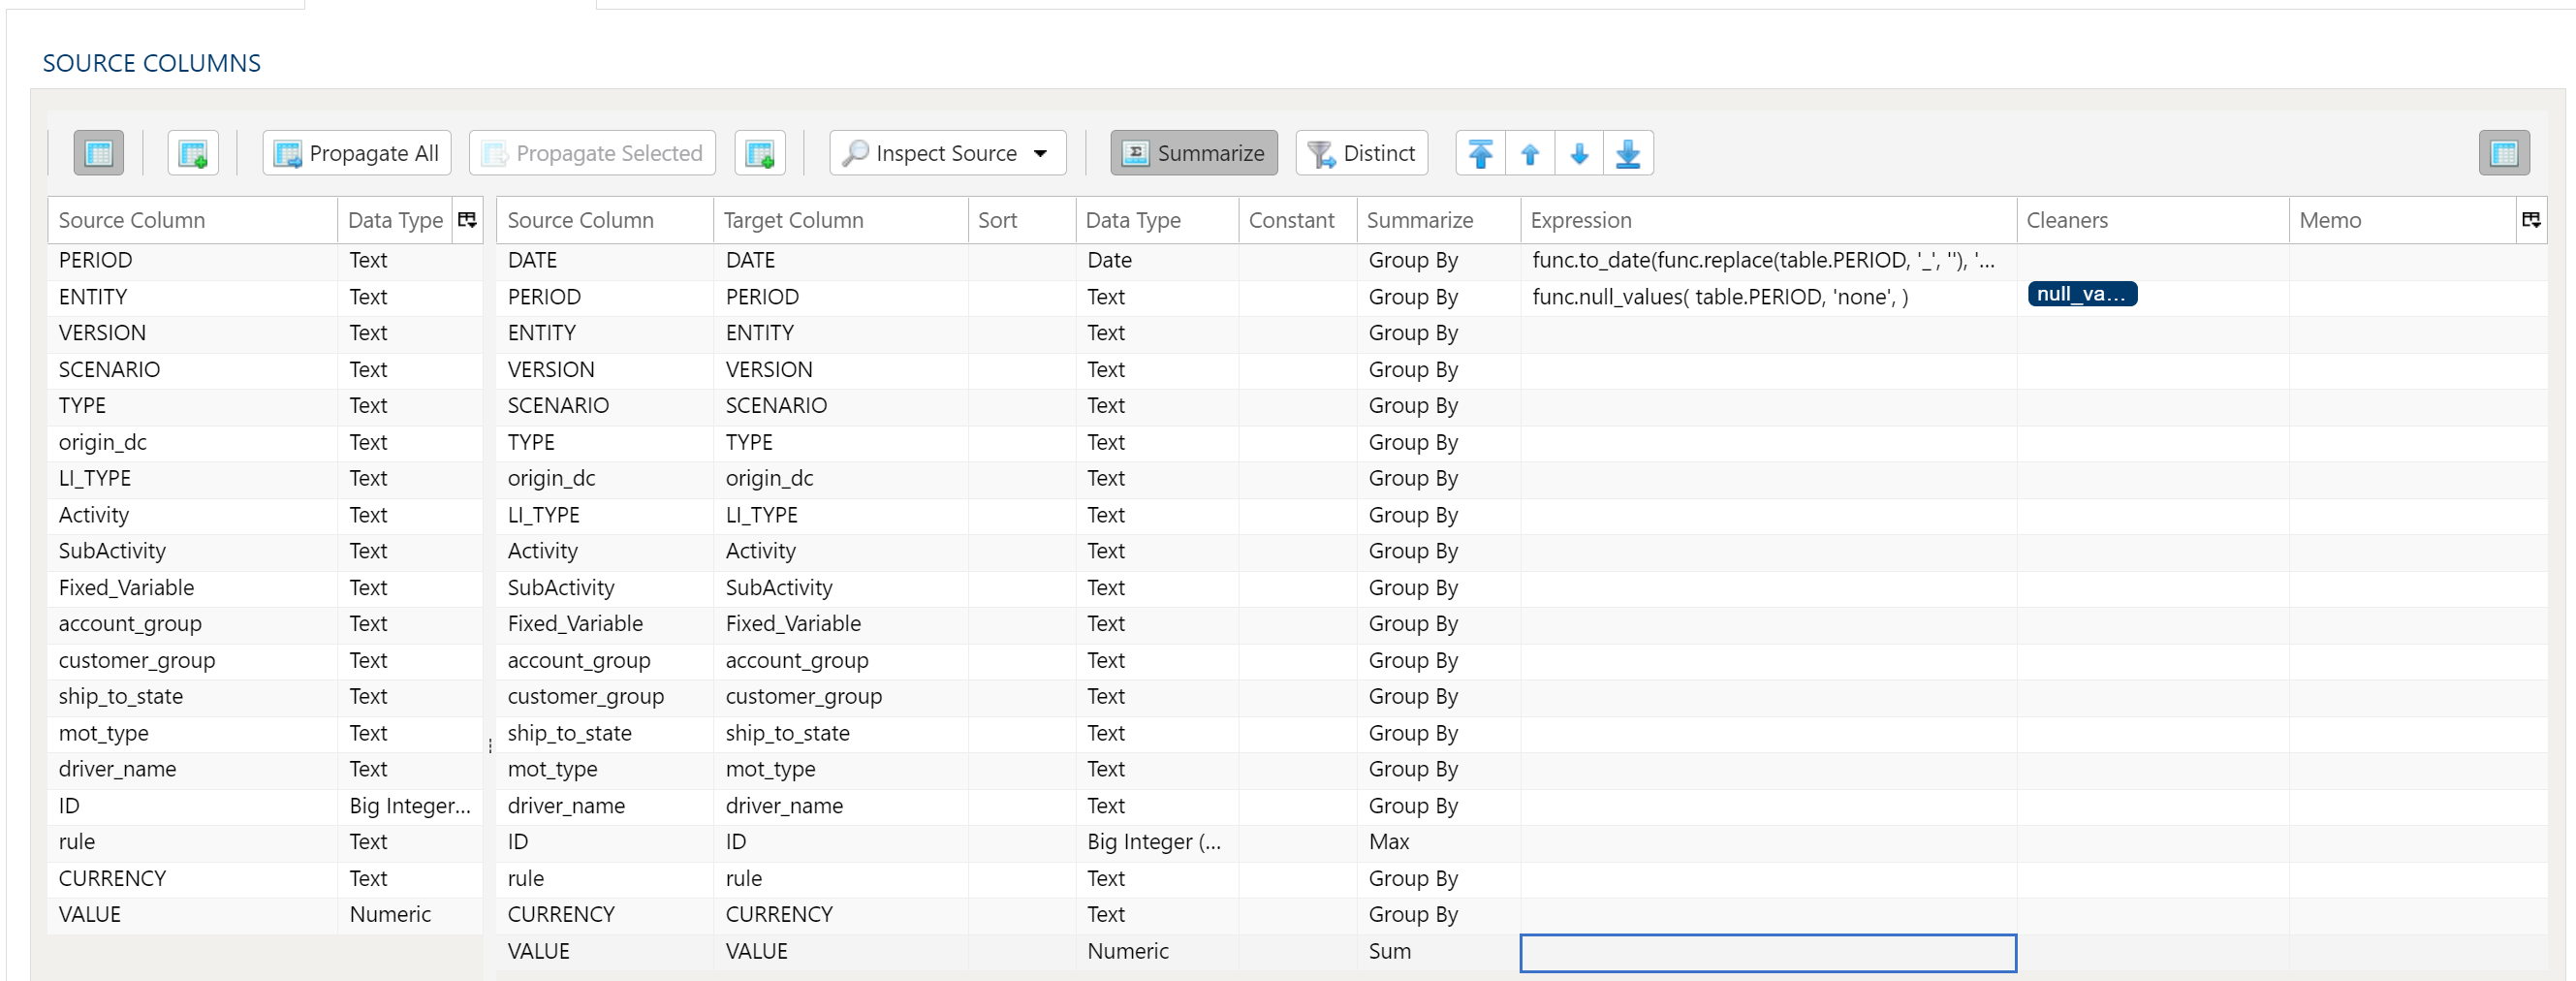
Data Mapper służy do mapowania kolumn z danych źródłowych na tabelę danych docelowych.
Sprawdzanie źródła i wypełnianie mappera
Przycisk menu Sprawdź źródło udostępnia dodatkowe sposoby mapowania kolumn ze źródła na cel:
- Wypełnij obie tabele mapowania: propaguje wszystkie wartości z tabeli danych źródłowych do tabeli danych docelowych. Jest to ustawienie domyślne.
- Wypełnij tylko tabelę mapowania źródła: mapuje wszystkie wartości wyłącznie w tabeli danych źródłowych. Jest to przydatne przy modyfikowaniu istniejącego przepływu pracy, gdy zmieniła się struktura kolumn źródłowych.
- Wypełnij tylko tabelę mapowania celu: propaguje wszystkie wartości wyłącznie do tabeli danych docelowych.
Jeśli opcje kolumn źródłowych i docelowych nie wystarczą, kolejne kolumny można dodać do tabeli danych docelowych na kilka sposobów:
- Propaguj wszystko wstawia wszystkie kolumny źródłowe do tabeli danych docelowych, niezależnie od tego, czy już w niej istniały.
- Propaguj zaznaczone wstawia tylko zaznaczone kolumny źródłowe.
- Kliknij prawym przyciskiem myszy po stronie docelowej i wybierz Wstaw wiersz, aby wstawić wiersz bezpośrednio nad aktualnie zaznaczonym wierszem.
- Kliknij prawym przyciskiem myszy po stronie docelowej i wybierz Dołącz wiersz, aby wstawić wiersz na dole (z prawej strony) tabeli danych docelowych.
Usuwanie kolumn
Aby usunąć kolumny z tabeli danych docelowych, zaznacz wybrane kolumny, kliknij prawym przyciskiem myszy i wybierz Usuń.
Kolumny źródłowe, których nie ma już na liście
Wiersz docelowy może wskazywać Kolumnę źródłową, której tabela danych źródłowych już nie zawiera, na przykład po ponownym sprawdzeniu źródła. Krok nigdy sam nie usuwa takiego wiersza. Zamiast tego nazwa kolumny jest wyświetlana na czerwono, za znakiem ostrzegawczym ⚠, a po najechaniu na nią kursorem pojawia się informacja, że kolumny nie ma wśród kolumn źródłowych. W kroku z kilkoma tabelami, takim jak unia, każda tabela jest sprawdzana względem własnych kolumn źródłowych.
Wiersz ze Stałą, Wyrażeniem lub podsumowaniem Liczba (z wartościami null) nigdy nie jest oznaczany, ponieważ krok nie odczytuje jego kolumny źródłowej. Nic nie jest oznaczane, dopóki tabela danych źródłowych nie zawiera żadnych kolumn, na przykład przed pierwszym sprawdzeniem źródła.
Podczas zapisywania kroku, który nadal ma oznaczone wiersze, okno Znaleziono nieaktualne kolumny wyświetla je pod kartą lub tabelą, do której należą, i oferuje trzy opcje:
- Usuń wszystkie i zapisz — usuń oznaczone wiersze, a następnie zapisz.
- Zapisz mimo to — zapisz krok bez zmian.
- Anuluj — wróć do kroku bez zapisywania.
Aby zachować wiersz i usunąć jego ostrzeżenie, dodaj kolumnę z powrotem do tabeli danych źródłowych albo wybierz kolumnę, którą ta tabela zawiera.
Typ danych kolumny
Każda kolumna docelowa ma Typ. Kolumna propagowana ze źródła zachowuje typ kolumny źródłowej; dodany ręcznie wiersz ma początkowo typ Tekst, a w polu Typ określasz, czym kolumna ma faktycznie być — kolumna, którą zamierzasz sumować lub sortować, wymaga typu liczbowego albo daty, ponieważ tekst jest sortowany i sumowany jako tekst.
Krok zapisany z kolumną bez żadnego typu nadal się uruchamia. Typ jest ustalany w chwili rozpoczęcia kroku na podstawie kolumny źródłowej, którą ta kolumna odczytuje. Jeśli nie ma z czego go odczytać, traktowany jest jako tekst: kolumny kroku Wyodrębnij SQL pochodzą z napisanego przez Ciebie zapytania, a nie z zmapowanego źródła, a gdy kilka źródeł zawiera kolumnę o tej samej nazwie, lecz o niezgodnych typach, używany jest tekst zamiast zgadywania jednego z nich — błędne odgadnięcie powoduje konwersję, którą magazyn danych może odrzucić, a wszystko można przekonwertować na tekst.
Samodzielne ustawienie pola Typ nadal jest sposobem na określenie, czym kolumna ma być. Pozostawienie go nieustawionego oznacza zgodę na to, czym akurat jest kolumna źródłowa.
Zmiana kolejności kolumn
Aby zmienić kolejność kolumn w tabeli danych docelowych, zaznacz wybrane kolumny. Możesz użyć jednej z poniższych metod:
- Strzałki przenoszenia zbiorczego: wybierz odpowiednią opcję przenoszenia za pomocą strzałek w prawym górnym rogu
- Menu kontekstowe: kliknij prawym przyciskiem myszy i wybierz Przenieś na początek, Przenieś w górę, Przenieś w dół lub Przenieś na koniec.
Ograniczanie wyniku do unikalnych rekordów
Aby zwrócić tylko unikalne wartości, wybierz opcję menu Unikalne. Spowoduje to wyświetlenie zestawu pól wyboru dla każdej kolumny źródła. Wystarczy zaznaczyć pole obok odpowiedniej kolumny, aby zwrócić tylko unikalne wyniki.
W zależności od sytuacji warto rozważyć zastosowanie podsumowania.
Proces usuwania duplikatów zachowuje pierwszy znaleziony unikalny rekord, a pozostałe odrzuca. Jeśli spójność między uruchomieniami jest ważna, warto zastosować sortowanie danych.
Agregacja i grupowanie
Aby agregować wyniki, wybierz opcję menu Podsumuj. Spowoduje to wyświetlenie zestawu pól wyboru dla każdej kolumny w tabeli danych docelowych. Wybierz odpowiednią metodę podsumowania dla każdej kolumny.
Gdy Sprawdź źródło wypełnia kolumny, kolumna liczbowa zaczyna jako Grupuj według zamiast Suma, jeśli jej nazwa wygląda na identyfikator, na przykład id, customer_id, Order No lub CustomerKey, jeśli jej tabela ustawia ją jako klucz albo jeśli złączenie używa jej jako klucza.
- Grupuj według
- Suma
- Min
- Maks
- Pierwsza
- Ostatnia
- Liczba
- Liczba (z wartościami null)
- Średnia
- Odchylenie standardowe
- Odchylenie standardowe z próby
- Odchylenie standardowe z populacji
- Wariancja
- Wariancja z próby
- Wariancja z populacji
- Zaawansowane bez grupowania
Informacje o zaawansowanym użyciu Data Mapper, takim jak wyrażenia, czyszczenie i stałe, znajdziesz w artykule Zaawansowane użycie Data Mapper
Filtry danych
Dział zatytułowany „Filtry danych”
Aby zapewnić maksymalną elastyczność, filtry danych są dostępne zarówno dla danych źródłowych, jak i docelowych. W przypadku większych zbiorów danych szczególnie korzystne może być odfiltrowanie wierszy już na źródle, aby pozostałe operacje były wykonywane na mniejszym zbiorze danych.
Wybierz podzbiór danych
Ten typ filtru umożliwia filtrowanie przychodzących danych źródłowych na podstawie określonych warunków.
Zastosuj filtr wtórny do danych wynikowych
Ten typ filtru umożliwia zastosowanie filtru do danych wynikowych po transformacji na podstawie określonych warunków. Możliwość zastosowania filtru do wyniku po transformacji pozwala na wykluczenia oparte na wynikach złożonych obliczeń, podsumowań lub funkcji okienkowych.
Końcowe wycinanie tabeli danych (limit)
Wycinanie wierszy umożliwia ograniczenie liczby wierszy w zbiorze wynikowym na podstawie zakresu i punktu początkowego.
Składnia filtrów
Składnia filtrów korzysta z Python SQLAlchemy, czyli tej samej składni, która obowiązuje w innych wyrażeniach.
Przykłady i funkcje wyrażeń znajdziesz w obszarze Wyrażenia.
Przykłady
Dział zatytułowany „Przykłady”Brak przykładów…