Allocation By Assignment Dimension
Alokuje wartości z tabeli źródłowej na cele na podstawie wymiaru przypisania i tabeli danych sterujących. Jest to najbardziej elastyczny krok alokacji — używaj go do rozdziału opartego na kluczu alokacji, gdzie miejsce docelowe każdego wiersza źródłowego wyznacza hierarchia, a wartości sterujące określają, ile trafia gdzie.
Typowe wzorce: rozdzielenie sum centrów kosztów na linie produktów na podstawie godzin aktywności; rozdzielenie kosztów ogólnych IT między jednostki biznesowe na podstawie liczby pracowników; alokacja kosztów usług wspólnych za pomocą niestandardowego ważenia.
Ustawienia tabeli danych
Dział zatytułowany „Ustawienia tabeli danych”Hierarchia wymiaru przypisania
Dział zatytułowany „Hierarchia wymiaru przypisania”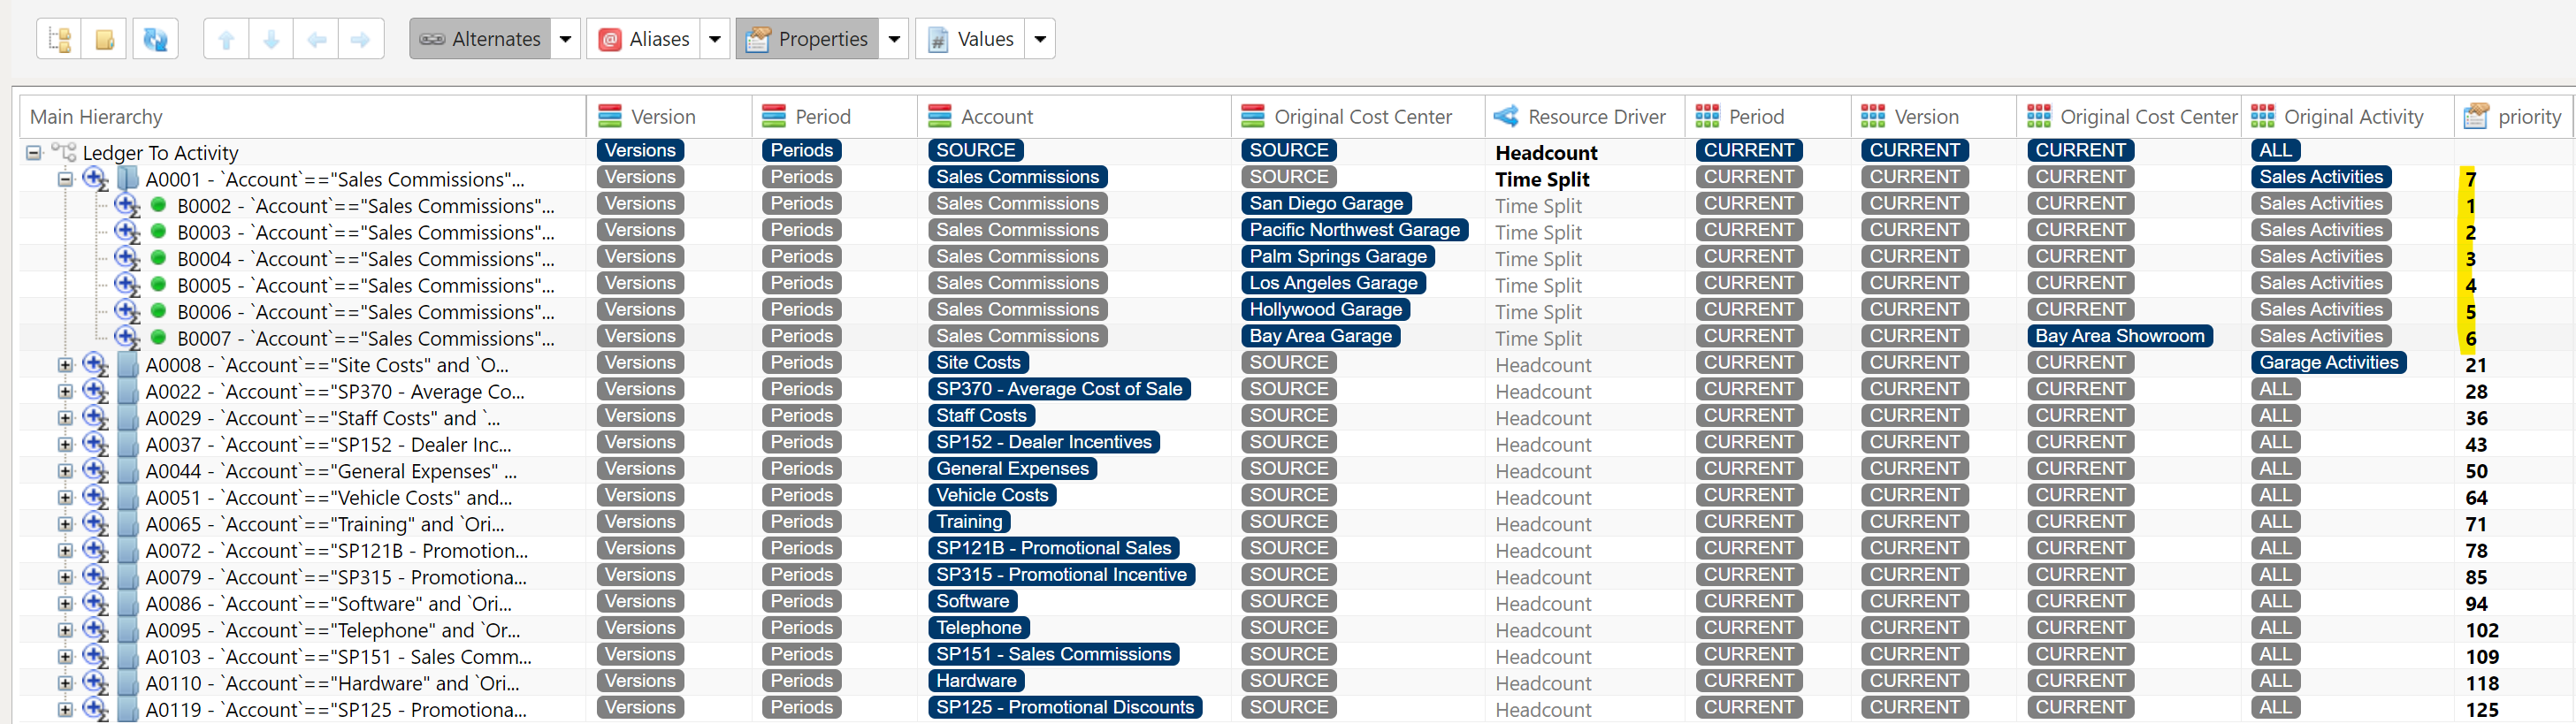
Hierarchia wymiaru przypisania daje możliwość wskazywania, klikania i filtrowania Tabeli wartości do alokacji, Tabeli danych sterujących lub obu, aby tworzyć ukierunkowane alokacje. Hierarchia wymiaru przypisania powstaje przez połączenie wymiarów, które odwołują się do Tabeli wartości do alokacji i Tabeli danych sterujących.
Tworzenie hierarchii wymiaru przypisania
Dział zatytułowany „Tworzenie hierarchii wymiaru przypisania”Aby utworzyć Hierarchię wymiaru przypisania, musisz najpierw utworzyć wymiary, których chcesz używać jako filtrów dla Tabeli wartości do alokacji i Tabeli danych sterujących. Poniższe linki poprowadzą Cię przez tworzenie tych wymiarów.
Tworzenie hierarchii głównej
Dział zatytułowany „Tworzenie hierarchii głównej”Po utworzeniu wymiarów dla Tabeli wartości do alokacji i Tabeli danych sterujących następnym krokiem jest zdecydowanie, który z wymiarów Tabeli wartości do alokacji posłuży jako Hierarchia główna dla Hierarchii wymiaru przypisania.
Skopiuj ten wymiar, przechodząc do karty Wymiary w PlaidCloud, klikając wymiar, a następnie wybierając Akcje i Kopiuj wymiar. Po skopiowaniu wymiaru pojawi się okno z prośbą o wpisanie nazwy skopiowanego wymiaru.
Dodawanie wymiarów do hierarchii przypisania
Dział zatytułowany „Dodawanie wymiarów do hierarchii przypisania”Otwórz nowo utworzony Wymiar przypisania, kliknij strzałkę w dół obok pozycji Właściwości i wybierz Nowa właściwość.
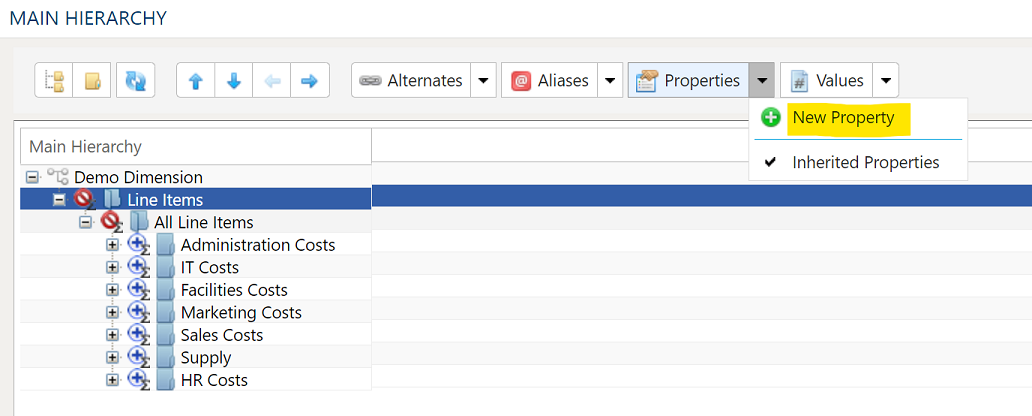
Otworzy to okno dialogowe Konfiguracja właściwości:
Konfiguracja właściwości
Dział zatytułowany „Konfiguracja właściwości”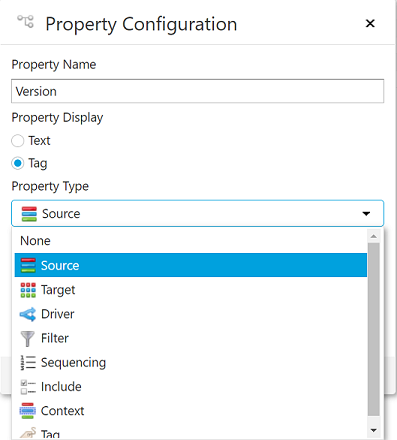
- Nazwa właściwości - Zwykle jest to nazwa wymiaru dodawanego do hierarchii przypisania.
- Wyświetlanie właściwości - Należy ustawić „Tag”.
- Typ właściwości - Ta właściwość informuje krok alokacji, z którą tabelą — Tabelą wartości do alokacji czy Tabelą danych sterujących — wiąże się dany wymiar.
- Źródło - Używane w połączeniu z Tabelą wartości do alokacji.
- Cel - Używany w połączeniu z Tabelą danych sterujących.
- Driver - Służy do filtrowania Tabeli danych sterujących po wybranym kluczu alokacji.
- Kontekst - Gdy Tabela wartości do alokacji i Tabela danych sterujących zawierają ten sam wymiar, kontekstu można użyć do określenia, jak wymiary mają się do siebie odnosić. Kontekst jest często używany, gdy obie tabele, Tabela wartości do alokacji i Tabela danych sterujących, zawierają Profit / Cost Centers lub Geography.
- Pozostawione puste - Węzeł bez własnego kontekstu przejmuje kontekst najbliższego przodka, który go ustawia, więc pusta komórka oznacza dziedziczenie, a nie brak kontekstu. Dopiero gdy żaden przodek też go nie ustawia, Tabela danych sterujących wraca do filtrowania według własnego ustawienia wymiaru docelowego.
- Bieżące - Działa jako przekazanie i filtruje Tabelę danych sterujących na podstawie ustawień wymiaru docelowego. Przykładowo, jeśli Kontekst opiera się na wymiarze Profit Center, a wymiar docelowy Profit Center jest ustawiony na Wszystkie, dane sterujące będą filtrowane po wszystkich Profit Centers. Ponieważ jest to wartość zapisana, zatrzymuje także dziedziczenie opisane powyżej, więc Bieżące to sposób, w jaki węzeł mówi „tutaj brak kontekstu”, gdy ustawia go przodek — wyczyszczenie komórki zamiast tego przekazałoby węzłowi kontekst jego przodka.
- Nadrzędne - Po wybraniu element nadrzędny Profit Center z Tabeli wartości do alokacji będzie używany do filtrowania wartości sterujących w Tabeli danych sterujących. Jest to przydatne, gdy wartości sterujące są czasem niedostępne dla konkretnego Profit Center, ale często są dostępne na poziomie nadrzędnym.
- Wszystkie - Po wybraniu Profit Center z Tabeli wartości do alokacji nie będzie filtrować wartości sterujących w Tabeli danych sterujących; użyte zostaną wartości sterujące dla wszystkich Profit Centers.
- Nieprzypisane - Zamiast wierszy sterujących, które wybrałby wymiar docelowy, używane są tylko te, których Profit Center nie ma żadnej wartości lub ma wartość
UNASSIGNED(w dowolnej wielkości liter), a Profit Center nie dzieli wyniku. Użyj tego dla reguły, która rozdziela koszty, których nie posiada żaden Profit Center. Dotyczy tylko reguły, która go ustawia — inna reguła pozostawiająca tę samą kolumnę pustą nie jest nim objęta.
- Typ edytora - Tę listę rozwijaną należy ustawić na Select Dimension.
Po wybraniu odpowiednich właściwości dla wymiaru dodawanego do hierarchii przypisania wybierz „Edytuj konfigurację”.
Konfiguracja wymiaru
Dział zatytułowany „Konfiguracja wymiaru”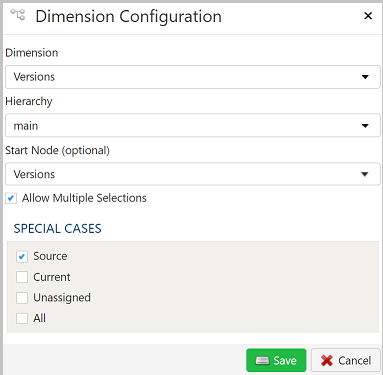
- Wymiar - Użyj listy rozwijanej, aby wybrać wymiar.
- Hierarchia - Jeśli wybrany wymiar ma hierarchie alternatywne, pojawią się one tutaj i będzie można je wybrać obok hierarchii głównej.
- Węzeł początkowy - Jeśli nie chcesz, aby wymiar był wyświetlany od węzła najwyższego, możesz wybrać dowolny węzeł w hierarchii jako węzeł, od którego wymiar będzie wyświetlany.
- Zezwalaj na wielokrotny wybór - Po zaznaczeniu użytkownik będzie mógł wybrać wiele węzłów w hierarchii.
- Przypadki szczególne - Po zaznaczeniu przypadki szczególne będą dostępne do wyboru w liście rozwijanej wymiaru. Zwykle są używane w wymiarach Cel.
- Źródło - Gdy wymiar jest ustawiony na Źródło, alokacja pominie ten wymiar podczas filtrowania Tabeli danych sterujących, ale zaalokowane wyniki będą zawierać wartości z tego wymiaru.
- Bieżące - Może być używane, gdy wymiar jest współdzielony między Źródło i Cel. Gdy wymiar Cel jest ustawiony na Bieżące, Tabela danych sterujących będzie filtrowana według bieżącej wartości wymiaru Źródło w trakcie wykonywania alokacji. Przykładem jest sytuacja, gdy w Tabeli wartości do alokacji i Tabeli danych sterujących jest wiele okresów, ale chcesz alokować w obrębie okresów, a nie między nimi. Często używa się też Bieżące dla Business Units, Cost Centers i Geographies.
- Nieprzypisane - Gdy wymiar jest ustawiony na Nieprzypisane, alokacja pominie ten wymiar podczas filtrowania Tabeli danych sterujących, a wynik alokacji dla tego wymiaru będzie wartością Null.
- Wszystkie - Gdy wymiar jest ustawiony na ALL, alokacja użyje wszystkich wartości w wymiarze.
Tabelę wartości do alokacji, Tabelę danych sterujących i Tabelę wyników alokacji można wybierać dynamicznie lub statycznie.
Dynamiczny wybór tabeli
Dział zatytułowany „Dynamiczny wybór tabeli”Opcja dynamiczna pozwala określić tabelę za pomocą tekstu i zmiennych. Jest to przydatne w przepływach pracy sterowanych zmiennymi, gdzie odwołania do tabeli lub widoku są względne wobec podanych zmiennych.
Przykład, który używa zmiennej current_month do dynamicznego wskazania tabeli:
legal_entity/inputs/{current_month}/ledger_valuesStatyczny wybór tabeli
Dział zatytułowany „Statyczny wybór tabeli”Gdy jako źródło ma być użyta konkretna tabela, pozostaw niezaznaczone pole Dynamiczna i wybierz tabelę źródłową z listy rozwijanej.
Eksplorator tabel jest zawsze dostępny przy każdym wyborze tabeli. Kliknij przycisk Eksploratora tabel po prawej stronie wyboru tabeli, a otworzy się okno Eksploratora tabel.
Tabela wartości do alokacji
Dział zatytułowany „Tabela wartości do alokacji”Jest to tabela zawierająca wartości, które mają być alokowane. Są to zwykle wartości kosztów lub przychodów.
Tabela danych sterujących
Dział zatytułowany „Tabela danych sterujących”Tabela danych sterujących zawiera wartości, których krok alokacji użyje do alokacji kosztów.
Przykłady:
- W łańcuchu dostaw, aby przypisać koszty klientom, możesz użyć danych o dostawach, z liczbą dostaw lub wagą dostaw jako kluczem alokacji.
- Aby dział pomocy technicznej IT przypisał swoje koszty obsługiwanym działom, danymi sterującymi może być liczba zgłoszeń według centrum kosztów.
Reguła znaku danych sterujących
Dział zatytułowany „Reguła znaku danych sterujących”Dane sterujące mogą zawierać zarówno wartości dodatnie, jak i ujemne. Reguła znaku danych sterujących pozwala zdecydować, jak będą obsługiwane sprzeczne znaki.
- Błąd przy sprzecznych znakach - Krok alokacji zgłosi błąd i zatrzyma się, jeśli napotka sprzeczne znaki.
- Kontynuuj z ostrzeżeniem przy sprzecznych znakach - Krok alokacji użyje zarówno ujemnych, jak i dodatnich wartości sterujących, ale wyświetli ostrzeżenie.
- Używaj tylko dodatnich wartości sterujących - Krok alokacji użyje tylko dodatnich wartości sterujących i zignoruje wartości ujemne.
- Używaj tylko ujemnych wartości sterujących - Krok alokacji użyje tylko ujemnych wartości sterujących i zignoruje wartości dodatnie.
- Używaj wartości bezwzględnych danych sterujących - Krok alokacji użyje wartości bezwzględnych danych sterujących.
Dopasowanie rekordów do więcej niż jednej reguły
Dział zatytułowany „Dopasowanie rekordów do więcej niż jednej reguły”Domyślnie rekord podlega tylko pierwszej regule, do której pasuje. Odznacz Dopasuj rekordy tylko do jednej reguły, a rekord podlega każdej regule, do której pasuje: pojawia się raz dla każdej z nich, a rekord, który nie pasuje do żadnej reguły, jest pomijany.
Reguły można także podzielić na iteracje za pomocą właściwości wymiaru przypisania typu Sekwencjonowanie, której wartością jest iteracja, w której uruchamiana jest każda reguła. Krok z odznaczoną opcją Dopasuj rekordy tylko do jednej reguły nie może robić obu rzeczy: jeśli uruchamiane reguły przypadają na więcej niż jedną iterację, krok zatrzymuje się z komunikatem Cannot apply rules when there are multiple iterations and records can match more than one rule. Zaznacz tę opcję lub uruchom każdą iterację jako osobny krok.
Tabele pośrednie
Dział zatytułowany „Tabele pośrednie”Tabele pośrednie są tworzone przy każdym uruchomieniu kroku alokacji i zawierają podsumowanie przetwarzania alokacji. Tabele pośrednie pokazują, jak przebiega proces alokacji, i służą do diagnozowania nieoczekiwanych wyników.
- Ścieżki - Pokazuje liczbę unikatowych ścieżek alokacji podsumowanych z hierarchii przypisania.
- Mapowanie - Pokazuje, jak każdy wiersz Tabeli wartości do alokacji jest mapowany na cele alokacji.
- Podsumowanie - Pokazuje każdą regułę, wynikającą z hierarchii przypisania, oraz ile rekordów z Tabeli wartości do alokacji do niej pasuje.
Gdy opcja Dopasuj rekordy tylko do jednej reguły jest zaznaczona, rekord, do którego nie pasuje żadna reguła, ma puste kolumny reguł w tabeli Mapowanie i jest liczony w wierszu Podsumowanie, który nie wskazuje żadnej reguły. Wartość pozostawiona przez regułę pustą jest również pusta. Puste oznacza null, nigdy pusty ciąg znaków, a trzy tabele mają te same kolumny i typy, niezależnie od tego, czy zaznaczono Zastosuj reguły za pomocą SQL, nie Pandas.
Tabela wyników alokacji
Dział zatytułowany „Tabela wyników alokacji”Dołącz wyniki do tabeli docelowej
Dział zatytułowany „Dołącz wyniki do tabeli docelowej”Jeśli to pole jest zaznaczone, wyniki alokacji będą dołączane do tabeli wyników alokacji. Jeśli to pole nie jest zaznaczone, tabela wyników alokacji będzie nadpisywana przy każdym uruchomieniu kroku alokacji.
Oddzielne kolumny dla zaalokowanych wyników
Dział zatytułowany „Oddzielne kolumny dla zaalokowanych wyników”Jeśli to pole jest zaznaczone, tabela wyników pokaże kwotę każdego zaalokowanego rekordu oraz kwotę faktycznie zaalokowaną do każdego rekordu sterującego.
Zmień nazwy węzłów wymiaru
Dział zatytułowany „Zmień nazwy węzłów wymiaru”Jeśli to pole jest zaznaczone, podczas uruchamiania kroku alokacji zmieni on nazwę węzła wymiaru w wymiarze przypisania.
Opcje zaawansowane
Dział zatytułowany „Opcje zaawansowane”Liczba wątków
Dział zatytułowany „Liczba wątków”Ustawia liczbę współbieżnych operacji, których użyje krok alokacji.
Rozmiar porcji
Dział zatytułowany „Rozmiar porcji”Ustawia liczbę ścieżek alokacji w jednym wątku.
Mapa źródła alokacji
Dział zatytułowany „Mapa źródła alokacji”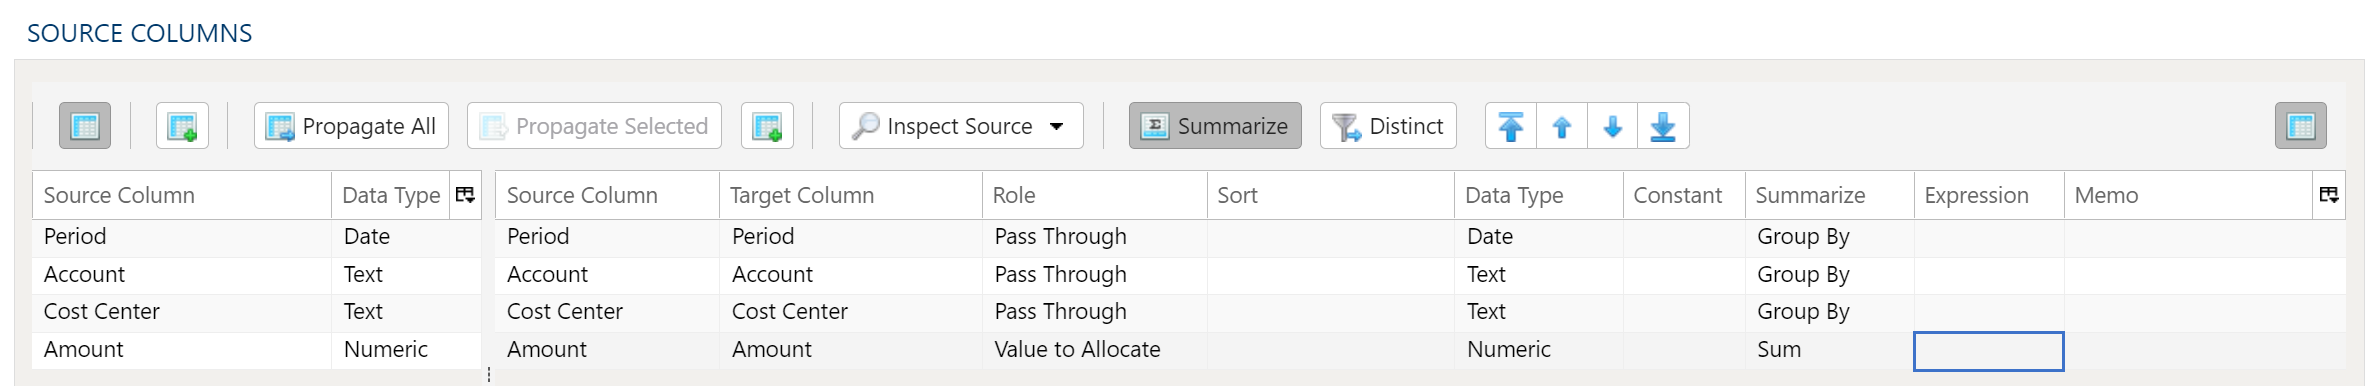
Mapa źródła alokacji służy do mapowania kolumn z tabeli Tabela wartości do alokacji, które zostaną użyte w kroku alokacji.
Sprawdzanie i wypełnianie mapowania
Przycisk menu Sprawdź źródło udostępnia dodatkowe sposoby mapowania kolumn ze źródła na cel:
- Wypełnij obie tabele mapowania: propaguje wszystkie wartości z tabeli danych źródłowych do tabeli danych docelowych. Jest to ustawienie domyślne.
- Wypełnij tylko tabelę mapowania źródła: mapuje wyłącznie wszystkie wartości w tabeli danych źródłowych. Ułatwia to modyfikowanie istniejącego przepływu pracy, gdy zmieniła się struktura kolumn źródłowych.
- Wypełnij tylko tabelę mapowania celu: propaguje wszystkie wartości wyłącznie do tabeli danych docelowych.
Jeśli opcje kolumn źródłowych i docelowych nie wystarczają, do tabeli danych docelowych można dodać kolejne kolumny na kilka sposobów:
- Propaguj wszystko wstawia wszystkie kolumny źródłowe do tabeli danych docelowych, niezależnie od tego, czy już w niej istniały.
- Propaguj zaznaczone wstawia tylko zaznaczone kolumny źródłowe.
- Kliknij prawym przyciskiem myszy po stronie docelowej i wybierz Wstaw wiersz, aby wstawić wiersz bezpośrednio nad aktualnie zaznaczonym wierszem.
- Kliknij prawym przyciskiem myszy po stronie docelowej i wybierz Dołącz wiersz, aby dodać wiersz na dole (z prawej strony) tabeli danych docelowych.
Rola
Każdej kolumnie w narzędziu Data Mapper trzeba przypisać rolę:
- Przekazanie - te kolumny pojawią się w tabeli wyników alokacji.
- Wartość do alokacji - kolumna zawierająca wartości do zaalokowania.
Usuwanie kolumn
Aby usunąć kolumny z tabeli danych docelowych, zaznacz wybrane kolumny, a następnie kliknij prawym przyciskiem myszy i wybierz Usuń.
Zmiana kolejności kolumn
Aby zmienić kolejność kolumn w tabeli danych docelowych, zaznacz wybrane kolumny. Możesz użyć jednej z poniższych metod:
- Strzałki przenoszenia zbiorczego: wybierz odpowiednią opcję przenoszenia za pomocą strzałek w prawym górnym rogu.
- Menu kontekstowe: kliknij prawym przyciskiem myszy i wybierz Przenieś na początek, Przenieś w górę, Przenieś w dół lub Przenieś na koniec.
Ograniczanie wyniku do unikalnych rekordów
Aby zwrócić tylko unikalne rekordy, wybierz opcję menu Unikalne. Spowoduje to wyświetlenie zestawu pól wyboru dla każdej kolumny źródła. Zaznacz pole obok odpowiedniej kolumny, aby zwrócić tylko unikalne wyniki.
W zależności od sytuacji warto rozważyć zastosowanie podsumowania.
Proces ten zachowuje pierwszy znaleziony unikalny rekord i odrzuca pozostałe. Jeśli spójność między kolejnymi uruchomieniami jest ważna, warto zastosować sortowanie danych.
Agregacja i grupowanie
Aby zagregować wyniki, wybierz opcję menu Podsumuj. Spowoduje to wyświetlenie zestawu list wyboru dla każdej kolumny w tabeli danych docelowych. Dla każdej kolumny wybierz odpowiednią metodę podsumowania.
- Grupuj według
- Suma
- Min
- Maks
- Pierwszy
- Ostatni
- Liczba
- Liczba (z wartościami null)
- Średnia
- Odchylenie standardowe
- Odchylenie standardowe z próby
- Odchylenie standardowe z populacji
- Wariancja
- Wariancja z próby
- Wariancja z populacji
- Zaawansowane bez grupowania
Informacje o zaawansowanym użyciu narzędzia Data Mapper, takim jak wyrażenia, czyszczenie i stałe, znajdziesz w artykule Zaawansowane użycie narzędzia Data Mapper
Filtry źródła alokacji
Dział zatytułowany „Filtry źródła alokacji”
Aby zapewnić maksymalną elastyczność, filtry danych są dostępne zarówno dla danych źródłowych, jak i docelowych. W przypadku większych zbiorów danych szczególnie korzystne może być odfiltrowanie wierszy już na źródle, aby pozostałe operacje były wykonywane na mniejszym zbiorze danych.
Wybierz podzbiór danych
Ten typ filtru umożliwia filtrowanie przychodzących danych źródłowych na podstawie określonych warunków.
Zastosuj filtr wtórny do danych wynikowych
Ten typ filtru umożliwia zastosowanie filtru do danych wynikowych po transformacji na podstawie określonych warunków. Możliwość zastosowania filtru do wyniku po transformacji pozwala na wykluczenia oparte na wynikach złożonych obliczeń, podsumowań lub funkcji okienkowych.
Końcowe wycinanie tabeli danych (limit)
Wycinanie wierszy umożliwia ograniczenie liczby wierszy w zbiorze wynikowym na podstawie zakresu i punktu początkowego.
Składnia filtrów
Składnia filtrów korzysta z Python SQLAlchemy, czyli tej samej składni, która obowiązuje w innych wyrażeniach.
Przykłady i funkcje wyrażeń znajdziesz w obszarze Wyrażenia.
Mapa danych sterujących
Dział zatytułowany „Mapa danych sterujących”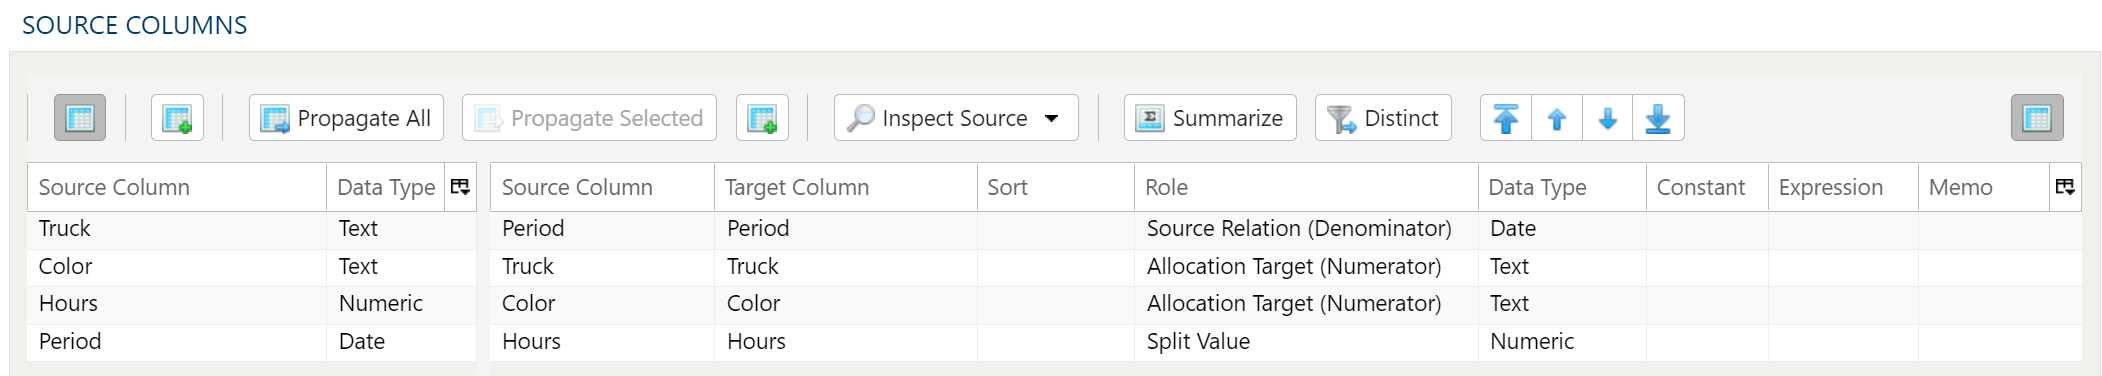
Mapa danych sterujących alokacji służy do mapowania kolumn z tabeli Tabela danych sterujących, które zostaną użyte w kroku alokacji.
Sprawdzanie i wypełnianie mapowania
Przycisk menu Sprawdź źródło udostępnia dodatkowe sposoby mapowania kolumn ze źródła na cel:
- Wypełnij obie tabele mapowania: propaguje wszystkie wartości z tabeli danych źródłowych do tabeli danych docelowych. Jest to ustawienie domyślne.
- Wypełnij tylko tabelę mapowania źródła: mapuje wyłącznie wszystkie wartości w tabeli danych źródłowych. Ułatwia to modyfikowanie istniejącego przepływu pracy, gdy zmieniła się struktura kolumn źródłowych.
- Wypełnij tylko tabelę mapowania celu: propaguje wszystkie wartości wyłącznie do tabeli danych docelowych.
Jeśli opcje kolumn źródłowych i docelowych nie wystarczają, do tabeli danych docelowych można dodać kolejne kolumny na kilka sposobów:
- Propaguj wszystko wstawia wszystkie kolumny źródłowe do tabeli danych docelowych, niezależnie od tego, czy już w niej istniały.
- Propaguj zaznaczone wstawia tylko zaznaczone kolumny źródłowe.
- Kliknij prawym przyciskiem myszy po stronie docelowej i wybierz Wstaw wiersz, aby wstawić wiersz bezpośrednio nad aktualnie zaznaczonym wierszem.
- Kliknij prawym przyciskiem myszy po stronie docelowej i wybierz Dołącz wiersz, aby dodać wiersz na dole (z prawej strony) tabeli danych docelowych.
Rola
Każdej kolumnie w narzędziu Data Mapper trzeba przypisać rolę:
- Relacja ze źródłem - te kolumny mają odpowiadające kolumny w tabeli Tabela wartości do alokacji.
- Cel alokacji - kolumny będą celem kroku alokacji i pojawią się w tabeli Tabela wyników alokacji.
- Wartość podziału - ta kolumna zawiera wartości, które posłużą do alokacji wartości z tabeli Tabela wartości do alokacji.
Usuwanie kolumn
Aby usunąć kolumny z tabeli danych docelowych, zaznacz wybrane kolumny, a następnie kliknij prawym przyciskiem myszy i wybierz Usuń.
Zmiana kolejności kolumn
Aby zmienić kolejność kolumn w tabeli danych docelowych, zaznacz wybrane kolumny. Możesz użyć jednej z poniższych metod:
- Strzałki przenoszenia zbiorczego: wybierz odpowiednią opcję przenoszenia za pomocą strzałek w prawym górnym rogu.
- Menu kontekstowe: kliknij prawym przyciskiem myszy i wybierz Przenieś na początek, Przenieś w górę, Przenieś w dół lub Przenieś na koniec.
Ograniczanie wyniku do unikalnych rekordów
Aby zwrócić tylko unikalne rekordy, wybierz opcję menu Unikalne. Spowoduje to wyświetlenie zestawu pól wyboru dla każdej kolumny źródła. Zaznacz pole obok odpowiedniej kolumny, aby zwrócić tylko unikalne wyniki.
W zależności od sytuacji warto rozważyć zastosowanie podsumowania.
Proces ten zachowuje pierwszy znaleziony unikalny rekord i odrzuca pozostałe. Jeśli spójność między kolejnymi uruchomieniami jest ważna, warto zastosować sortowanie danych.
Agregacja i grupowanie
Aby zagregować wyniki, wybierz opcję menu Podsumuj. Spowoduje to wyświetlenie zestawu list wyboru dla każdej kolumny w tabeli danych docelowych. Dla każdej kolumny wybierz odpowiednią metodę podsumowania.
- Grupuj według
- Suma
- Min
- Maks
- Pierwszy
- Ostatni
- Liczba
- Liczba (z wartościami null)
- Średnia
- Odchylenie standardowe
- Odchylenie standardowe z próby
- Odchylenie standardowe z populacji
- Wariancja
- Wariancja z próby
- Wariancja z populacji
- Zaawansowane bez grupowania
Informacje o zaawansowanym użyciu narzędzia Data Mapper, takim jak wyrażenia, czyszczenie i stałe, znajdziesz w artykule Zaawansowane użycie narzędzia Data Mapper
Filtry danych sterujących
Dział zatytułowany „Filtry danych sterujących”
Aby zapewnić maksymalną elastyczność, filtry danych są dostępne zarówno dla danych źródłowych, jak i docelowych. W przypadku większych zbiorów danych szczególnie korzystne może być odfiltrowanie wierszy już na źródle, aby pozostałe operacje były wykonywane na mniejszym zbiorze danych.
Wybierz podzbiór danych
Ten typ filtru umożliwia filtrowanie przychodzących danych źródłowych na podstawie określonych warunków.
Zastosuj filtr wtórny do danych wynikowych
Ten typ filtru umożliwia zastosowanie filtru do danych wynikowych po transformacji na podstawie określonych warunków. Możliwość zastosowania filtru do wyniku po transformacji pozwala na wykluczenia oparte na wynikach złożonych obliczeń, podsumowań lub funkcji okienkowych.
Końcowe wycinanie tabeli danych (limit)
Wycinanie wierszy umożliwia ograniczenie liczby wierszy w zbiorze wynikowym na podstawie zakresu i punktu początkowego.
Składnia filtrów
Składnia filtrów korzysta z Python SQLAlchemy, czyli tej samej składni, która obowiązuje w innych wyrażeniach.
Przykłady i funkcje wyrażeń znajdziesz w obszarze Wyrażenia.
Przykłady
Dział zatytułowany „Przykłady”Przykład 1
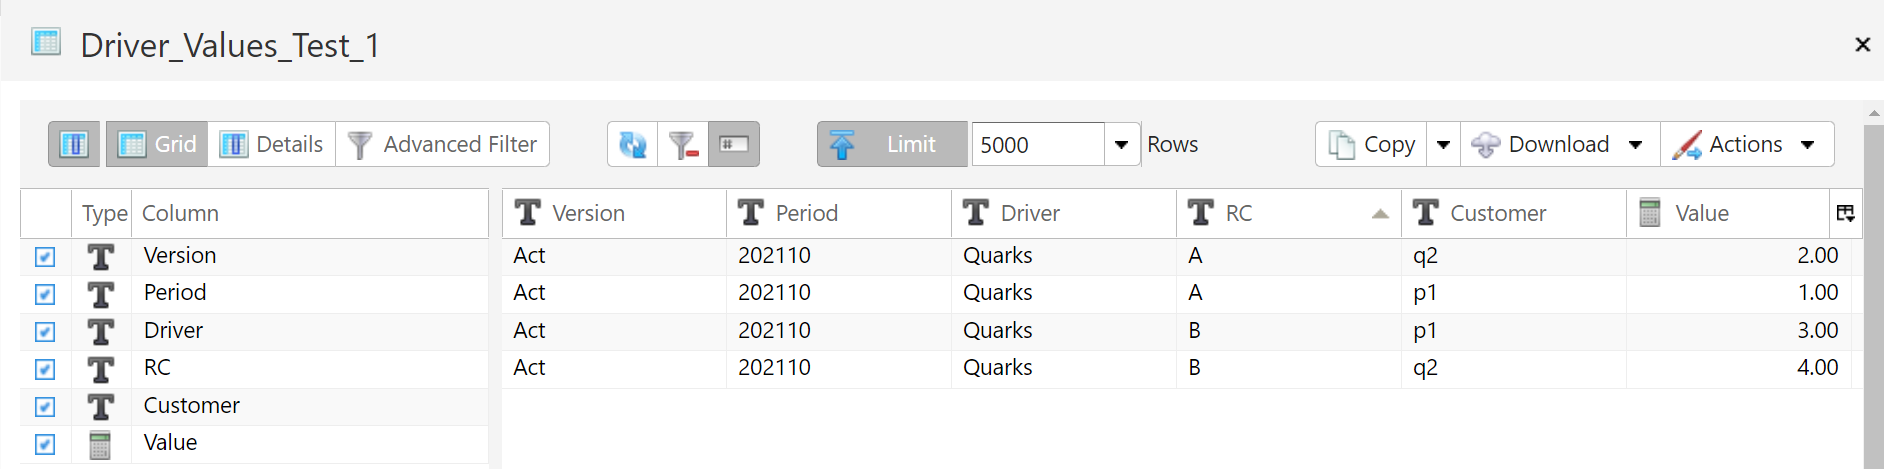
Dział zatytułowany „Przykład 1”Tabela wartości do alokacji
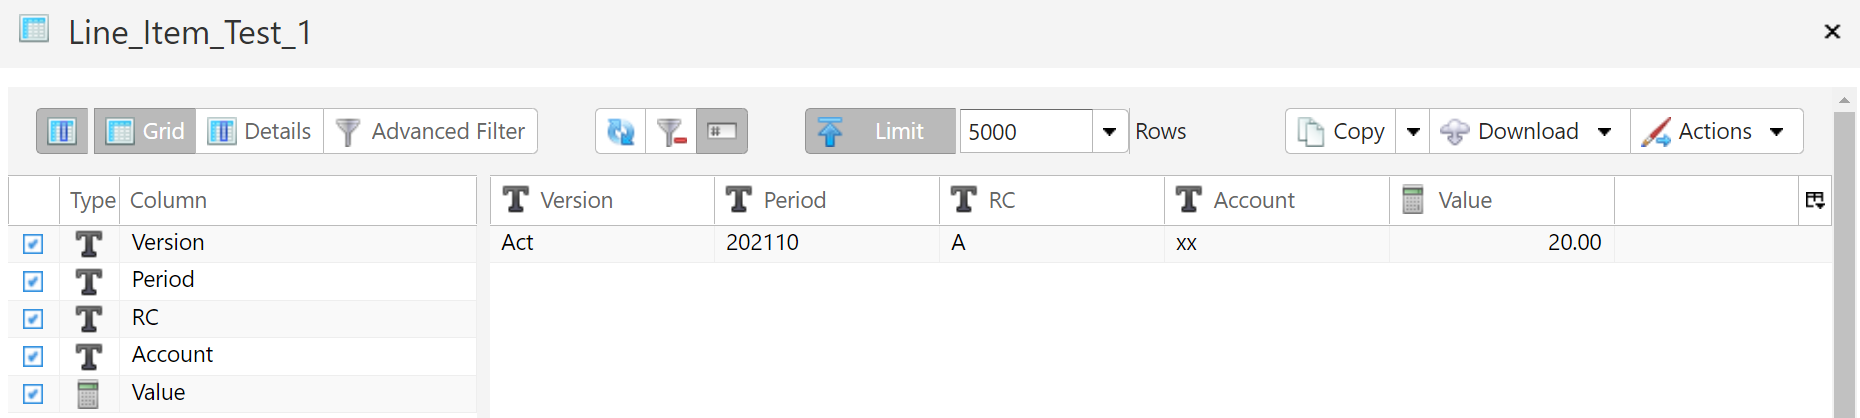
Tabela danych sterujących
Hierarchia wymiaru przypisania
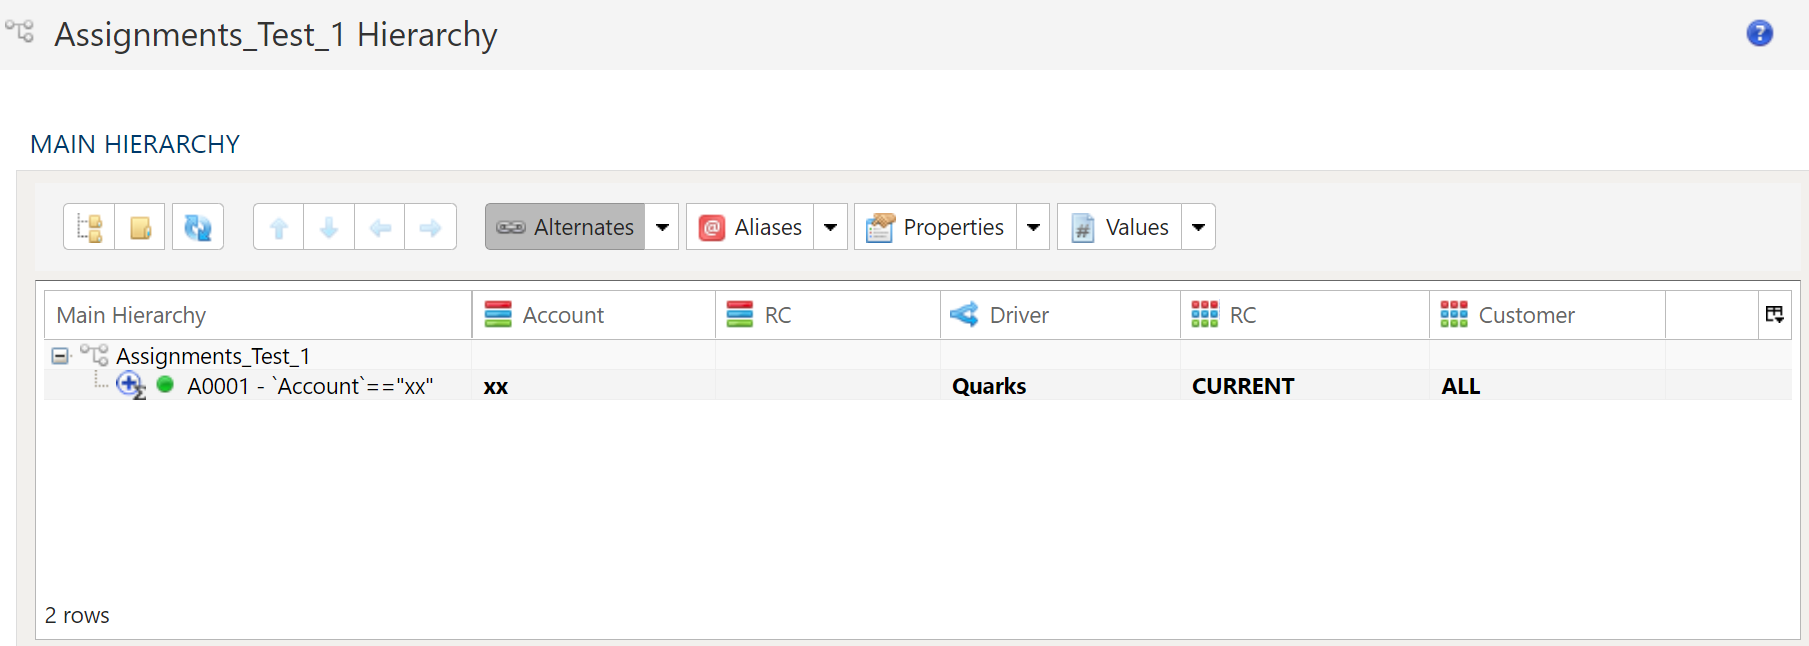
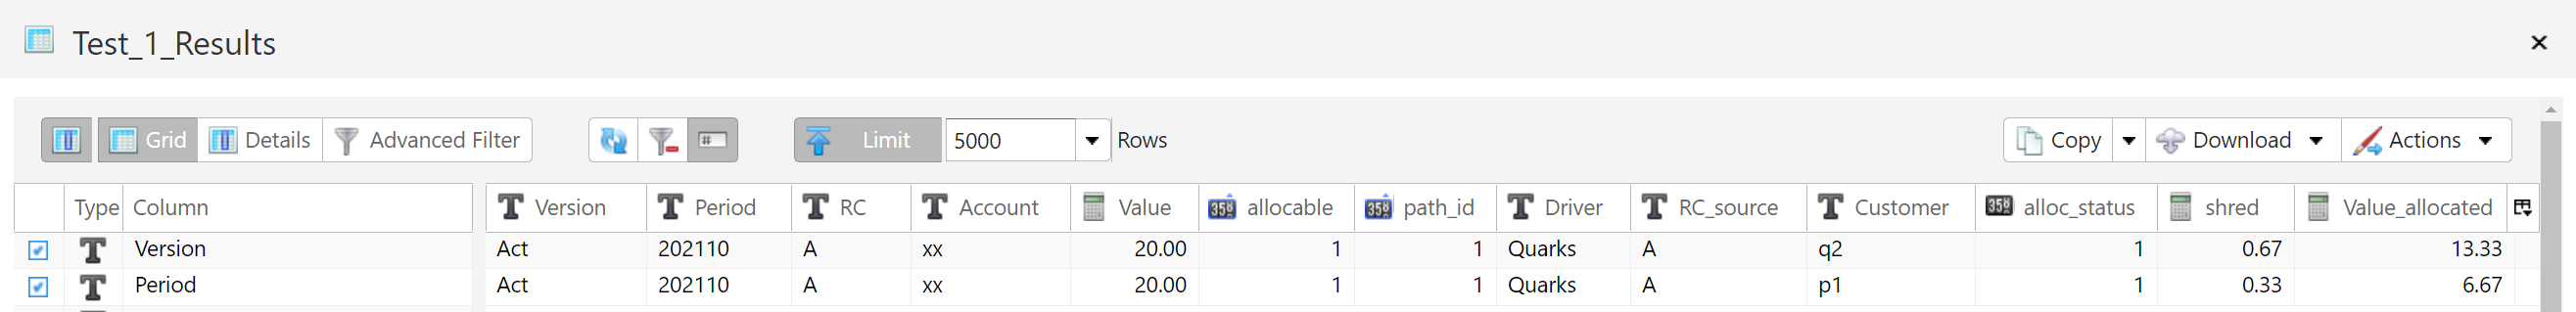
Ponieważ wymiar Target RC jest ustawiony na Bieżące, dane sterujące będą filtrowane według wartości Source RC w Tabeli wartości do alokacji. Ponieważ jedyną wartością w Source RC jest „A”, w kroku alokacji zostaną użyte tylko rekordy wartości sterujących, w których RC = A.
Tabela wyników alokacji
Przykład 2
Dział zatytułowany „Przykład 2”Tabela wartości do alokacji
Tabela danych sterujących
Hierarchia wymiaru przypisania
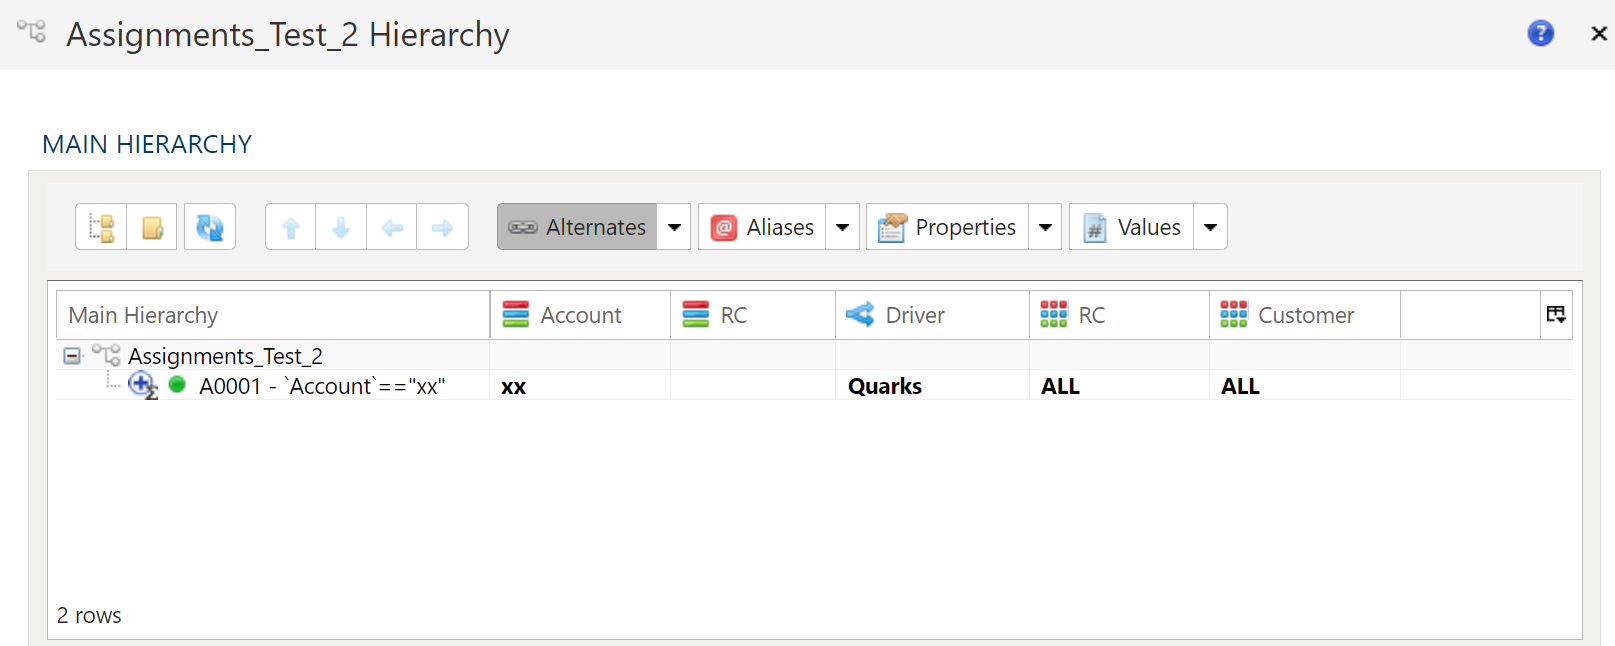
Ponieważ wymiar Target RC jest ustawiony na ALL, dane sterujące będą obejmować wszystkie wartości RC, co widać w kolumnie RC w Tabeli wyników alokacji.
Tabela wyników alokacji
Przykład 3
Dział zatytułowany „Przykład 3”Tabela wartości do alokacji
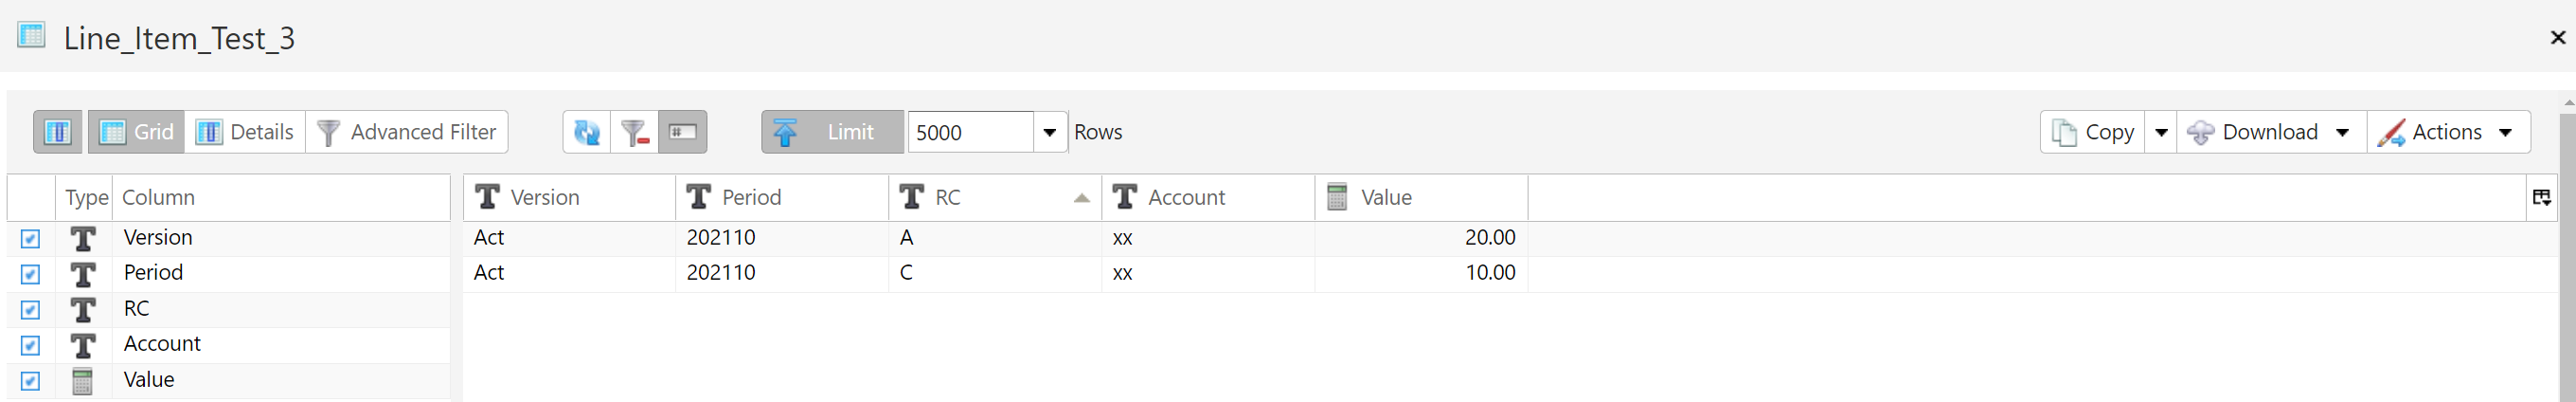
Tabela danych sterujących
Hierarchia wymiaru przypisania
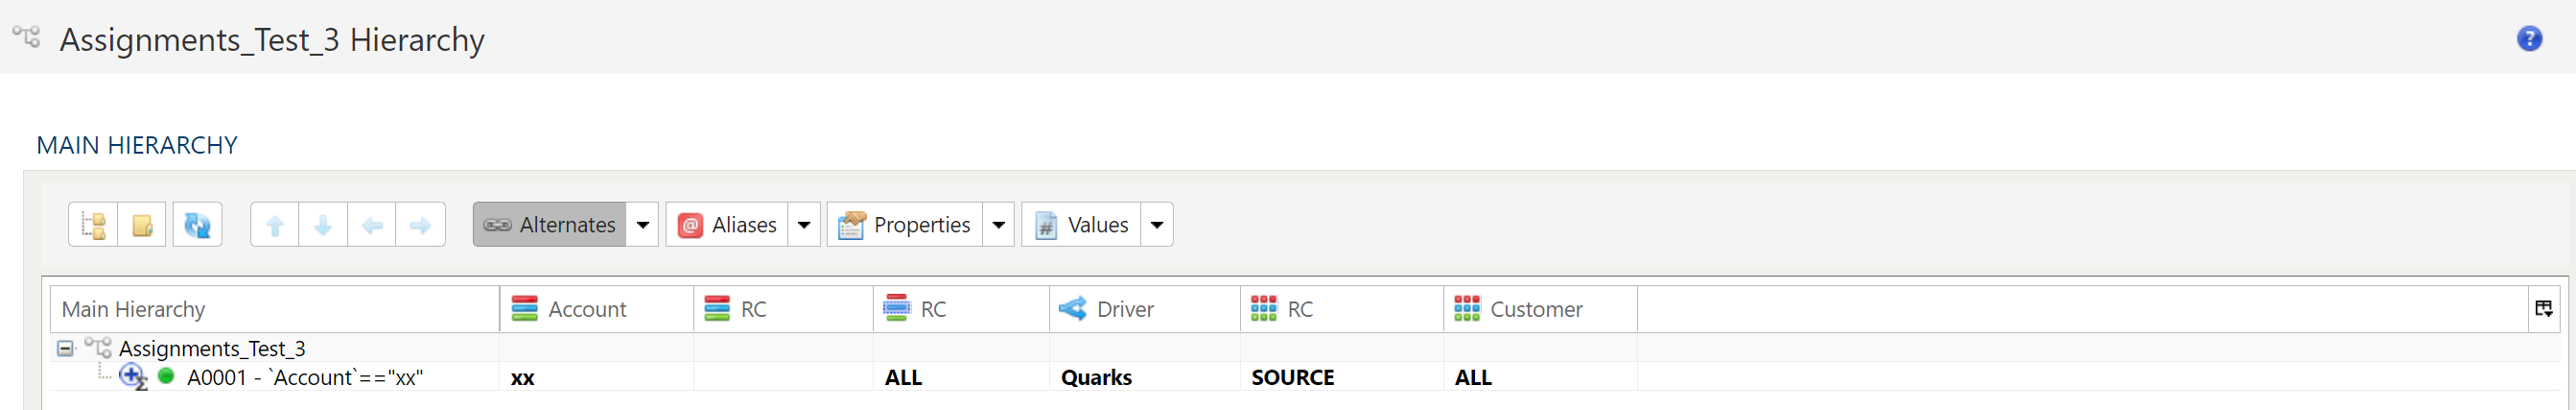
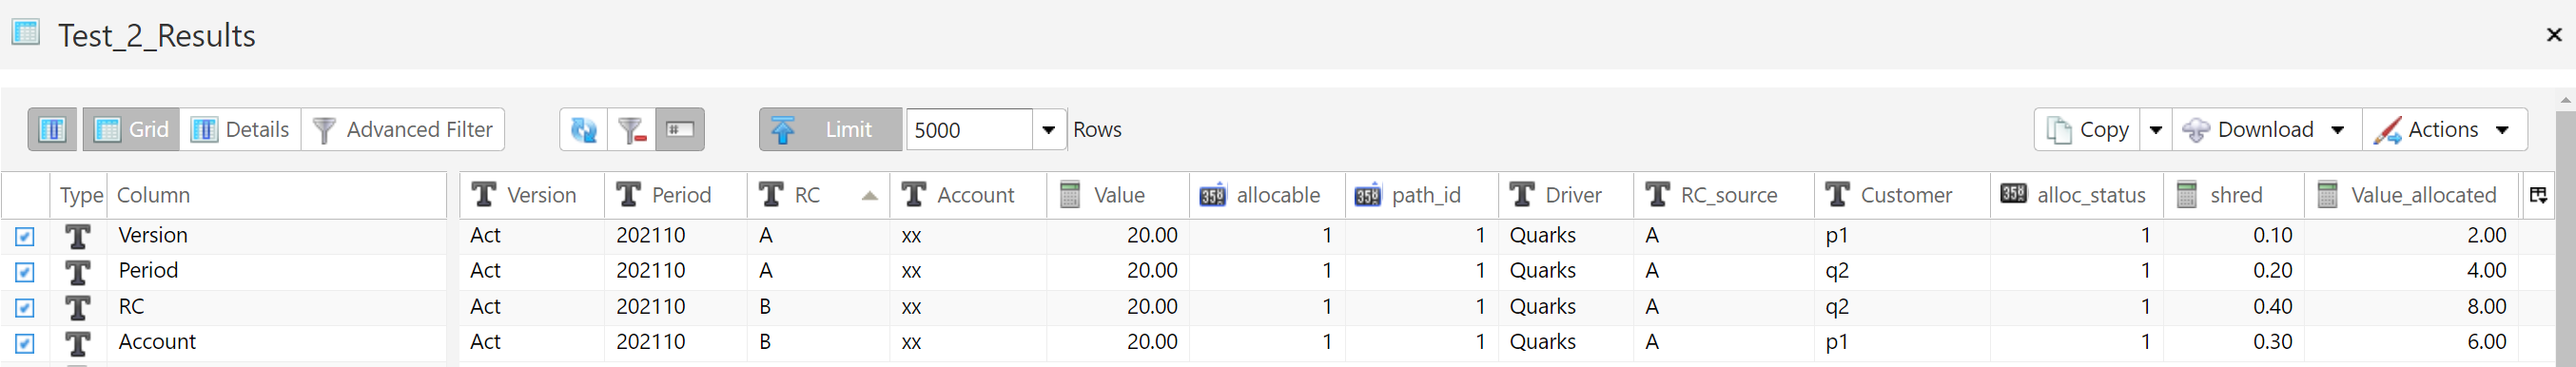
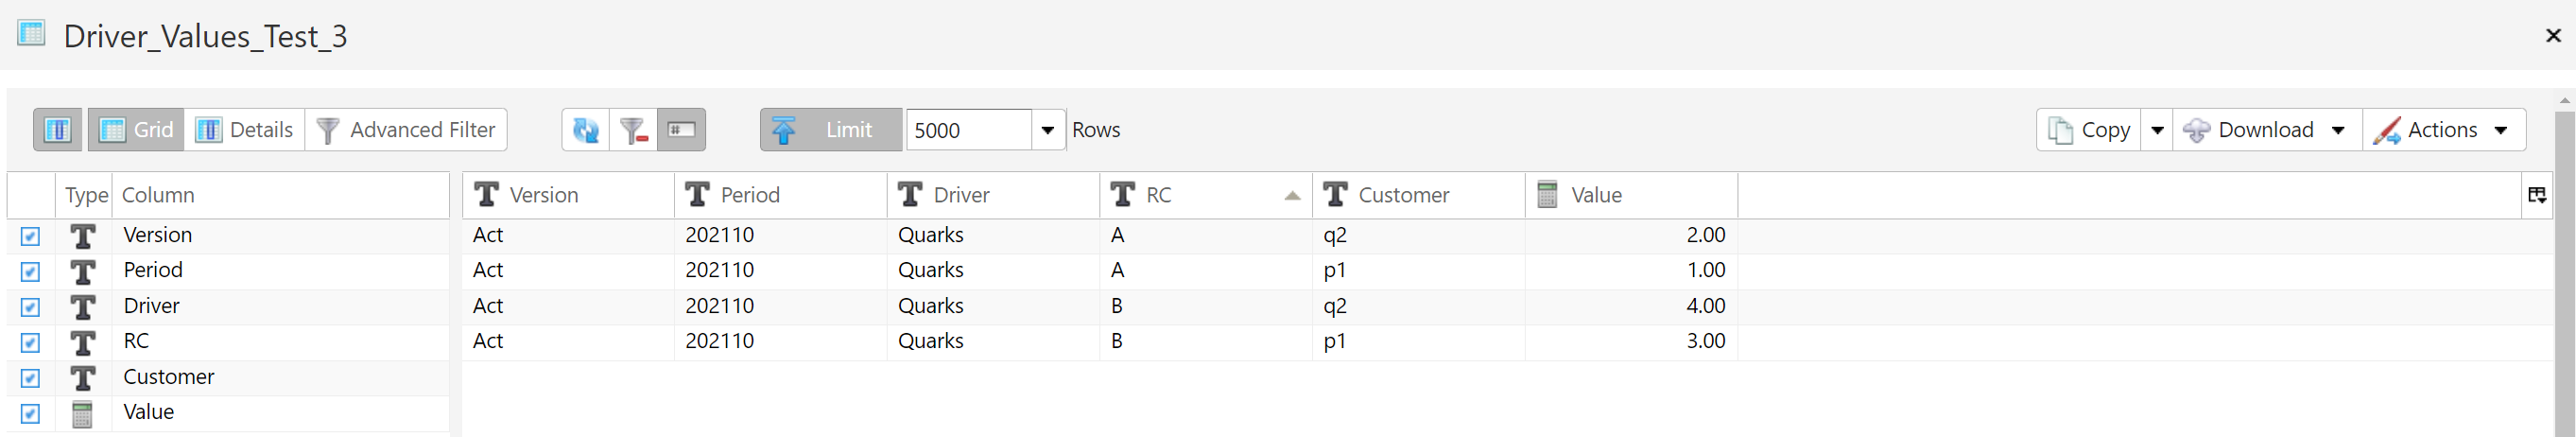
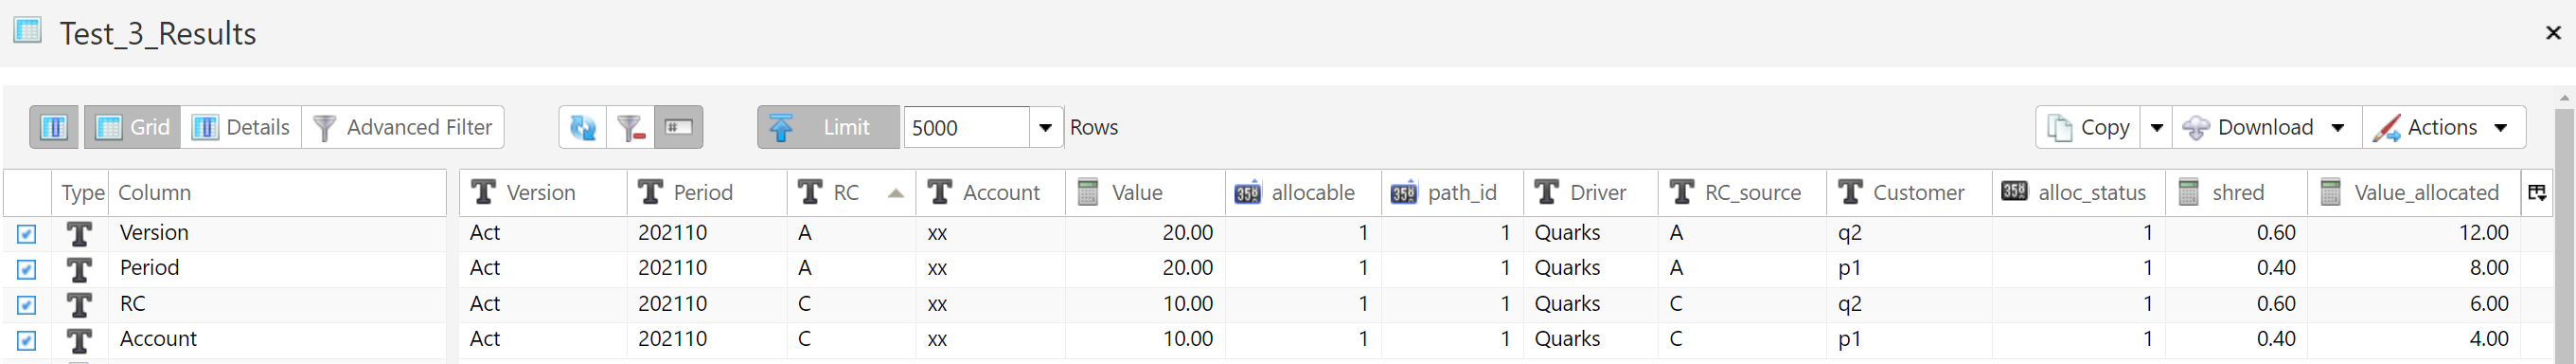
Gdy Context RC jest ustawiony na ALL, a Target RC na Source, dane sterujące będą obejmować wszystkie RC w danych sterujących. Context RC zastąpi ustawienie Target RC.
Tabela wyników alokacji
Przykład 4
Dział zatytułowany „Przykład 4”Tabela wartości do alokacji
Tabela danych sterujących
Hierarchia wymiaru przypisania
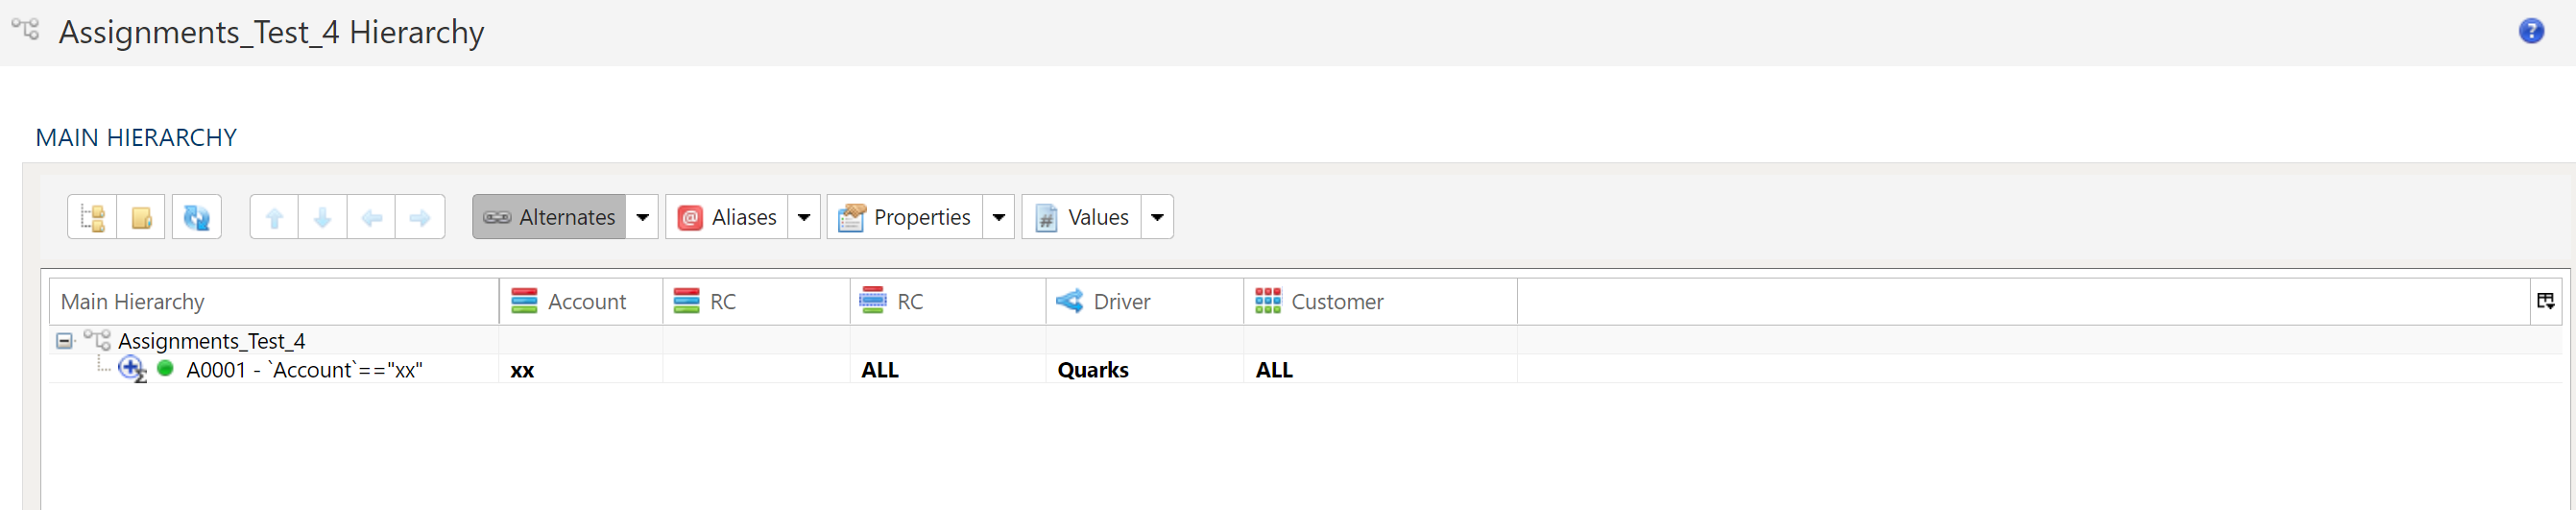
Gdy Context RC jest ustawiony na ALL, dane sterujące będą obejmować wszystkie RC w danych sterujących.
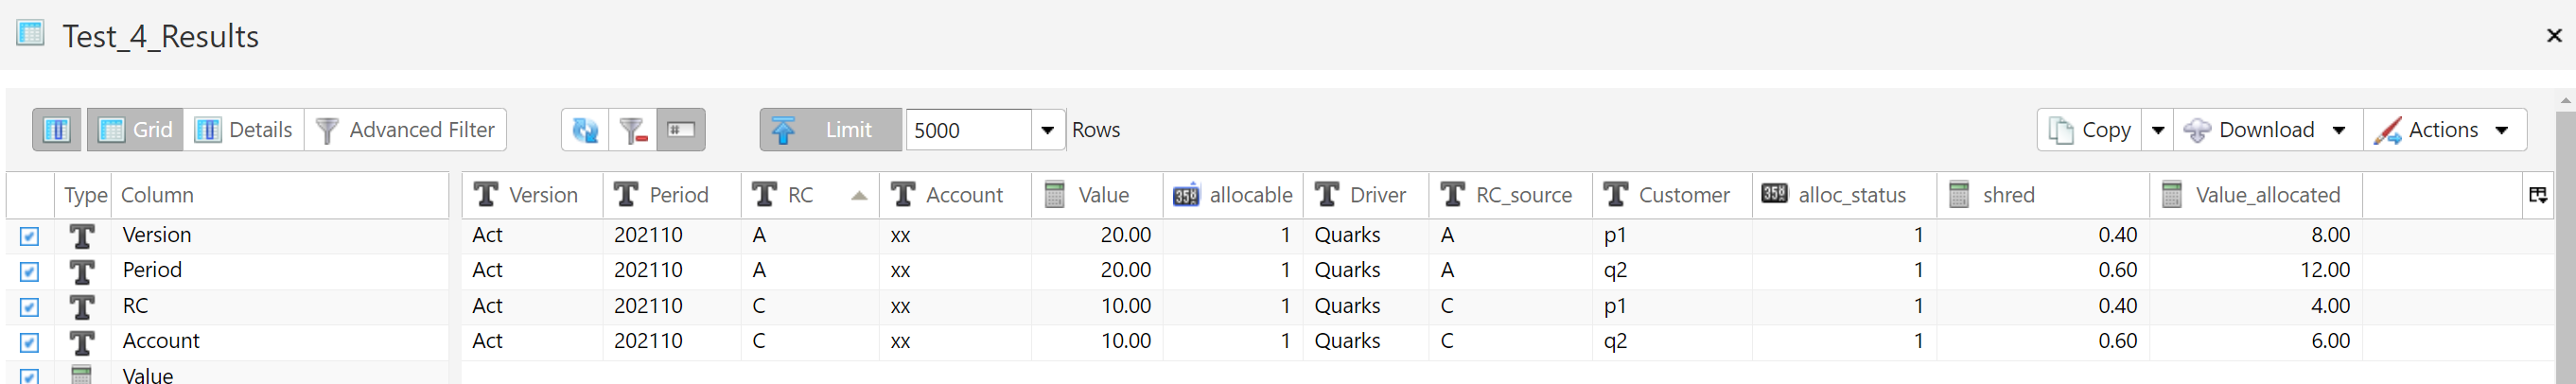
Tabela wyników alokacji