

SQL抽出
自分で記述したSQLのSELECTから、ターゲットテーブルにデータを入力します。Table Extract ステップはマッピングされた列と式からクエリを構築しますが、このステップはクエリをそのままウェアハウスに渡します。マッパーで組み立てるよりも、SQLで直接表現する方が簡単な場合に使用します。
マッパーが対応していない構文が必要な場合に使用してください。再帰CTE、マッパーでは記述できないパーティションに対するウィンドウ関数、結合ステップを使うとかえって複雑になる複数テーブルに対するクエリなどです。
固有の設定項目
Section titled “固有の設定項目”SQL Selectクエリ
Section titled “SQL Selectクエリ”クエリのテキストです。1行の長い文ではなく、読みやすい複数行のインデント付きSQL(1行に1つの列または句)として整形してください。ステップは記述した内容をそのまま保持し、次にそれを開く人が読むことになります。
クエリはプロジェクトのLakehouseで実行されるため、使用できる関数は、ワークスペースに応じてLakehouse v1またはv2のセットになります。
プレビュー
ソースタブでプレビューをクリックすると、ステップが読み取る内容の最大100行を、実行せずに確認できます。結果がそれより長い場合、プレビューには最初の行のみが表示されていること、すべてを読み取るにはステップを実行する必要があることが表示されます。
プレビューは、実行時と同じ方法で、プロジェクト変数とワークフロー変数を埋め込みます。{x:>9}のような変数の書式指定には対応していません。また、トリガーの値のように、実行中にのみ値を持つ変数は埋め込めません。
プレビューはデータの読み取りのみを行います。何かを変更する可能性のあるクエリは拒否し、行の代わりにメッセージを表示します。
- Preview only supports standard SQL functions. Run the step to see results. クエリで、プレビューが読み取り専用かどうかをチェックできない関数が使用されています。結果を確認するには、ステップを実行してください。
- 単一の
SELECTではないクエリ、または変数が展開された結果として書き込みを行うステートメントになるクエリは、拒否されます。
プレビューは、ロックされたプロジェクト、SQL Server、Oracle、SQLiteの接続、およびAgent Remote Execution of SQL ステップのようにエージェント経由で実行されるステップでは利用できません。
ほかのSQLステップとは異なり、このステップは変数を埋め込まないため、そのプレビューでも埋め込まれません。
共通の設定項目
Section titled “共通の設定項目”データマッパーの設定
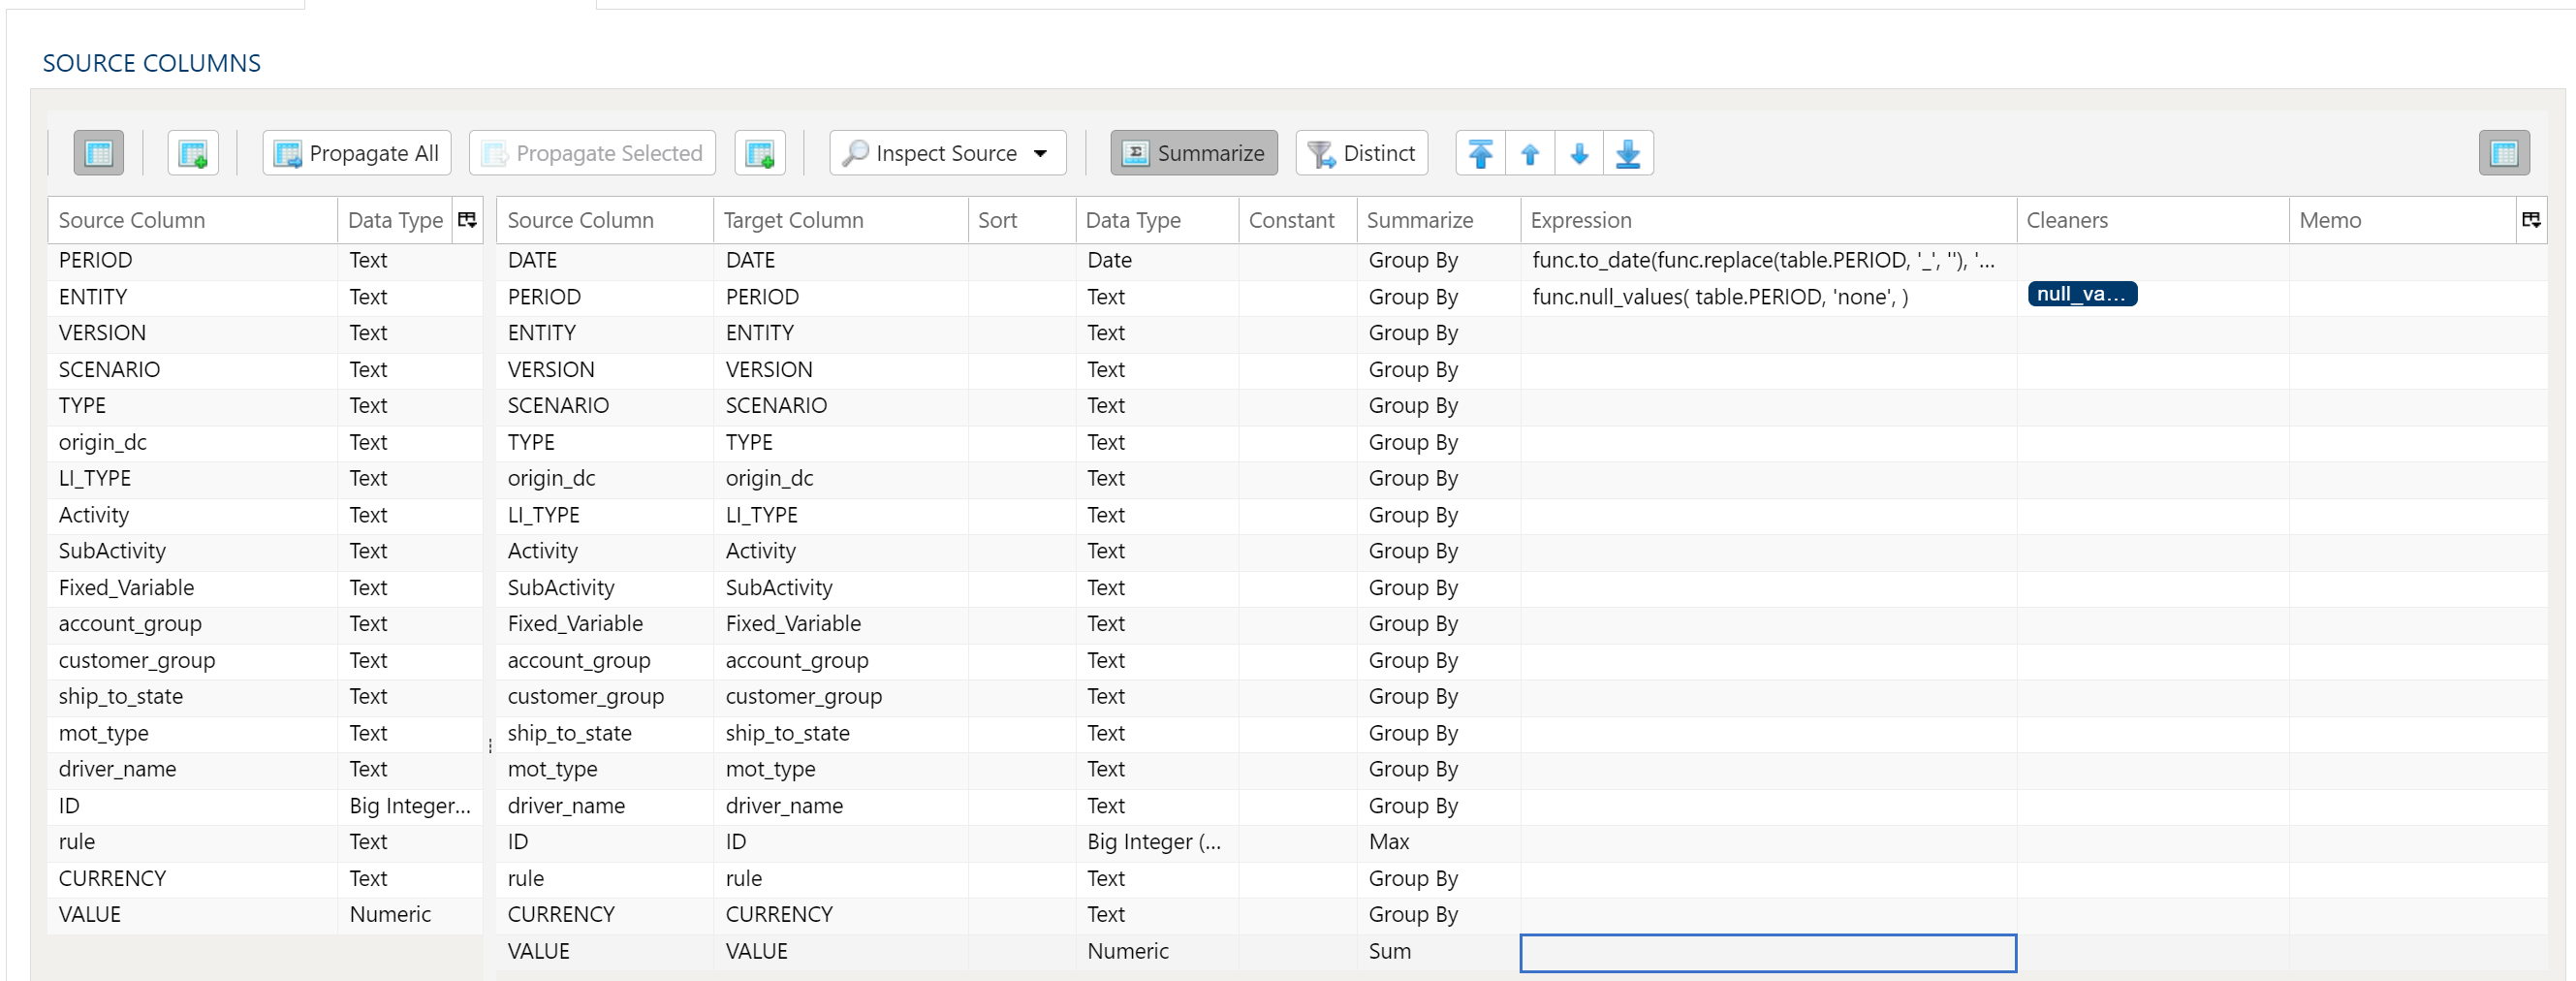
データマッパーは、ソースデータの列をターゲットのデータテーブルにマッピングするために使用します。
マッパーの検査と入力
ソースを検査メニューボタンを使うと、ソースからターゲットへ列をマッピングする方法が増えます。
- 両方のマッピングテーブルを入力: ソースデータテーブルのすべての値をターゲットのデータテーブルに反映します。これがデフォルトです。
- ソースマッピングテーブルのみを入力: ソースデータテーブルのすべての値のみをマッピングします。ソース列の構成が変わった既存のワークフローを修正する際に便利です。
- ターゲットマッピングテーブルのみを入力: すべての値をターゲットのデータテーブルのみに反映します。
ソース列とターゲット列のオプションだけでは足りない場合は、次のようにいくつかの方法でターゲットのデータテーブルに列を追加できます。
- すべてを反映は、すでに存在しているかどうかにかかわらず、すべてのソース列をターゲットのデータテーブルに挿入します。
- 選択を反映は、選択したソース列のみを挿入します。
- ターゲット側を右クリックして行を挿入を選択すると、現在選択している行の直上に行を挿入します。
- ターゲット側を右クリックして行を追加を選択すると、ターゲットのデータテーブルの末尾(右端)に行を挿入します。
列の削除
ターゲットのデータテーブルから列を削除するには、対象の列を選択し、右クリックして削除を選択します。
一覧になくなったソース列
ターゲットの行がソース列として指定している列が、ソースデータテーブルの一覧にない場合があります。たとえば、ソースを再度検査した後などです。ステップがそのような行を自動的に削除することはありません。代わりに、列名が警告マーク ⚠ の後ろに赤色で表示され、その上にカーソルを置くと、その列がソース列にないことが示されます。ユニオンなど複数のテーブルを扱うステップでは、各テーブルがそれぞれのソース列に対してチェックされます。
定数、式、または件数 (NULLを含む) の集計を設定した行は、ステップがそのソース列を読み取らないため、フラグが付くことはありません。ソースデータテーブルに列が一覧表示されていない間(たとえば、ソースを初めて検査する前)は、何もフラグが付きません。
フラグが付いた行が残ったままステップを保存すると、古い列が見つかりましたダイアログに、該当する行が所属するタブまたはテーブルごとに表示され、次の3つの選択肢が提示されます。
- すべて削除して保存 — フラグが付いた行を削除してから保存します。
- このまま保存 — ステップをそのまま保存します。
- キャンセル — 保存せずにステップに戻ります。
行を残したまま警告を解除するには、その列をソースデータテーブルに追加し直すか、ソースデータテーブルに一覧表示されている列を選択します。
列のデータ型
ターゲットの各列にはタイプがあります。ソースから反映した列はソース列のタイプを引き継ぎます。手動で追加した行はテキストから始まるため、実際に必要なタイプをタイプで設定します。合計や並べ替えを行う列には数値型や日付型が必要です。テキストはテキストとして並べ替えられ、合計されるためです。
タイプがまったく設定されていない列を含んだままステップを保存しても、ステップは実行されます。タイプは、ステップの開始時に、その列が読み取るソース列から判定されます。読み取り元がない場合はテキストとして扱われます。たとえば、SQL抽出ステップの列は、マッピングされたソースではなく、記述したクエリから決まります。また、同じ列名でタイプが一致しないソースが複数ある場合は、いずれかを推測せずテキストが使われます。推測が外れるとウェアハウスが拒否する変換が生じる可能性がありますが、どんな値もテキストには変換できるためです。
列がどうあるべきかを指定する方法は、引き続きタイプを自分で設定することです。未設定のままにすると、ソース列がたまたまそうであるタイプをそのまま受け入れることになります。
列の順序の変更
ターゲットのデータテーブルの列を並べ替えるには、対象の列を選択します。次のどちらかを使用できます。
- 一括移動の矢印: 右上の矢印から目的の移動オプションを選択します
- コンテキストメニュー: 右クリックして、先頭へ移動、上へ移動、下へ移動、末尾へ移動のいずれかを選択します。
結果を重複のないレコードのみに絞り込む
重複のないオプションのみを返すには、重複排除メニューオプションを選択します。ソースの各列にチェックボックスが表示されます。重複を排除したい列の横にあるチェックボックスをオンにすると、重複のない結果のみが返されます。
状況によっては、代わりに集計の使用を検討することをお勧めします。
重複排除では、最初に見つかった一意のレコードを残し、残りを破棄します。実行間で一貫性が必要な場合は、データに並べ替えを適用することをお勧めします。
集計とグループ化
結果を集計するには、集計メニューオプションを選択します。ターゲットのデータテーブルの各列に選択ボックスが表示されます。列ごとに適切な集計方法を選択します。
ソースを検査で列が入力される際、数値列は、名前が id、customer_id、Order No、CustomerKey のように識別子と読み取れる場合、テーブルでキーに設定されている場合、または結合でキーとして使用されている場合に、合計ではなくグループ化から始まります。
- グループ化
- 合計
- 最小
- 最大
- 最初
- 最後
- 件数
- 件数 (NULLを含む)
- 平均
- 標準偏差
- 標本標準偏差
- 母標準偏差
- 分散
- 標本分散
- 母分散
- 高度な非グループ化
式、クレンジング、定数などのデータマッパーの高度な使い方については、データマッパーの高度な使い方を参照してください。