

検索拡張、グラウンディング、分析パス
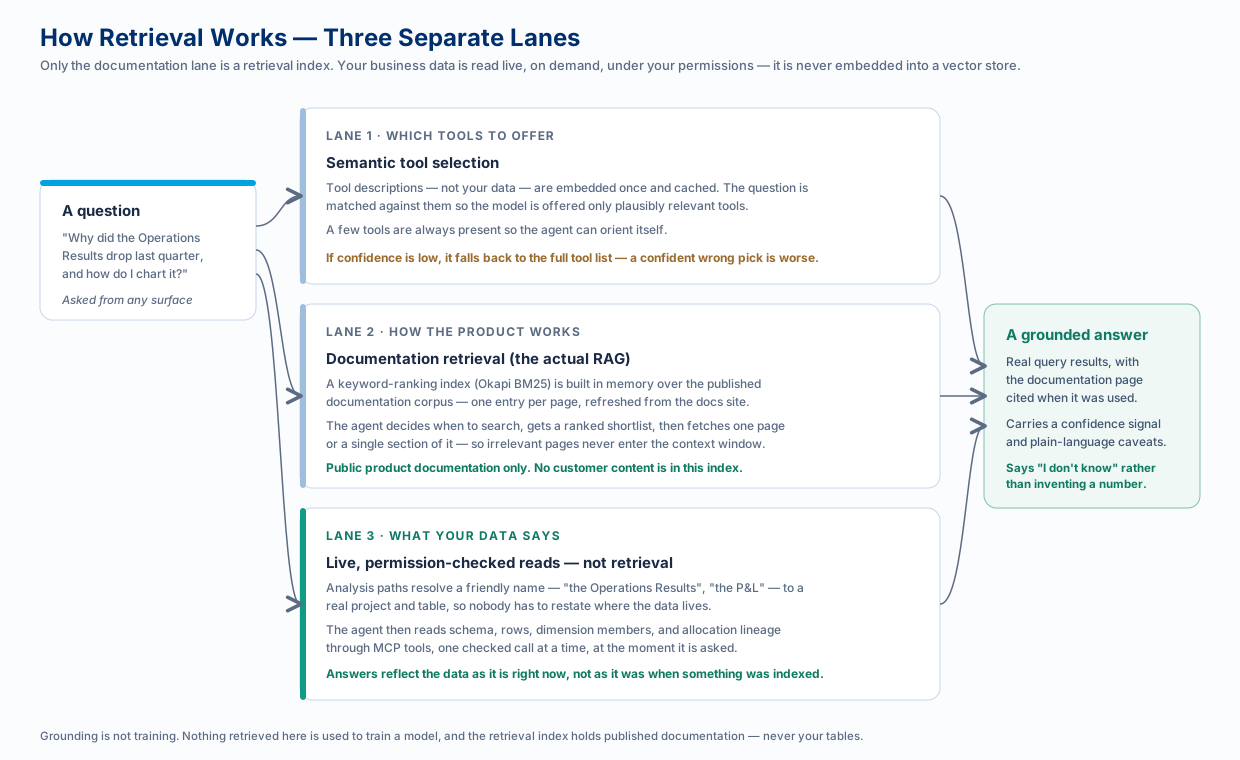
「RAG」は通常、1つのことを意味します。コーパスを断片に分割し、ベクトルストアに埋め込み、最も近いものをプロンプトに貼り付けるという処理です。PlaidCloudがこれを行うのは、製品ドキュメントという1つのコーパスだけです。ユーザーのデータに対しては、意図的にこれを行いません。
テーブルは、質問された時点で、ユーザーの権限のもとでリアルタイムに読み取られます。これはパフォーマンス上の判断ではなく、回答を信頼でき、アクセス制御を意味のあるものにするための仕組みです。
レーン1:提示するツールの選択
Section titled “レーン1:提示するツールの選択”このレーンは、独自のツールカタログを持つアプリ内アシスタントで動作します。モデルに表示するツールの説明は、ターンごとにプロンプトトークンを消費します。そのため、モデルが何かを見る前に、質問がツールの説明(ユーザーのデータではありません)とセマンティックな類似度で照合され、関連性が高そうなツールだけが提示されます。
他の利用方法では、ツールカタログはMCP接続が処理します。Anthropicのコネクターはサーバー側で管理し、クライアント側ループは宣言する範囲に上限を設けます。以下のレーン2とレーン3は、どの利用方法にも適用されます。
次の3点が重要です。
- 埋め込みが表すのはツールであり、コンテンツではありません。 ツール名と説明から一度だけ計算されてキャッシュされ、説明が変更されると自動的に再構築されます。
- 一部のツールは常に提示されます。 質問にどちらも含まれていない場合でも、エージェントが状況(誰が、どのプロジェクトで質問しているか)を把握できるようにするためです。
- 信頼度が低い場合は、完全なリストに戻ります。 自信を持って誤った絞り込みをするより、一度だけ完全なトークンコストを払うほうが望ましいため、判断が不確かな場合はすべてを表示します。非常に短いターン(「ありがとう」「OK」など)では、この処理は完全にスキップされます。
レーン2:ドキュメントでのグラウンディング
Section titled “レーン2:ドキュメントでのグラウンディング”これは本来の検索拡張生成の経路で、「…するにはどうすればよいですか」「…とは何ですか」「…はどこで設定しますか」といった質問に答えます。
公開ドキュメントは、1ページにつき1エントリの構造化されたコーパスとして取得され、キーワードのランキング関数であるOkapi BM25でメモリ内にインデックス化されます。エージェントは次の2段階で動作します。
- 検索は、ページのランク付けされた候補リストを返します。スラッグ、タイトル、説明、スコアが含まれます。
- 取得は、エージェントが実際に必要なページを決定した後、そのページ全体、またはその中の名前付きセクション1つを取得します。
設計上のポイントは、エージェントがいつ検索するか、どれだけ読むかを自ら決めることです。受動的な注入は、役に立つかどうかにかかわらずすべてのプロンプトに何かを貼り付けます。ツール駆動の検索では、無関係なページがコンテキストウィンドウに入らず、エージェントが使用したページを引用できるため、後から確認できます。
ドキュメントのコーパスに一時的に接続できない場合、エージェントはターンを失敗させず、ドキュメントなしで回答します。
レーン3:自社データの読み取り
Section titled “レーン3:自社データの読み取り”ユーザー自身の数値に関する質問は、検索ではまったく回答されません。エージェントは、必要なものを必要なときに、権限チェック付きのツールを通じて読み取ります。テーブルのスキーマ、行、ディメンションメンバー、ワークフローのリネージ、配賦のトレースなどです。
回答が最新である理由はここにあります。何かが最後にインデックス化された時点ではなく、現在のデータが反映されます。アクセス制御が機能する理由もここにあります。インデックスがないため、権限の境界を越えて漏えいするような構築済みのインデックスは存在しません。
分析パス:名前付けのレイヤー
Section titled “分析パス:名前付けのレイヤー”リアルタイムの読み取りでは、どのテーブルかを知る必要があります。分析パスは、それを簡単にする共有の語彙です。「営業成績」「損益計算書」「従業員数」のようなわかりやすい名前を、実際のプロジェクトとテーブルに一度対応付けると、以降はワークスペースの全員が使用できます。
- 毎回プロジェクトとテーブルを指定する代わりに、名前で質問できます。
- 1つをワークスペースのデフォルトにすると、対象を指定しない「先四半期に何が変わりましたか?」という質問でも、適切な場所に行き着きます。
- 全員が同じものを指します。 チーム全員が「損益計算書」と言えば、同じテーブルに到達します。
管理者が登録し、誰でも使用できます。すべての質問は、質問したユーザー自身の権限のもとで実行されます。アプリ内アシスタント、Microsoft 365 Copilot、接続されたコーディングエージェントのどれからでも、同じように機能します。設定方法については、分析パスを参照してください。
式のカタログ
Section titled “式のカタログ”アシスタントが式を書くとき、関数名を記憶から推測することはありません。PlaidCloudのすべての式関数について、名前、シグネチャ、ドキュメントへのリンク、カテゴリを含む構造化されたカタログを参照し、ウェアハウスが実際に提供する関数と照合します。名前がほぼ正しい場合は、近い候補を提示します。関数名では「ほぼ正しい」は誤りであるため、類似度検索ではなく、照会を行います。
グラウンディングは学習ではありません
Section titled “グラウンディングは学習ではありません”ユーザーが懸念するのも無理はない点が2つあります。
- ここで取得されたものがモデルの学習に使われることはありません。 グラウンディングは、1回のリクエストに情報を入れるだけです。モデルの重みは変更されず、お客様のコンテンツが誰かのモデルの学習に使われることもありません。
- 検索インデックスに含まれるのは公開ドキュメントのみです。 お客様のコンテンツは一切埋め込まれません。
データの送信先と、それを自社で管理するインフラストラクチャ内に留める方法については、自社管理のLLMを使用するで説明しています。
より良い回答が得られる理由
Section titled “より良い回答が得られる理由”グラウンディングによって、アシスタントは何かをでっち上げるのではなく、「わかりません」と言えるようになります。すべての数値は実際のクエリから、製品に関するすべての主張は実際のドキュメントのページから得られるため、回答を評価できます。各回答には信頼度の指標と平易な言葉の注意事項が付き、要約の文章はチェックされるため、制限事項が黙って省かれたり、分析が生成していない数値が引用されたりすることはありません。信頼できる回答を参照してください。
- 分析パス:共有の名前を設定します
- 配賦のトレース:結果がなぜ変動したかを問い合わせます
- AIとLLMのアーキテクチャ:利用方法と共通の経路