

Table Extract ステップ
既存のAnalyzeデータテーブルから、別のデータテーブルにデータを抽出する際に使用します。例には次のようなものがありますが、これらに限定されません。
- 並べ替え
- グループ化
- 集計
- 行のフィルター/サブセット化
- 余分な列の削除
- 数値演算
- 文字列操作
抽出パラメーター
Section titled “抽出パラメーター”ソースとターゲット
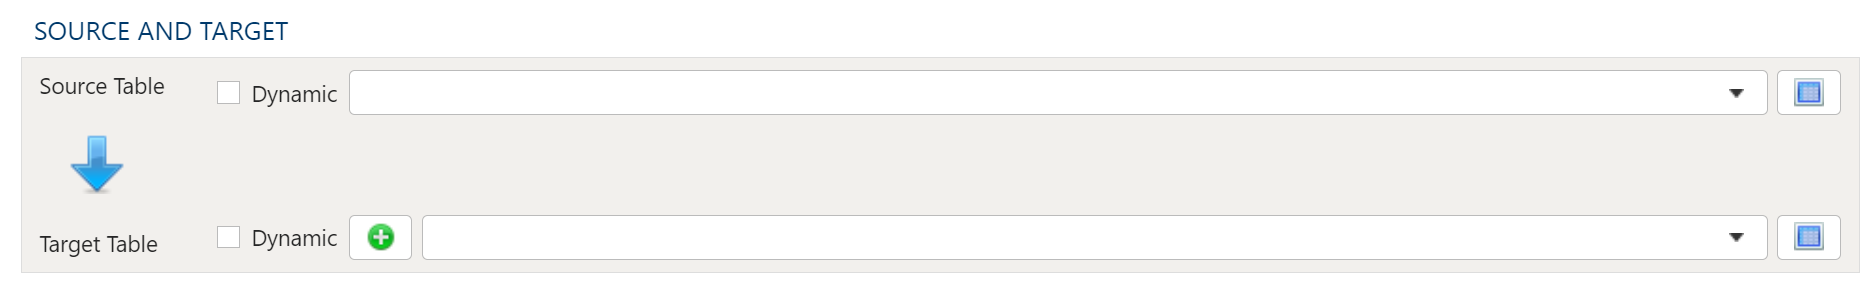
ソーステーブルとターゲットテーブルを設定するには、まずソーステーブルドロップダウンメニューから、抽出元のデータテーブルを選択します。次に、ターゲットテーブルドロップダウンで既存のテーブルをターゲットテーブルとして選択するか、緑色の “+” 記号をクリックして新しいテーブルをターゲットとして作成します。
テーブルの作成
新しいテーブルを作成するときは、ビューまたはテーブルのどちらかとして作成できます。
ビュー:
ビューを使用すると、テーブルを使用する場合に比べてステップの実行時間が大幅に短くなります。一方、ビューにはテーブルの詳細モードでのデータ探索に向かないという欠点があります。
テーブル:
ターゲットにテーブルを使用すると、ステップの実行に時間がかかりますが、詳細モードでのデータ探索はビューよりもはるかに高速です。
テーブルデータの選択
Section titled “テーブルデータの選択”データマッパーの設定
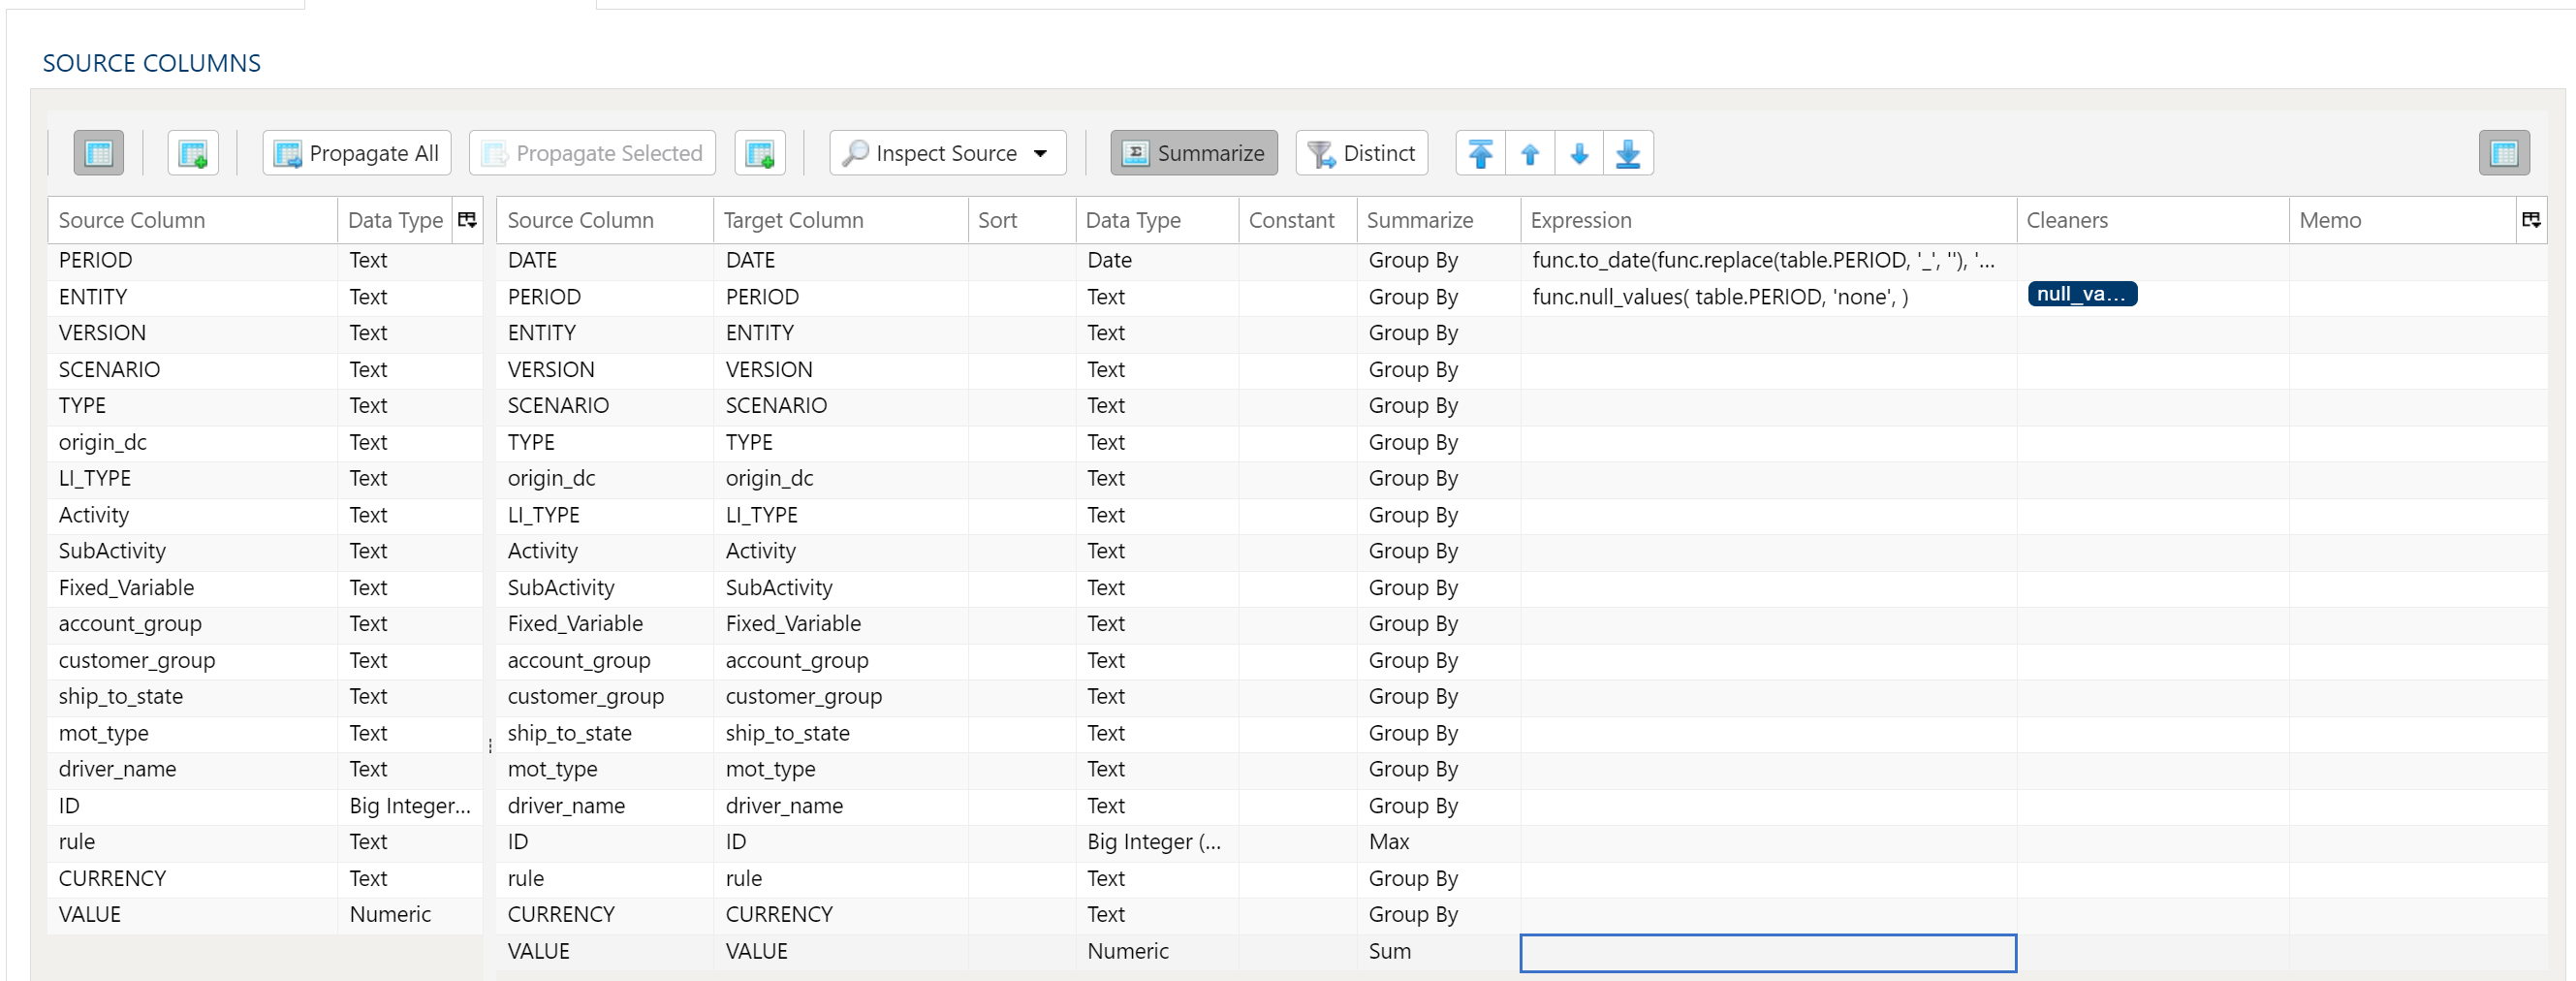
データマッパーは、ソースデータの列をターゲットのデータテーブルにマッピングするために使用します。
マッパーの検査と入力
ソースを検査メニューボタンを使うと、ソースからターゲットへ列をマッピングする方法が増えます。
- 両方のマッピングテーブルを入力: ソースデータテーブルのすべての値をターゲットのデータテーブルに反映します。これがデフォルトです。
- ソースマッピングテーブルのみを入力: ソースデータテーブルのすべての値のみをマッピングします。ソース列の構成が変わった既存のワークフローを修正する際に便利です。
- ターゲットマッピングテーブルのみを入力: すべての値をターゲットのデータテーブルのみに反映します。
ソース列とターゲット列のオプションだけでは足りない場合は、次のようにいくつかの方法でターゲットのデータテーブルに列を追加できます。
- すべてを反映は、すでに存在しているかどうかにかかわらず、すべてのソース列をターゲットのデータテーブルに挿入します。
- 選択を反映は、選択したソース列のみを挿入します。
- ターゲット側を右クリックして行を挿入を選択すると、現在選択している行の直上に行を挿入します。
- ターゲット側を右クリックして行を追加を選択すると、ターゲットのデータテーブルの末尾(右端)に行を挿入します。
列の削除
ターゲットのデータテーブルから列を削除するには、対象の列を選択し、右クリックして削除を選択します。
一覧になくなったソース列
ターゲットの行がソース列として指定している列が、ソースデータテーブルの一覧にない場合があります。たとえば、ソースを再度検査した後などです。ステップがそのような行を自動的に削除することはありません。代わりに、列名が警告マーク ⚠ の後ろに赤色で表示され、その上にカーソルを置くと、その列がソース列にないことが示されます。ユニオンなど複数のテーブルを扱うステップでは、各テーブルがそれぞれのソース列に対してチェックされます。
定数、式、または件数 (NULLを含む) の集計を設定した行は、ステップがそのソース列を読み取らないため、フラグが付くことはありません。ソースデータテーブルに列が一覧表示されていない間(たとえば、ソースを初めて検査する前)は、何もフラグが付きません。
フラグが付いた行が残ったままステップを保存すると、古い列が見つかりましたダイアログに、該当する行が所属するタブまたはテーブルごとに表示され、次の3つの選択肢が提示されます。
- すべて削除して保存 — フラグが付いた行を削除してから保存します。
- このまま保存 — ステップをそのまま保存します。
- キャンセル — 保存せずにステップに戻ります。
行を残したまま警告を解除するには、その列をソースデータテーブルに追加し直すか、ソースデータテーブルに一覧表示されている列を選択します。
ソーステーブルに存在しない列
保存時には、ソースデータテーブル自体の現在の状態が確認されます。ステップのソース列に一覧表示されている列がテーブルに存在しない場合(たとえば、前のステップで名前が変更されたか削除された列)、ステップの列が古くなっていることを意味し、そのような列を読み取るステップは実行時に失敗します。その場合、保存すると不足しているソース列ダイアログが開き、各テーブルと、そのテーブルにない列が表示されます。選択肢は次の2つです。
- このまま保存 — ステップをそのまま保存します。
- キャンセル — 保存せずにステップに戻ります。
テーブル側が誤っている可能性があり、ステップの実行前に再び変わる可能性もあるため、自動的に削除されるものはありません。行が一覧に含まれなくなったものとしてフラグ付けされている場合は、両方が古い列が見つかりましたダイアログにまとめて表示され、すべて削除して保存ではフラグ付けされた行のみが削除されます。ソース列のリストが空の間は、代わりにステップがマッピングする列が確認されます。ただし、定数、式、または件数 (NULLを含む) の集計を持つ行は、どの列も読み取らないため対象外です。
{year}/Sales のように変数で指定されたソースは、保存時点の変数の値で確認され、ダイアログには 2026/Sales (from {year}/Sales) のように確認したテーブルが表示されます。ループが設定する変数には最後の反復の値が入っているため、形状の異なるテーブルをループ処理する場合、次の実行では読み取られないテーブルについて警告が表示されることがあります。まだ存在しないテーブル(たとえば、ワークフロー内の前のステップが作成するテーブル)は確認されません。値のない変数で指定されたソース、実行時にステップが検索して見つけるテーブル、現時点で読み取れないテーブルも同様です。
ステップの実行時
Table Extract、Table Lookup、Table Inner Join、Table Cross Join、Table Outer Join、Table Anti Join、複数テーブル結合、Table Union Distinct、Table Union All、Table Pivot、Table Melt、Table In-Place Delete、Table Upsert、Table Append の各ステップは、実行時、何かを書き込む前に、ソーステーブルを確認します。この確認では、ステップが構築したクエリを、その時点の各ソーステーブルと照合します。
- ステップが読み取る列がテーブルにない場合、テーブルにない、またはステップのソース列にない結合キーがある場合、またはステップが読み取るソーステーブルが構築されていない場合、ステップは停止します。1つのエラーにすべての問題がそれぞれの修正方法とともに示されます。既存のターゲットテーブルは元の状態のまま残り、ステップが作成する必要があったターゲットテーブルは空のままになります。
- ステップが一覧に載せているが読み取らない列がテーブルにもうない場合は、警告が追加されます。ステップはその列なしで実行されます。
- Table Union Distinct と Table Union All は、構築されていないソーステーブルについては例外です。従来どおり、そのテーブルを警告なしで除外し、残りのテーブルをまとめます。ソーステーブルが1つも構築されていない場合は、失敗せずに警告を出して終了します。
ターゲットがビューであるステップはビューを作成するだけなので、一覧に載せている列と結合キーは、ウェアハウスがそのビューの作成を拒否する場合にのみ、そのテーブルと照合して確認されます。それ以外の場合は、構築されていないソーステーブル、またはステップの一覧にない結合キーがある場合にのみステップが停止し、警告は追加されません。
可能な場合、エラーにはテーブルを構築するステップが示され、テーブルに不足している列と名前が近い列(大文字小文字だけが異なる列など)がある場合は、その列も示されます。
列のデータ型
ターゲットの各列にはタイプがあります。ソースから反映した列はソース列のタイプを引き継ぎます。手動で追加した行はテキストから始まるため、実際に必要なタイプをタイプで設定します。合計や並べ替えを行う列には数値型や日付型が必要です。テキストはテキストとして並べ替えられ、合計されるためです。
タイプがまったく設定されていない列を含んだままステップを保存しても、ステップは実行されます。タイプは、ステップの開始時に、その列が読み取るソース列から判定されます。読み取り元がない場合はテキストとして扱われます。たとえば、SQL抽出ステップの列は、マッピングされたソースではなく、記述したクエリから決まります。また、同じ列名でタイプが一致しないソースが複数ある場合は、いずれかを推測せずテキストが使われます。推測が外れるとウェアハウスが拒否する変換が生じる可能性がありますが、どんな値もテキストには変換できるためです。
列がどうあるべきかを指定する方法は、引き続きタイプを自分で設定することです。未設定のままにすると、ソース列がたまたまそうであるタイプをそのまま受け入れることになります。
列の順序の変更
ターゲットのデータテーブルの列を並べ替えるには、対象の列を選択します。次のどちらかを使用できます。
- 一括移動の矢印: 右上の矢印から目的の移動オプションを選択します
- コンテキストメニュー: 右クリックして、先頭へ移動、上へ移動、下へ移動、末尾へ移動のいずれかを選択します。
結果を重複のないレコードのみに絞り込む
重複のないオプションのみを返すには、重複排除メニューオプションを選択します。ソースの各列にチェックボックスが表示されます。重複を排除したい列の横にあるチェックボックスをオンにすると、重複のない結果のみが返されます。
状況によっては、代わりに集計の使用を検討することをお勧めします。
重複排除では、最初に見つかった一意のレコードを残し、残りを破棄します。実行間で一貫性が必要な場合は、データに並べ替えを適用することをお勧めします。
集計とグループ化
結果を集計するには、集計メニューオプションを選択します。ターゲットのデータテーブルの各列に選択ボックスが表示されます。列ごとに適切な集計方法を選択します。
ソースを検査で列が入力される際、数値列は、名前が id、customer_id、Order No、CustomerKey のように識別子と読み取れる場合、テーブルでキーに設定されている場合、または結合でキーとして使用されている場合に、合計ではなくグループ化から始まります。
- グループ化
- 合計
- 最小
- 最大
- 最初
- 最後
- 件数
- 件数 (NULLを含む)
- 平均
- 標準偏差
- 標本標準偏差
- 母標準偏差
- 分散
- 標本分散
- 母分散
- 高度な非グループ化
式、クレンジング、定数などのデータマッパーの高度な使い方については、データマッパーの高度な使い方を参照してください。
実行時に指定された列
Section titled “実行時に指定された列”実行時に指定された列も引き継ぐを選択すると、ステップが列挙していないすべてのソース列が、ステップの実行時にテーブルが持っているとおりに、そのまま渡されます。ピボットのように、データに応じて名前が決まる列を前のステップが作成するため、ステップの構築時にそれらを列挙できない場合に使用します。オフのままにすると、列挙した列だけが書き込まれます。
オンにすると、引き継ぐ列セクションが表示され、データで名前が決まる列セクションは常に利用できます。これらには次のフィールドがあります。
- 引き継ぎ方法(
carry_expression)— 引き継ぐ各列を、そのままではなく、この式として書き込みます。__column__は引き継ぐ列を表します。グループ化するステップは、実行時にしか名前が分からない列をこのようにして取り込みます。集計するステップは、これがないと何も引き継ぎません。引き継ぐ列の型(carry_dtype)は、引き継ぐ各列のデータ型を設定し(デフォルトはその列自身の型)、引き継ぐ列の集計(carry_agg)は、集計するステップがその列をどう扱うかを設定します(式が集計する場合はdont_group)。 - 引き継ぐ列の名前変更(
carry_rename)— 正規表現patternに一致し、keepに一致しない名前の引き継ぐ各列の名前を、一致した各部分をreplacementに置き換えて変更します(グループには\1、設定されている場合は最初のmax個の一致)。replacement内の__index__は、名前を変更する列の中での、startから数えたその列の位置です。すでに使用されている名前には、(#n)が追加されます。 - 動的列(
dynamic_columns)— データで名前が決まるターゲット列で、ステップがソースから読み取る個別の値ごとに1セットが、ステップの実行時に書き込まれます。各エントリには、rows(ソースに対する式key、label、where、order)、__key__、__label__、__index__を使用するtargetの列または列のリスト、そして新しい列を追加する位置となるターゲット列after(デフォルトは末尾)を指定します。値は、テキスト、整数、ブール値、またはNULLである必要があります。ステップが書き込む列は最大1,000列で、出力はテーブルである必要があります。ステップの実行時、rowsの式とステップのフィルターは拒否される関数と演算子のルールに従う必要があり、従わない場合はステップが失敗します。
データフィルター
Section titled “データフィルター”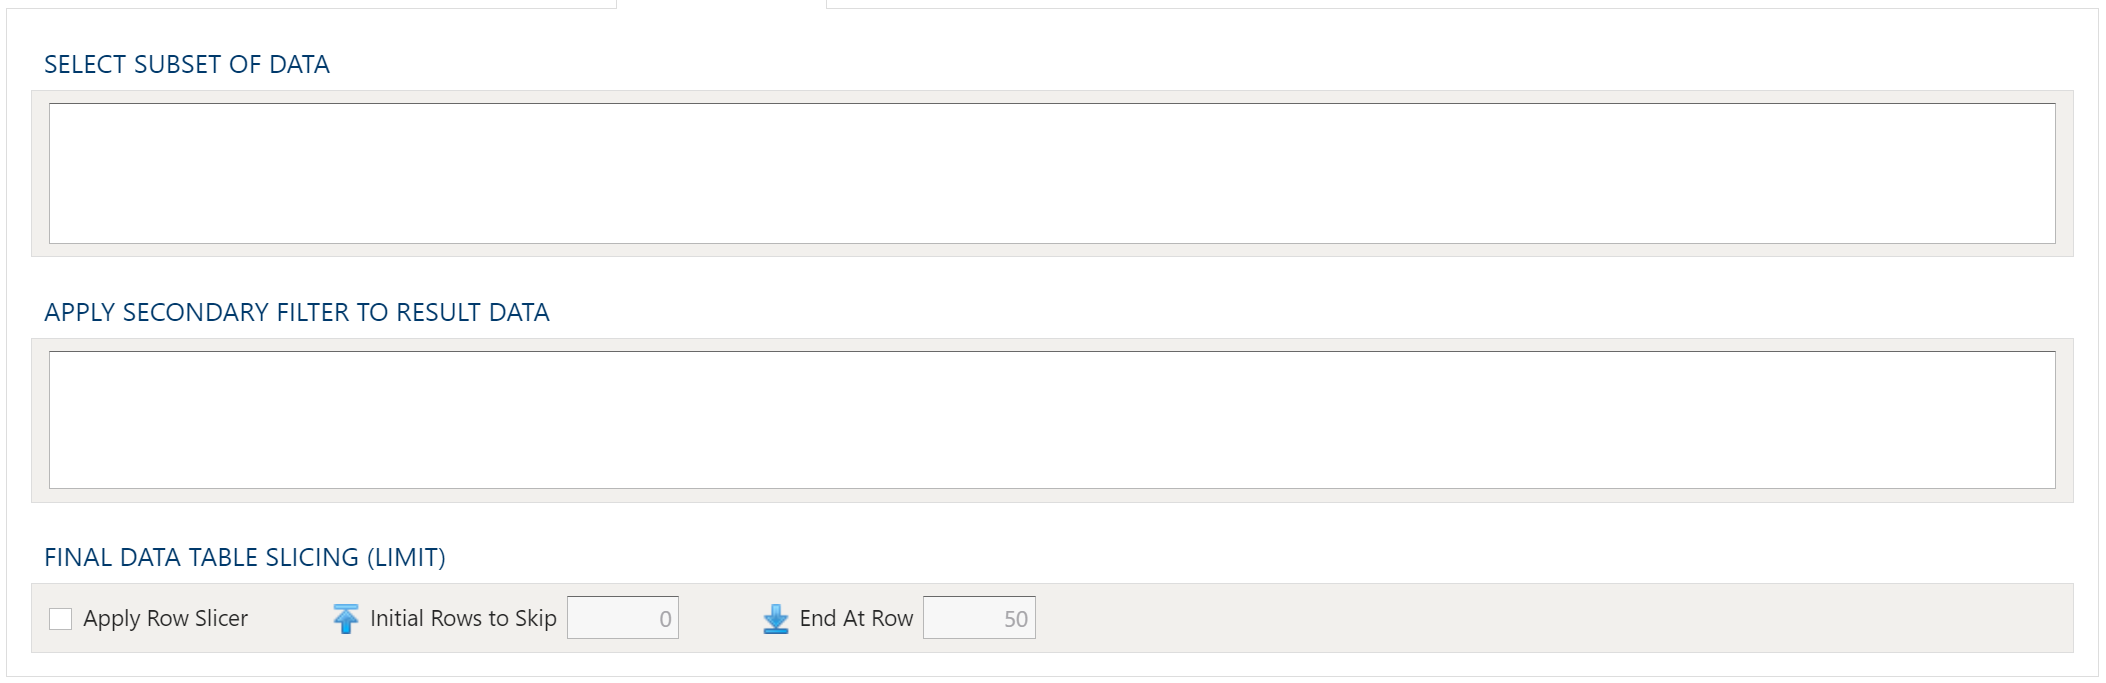
柔軟性を最大限に高めるため、データフィルターはソースデータとターゲットデータの両方で使用できます。データセットが大きい場合は、ソース側で行を絞り込んでおくと、残りの処理を小さなデータセットに対して実行できるため、特に効果的です。
データのサブセットを選択
このフィルタータイプでは、指定した条件に基づいて、受信するソースデータをフィルター処理できます。
結果データにセカンダリフィルターを適用
このフィルタータイプでは、変換後の結果データに対して、指定した条件に基づくフィルターを適用できます。 変換後の結果にフィルターを適用できるため、複雑な計算、集計、ウィンドウ関数の結果に基づいて行を除外できます。
最終データテーブルのスライス(制限)
行のスライス機能では、範囲と開始位置に基づいて、結果セットの行数を制限できます。
フィルター構文
フィルター構文には Python SQLAlchemy を使用します。これは他の式と同じ構文です。
式の例と式関数については、式のセクションを参照してください。