

Allocation Split
Descripción
Sección titulada «Descripción»Divide el valor de una fila de origen en partes y envía cada parte a un destino distinto, con proporciones determinadas por los datos de inductores. Es más sencillo que Allocation Rules: úselo cuando solo necesite repartir valores sin una dimensión de asignación.
Patrón habitual: tomar un importe total, dividirlo entre varios destinatarios según los porcentajes o las ponderaciones de una tabla de inductores y generar una fila de salida por destinatario.
Configuración de la tabla de datos
Sección titulada «Configuración de la tabla de datos»La Tabla de valores que asignar, la Tabla de datos de inductores y la Tabla de resultados de la asignación se pueden seleccionar de forma dinámica o estática.
Selección dinámica de tablas
Sección titulada «Selección dinámica de tablas»La opción de tabla dinámica permite especificar una tabla mediante texto y variables. Es útil en flujos de trabajo controlados por variables, en los que las referencias a tablas o vistas dependen de las variables especificadas.
Un ejemplo que usa la variable current_month para apuntar dinámicamente a una tabla:
legal_entity/inputs/{current_month}/ledger_valuesSelección estática de tablas
Sección titulada «Selección estática de tablas»Cuando se desea una tabla específica como origen, deje sin marcar la casilla Dynamic y seleccione la tabla de origen en el menú desplegable.
El Explorador de tablas siempre está disponible con cualquier selección de tabla. Haga clic en el botón del Explorador de tablas situado a la derecha de la selección de tabla y se abrirá una ventana del Explorador de tablas.
Tabla de valores que asignar
Sección titulada «Tabla de valores que asignar»Esta es la tabla que contiene los valores que se van a asignar. Normalmente son valores de costo o de ingresos.
Tabla de datos de inductores
Sección titulada «Tabla de datos de inductores»La tabla de datos de inductores contiene los valores que el paso de asignación usará para asignar los costos.
Ejemplos:
- Para que una cadena de suministro asigne costos a los clientes, podría usar datos de entregas con el número de entregas o el peso de las entregas como inductor.
- Para que un servicio de asistencia de TI asigne sus costos a los departamentos a los que da soporte, los datos de inductores serían el número de incidencias por centro de costos.
Driver Data Sign Rule
Sección titulada «Driver Data Sign Rule»Los datos de inductores pueden contener valores positivos y negativos. Driver Data Sign Rule le permite decidir cómo se tratarán los signos en conflicto.
- Error on conficting signs: el paso de asignación generará un error y se detendrá si encuentra signos en conflicto.
- Proceed with warning on conflicting signs: el paso de asignación usará tanto los valores de inductores negativos como los positivos, pero mostrará una advertencia.
- Use only positive driver values: el paso de asignación usará solo los valores de inductores positivos e ignorará los negativos.
- Use only negative driver values: el paso de asignación usará solo los valores de inductores negativos e ignorará los positivos.
- Use absolute values of driver data: el paso de asignación usará los valores absolutos de los datos de inductores.
Tabla de resultados de la asignación
Sección titulada «Tabla de resultados de la asignación»Anexar resultados a la tabla de destino
Sección titulada «Anexar resultados a la tabla de destino»Si se marca esta casilla, los resultados de la asignación se anexarán a la tabla de resultados de la asignación. Si no se marca, la tabla de resultados de la asignación se sobrescribirá cada vez que se ejecute el paso de asignación.
Columnas separadas para los resultados asignados
Sección titulada «Columnas separadas para los resultados asignados»Si se marca esta casilla, la tabla de resultados mostrará el importe de cada registro asignado, así como el importe realmente asignado a cada registro de inductor.
Mapa de origen de la asignación
Sección titulada «Mapa de origen de la asignación»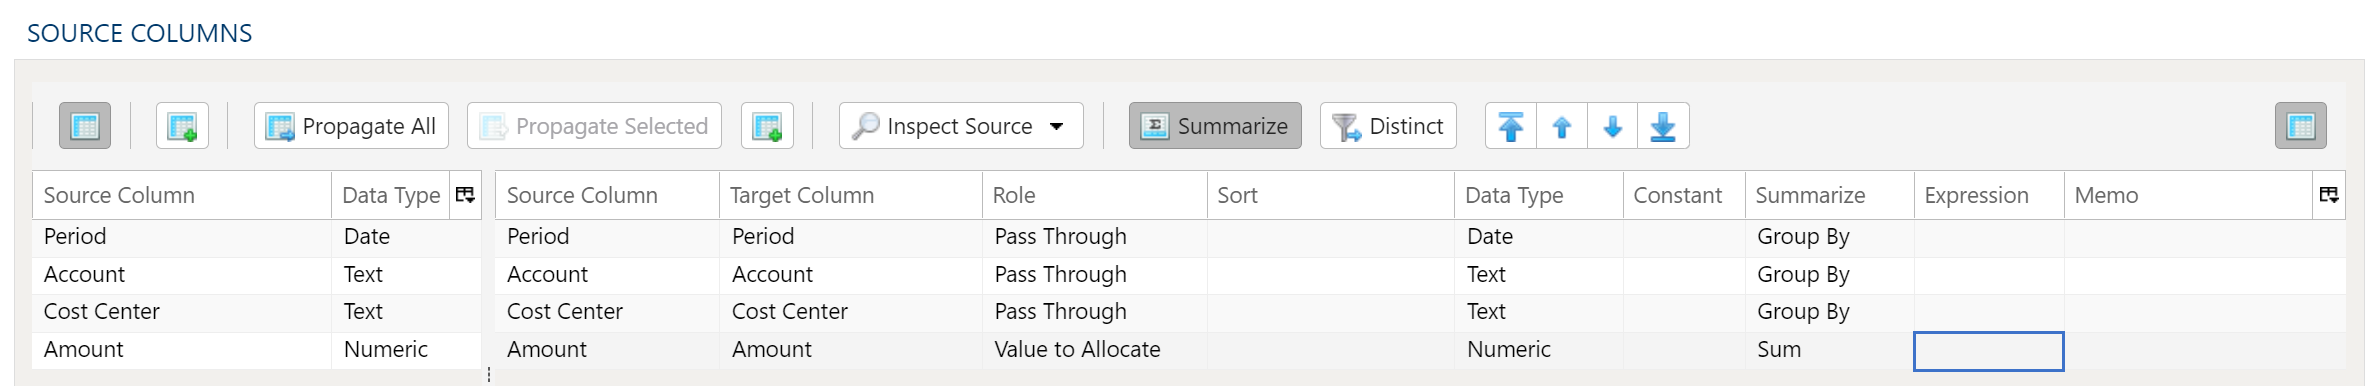
El mapa de origen de la asignación se utiliza para asignar las columnas de la Tabla de valores que asignar que se usarán en el paso de asignación.
Inspección y rellenado del asignador
El botón de menú Inspeccionar origen ofrece formas adicionales de asignar columnas del origen al destino:
- Rellenar ambas tablas de asignación: propaga todos los valores de la tabla de datos de origen a la tabla de datos de destino. Es la opción predeterminada.
- Rellenar solo la tabla de asignación de origen: asigna únicamente los valores de la tabla de datos de origen. Resulta útil al modificar un flujo de trabajo existente cuando la estructura de columnas de origen ha cambiado.
- Rellenar solo la tabla de asignación de destino: propaga todos los valores únicamente a la tabla de datos de destino.
Si las opciones de columnas de origen y destino no son suficientes, puede agregar otras columnas a la tabla de datos de destino de varias maneras:
- Propagar todo inserta todas las columnas de origen en la tabla de datos de destino, existan ya o no.
- Propagar seleccionadas inserta únicamente las columnas de origen seleccionadas.
- Haga clic con el botón derecho en el lado de destino y seleccione Insertar fila para insertar una fila inmediatamente encima de la fila seleccionada.
- Haga clic con el botón derecho en el lado de destino y seleccione Anexar fila para insertar una fila al final (en el extremo derecho) de la tabla de datos de destino.
Rol
Cada columna del asignador de datos debe tener un rol asignado:
- Paso directo: estas columnas aparecerán en la tabla de resultados de la asignación.
- Valor que asignar: esta es la columna que contiene los valores que se van a asignar.
Eliminación de columnas
Para eliminar columnas de la tabla de datos de destino, seleccione las columnas que desee, haga clic con el botón derecho y seleccione Eliminar.
Cambio del orden de las columnas
Para reorganizar las columnas de la tabla de datos de destino, seleccione las columnas que desee. Puede usar cualquiera de estas opciones:
- Flechas de movimiento en bloque: seleccione la opción de movimiento que desee con las flechas de la esquina superior derecha.
- Menú contextual: haga clic con el botón derecho y seleccione Mover al principio, Subir, Bajar o Mover al final.
Reducción del resultado a registros distintos
Para devolver solo opciones distintas, seleccione la opción de menú Distinto. Esto mostrará un conjunto de casillas de verificación para cada columna del origen. Marque la casilla situada junto a la columna correspondiente para devolver solo resultados distintos.
Según la situación, puede ser preferible utilizar un resumen en su lugar.
El proceso de eliminación de duplicados conserva el primer registro único que encuentra y descarta el resto. Si la coherencia entre ejecuciones es importante, puede ser conveniente ordenar los datos.
Agregación y agrupación
Para agregar resultados, seleccione la opción de menú Resumir. Esto mostrará un conjunto de cuadros de selección para cada columna de la tabla de datos de destino. Elija un método de resumen adecuado para cada columna.
- Agrupar por
- Suma
- Mín.
- Máx.
- Primero
- Último
- Recuento
- Recuento (incluidos nulos)
- Media
- Desviación estándar
- Desviación estándar muestral
- Desviación estándar poblacional
- Varianza
- Varianza muestral
- Varianza poblacional
- Avanzado sin agrupar
Para un uso avanzado del asignador de datos, como expresiones, limpieza y constantes, consulte Uso avanzado del asignador de datos
Filtros de origen de la asignación
Sección titulada «Filtros de origen de la asignación»
Para ofrecer la máxima flexibilidad, hay filtros de datos disponibles tanto para los datos de origen como para los datos de destino. En conjuntos de datos grandes, puede ser especialmente beneficioso filtrar filas en el origen para que las operaciones restantes se realicen sobre un conjunto de datos más pequeño.
Seleccionar un subconjunto de datos
Este tipo de filtro permite filtrar los datos de origen entrantes según las condiciones especificadas.
Aplicar un filtro secundario a los datos resultantes
Este tipo de filtro permite aplicar un filtro a los datos resultantes posteriores a la transformación según las condiciones especificadas. La posibilidad de aplicar un filtro sobre el resultado transformado permite realizar exclusiones basadas en los resultados de cálculos complejos, resúmenes o funciones de ventana.
Segmentación final de la tabla de datos (límite)
La capacidad de segmentación de filas permite limitar las filas del conjunto de resultados según un intervalo y un punto de inicio.
Sintaxis de filtros
La sintaxis de filtros utiliza Python SQLAlchemy, que es la misma sintaxis que otras expresiones.
Consulte ejemplos y funciones de expresión en el área de Expresiones.
Mapa de datos de inductores
Sección titulada «Mapa de datos de inductores»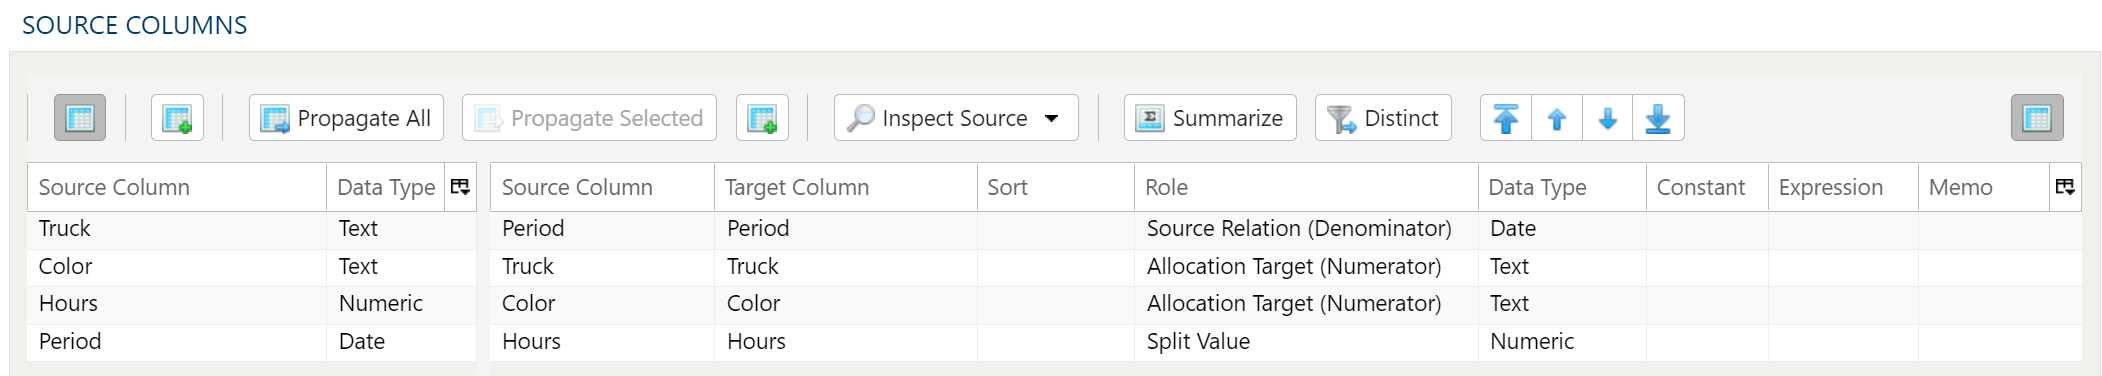
El mapa de datos de inductores de la asignación se utiliza para asignar las columnas de la Tabla de datos de inductores que se usarán en el paso de asignación.
Inspección y rellenado del asignador
El botón de menú Inspeccionar origen ofrece formas adicionales de asignar columnas del origen al destino:
- Rellenar ambas tablas de asignación: propaga todos los valores de la tabla de datos de origen a la tabla de datos de destino. Es la opción predeterminada.
- Rellenar solo la tabla de asignación de origen: asigna únicamente los valores de la tabla de datos de origen. Resulta útil al modificar un flujo de trabajo existente cuando la estructura de columnas de origen ha cambiado.
- Rellenar solo la tabla de asignación de destino: propaga todos los valores únicamente a la tabla de datos de destino.
Si las opciones de columnas de origen y destino no son suficientes, puede agregar otras columnas a la tabla de datos de destino de varias maneras:
- Propagar todo inserta todas las columnas de origen en la tabla de datos de destino, existan ya o no.
- Propagar seleccionadas inserta únicamente las columnas de origen seleccionadas.
- Haga clic con el botón derecho en el lado de destino y seleccione Insertar fila para insertar una fila inmediatamente encima de la fila seleccionada.
- Haga clic con el botón derecho en el lado de destino y seleccione Anexar fila para insertar una fila al final (en el extremo derecho) de la tabla de datos de destino.
Rol
Cada columna del asignador de datos debe tener un rol asignado:
- Relación de origen: estas columnas tienen columnas correspondientes en la Tabla de valores que asignar.
- Destino de la asignación: las columnas serán el destino del paso de asignación y aparecerán en la Tabla de resultados de la asignación.
- Valor de división: esta columna contiene los valores que se usarán para asignar los valores de la Tabla de valores que asignar.
Eliminación de columnas
Para eliminar columnas de la tabla de datos de destino, seleccione las columnas que desee, haga clic con el botón derecho y seleccione Eliminar.
Cambio del orden de las columnas
Para reorganizar las columnas de la tabla de datos de destino, seleccione las columnas que desee. Puede usar cualquiera de estas opciones:
- Flechas de movimiento en bloque: seleccione la opción de movimiento que desee con las flechas de la esquina superior derecha.
- Menú contextual: haga clic con el botón derecho y seleccione Mover al principio, Subir, Bajar o Mover al final.
Reducción del resultado a registros distintos
Para devolver solo opciones distintas, seleccione la opción de menú Distinto. Esto mostrará un conjunto de casillas de verificación para cada columna del origen. Marque la casilla situada junto a la columna correspondiente para devolver solo resultados distintos.
Según la situación, puede ser preferible utilizar un resumen en su lugar.
El proceso de eliminación de duplicados conserva el primer registro único que encuentra y descarta el resto. Si la coherencia entre ejecuciones es importante, puede ser conveniente ordenar los datos.
Agregación y agrupación
Para agregar resultados, seleccione la opción de menú Resumir. Esto mostrará un conjunto de cuadros de selección para cada columna de la tabla de datos de destino. Elija un método de resumen adecuado para cada columna.
- Agrupar por
- Suma
- Mín.
- Máx.
- Primero
- Último
- Recuento
- Recuento (incluidos nulos)
- Media
- Desviación estándar
- Desviación estándar muestral
- Desviación estándar poblacional
- Varianza
- Varianza muestral
- Varianza poblacional
- Avanzado sin agrupar
Para un uso avanzado del asignador de datos, como expresiones, limpieza y constantes, consulte Uso avanzado del asignador de datos
Filtros de datos de inductores
Sección titulada «Filtros de datos de inductores»
Para ofrecer la máxima flexibilidad, hay filtros de datos disponibles tanto para los datos de origen como para los datos de destino. En conjuntos de datos grandes, puede ser especialmente beneficioso filtrar filas en el origen para que las operaciones restantes se realicen sobre un conjunto de datos más pequeño.
Seleccionar un subconjunto de datos
Este tipo de filtro permite filtrar los datos de origen entrantes según las condiciones especificadas.
Aplicar un filtro secundario a los datos resultantes
Este tipo de filtro permite aplicar un filtro a los datos resultantes posteriores a la transformación según las condiciones especificadas. La posibilidad de aplicar un filtro sobre el resultado transformado permite realizar exclusiones basadas en los resultados de cálculos complejos, resúmenes o funciones de ventana.
Segmentación final de la tabla de datos (límite)
La capacidad de segmentación de filas permite limitar las filas del conjunto de resultados según un intervalo y un punto de inicio.
Sintaxis de filtros
La sintaxis de filtros utiliza Python SQLAlchemy, que es la misma sintaxis que otras expresiones.
Consulte ejemplos y funciones de expresión en el área de Expresiones.