

Recuperación, fundamentación y rutas de análisis
“RAG” suele significar una sola cosa: trocear el corpus en fragmentos, incrustarlos en un almacén de vectores y pegar las coincidencias más cercanas en la indicación. PlaidCloud hace eso con un único corpus (la documentación del producto) y deliberadamente no lo hace con sus datos.
Sus tablas se leen en vivo, en el momento en que se pregunta por ellas, con sus permisos. Eso no es una decisión de rendimiento; es lo que hace que una respuesta sea digna de confianza y que un control de acceso tenga sentido.
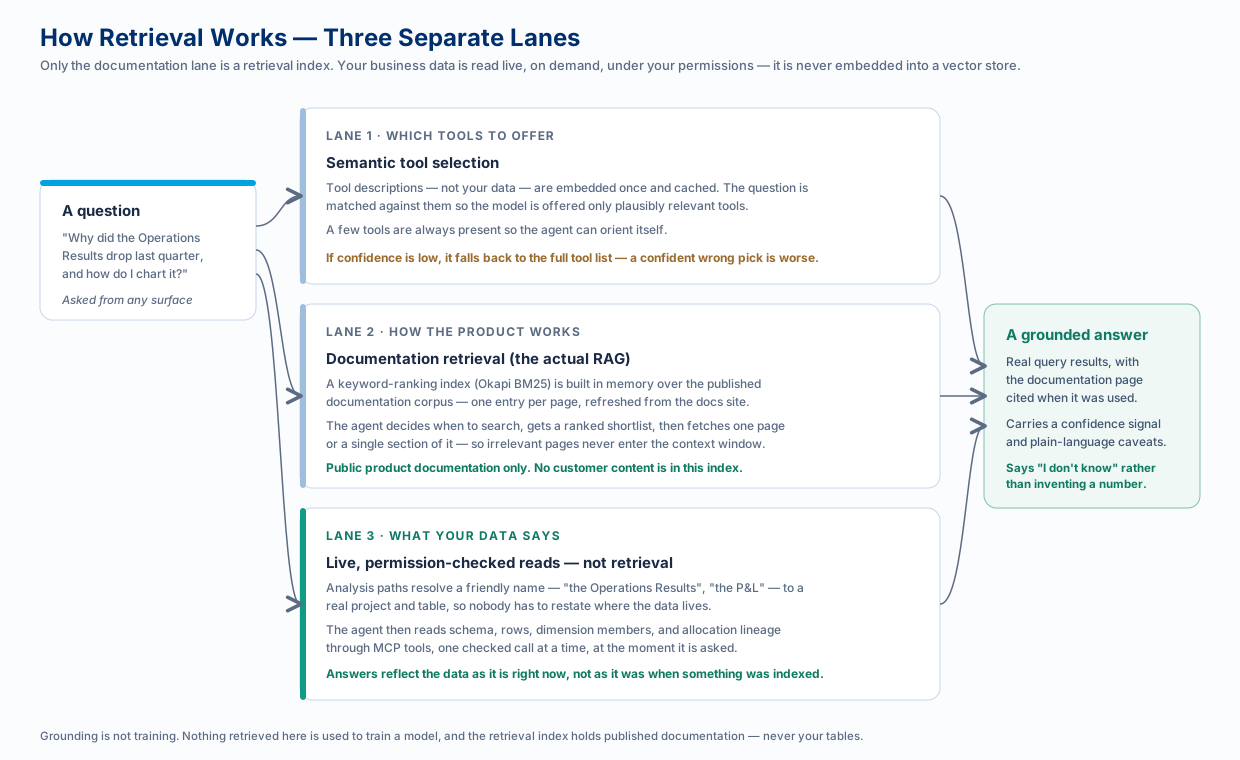
Carril 1: elegir qué herramientas ofrecer
Sección titulada «Carril 1: elegir qué herramientas ofrecer»Este carril se ejecuta para el asistente integrado, que lleva su propio catálogo de herramientas. Cada descripción de herramienta que muestra al modelo consume tokens de la indicación en cada turno, así que antes de que el modelo vea nada, la pregunta se compara por similitud semántica con las descripciones de las herramientas (nunca con sus datos) y solo se ofrecen las herramientas plausiblemente relevantes.
En las demás superficies, el catálogo de herramientas lo gestiona la conexión MCP: el conector de Anthropic lo administra en el servidor, y el bucle del lado del cliente limita la superficie que declara. Los carriles 2 y 3 que se describen a continuación se aplican en todas partes.
Tres detalles importan:
- Las incrustaciones describen herramientas, no contenido. Se calculan una sola vez a partir de los nombres y las descripciones de las herramientas, se almacenan en caché y se reconstruyen automáticamente cuando cambia una descripción.
- Algunas herramientas están siempre presentes para que el agente pueda orientarse (averiguar quién pregunta y en qué proyecto) incluso cuando la pregunta no menciona ninguno de los dos.
- Si la confianza es baja, se recurre a la lista completa. Una restricción equivocada pero segura de sí misma es peor que pagar el costo completo de tokens una vez, así que una coincidencia incierta simplemente lo muestra todo. Los turnos muy cortos (“gracias”, “ok”) omiten este paso por completo.
Carril 2: fundamentación en la documentación
Sección titulada «Carril 2: fundamentación en la documentación»Esta es la verdadera ruta de generación aumentada por recuperación, y responde a “¿cómo hago…?”, “¿qué es…?” y “¿dónde configuro…?”.
La documentación publicada se obtiene como un corpus estructurado (una entrada por página) y se indexa en memoria con Okapi BM25, una función de clasificación por palabras clave. El agente trabaja entonces en dos movimientos:
- Buscar devuelve una lista corta clasificada de páginas: slug, título, descripción y puntuación.
- Obtener trae una página, o una sección concreta de ella, una vez que el agente ha decidido cuál necesita realmente.
El punto clave del diseño es que el agente decide cuándo buscar y cuánto leer. La inyección pasiva pega algo en cada indicación, sirva o no; la recuperación dirigida por herramientas mantiene las páginas irrelevantes fuera de la ventana de contexto y permite que el agente cite la página que usó para que usted pueda profundizar.
Si el corpus de documentación no está disponible momentáneamente, el agente responde sin él en lugar de hacer fallar el turno.
Carril 3: lectura de sus propios datos
Sección titulada «Carril 3: lectura de sus propios datos»Las preguntas sobre sus cifras no se responden mediante recuperación en absoluto. El agente lee lo que necesita, cuando lo necesita, mediante herramientas con comprobación de permisos: esquemas de tablas, filas, miembros de dimensiones, linaje de flujos de trabajo, rastreos de asignación.
Por eso las respuestas están al día (reflejan los datos tal como están ahora, no como estaban cuando algo se indexó por última vez) y por eso funciona el control de acceso: no hay ningún índice precompilado que pueda filtrar datos a través de un límite de permisos, porque no hay índice.
Rutas de análisis: la capa de nombres
Sección titulada «Rutas de análisis: la capa de nombres»Las lecturas en vivo necesitan saber qué tabla. Las rutas de análisis son el vocabulario compartido que lo hace sencillo: un nombre sencillo (“Resultados operativos”, “el estado de pérdidas y ganancias”, “Plantilla de personal”) asignado una sola vez a un proyecto y una tabla reales, y que a partir de entonces puede usar cualquier persona del espacio de trabajo.
- Pregunte por el nombre en lugar de indicar un proyecto y una tabla cada vez.
- Marque una como predeterminada del espacio de trabajo para que una pregunta sin destino, como “¿qué cambió el último trimestre?”, llegue a un lugar razonable.
- Todos se refieren a lo mismo. Cuando todo el equipo dice “el estado de pérdidas y ganancias”, llega a la misma tabla.
Un administrador las registra; cualquiera puede usarlas; cada pregunta se sigue ejecutando con los permisos propios de la persona que la hace. Funcionan igual desde el asistente integrado, Microsoft 365 Copilot y un agente de programación conectado. Consulte Rutas de análisis para saber cómo configurarlas.
El catálogo de expresiones
Sección titulada «El catálogo de expresiones»Cuando el asistente escribe una expresión, no adivina los nombres de las funciones de memoria. Consulta un catálogo estructurado de todas las funciones de expresión de PlaidCloud (nombre, firma, enlace a la documentación, categoría), contrastado con las funciones que su almacén de datos ofrece realmente, con sugerencias de coincidencias cercanas cuando un nombre casi es correcto. Es una búsqueda, no una búsqueda por similitud, porque para los nombres de funciones “casi correcto” es incorrecto.
Fundamentar no es entrenar
Sección titulada «Fundamentar no es entrenar»Hay dos cosas que preocupan con razón:
- Nada de lo que se recupera aquí entrena un modelo. La fundamentación pone información en una sola solicitud. No cambia los pesos del modelo, y su contenido no se usa para entrenar el modelo de nadie.
- El índice de recuperación contiene solo documentación pública. No se incrusta en él ningún contenido de clientes.
A dónde van sus datos, y cómo mantenerlos dentro de una infraestructura que usted controla, se explica en Uso de su propio LLM controlado.
Por qué esto produce mejores respuestas
Sección titulada «Por qué esto produce mejores respuestas»La fundamentación es lo que permite que el asistente diga “no lo sé” en lugar de inventar algo. Como cada cifra proviene de una consulta real y cada afirmación sobre el producto de una página de documentación real, una respuesta puede calificarse: cada una lleva una señal de confianza y salvedades en lenguaje sencillo, y un resumen narrativo se verifica para que no pueda omitir en silencio una limitación ni citar una cifra que el análisis nunca produjo. Consulte Respuestas en las que puede confiar.
Relacionado
Sección titulada «Relacionado»- Rutas de análisis: configure los nombres compartidos
- Rastreo de asignaciones: preguntar por qué se movió un resultado
- Arquitectura de IA y LLM: las superficies y la ruta compartida