

Arquitectura de IA y LLM
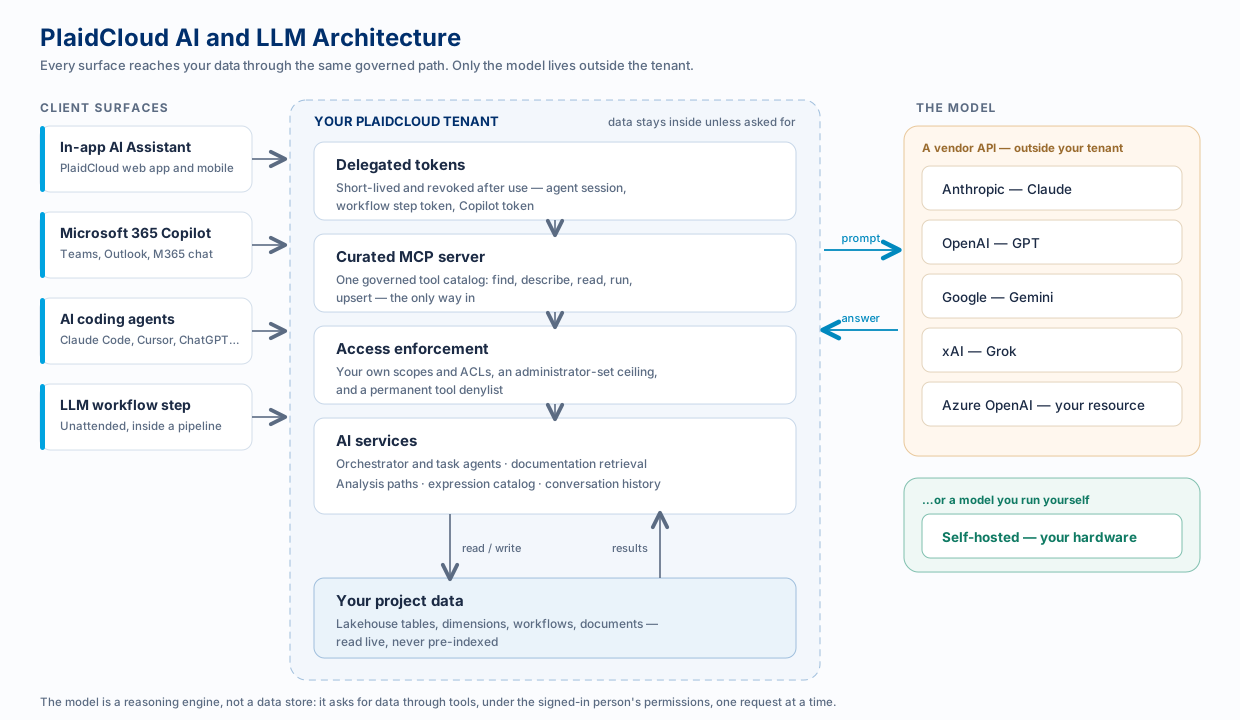
PlaidCloud no tiene una única función de IA. Tiene cuatro formas de acceder a un modelo (el asistente integrado en el producto, Microsoft 365 Copilot, los agentes de programación externos y un paso LLM dentro de un flujo de trabajo) y las cuatro funcionan sobre la misma ruta gobernada. El modelo en sí es intercambiable: Claude, GPT, Gemini, Grok, un recurso de Azure OpenAI en su propia suscripción o un modelo que usted mismo aloje.
Esta sección explica esa arquitectura: qué se ejecuta dónde, qué cruza el límite y por qué.
Las cuatro superficies
Sección titulada «Las cuatro superficies»| Superficie | Quién la usa | Cómo llega el modelo a los datos | Dónde empezar |
|---|---|---|---|
| Asistente de IA integrado | Cualquier persona que trabaje en PlaidCloud | Los agentes propios de PlaidCloud llaman a herramientas internas en su nombre | Weave AI Chat |
| Microsoft 365 Copilot | Equipos completos, en Teams y Outlook | Un agente publicado inicia sesión de la persona y luego llama al servidor MCP | Microsoft 365 Copilot |
| Agentes de programación con IA | Analistas y desarrolladores | Su cliente se conecta directamente al servidor MCP mediante OAuth | Primeros pasos |
| Paso LLM del flujo de trabajo | Canalizaciones desatendidas | En Anthropic, un token limitado a los objetos que usted vincula; en otros proveedores, ningún acceso a datos; consulte las reglas del paso | Paso LLM |
Se diferencian en quién conduce y en dónde ocurre la conversación. No se diferencian en lo que el modelo tiene permitido tocar.
Una ruta gobernada
Sección titulada «Una ruta gobernada»Sea cual sea la superficie por la que llegue una pregunta, se cumplen siempre las mismas cinco cosas.
-
El modelo se ejecuta como una persona, no como la plataforma. Cada solicitud lleva una credencial de corta duración, revocada al terminar, que representa al usuario con la sesión iniciada. No hay una cuenta de servicio compartida con derechos elevados detrás de la IA.
-
Las herramientas son la única vía de entrada. El modelo no puede consultar directamente su Lakehouse. Llama a un catálogo curado de herramientas (buscar, describir, leer, ejecutar, upsert) y cada llamada se comprueba de forma independiente.
-
Sus propios permisos siguen delimitándolo. Una solicitud de IA nunca puede ver ni cambiar algo que usted mismo no pudiera ver o cambiar. La capa de IA restringe el acceso; nunca lo amplía.
-
Un administrador fija el límite máximo, y empieza cerrado. El Acceso del agente de una conexión de LLM comienza en solo lectura. Microsoft 365 Copilot comienza sin nada: hasta que un administrador asigna a alguien un nivel de acceso, una persona con la sesión iniciada no obtiene datos. Son dos mecanismos distintos, pero elevar cualquiera de ellos solo limita lo que la IA puede intentar; nunca amplía lo que usted ya podía alcanzar por sí mismo.
-
Algunas cosas están prohibidas de forma permanente. La configuración de credenciales y conexiones, la administración de identidades y grupos, los cambios en el control de acceso, la publicación y el código implementable nunca pueden ser invocados por una credencial de IA, sin importar lo que haya concedido un administrador, en ningún proveedor. Esas acciones siguen siendo exclusivamente humanas.
La vida de una pregunta
Sección titulada «La vida de una pregunta»Tomemos la pregunta “¿Por qué subió el costo de TI asignado a Atlanta el trimestre pasado?”, formulada desde cualquier superficie:
-
Se emite una credencial para la persona que pregunta, con alcance limitado y de corta duración.
-
Se ponen herramientas a disposición del modelo: se restringen a lo que la pregunta plausiblemente necesita en las superficies que hacen esa restricción, y se descubren desde el catálogo en las que no.
-
La indicación llega al modelo: la pregunta, las reglas permanentes y las descripciones de las herramientas. Todavía no hay datos.
-
El modelo pide datos mediante llamadas a herramientas: resolver la ruta de análisis, leer el esquema, ejecutar el rastreo de asignación, leer las filas de inductores. Cada llamada se comprueba al llegar para verificar los permisos.
-
El modelo responde a partir de lo que recibió, cita la página de documentación si consultó alguna y incluye una señal de confianza y salvedades.
-
La credencial se revoca. Un token capturado no puede reutilizarse cuando termina la solicitud.
El detalle importante es el paso 4: el modelo no tiene sus datos. Pide porciones de ellos, y cada petición se evalúa.
Siguientes lecturas
Sección titulada «Siguientes lecturas»Relacionado
Sección titulada «Relacionado»- Respuestas en las que puede confiar: cómo se califican las respuestas y se les añaden salvedades
- Rutas de análisis: nombres sencillos para las tablas sobre las que pregunta su equipo
- Arquitectura de la plataforma: dónde encaja la IA en la plataforma en general