

Table Meltステップ
横長で短いデータテーブルを、縦長で幅の狭いデータテーブルに変換するために使用します。選択した列が転置され、列名が複数の行にわたる値に変換されます。
最もわかりやすい例は、列ヘッダーとして月が並んでいるデータテーブルです。
このデータテーブルをピボット解除すると、すべての月の列が行に変換されます。
Jan/Feb 列は、そのまま残す列をキーとして、Month と Value の行にまとめられます。転置する列とそのまま残す列を指定することで、強力なツールになります。ほかのETLツールでこの変換を行うには、さらに十数個のステップが必要になる場合があります。
ソースとターゲットのパラメーター
Section titled “ソースとターゲットのパラメーター”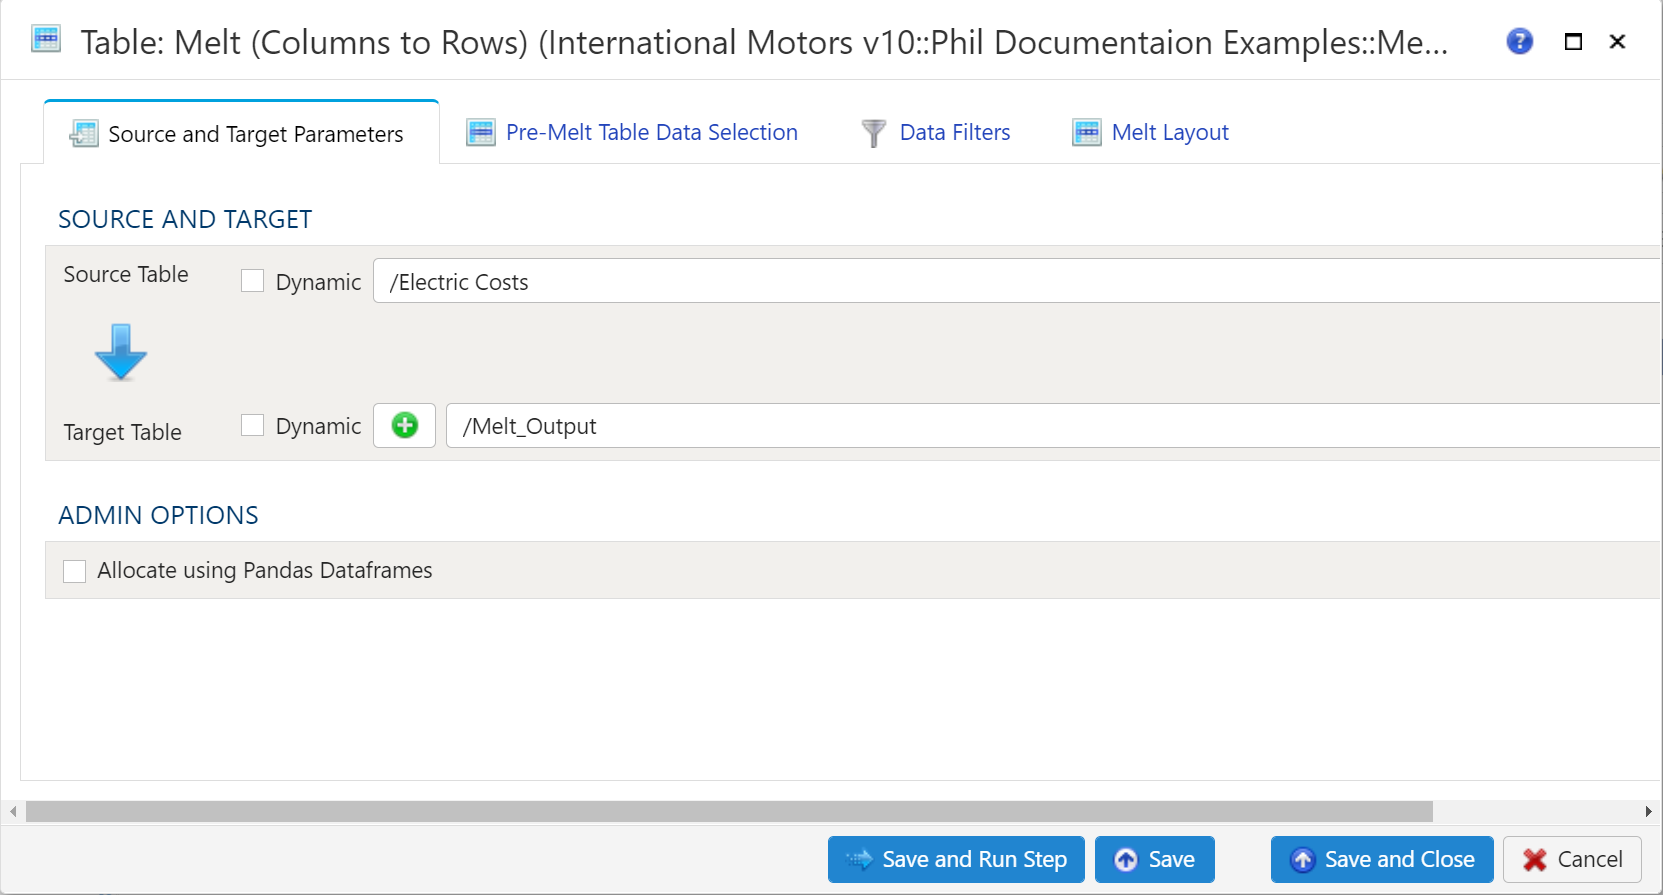
ソースとターゲット
Section titled “ソースとターゲット”ソースとターゲットを設定するには、まず ソーステーブル のドロップダウンメニューから、抽出元のデータテーブルを選択します。
ターゲットテーブル

ターゲットテーブルを設定するには、ターゲットテーブルドロップダウンから既存のテーブルを選択するか、緑色の “+” 記号をクリックして新しいテーブルをターゲットとして作成します。
テーブルの作成
新しいテーブルを作成するときは、ビューまたはテーブルのどちらとして作成するかを選択できます。
ビュー:
ビューは、テーブルを使用する場合に比べてステップの実行時間が大幅に短くなる点で便利です。短所は、テーブルの詳細モードでのデータ探索には向かないことです。
テーブル:
ターゲットにテーブルを使用すると、ステップの実行には時間がかかりますが、詳細モードでのデータ探索はビューよりもはるかに高速です。
ステップの実行時
Table Extract、Table Lookup、Table Inner Join、Table Cross Join、Table Outer Join、Table Anti Join、複数テーブル結合、Table Union Distinct、Table Union All、Table Pivot、Table Melt、Table In-Place Delete、Table Upsert、Table Append の各ステップは、実行時、何かを書き込む前に、ソーステーブルを確認します。この確認では、ステップが構築したクエリを、その時点の各ソーステーブルと照合します。
- ステップが読み取る列がテーブルにない場合、テーブルにない、またはステップのソース列にない結合キーがある場合、またはステップが読み取るソーステーブルが構築されていない場合、ステップは停止します。1つのエラーにすべての問題がそれぞれの修正方法とともに示されます。既存のターゲットテーブルは元の状態のまま残り、ステップが作成する必要があったターゲットテーブルは空のままになります。
- ステップが一覧に載せているが読み取らない列がテーブルにもうない場合は、警告が追加されます。ステップはその列なしで実行されます。
- Table Union Distinct と Table Union All は、構築されていないソーステーブルについては例外です。従来どおり、そのテーブルを警告なしで除外し、残りのテーブルをまとめます。ソーステーブルが1つも構築されていない場合は、失敗せずに警告を出して終了します。
ターゲットがビューであるステップはビューを作成するだけなので、一覧に載せている列と結合キーは、ウェアハウスがそのビューの作成を拒否する場合にのみ、そのテーブルと照合して確認されます。それ以外の場合は、構築されていないソーステーブル、またはステップの一覧にない結合キーがある場合にのみステップが停止し、警告は追加されません。
可能な場合、エラーにはテーブルを構築するステップが示され、テーブルに不足している列と名前が近い列(大文字小文字だけが異なる列など)がある場合は、その列も示されます。
ピボット解除前のテーブルデータの選択
Section titled “ピボット解除前のテーブルデータの選択”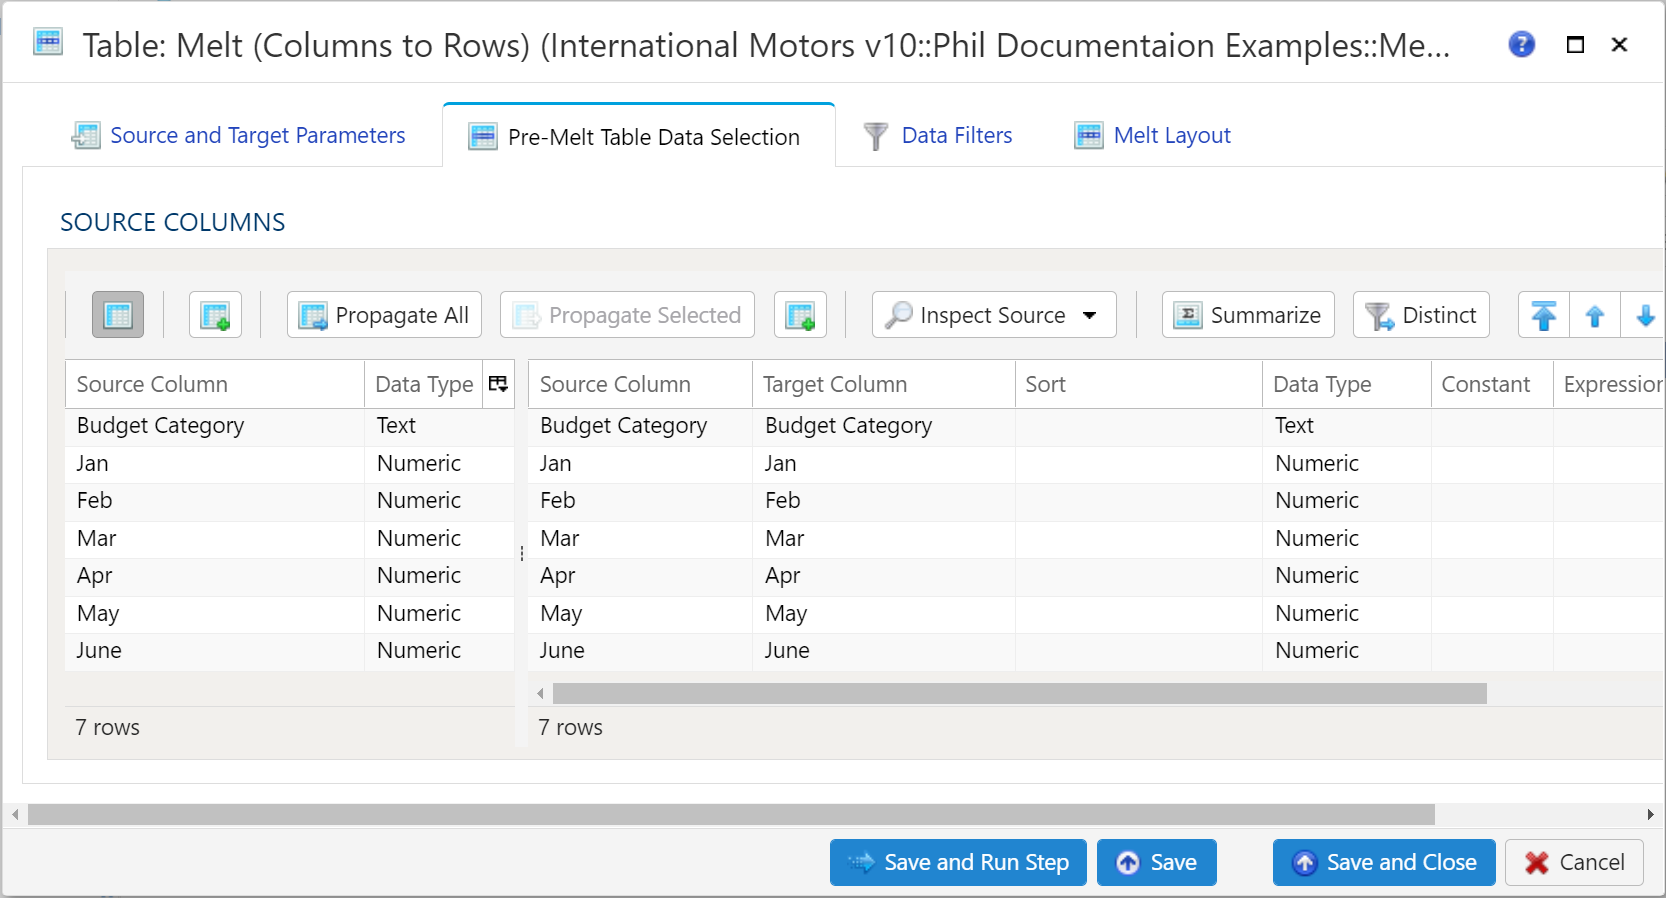
このセクションは、標準のテーブルデータの選択とは少し異なります。基本的に、ピボット解除の操作で使用する列を指定するために使用します。これには、ID列と変数列/値列が含まれます。
ソーステーブルを選択した状態で、ソース列またはターゲット列のどちらかが指定されていないまま保存すると、両方のマッピングテーブルを入力 を選択した場合と同様に、空の側がソースから入力されます。
データフィルター
Section titled “データフィルター”柔軟性を最大限に高めるために、ソースデータとターゲットデータの両方でデータフィルターを使用できます。特に大規模なデータセットでは、ソースで行をフィルターして除外しておくと、以降の操作を小さなデータセットに対して実行できるため、有効です。
ソースデータのサブセットを選択
Section titled “ソースデータのサブセットを選択”データのサブセットを指定するには、有効なPython式であれば何でも使用できます。詳細と例については、式を参照してください。
結果データに二次フィルターを適用
Section titled “結果データに二次フィルターを適用”データのサブセットを指定するには、有効なPython式であれば何でも使用できます。詳細と例については、式を参照してください。
最終データテーブルのスライス(制限)
Section titled “最終データテーブルのスライス(制限)”データを制限するには、行スライサーを適用 ボックスをオンにして、次の項目を指定します。
- スキップする先頭行数: スキップするデータの行数です(列ヘッダー行はカウントに含まれません)。
- 終了行: 含める最後のデータ行です。末尾の行数を数えて削除する場合とは異なります。
ピボット解除のレイアウト
Section titled “ピボット解除のレイアウト”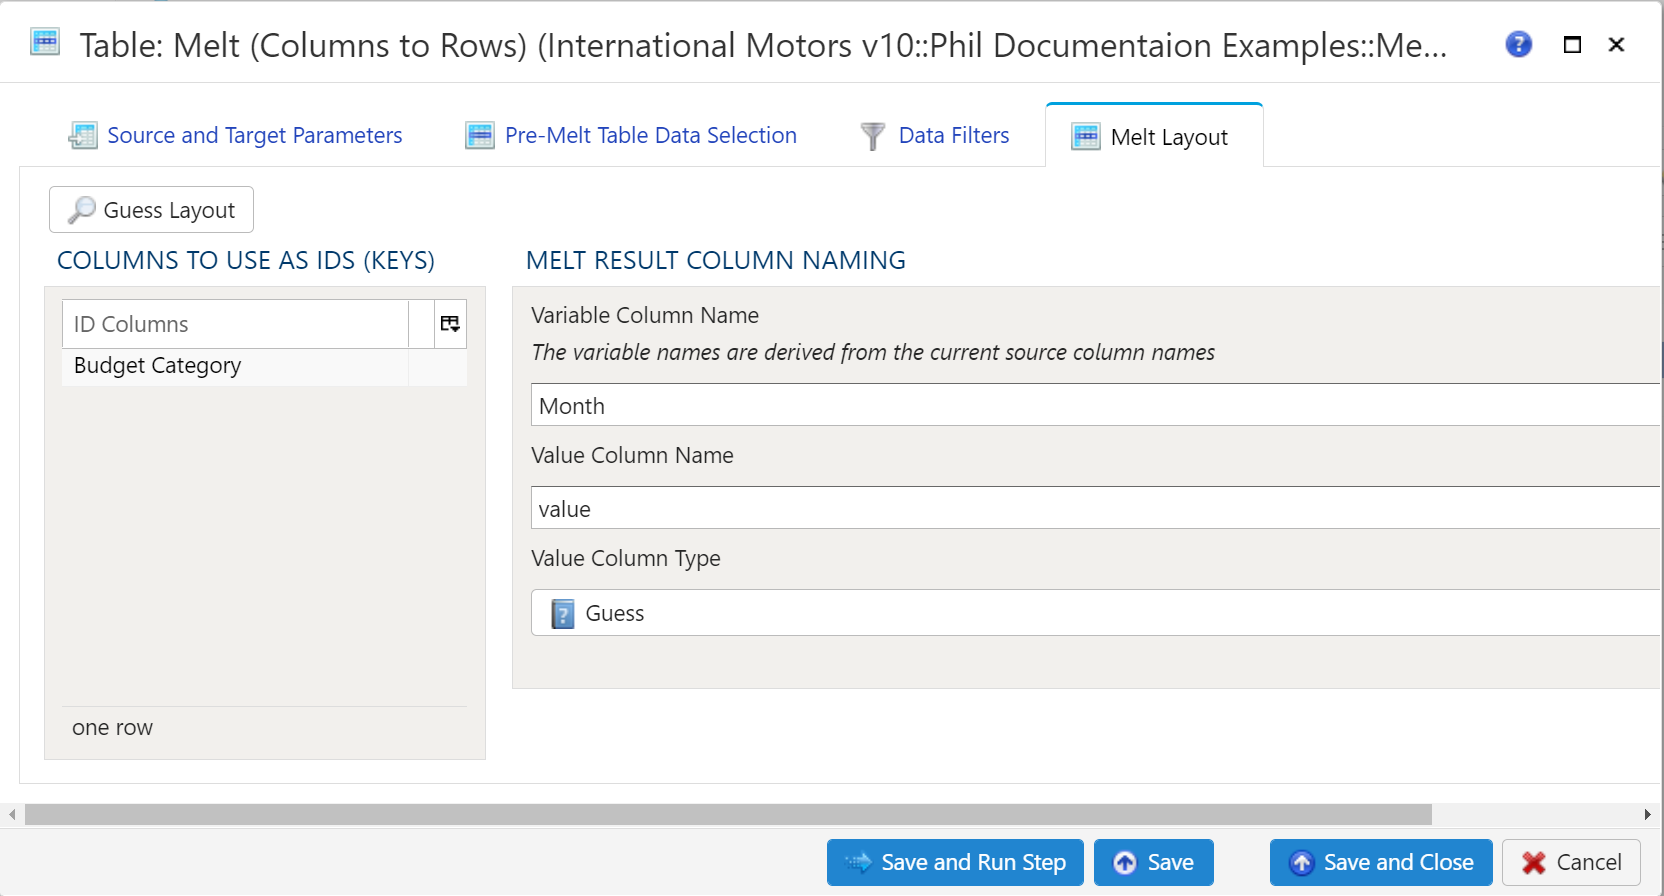
Guess Layout ボタンを使用すると、Analyzeが最初にID列の指定を試みます。デフォルトでは、すべてのテキスト列(データ型が 文字列)が キー セクションに配置されます。数値列はデフォルトでは キー に配置されませんが、モデルのニーズに応じて配置できます。
IDとして使用する列(キー)
Section titled “IDとして使用する列(キー)”ID列は、そのまま残る列です。これらの列は、変数と値の組み合わせの数だけ実質的に繰り返されます。月次テーブルの場合、ID列が12回繰り返されることになります。
ID列は自動または手動で追加できます。自動で追加するには、前述の Guess Layout ボタンを使用します。手動で列を追加するには、セクション内の任意の場所を右クリックし、行を挿入 または 行を追加 を選択して、それぞれ現在選択されている行の前、または末尾に行を追加します。続いて、IDとして使用する列名を入力します。
ID からフィールドを削除するには、右クリックして 削除 を選択します。
ピボット解除結果の列名
Section titled “ピボット解除結果の列名”指定する値は2つあります。どちらの値も、ターゲットのデータテーブルの列名になります。
- 変数列名: 変換で指定されているとおり、変数名は現在のソース列名から取得されます。基本的に、ソースのデータテーブルの列で元々表されていたデータを表す列名を指定します。
- 値列名: ソースのデータテーブル内のデータを表す列名を指定します。通常は、ドル、ポンド、度、パーセントなどの数値の単位になります。
その他のアンピボットオプション には、次のフィールドがあります。
- ステップ実行時にテーブルにある他のすべての列もアンピボットする(
melt_all_columns)— ステップが列挙しておらず、ID列でもない、ステップ実行時にソーステーブルにあるすべての列も、テーブルにある順序でアンピボットします。 - 位置列の名前(
position_name)— この名前の列も書き込みます。この列には、値列の中での各行の値列の0から始まる位置が入ります。 - 型列の名前(
type_name)— この名前の列も書き込みます。この列には、各行の値列のデータ型(integer、numeric、text、boolean、date、timestampなど)が入ります。
上記のドキュメントを参照してください。