

SQLのインポート
外部データベースに対するSQLクエリの結果を、PlaidCloudのプロジェクトテーブルにインポートします。クエリはリモートのデータベースで実行され、結果セットのみがPlaidCloudに取り込まれます。
外部データベーステーブルのインポートとの違いは、SQLを自分で記述する点です。データがPlaidCloudに取り込まれる前に、ソースのデータベースで実行したい複雑な結合、フィルター、集計に便利です。
インポートパラメーター
Section titled “インポートパラメーター”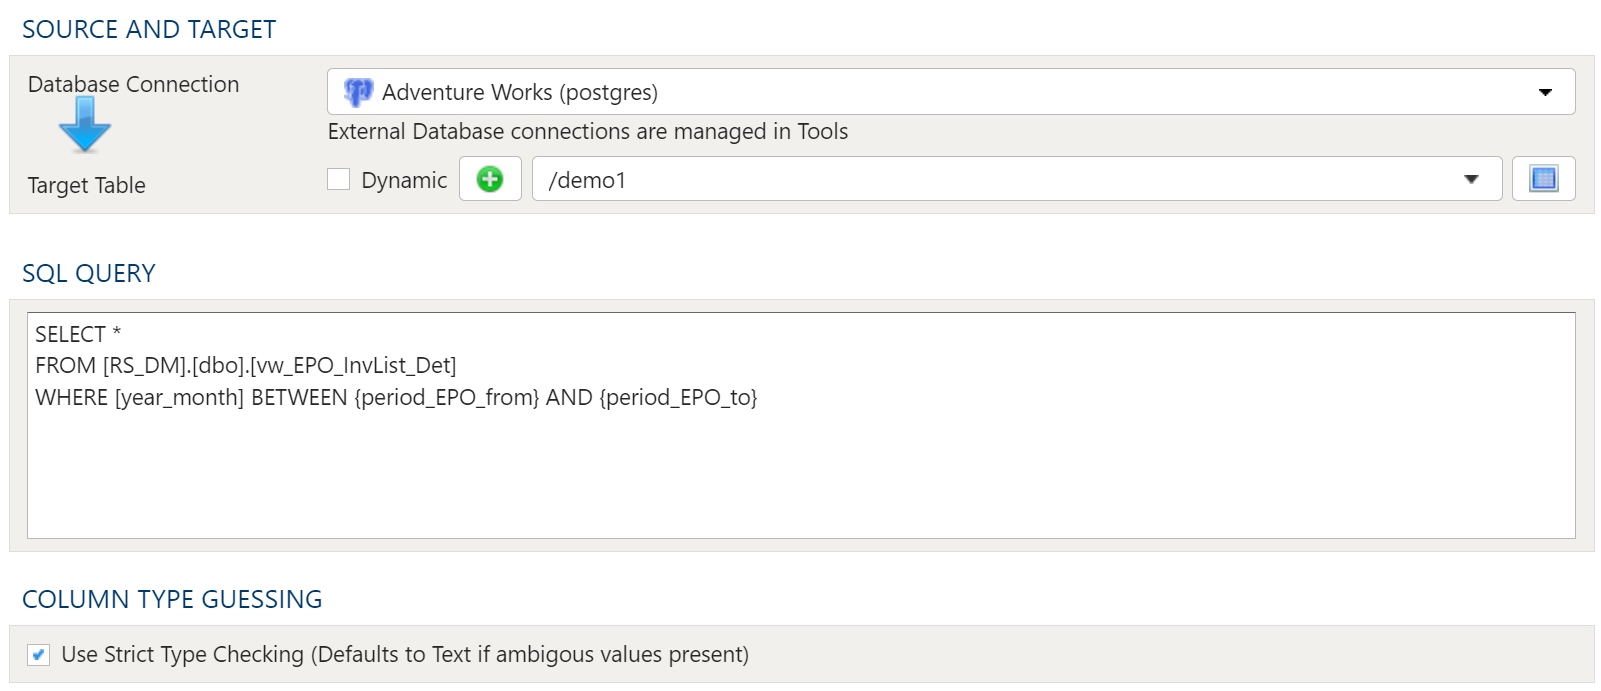
ソースとターゲット
Section titled “ソースとターゲット”データベース接続
Section titled “データベース接続”データベース接続を確立するには、 PlaidCloudデータ接続を参照してください。
ターゲットテーブル
ビューには基になるデータが含まれないため、インポートのターゲットとして選択できるのはテーブルのみです。
Dynamic オプション
Dynamic オプションでは、変数を含むテキストでテーブルを指定できます。テーブルやビューの参照が指定した変数に応じて決まる、変数駆動型のワークフローで便利です。
current_month 変数を使用して、ターゲットテーブルを動的に指定する例:
legal_entity/inputs/{current_month}/ledger_valuesStatic オプション
インポートのターゲットとして特定のテーブルを使用する場合は、Dynamic ボックスをオフのままにして、ターゲットテーブルを選択します。
ターゲットテーブルが存在しない場合は、新規作成ボタンを選択して、目的の場所にテーブルを作成します。
テーブルエクスプローラーは、どのテーブル選択でも常に利用できます。テーブル選択の右側にあるテーブルエクスプローラーボタンをクリックすると、テーブルエクスプローラーのウィンドウが開きます。
SQLクエリ
Section titled “SQLクエリ”このセクションでは、必要なデータを返すSQLクエリを記述します。
列タイプの推測
Section titled “列タイプの推測”SQLのインポートでは、読み込み時にデータ型を推測するか、すべての列をテキスト型に設定するかを選択できます。データがクリーンであれば、データ型を動的に設定するほうが速い場合がありますが、状況によっては問題が発生することがあります。
たとえば、データのほとんどが数値に見えても一部にテキストが含まれていると、数値として設定しようとして、データ型の不一致による読み込みの問題が発生する可能性があります。また、16桁の数値の商品コードがある場合にも問題が起こることがあります。先頭のゼロが切り捨てられ、16桁のコードではなく数値になってしまいます。
ただし、データをすべてテキストに設定した場合は、日付や数値など、テキストであるべきでないデータ型を適切な型に変換するために、後続の抽出ステップが必要です。
トラブルシューティング
Section titled “トラブルシューティング”| 症状 | 考えられる原因 |
|---|---|
| クエリ、接続、データ量に変更がないにもかかわらず、ステップの実行にいつもより著しく長い時間(最大で約30分)がかかった | インポートを実行しているバックグラウンドワーカーが途中で中断され(ワークフローの問題ではなく、プラットフォーム側の再起動または退避)、プラットフォームがテーブルのインポートを自動的に再試行しました。再試行は中断が検出されてから開始されるため、その分の時間が余分にかかります。 |
| その遅延の後も、ステップは正常に完了した | 再試行ではテーブルの内容が完全に置き換えられるため、結果は1回の正常な実行と同じです。確認や再実行は必要ありません。 |
| ステップが「has already been attempted and cannot be safely re-run」で失敗する | SQLのインポートステップでは、この拒否は発生しなくなりました。実行中の中断は再試行されます。設計上、プロジェクトアーカイブの復元やディメンションのロードでは引き続き表示されます。これらは再実行すると何かが置き換えられるのではなく重複が作成されるためです。SQLのインポートステップ自体でこれが表示された場合は、サポートチケットを作成してください。 |