

JSONのインポート
PlaidCloud DocumentからJSONテキストファイルをインポートします。
JSONファイルの詳細については、JSONの公式サイト(http://json.org/)を参照してください。
JSONファイルでは列の順序は保持されません。ソースファイルの列の順序が、インポートされたデータテーブルの列の順序に反映されるとは限りません。
JSONのインポートは、ドキュメント全体をメモリに読み込むのではなく一時ストレージ経由でストリーミングされるため、非常に大きなファイルでもメモリ不足にならずにインポートできます。大きなドキュメントの後半で初めて現れる列も、インポートされるテーブルに含まれます。ネストされたオブジェクトと配列は、標準的なコンパクトなJSONテキストとしてインポートされるため、後続のステップで任意のJSONツールを使って解析できます。
まだ例はありません。
固有の設定項目
Section titled “固有の設定項目”JSONデータの向き
Section titled “JSONデータの向き”次のデータセットを考えてみましょう。
| ID | Name | Gender | State | | 1 | Jack | M | MO | | 2 | Jill | F | MO | | 3 | George | M | VA | | 4 | Abe | M | KY |
JSONファイルは、次の3つのデータ形式のいずれかでインポートできます。
- Records: データはPythonの辞書のセットに保存され、各行は {Column -> Value, …} の形式で保存されます。例を示します。
[{ "ID": 1, "Name": "Jack", "Gender": "M", "State": "MO" }, { "ID": 2, "Name": "Jill", "Gender": "F", "State": "MO" }, { "ID": 3, "Name": "George", "Gender": "M", "State": "VA" }, { "ID": 4, "Name": "Abe", "Gender": "M", "State": "KY" }]- Index: データはネストされたPythonの辞書のセットに保存され、各行は {Index -> {Column -> Value, …},…} の形式で保存されます。例を示します。
{ "0": { "ID": 1, "Name": "Jack", "Gender": "M", "State": "MO" }, "1": { "ID": 2, "Name": "Jill", "Gender": "F", "State": "MO" }, "2": { "ID": 3, "Name": "George", "Gender": "M", "State": "VA" }, "3": { "ID": 4, "Name": "Abe", "Gender": "M", "State": "KY" } }- Split: データは単一のPythonの辞書のセットに保存され、値はリストに保存されます。例を示します。
{ "columns": ["ID", "Name", "Gender", "State"], "index": [0, 1, 2, 3], "data": [ [1, "Jack", "M", "MO"], [2, "Jill", "F", "MO"], [3, "George", "M", "VA"], [4, "Abe", "M", "KY"] ] }上記の形式に加えて、改行区切りのJSON(NDJSON)も使用できます。これは、配列で囲まず、1行に1つの独立したJSONオブジェクトを記述する形式です。例を示します。
{ "ID": 1, "Name": "Jack", "Gender": "M", "State": "MO" }{ "ID": 2, "Name": "Jill", "Gender": "F", "State": "MO" }ドキュメント全体
Section titled “ドキュメント全体”各ファイルのJSONをそのまま保持するには、その他の JSON オプションで各ファイルを JSON ドキュメント全体を保持する 1 行としてインポートする(whole_document)を選択します。すると、各ファイルは、JSONドキュメント全体を保持する1行としてインポートされ、数値は記述されたとおりに保持されます。
共通の設定項目
Section titled “共通の設定項目”非ASCII文字を削除するオプション
このオプションを選択すると、インポート時にASCII以外のコンテンツがすべて削除されます。PlaidCloudはUnicode(UTF-8)を完全にサポートしていますが、実際のファイルにはさまざまなエンコードや不要な文字が含まれていることがあり、処理が難しくなる場合があります。
ファイルの内容がASCIIのみであると想定される場合は、このチェックボックスをオンにすると、インポート処理を円滑に実行できます。
インポート後にファイルを削除するオプション
このオプションを使用すると、インポートが正常に完了した後に、PlaidCloudのドキュメントアカウントからそのファイルを削除できます。
インポート用ファイルが基幹システムから再作成できる場合や、処理済みの元の入力ファイルを保持する必要がない場合に便利です。
削除されるのは、インポートされたファイルのみです。インポート中にスキップされたファイルや警告が発生したファイルは、フォルダーに残ります。
ソースファイルが変更されていない場合に再インポートをスキップするオプション
このオプションがオンの場合、前回の正常な実行以降にソースファイルとステップの設定が変更されていなければ、このステップのワークフロー実行では、ダウンロード、変換、テーブルの再構築を含むインポート全体がスキップされます。これにより、スケジュールされたワークフローが、変更のないソースファイルに対して再実行される際の無駄な処理を避けられます。
ステップは、各ソースファイルをパス、サイズ、最終更新日時(ソースがコンテンツハッシュを提供する場合はそれも)で比較します。ファイルが追加、削除、変更された場合や、ステップの構成が変更された場合は、インポートが通常どおり実行されます。このオプションはデフォルトでオンです。常に再インポートするにはオフにしてください。手動で行う単発のインポートは常に実行されます。
スキップするには、ターゲットテーブルに前回のインポートで読み込まれた行が残っていることも条件になります。テーブルが空になっている場合や、行数を読み取れない場合は、スキップして下流のステップにデータがない状態になることを避けるため、インポートが再度実行されます。
一部のソース(たとえばSFTP)はコンテンツハッシュを提供しないため、その場合の変更の判定材料はファイルのサイズと最終更新日時のみになります。サイズと更新日時が同じままファイルがその場で置き換えられた場合は、未変更と見なされてスキップされます。そのような方法でソースが更新される可能性があるステップでは、このオプションをオフにしてください。
インポートファイルセレクター
このトランスフォームのファイルセレクターでは、インポート対象として、PlaidCloud のドキュメントの場所に保存されているファイルを選択できます。
ディレクトリを選択してインポートすることもできます。その場合、ディレクトリ内のすべてのファイルが、トランスフォームの実行の一部としてインポートされます。
ドキュメントアカウントの選択
アクセス権のある PlaidCloud のドキュメントアカウントを選択します。これにより、次の選択でディレクトリまたはファイルを選択できるようになります。
プロジェクト内では、リストの先頭に Project Default も表示されます。これは、プロジェクトに現在デフォルトとして設定されているアカウントの代わりとなる項目です。プロジェクトにデフォルトのアカウントがある場合、新しいステップでは Project Default が事前に選択されます。既存のステップは、変更するまで、すでに保存されているアカウントのままです。Project Default のままのステップは、実行時にプロジェクトのデフォルトであるアカウントに対して実行されます。デフォルトが設定されていない場合は、別のアカウントにフォールバックせず、実行が失敗し、プロジェクト名が示されます。
検索オプション
検索オプションを使用すると、指定したディレクトリパス以下で一致するすべてのファイルを検索してインポートできます。多数のファイルを含める必要があるものの、それらがネストされたディレクトリに保存されている場合や、インポートしたくない他のファイルと同じディレクトリ内に混在している場合に、特に便利です。
選択した検索パスは、検索を開始するディレクトリです。検索処理では、そのディレクトリ内のすべてのファイルと、指定した検索条件に一致するサブディレクトリ内のファイルが検索されます。検索条件がサブディレクトリ内のファイルにも適用できることを確認してください。
検索には、次の条件を使用できます。
- 完全一致: 検索テキストと完全に一致するものを対象にします
- 次で始まる: 検索テキストで始まるファイルすべてを対象にします
- 含む: 検索テキストを含むファイルすべてを対象にします
- 次で終わる: 検索テキストで終わるファイルすべてを対象にします
AI エージェントまたは REST API では、検索を glob(CO Store*.yxdb のようなワイルドカードパターンで、大文字と小文字を区別せずファイル名全体と照合)または regex(ファイル名全体が一致する必要がある正規表現)に設定することもできます。正規表現は、(?i) で始まらない限り、大文字と小文字が区別されます。
ファイルまたはディレクトリの選択オプション
インポートするファイルまたはディレクトリが決まっている場合は、検索よりも、ファイルまたはディレクトリを直接選択する方法が適しています。
ファイルまたはディレクトリを選択するには、参照ボタンを使用して、上で選択したドキュメントアカウントのパスを選びます。
変数の置換
検索オプションと、特定のファイル/ディレクトリを指定するオプションのどちらでも、パス、検索テキスト、ファイル名に変数を使用できます。
current_month 変数を使用して、正しいファイルを動的に指すようにした例:
legal_entity/inputs/{current_month}/ledger_values.csvターゲットテーブル
ビューには基になるデータが含まれないため、インポートのターゲットとして選択できるのはテーブルのみです。
Dynamic オプション
Dynamic オプションでは、変数を含むテキストでテーブルを指定できます。テーブルやビューの参照が指定した変数に応じて決まる、変数駆動型のワークフローで便利です。
current_month 変数を使用して、ターゲットテーブルを動的に指定する例:
legal_entity/inputs/{current_month}/ledger_valuesStatic オプション
インポートのターゲットとして特定のテーブルを使用する場合は、Dynamic ボックスをオフのままにして、ターゲットテーブルを選択します。
ターゲットテーブルが存在しない場合は、新規作成ボタンを選択して、目的の場所にテーブルを作成します。
テーブルエクスプローラーは、どのテーブル選択でも常に利用できます。テーブル選択の右側にあるテーブルエクスプローラーボタンをクリックすると、テーブルエクスプローラーのウィンドウが開きます。
データマッパーの設定
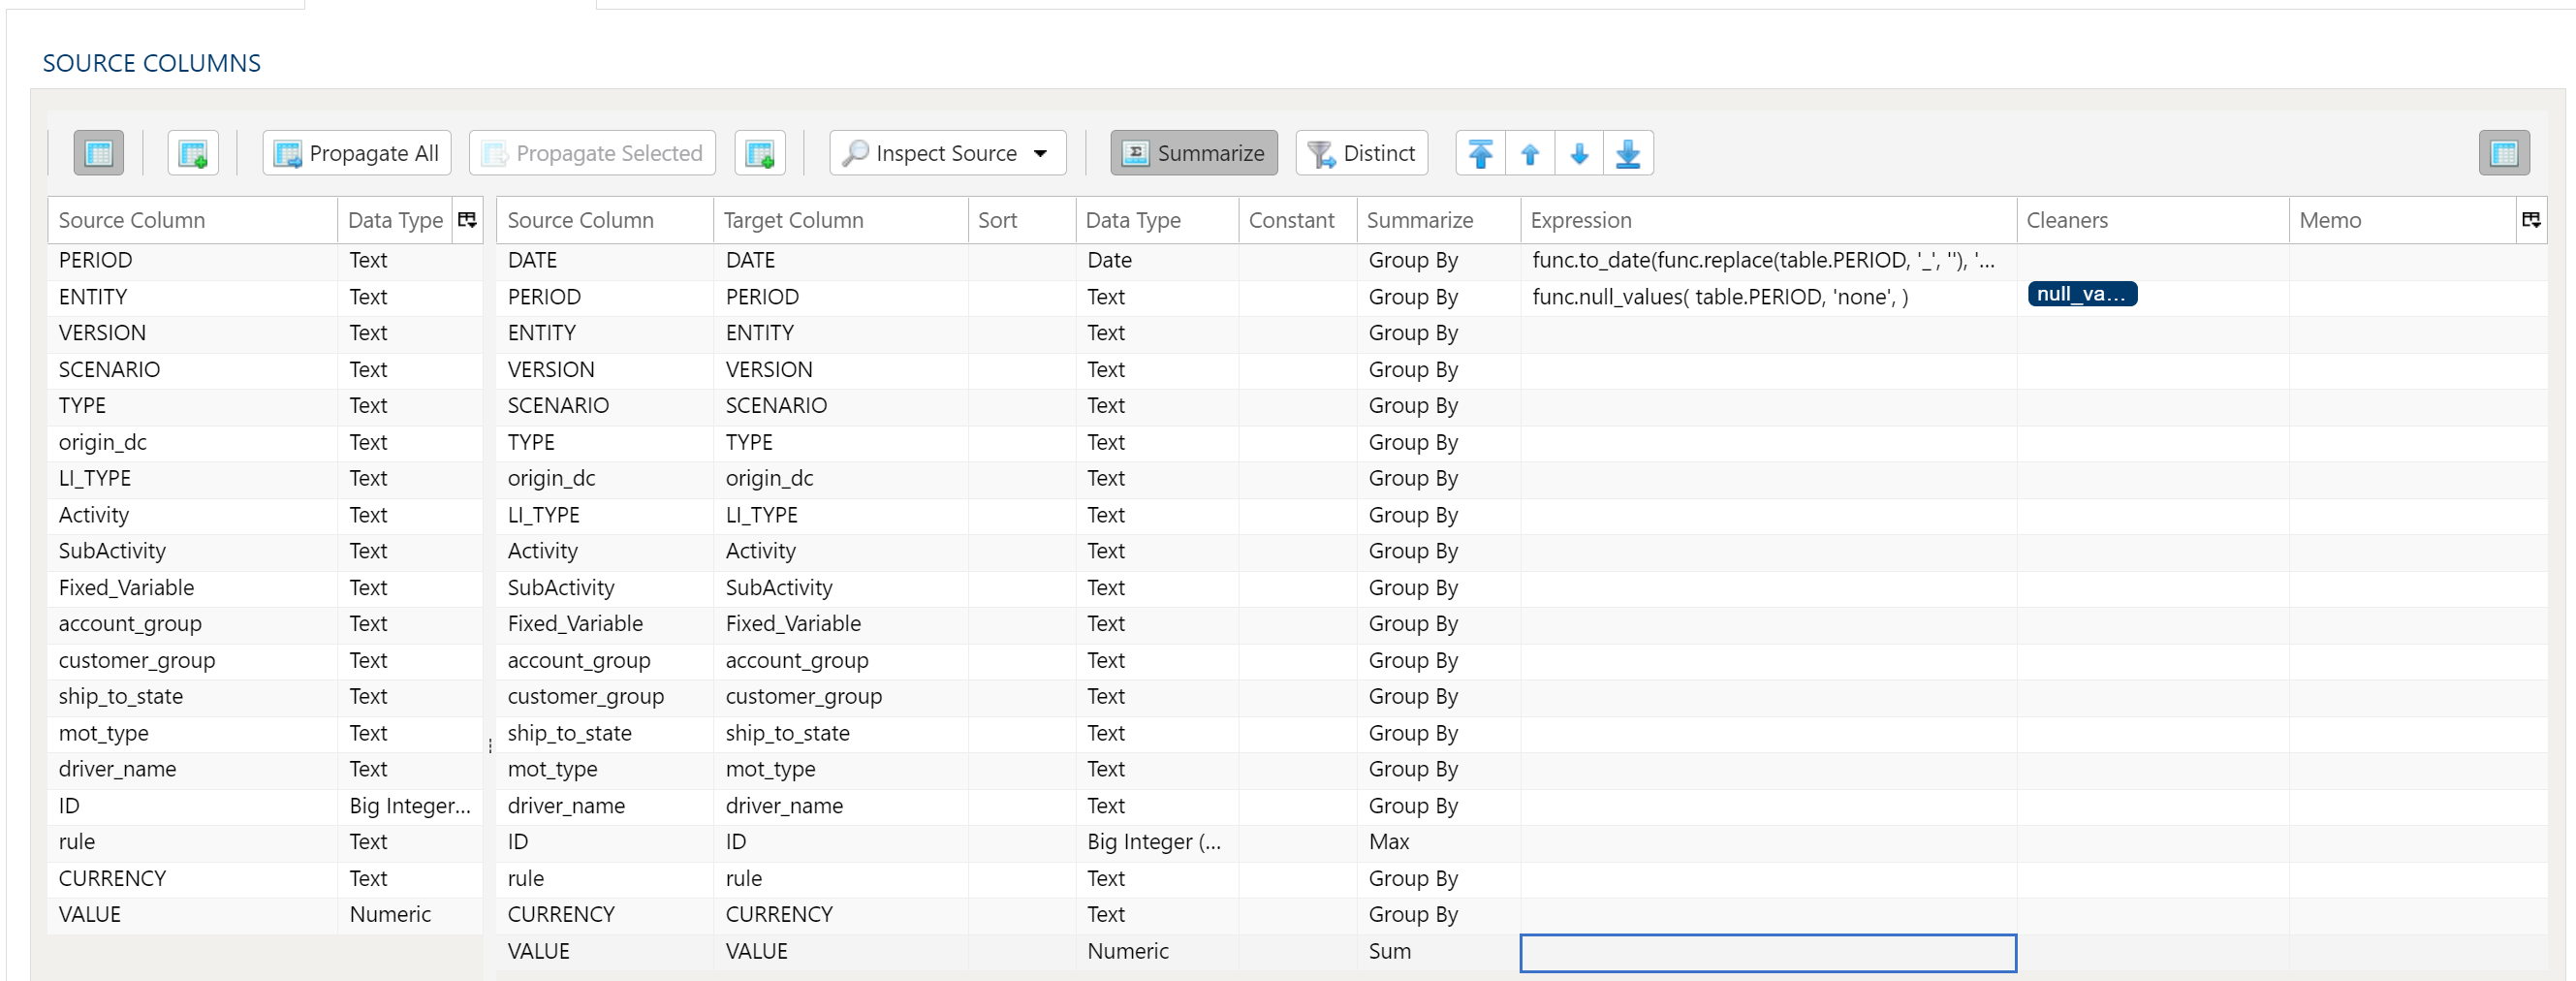
データマッパーは、ソースデータの列をターゲットのデータテーブルにマッピングするために使用します。
マッパーの検査と入力
ソースを検査メニューボタンを使うと、ソースからターゲットへ列をマッピングする方法が増えます。
- 両方のマッピングテーブルを入力: ソースデータテーブルのすべての値をターゲットのデータテーブルに反映します。これがデフォルトです。
- ソースマッピングテーブルのみを入力: ソースデータテーブルのすべての値のみをマッピングします。ソース列の構成が変わった既存のワークフローを修正する際に便利です。
- ターゲットマッピングテーブルのみを入力: すべての値をターゲットのデータテーブルのみに反映します。
ソース列とターゲット列のオプションだけでは足りない場合は、次のようにいくつかの方法でターゲットのデータテーブルに列を追加できます。
- すべてを反映は、すでに存在しているかどうかにかかわらず、すべてのソース列をターゲットのデータテーブルに挿入します。
- 選択を反映は、選択したソース列のみを挿入します。
- ターゲット側を右クリックして行を挿入を選択すると、現在選択している行の直上に行を挿入します。
- ターゲット側を右クリックして行を追加を選択すると、ターゲットのデータテーブルの末尾(右端)に行を挿入します。
列の削除
ターゲットのデータテーブルから列を削除するには、対象の列を選択し、右クリックして削除を選択します。
一覧になくなったソース列
ターゲットの行がソース列として指定している列が、ソースデータテーブルの一覧にない場合があります。たとえば、ソースを再度検査した後などです。ステップがそのような行を自動的に削除することはありません。代わりに、列名が警告マーク ⚠ の後ろに赤色で表示され、その上にカーソルを置くと、その列がソース列にないことが示されます。ユニオンなど複数のテーブルを扱うステップでは、各テーブルがそれぞれのソース列に対してチェックされます。
定数、式、または件数 (NULLを含む) の集計を設定した行は、ステップがそのソース列を読み取らないため、フラグが付くことはありません。ソースデータテーブルに列が一覧表示されていない間(たとえば、ソースを初めて検査する前)は、何もフラグが付きません。
フラグが付いた行が残ったままステップを保存すると、古い列が見つかりましたダイアログに、該当する行が所属するタブまたはテーブルごとに表示され、次の3つの選択肢が提示されます。
- すべて削除して保存 — フラグが付いた行を削除してから保存します。
- このまま保存 — ステップをそのまま保存します。
- キャンセル — 保存せずにステップに戻ります。
行を残したまま警告を解除するには、その列をソースデータテーブルに追加し直すか、ソースデータテーブルに一覧表示されている列を選択します。
列のデータ型
ターゲットの各列にはタイプがあります。ソースから反映した列はソース列のタイプを引き継ぎます。手動で追加した行はテキストから始まるため、実際に必要なタイプをタイプで設定します。合計や並べ替えを行う列には数値型や日付型が必要です。テキストはテキストとして並べ替えられ、合計されるためです。
タイプがまったく設定されていない列を含んだままステップを保存しても、ステップは実行されます。タイプは、ステップの開始時に、その列が読み取るソース列から判定されます。読み取り元がない場合はテキストとして扱われます。たとえば、SQL抽出ステップの列は、マッピングされたソースではなく、記述したクエリから決まります。また、同じ列名でタイプが一致しないソースが複数ある場合は、いずれかを推測せずテキストが使われます。推測が外れるとウェアハウスが拒否する変換が生じる可能性がありますが、どんな値もテキストには変換できるためです。
列がどうあるべきかを指定する方法は、引き続きタイプを自分で設定することです。未設定のままにすると、ソース列がたまたまそうであるタイプをそのまま受け入れることになります。
列の順序の変更
ターゲットのデータテーブルの列を並べ替えるには、対象の列を選択します。次のどちらかを使用できます。
- 一括移動の矢印: 右上の矢印から目的の移動オプションを選択します
- コンテキストメニュー: 右クリックして、先頭へ移動、上へ移動、下へ移動、末尾へ移動のいずれかを選択します。
結果を重複のないレコードのみに絞り込む
重複のないオプションのみを返すには、重複排除メニューオプションを選択します。ソースの各列にチェックボックスが表示されます。重複を排除したい列の横にあるチェックボックスをオンにすると、重複のない結果のみが返されます。
状況によっては、代わりに集計の使用を検討することをお勧めします。
重複排除では、最初に見つかった一意のレコードを残し、残りを破棄します。実行間で一貫性が必要な場合は、データに並べ替えを適用することをお勧めします。
集計とグループ化
結果を集計するには、集計メニューオプションを選択します。ターゲットのデータテーブルの各列に選択ボックスが表示されます。列ごとに適切な集計方法を選択します。
ソースを検査で列が入力される際、数値列は、名前が id、customer_id、Order No、CustomerKey のように識別子と読み取れる場合、テーブルでキーに設定されている場合、または結合でキーとして使用されている場合に、合計ではなくグループ化から始まります。
- グループ化
- 合計
- 最小
- 最大
- 最初
- 最後
- 件数
- 件数 (NULLを含む)
- 平均
- 標準偏差
- 標本標準偏差
- 母標準偏差
- 分散
- 標本分散
- 母分散
- 高度な非グループ化
式、クレンジング、定数などのデータマッパーの高度な使い方については、データマッパーの高度な使い方を参照してください。

柔軟性を最大限に高めるため、データフィルターはソースデータとターゲットデータの両方で使用できます。データセットが大きい場合は、ソース側で行を絞り込んでおくと、残りの処理を小さなデータセットに対して実行できるため、特に効果的です。
データのサブセットを選択
このフィルタータイプでは、指定した条件に基づいて、受信するソースデータをフィルター処理できます。
結果データにセカンダリフィルターを適用
このフィルタータイプでは、変換後の結果データに対して、指定した条件に基づくフィルターを適用できます。 変換後の結果にフィルターを適用できるため、複雑な計算、集計、ウィンドウ関数の結果に基づいて行を除外できます。
最終データテーブルのスライス(制限)
行のスライス機能では、範囲と開始位置に基づいて、結果セットの行数を制限できます。
フィルター構文
フィルター構文には Python SQLAlchemy を使用します。これは他の式と同じ構文です。
式の例と式関数については、式のセクションを参照してください。