

Allocation Split
ソースの行の値をいくつかに分割し、ドライバーデータで決まる比率で、それぞれを異なるターゲットに振り分けます。Allocation Rulesよりシンプルで、割り当てディメンションなしで値を分配するだけでよい場合に使用します。
よくあるパターン: 合計金額を取り、ドライバーテーブルのパーセンテージまたは重みに基づいて複数の受け手に分配し、受け手ごとに1行の出力を生成します。
データテーブルの設定
Section titled “データテーブルの設定”配賦する値のテーブル、ドライバーデータテーブル、配賦結果テーブルは、動的または静的に選択できます。
動的なテーブルの選択
Section titled “動的なテーブルの選択”動的テーブルのオプションでは、テキストと変数を使ってテーブルを指定できます。テーブルやビューへの参照が、指定した変数に応じて変わる、変数駆動のワークフローを使う場合に便利です。
current_month変数を使って、動的にテーブルを指す例:
legal_entity/inputs/{current_month}/ledger_values静的なテーブルの選択
Section titled “静的なテーブルの選択”特定のテーブルをソースにしたい場合は、動的ボックスをオフのままにして、ドロップダウンメニューからソーステーブルを選択します。
テーブルエクスプローラーは、どのテーブル選択でも常に利用できます。テーブル選択の右にあるテーブルエクスプローラーボタンをクリックすると、テーブルエクスプローラーのウィンドウが開きます。
配賦する値のテーブル
Section titled “配賦する値のテーブル”配賦する値を含むテーブルです。通常は、コストまたは収益の値です。
ドライバーデータテーブル
Section titled “ドライバーデータテーブル”ドライバーデータテーブルには、配賦ステップがコストを配賦するために使用する値が含まれます。
例:
- サプライチェーンで顧客にコストを割り当てる場合は、配送データを使い、配送の件数または配送の重量をドライバーにできます。
- ITヘルプデスクが、支援する部門にコストを割り当てる場合は、ドライバーデータはコストセンターごとのチケット数になります。
ドライバーデータの符号ルール
Section titled “ドライバーデータの符号ルール”ドライバーデータには、正の値と負の値の両方を含めることができます。ドライバーデータの符号ルールでは、符号が競合する場合の処理方法を決めます。
- 符号が競合する場合はエラー - 符号が競合すると、配賦ステップはエラーを出して停止します。
- 符号が競合する場合は警告して続行 - 配賦ステップは負のドライバー値と正のドライバー値の両方を使用し、警告を表示します。
- 正のドライバー値のみを使用 - 配賦ステップは正のドライバー値のみを使用し、負の値は無視します。
- 負のドライバー値のみを使用 - 配賦ステップは負のドライバー値のみを使用し、正の値は無視します。
- ドライバーデータの絶対値を使用 - 配賦ステップは、ドライバーデータの絶対値を使用します。
配賦結果テーブル
Section titled “配賦結果テーブル”結果をターゲットテーブルに追加
Section titled “結果をターゲットテーブルに追加”このボックスをオンにすると、配賦結果が配賦結果テーブルに追加されます。 このボックスをオフにすると、配賦ステップが実行されるたびに、配賦結果テーブルが上書きされます。
配賦結果を別の列に出力
Section titled “配賦結果を別の列に出力”このボックスをオンにすると、結果テーブルには、各配賦レコードの金額と、各ドライバーレコードに実際に配賦された金額の両方が表示されます。
配賦ソースマップ
Section titled “配賦ソースマップ”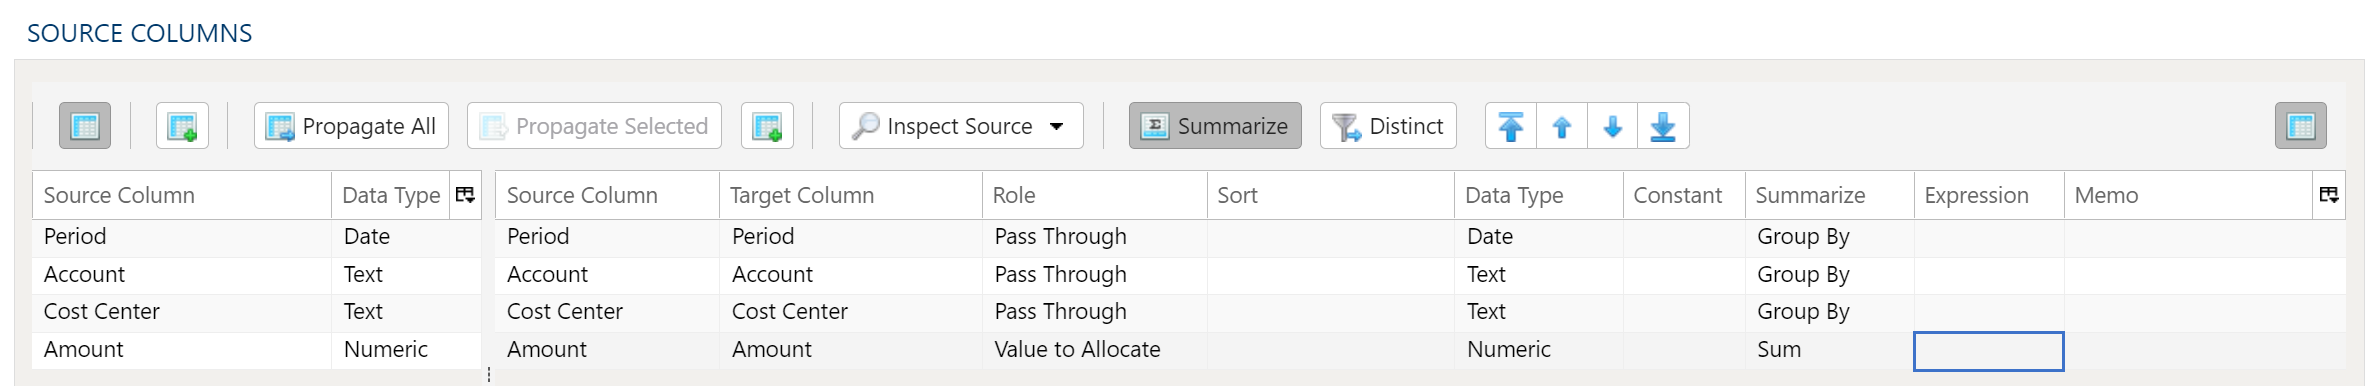
配賦ソースマップは、配賦ステップで使用する配賦する値のテーブルの列をマッピングするために使用します。
ソースの検査とマッパーへの入力
ソースを検査メニューボタンを使用すると、ソースからターゲットへ列をマッピングするための方法が追加で利用できます。
- 両方のマッピングテーブルを入力: ソースデータテーブルのすべての値をターゲットデータテーブルに反映します。これがデフォルトの動作です。
- ソースマッピングテーブルのみを入力: ソースデータテーブルの値のみをマッピングします。ソース列の構造が変わった既存のワークフローを変更する場合に便利です。
- ターゲットマッピングテーブルのみを入力: すべての値をターゲットデータテーブルにのみ反映します。
ソース列とターゲット列のオプションだけでは足りない場合は、次のようないくつかの方法でターゲットデータテーブルに列を追加できます。
- すべてを反映を選択すると、すでに存在するかどうかにかかわらず、すべてのソース列がターゲットデータテーブルに挿入されます。
- 選択を反映を選択すると、選択したソース列のみが挿入されます。
- ターゲット側を右クリックして行を挿入を選択すると、現在選択している行の直前に行が挿入されます。
- ターゲット側を右クリックして行を追加を選択すると、ターゲットデータテーブルの末尾(右端)に行が挿入されます。
ロール
データマッパーの各列にはロールを割り当てる必要があります。
- Pass Thought - これらの列は配賦結果テーブルに表示されます。
- 配賦する値 - 配賦する値が含まれる列です。
列の削除
ターゲットデータテーブルから列を削除するには、削除する列を選択し、右クリックして削除を選択します。
列の順序の変更
ターゲットデータテーブルの列を並べ替えるには、対象の列を選択します。次のいずれかを使用できます。
- 一括移動の矢印: 右上の矢印から移動方法を選択します
- コンテキストメニュー: 右クリックして先頭へ移動、上へ移動、下へ移動、末尾へ移動のいずれかを選択します。
結果を重複のないレコードのみに絞り込む
重複のない結果のみを返すには、重複排除メニューオプションを選択します。ソースの各列にチェックボックスが表示されます。重複排除の対象とする列の横にあるボックスをオンにすると、重複のない結果のみが返されます。
状況によっては、代わりに集計の使用を検討することもできます。
重複排除では、最初に見つかった一意のレコードが保持され、残りは破棄されます。実行間で結果の一貫性が必要な場合は、データに並べ替えを適用することをおすすめします。
集計とグループ化
結果を集計するには、集計メニューオプションを選択します。ターゲットデータテーブルの各列に選択ボックスが表示されます。列ごとに適切な集計方法を選択します。
- グループ化
- 合計
- 最小
- 最大
- 最初
- 最後
- 件数
- 件数 (NULLを含む)
- 平均
- 標準偏差
- 標本標準偏差
- 母標準偏差
- 分散
- 標本分散
- 母分散
- 高度な非グループ化
式、クレンジング、定数などのデータマッパーの高度な使い方については、データマッパーの高度な使い方を参照してください。
配賦ソースフィルター
Section titled “配賦ソースフィルター”
柔軟性を最大限に高めるため、データフィルターはソースデータとターゲットデータの両方で使用できます。データセットが大きい場合は、ソース側で行を絞り込んでおくと、残りの処理を小さなデータセットに対して実行できるため、特に効果的です。
データのサブセットを選択
このフィルタータイプでは、指定した条件に基づいて、受信するソースデータをフィルター処理できます。
結果データにセカンダリフィルターを適用
このフィルタータイプでは、変換後の結果データに対して、指定した条件に基づくフィルターを適用できます。 変換後の結果にフィルターを適用できるため、複雑な計算、集計、ウィンドウ関数の結果に基づいて行を除外できます。
最終データテーブルのスライス(制限)
行のスライス機能では、範囲と開始位置に基づいて、結果セットの行数を制限できます。
フィルター構文
フィルター構文には Python SQLAlchemy を使用します。これは他の式と同じ構文です。
式の例と式関数については、式のセクションを参照してください。
ドライバーデータマップ
Section titled “ドライバーデータマップ”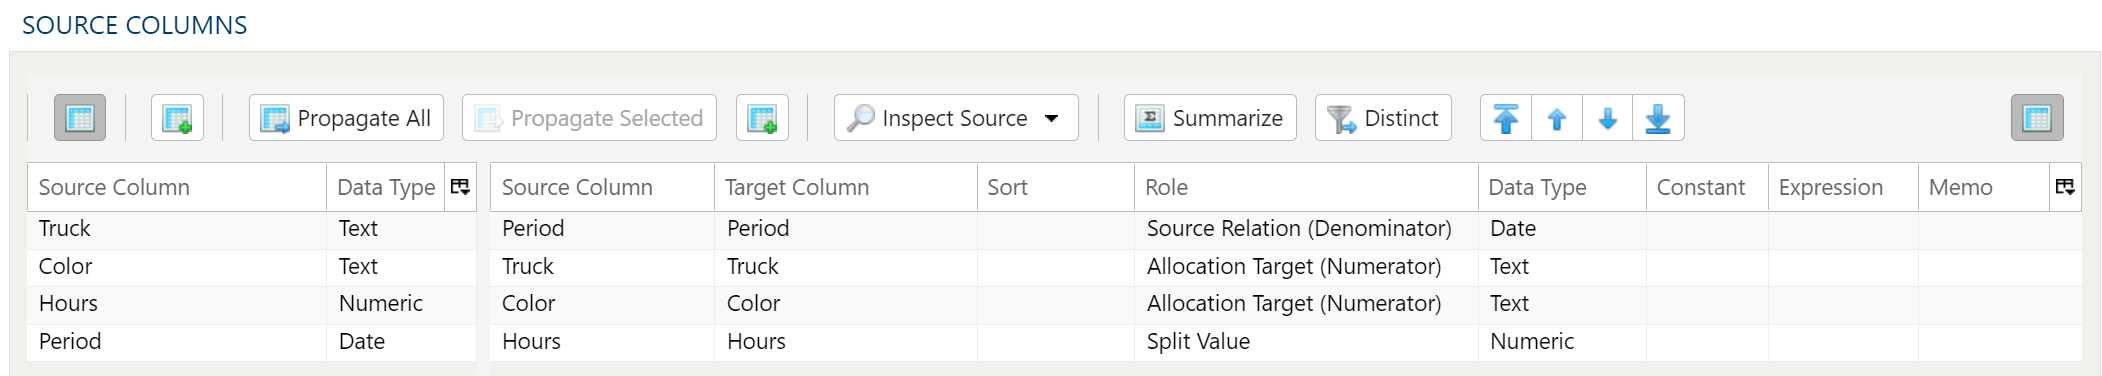
配賦ドライバーデータマップは、配賦ステップで使用するドライバーデータテーブルの列をマッピングするために使用します。
ソースの検査とマッパーへの入力
ソースを検査メニューボタンを使用すると、ソースからターゲットへ列をマッピングするための方法が追加で利用できます。
- 両方のマッピングテーブルを入力: ソースデータテーブルのすべての値をターゲットデータテーブルに反映します。これがデフォルトの動作です。
- ソースマッピングテーブルのみを入力: ソースデータテーブルの値のみをマッピングします。ソース列の構造が変わった既存のワークフローを変更する場合に便利です。
- ターゲットマッピングテーブルのみを入力: すべての値をターゲットデータテーブルにのみ反映します。
ソース列とターゲット列のオプションだけでは足りない場合は、次のようないくつかの方法でターゲットデータテーブルに列を追加できます。
- すべてを反映を選択すると、すでに存在するかどうかにかかわらず、すべてのソース列がターゲットデータテーブルに挿入されます。
- 選択を反映を選択すると、選択したソース列のみが挿入されます。
- ターゲット側を右クリックして行を挿入を選択すると、現在選択している行の直前に行が挿入されます。
- ターゲット側を右クリックして行を追加を選択すると、ターゲットデータテーブルの末尾(右端)に行が挿入されます。
ロール
データマッパーの各列にはロールを割り当てる必要があります。
- Source Relation - これらの列は、配賦する値のテーブル内の対応する列を持ちます。
- Allocation Target - これらの列は配賦ステップのターゲットとなり、配賦結果テーブルに表示されます。
- Split Value - この列には、配賦する値のテーブルの値を配賦するために使用する値が含まれます。
列の削除
ターゲットデータテーブルから列を削除するには、削除する列を選択し、右クリックして削除を選択します。
列の順序の変更
ターゲットデータテーブルの列を並べ替えるには、対象の列を選択します。次のいずれかを使用できます。
- 一括移動の矢印: 右上の矢印から移動方法を選択します
- コンテキストメニュー: 右クリックして先頭へ移動、上へ移動、下へ移動、末尾へ移動のいずれかを選択します。
結果を重複のないレコードのみに絞り込む
重複のない結果のみを返すには、重複排除メニューオプションを選択します。ソースの各列にチェックボックスが表示されます。重複排除の対象とする列の横にあるボックスをオンにすると、重複のない結果のみが返されます。
状況によっては、代わりに集計の使用を検討することもできます。
重複排除では、最初に見つかった一意のレコードが保持され、残りは破棄されます。実行間で結果の一貫性が必要な場合は、データに並べ替えを適用することをおすすめします。
集計とグループ化
結果を集計するには、集計メニューオプションを選択します。ターゲットデータテーブルの各列に選択ボックスが表示されます。列ごとに適切な集計方法を選択します。
- グループ化
- 合計
- 最小
- 最大
- 最初
- 最後
- 件数
- 件数 (NULLを含む)
- 平均
- 標準偏差
- 標本標準偏差
- 母標準偏差
- 分散
- 標本分散
- 母分散
- 高度な非グループ化
式、クレンジング、定数などのデータマッパーの高度な使い方については、データマッパーの高度な使い方を参照してください。
ドライバーデータフィルター
Section titled “ドライバーデータフィルター”
柔軟性を最大限に高めるため、データフィルターはソースデータとターゲットデータの両方で使用できます。データセットが大きい場合は、ソース側で行を絞り込んでおくと、残りの処理を小さなデータセットに対して実行できるため、特に効果的です。
データのサブセットを選択
このフィルタータイプでは、指定した条件に基づいて、受信するソースデータをフィルター処理できます。
結果データにセカンダリフィルターを適用
このフィルタータイプでは、変換後の結果データに対して、指定した条件に基づくフィルターを適用できます。 変換後の結果にフィルターを適用できるため、複雑な計算、集計、ウィンドウ関数の結果に基づいて行を除外できます。
最終データテーブルのスライス(制限)
行のスライス機能では、範囲と開始位置に基づいて、結果セットの行数を制限できます。
フィルター構文
フィルター構文には Python SQLAlchemy を使用します。これは他の式と同じ構文です。
式の例と式関数については、式のセクションを参照してください。