

Paso Table Outer Join
Descripción
Sección titulada «Descripción»Se usa para realizar una combinación externa de 2 tablas de datos y unirlas en una sola tabla de datos según las claves de combinación especificadas. El control Tipo de combinación selecciona qué filas sin coincidencia se conservan: una combinación Combinación izquierda, Combinación derecha o Combinación externa completa. El valor predeterminado es una combinación izquierda (todas las filas de la tabla A, con las columnas de la tabla B completadas donde coinciden las claves).
Para obtener más detalles sobre la metodología de la combinación externa, consulte: Wikipedia SQL Join
Selección de datos de la tabla
Sección titulada «Selección de datos de la tabla»Tabla de origen
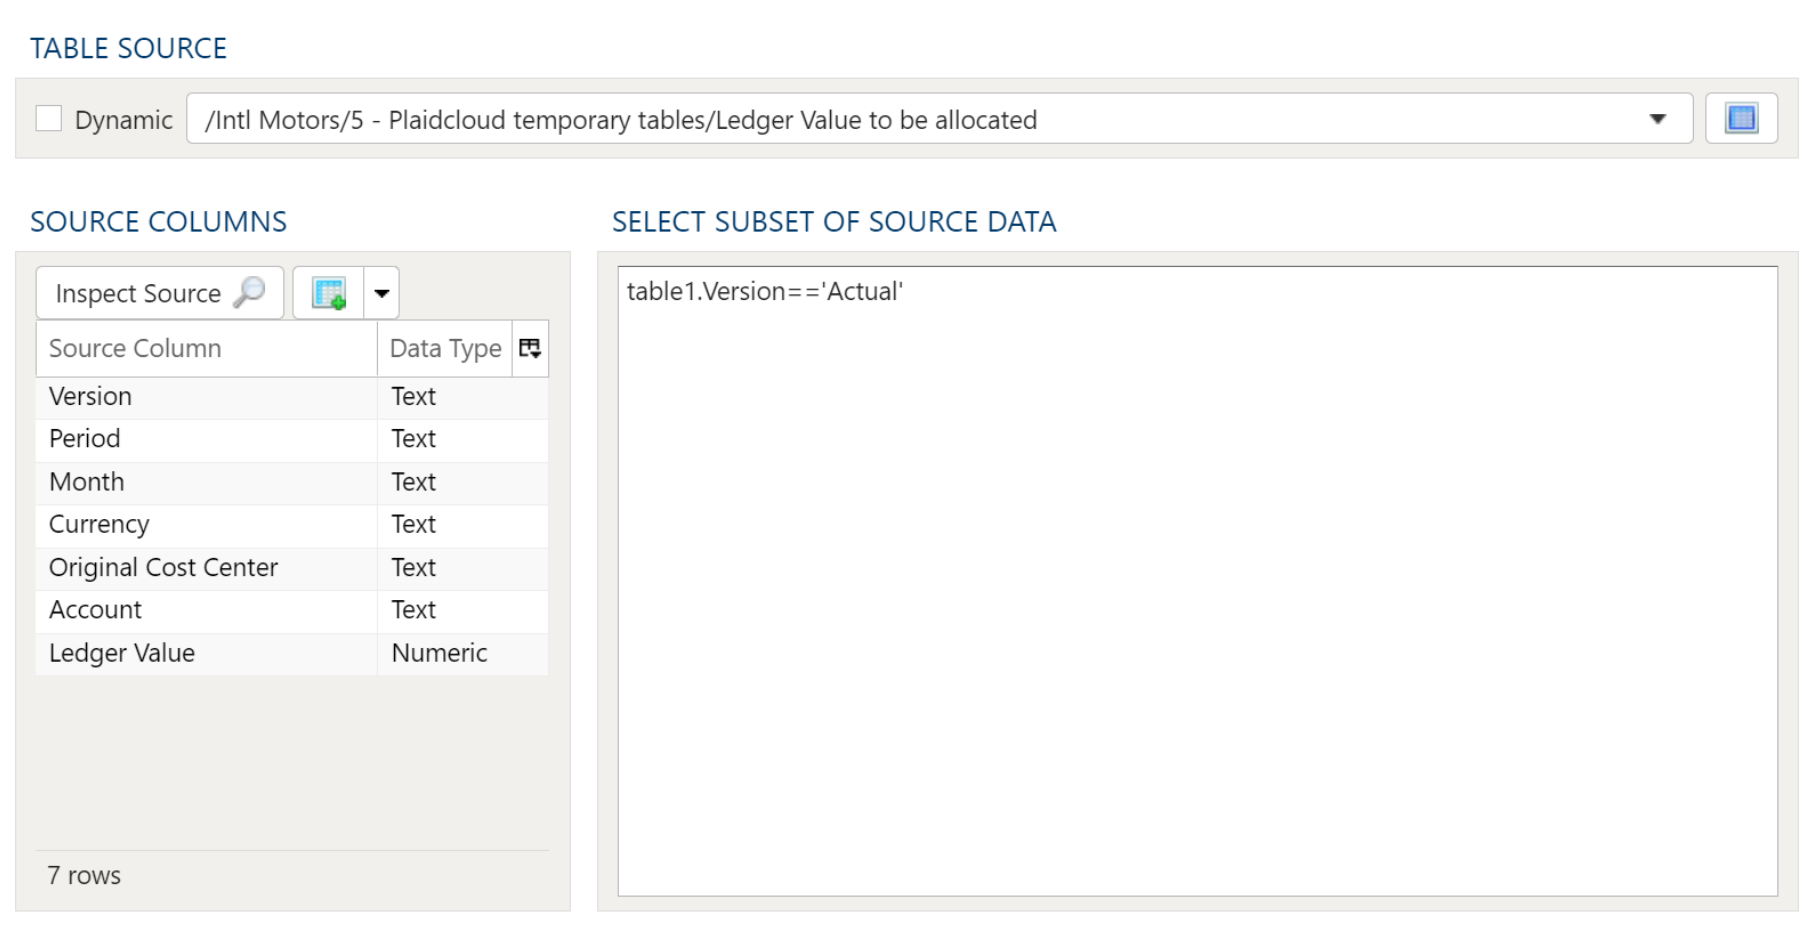
Especifique la tabla de datos de origen seleccionándola en el menú desplegable.
Columnas de origen
Especifique aquí las columnas que desea incluir. Al seleccionar los botones Inspeccionar origen y Populate Source Mapping Table, estas columnas quedarán disponibles para la operación de combinación.
Seleccionar un subconjunto de los datos de origen
Se acepta cualquier expresión de Python válida para obtener un subconjunto de los datos. Consulte Expresiones para obtener más detalles y ejemplos.
Columnas nombradas en tiempo de ejecución
Sección titulada «Columnas nombradas en tiempo de ejecución»Seleccione Incluir también columnas nombradas en tiempo de ejecución para pasar sin cambios todas las columnas de origen que el paso no enumera, tal como las tiene la tabla cuando se ejecuta el paso. Úselo cuando un paso anterior cree columnas cuyos nombres dependan de los datos, como un pivote, de modo que no pueda enumerarlas al crear el paso. Déjelo desactivado para escribir solo las columnas que enumere.
Salida de la tabla
Sección titulada «Salida de la tabla»Tabla de destino

Para establecer la tabla de destino, seleccione una tabla existente con el menú desplegable Tabla de destino o haga clic en el signo “+” verde para crear una nueva tabla de destino.
Creación de tablas
Al crear una nueva tabla, podrá crearla como Vista o como Tabla.
Vistas:
Las vistas son útiles porque el tiempo que tarda en ejecutarse un paso es considerablemente menor que cuando se usa una tabla. La desventaja de las vistas es que no son útiles para explorar datos en el modo Detalles de la tabla.
Tablas:
Cuando se usa una tabla como destino, un paso tarda más en ejecutarse, pero la exploración de datos en el modo Detalles es mucho más rápida que con una vista.
Mapa de combinación
Sección titulada «Mapa de combinación»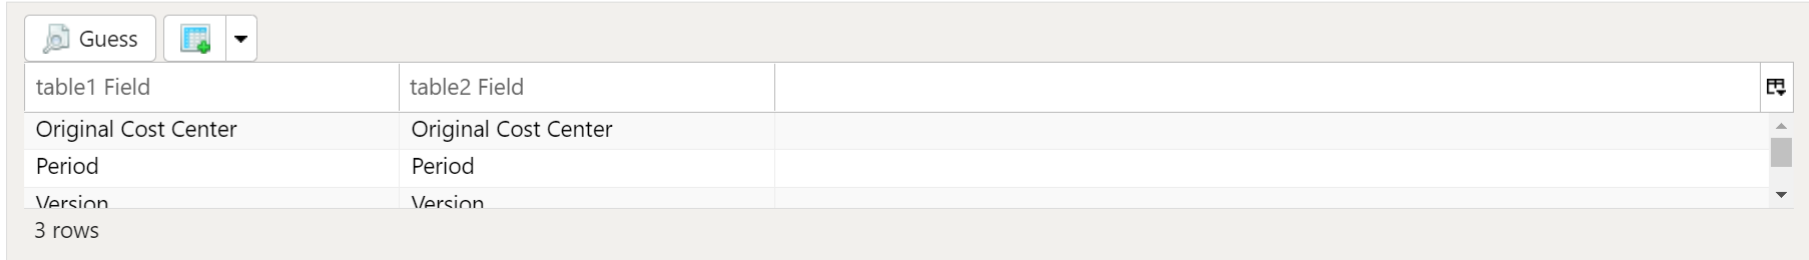
Especifique las condiciones de combinación. Detectar rellena el Join Map con la primera de estas opciones que puedan aplicar las columnas de las dos tablas:
- las claves de otro paso de combinación de este proyecto que combina las mismas dos tablas
- las claves de una métrica aprobada que las combina
- las columnas de clave definidas en una de las tablas, emparejadas por nombre en la otra
- las columnas con el mismo nombre en la Tabla 1 y la Tabla 2
- las columnas cuyos nombres solo difieren en mayúsculas o guiones bajos, o una columna
idemparejada con una columna que lleva el nombre de su tabla, comocustomer_idpara una tabla llamada Customers
Una línea bajo el mapa indica cuál se usó, hasta que usted cambie el mapa. Detectar lee las columnas de las tablas, no sus filas, así que revise las claves antes de guardar. Inspeccionar origen rellena un Join Map vacío de la misma manera.
Para agregar columnas adicionales manualmente, haga clic con el botón derecho en cualquier punto de la sección y seleccione Insertar fila o Anexar fila, para agregar una fila antes de la fila seleccionada o al final, respectivamente. Después, escriba los nombres de las columnas que se deben emparejar de la Tabla 1 con la Tabla 2. Para quitar un campo del Join Map, haga clic con el botón derecho y seleccione Eliminar.
Tipo de combinación
Sección titulada «Tipo de combinación»Elija cómo se conservan las filas sin coincidencia:
- Combinación izquierda: conserva todas las filas de la tabla A; las columnas de la tabla B se completan solo donde coinciden las claves de combinación. Es el valor predeterminado.
- Combinación derecha: conserva todas las filas de la tabla B; las columnas de la tabla A se completan solo donde coinciden las claves de combinación.
- Combinación externa completa: conserva todas las filas de ambas tablas, tengan o no coincidencia en el otro lado.
Comprobar claves
Sección titulada «Comprobar claves»Comprobar claves, junto a Detectar, cuenta los valores de clave del Join Map que aparecen en más de una fila de una tabla. Cuando un valor de clave se repite en la tabla con la que se combina, cada fila que coincide con él aparece en el resultado una vez por cada fila coincidente, por lo que el resultado puede tener más filas que la tabla de partida.
La tabla que se comprueba depende del paso:
- Combinación interna y Table Lookup: Tabla 2.
- Combinación externa: Tabla 2 en una combinación izquierda, Tabla 1 en una combinación derecha y ambas tablas en una combinación completa.
La respuesta aparece debajo del Join Map. Indica el número de valores de clave repetidos y las filas que los comparten, y enumera hasta cinco de los más repetidos. Cuenta:
- la tabla tal como está ahora, después del filtro de este paso sobre esa tabla;
- solo las filas que usted puede ver, cuando la seguridad a nivel de fila limita lo que ve de la tabla. La respuesta lo indica;
- ninguna fila con una clave en blanco, porque una clave en blanco nunca coincide con otra fila. La excepción es una combinación interna o externa configurada para hacer coincidir claves en blanco entre sí, como puede ocurrir en una combinación convertida desde Alteryx: en ese caso, las claves en blanco cuentan como un valor de clave y pueden aparecer como (en blanco).
Table Lookup nunca repite una fila. Para una clave repetida conserva una fila de la Tabla 2, tomando el valor más bajo de cada columna (el número más pequeño, la fecha más temprana, el primer texto en orden de clasificación), por lo que esa fila puede combinar valores de distintas filas de la Tabla 2. Comprobar claves le avisa cuando esto ocurre; para elegir qué valores se usan, haga que cada clave aparezca una sola vez en la Tabla 2.
La comprobación lee la tabla de su almacén de datos, por lo que se ejecuta solo cuando usted la elige y se detiene a los 30 segundos. Cambiar cualquiera de las dos tablas, su filtro, el Join Map o, en la combinación externa, el Tipo de combinación, borra la respuesta.
Columnas de salida de destino
Sección titulada «Columnas de salida de destino»Configuración del asignador de datos
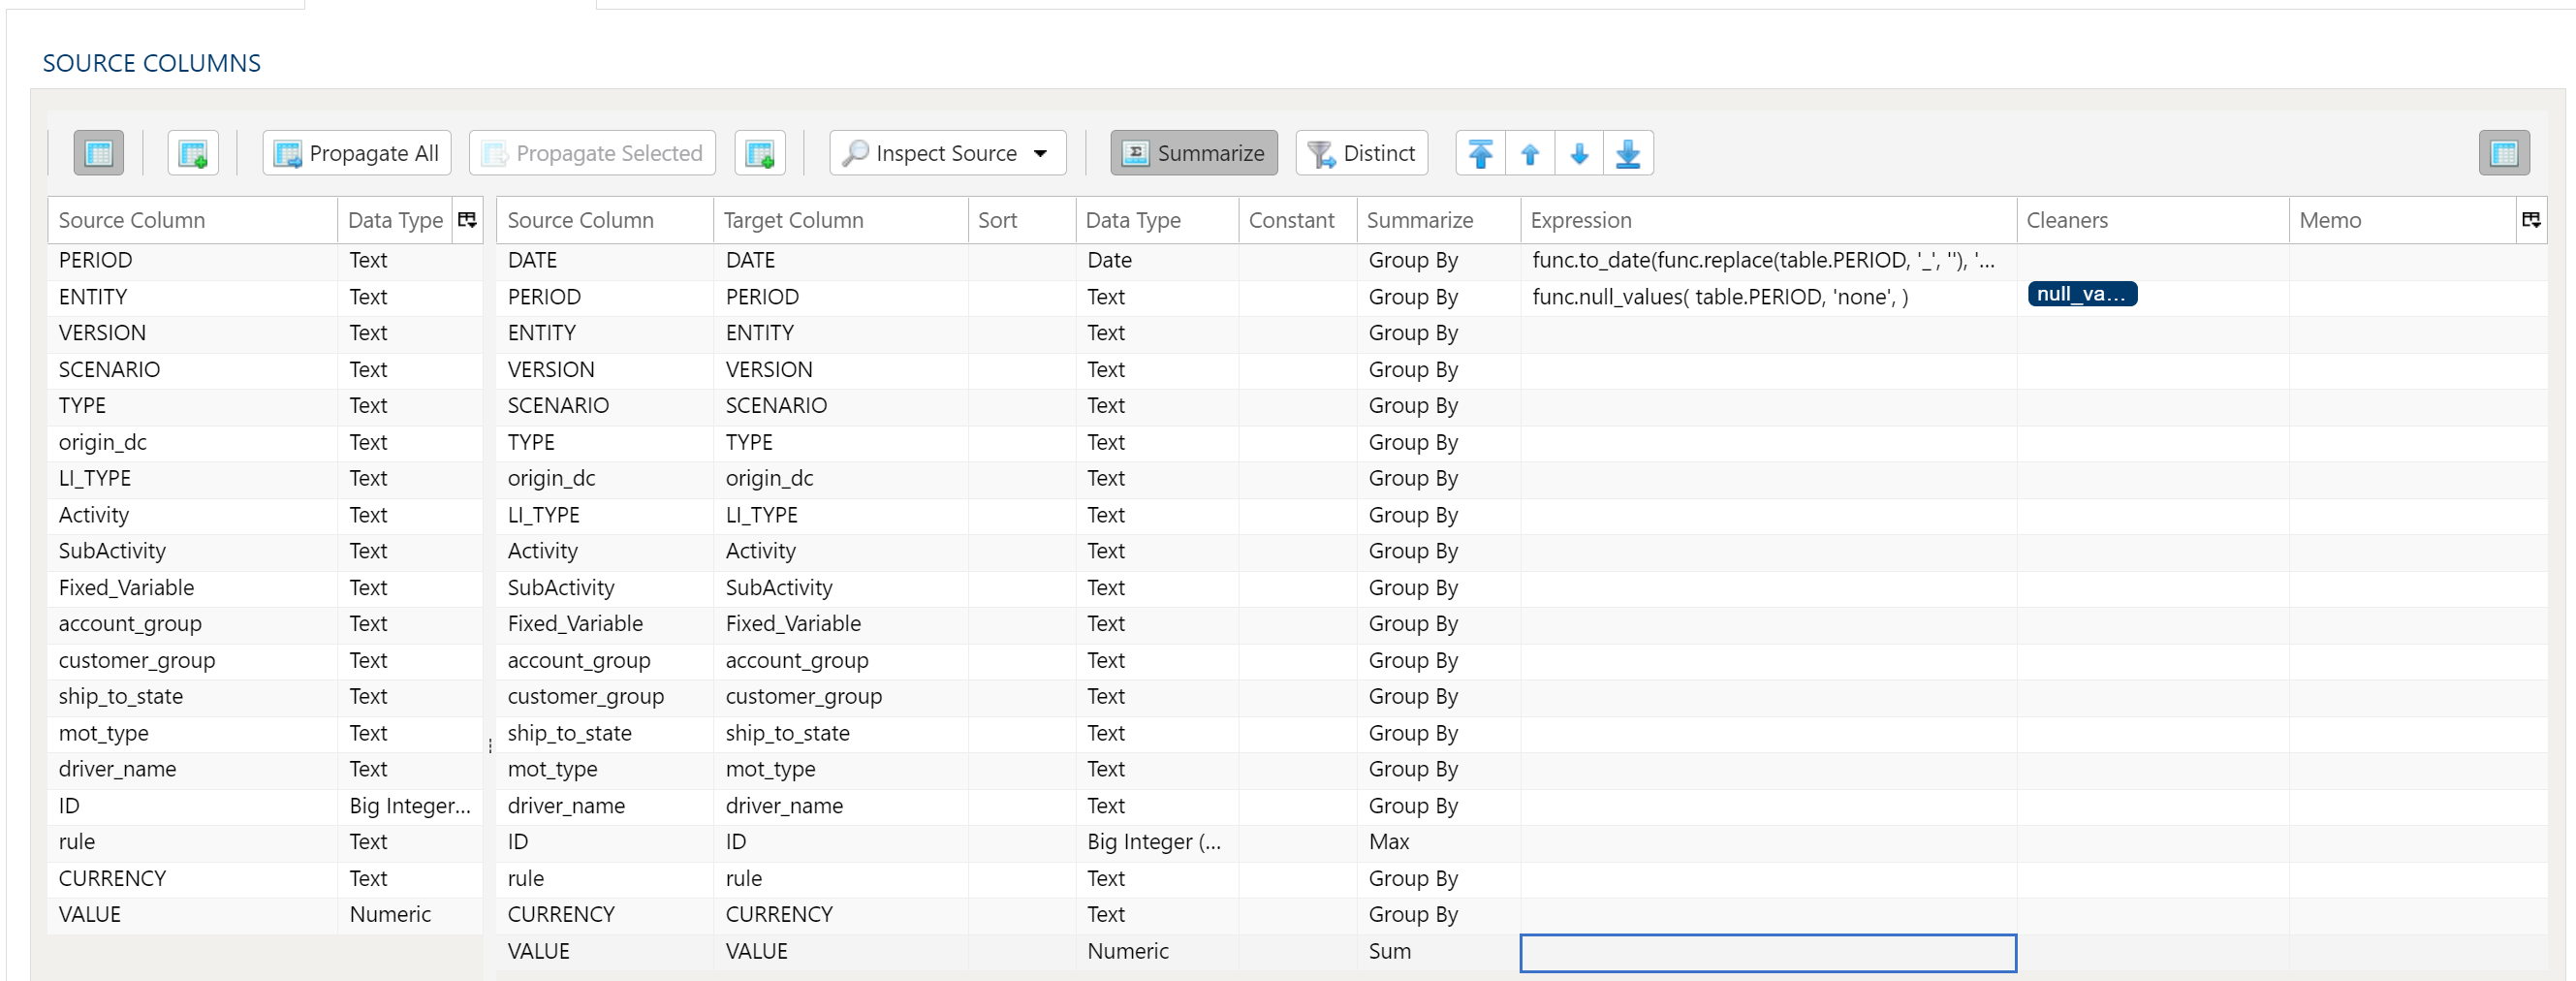
El asignador de datos se usa para asignar columnas de los datos de origen a la tabla de datos de destino.
Inspección y llenado del asignador
Usar el botón de menú Inspeccionar origen ofrece formas adicionales de asignar columnas del origen al destino:
- Rellenar ambas tablas de asignación: propaga todos los valores de la tabla de datos de origen a la tabla de datos de destino. Es la opción predeterminada.
- Rellenar solo la tabla de asignación de origen: asigna únicamente todos los valores de la tabla de datos de origen. Es útil al modificar un flujo de trabajo existente cuando la estructura de columnas de origen ha cambiado.
- Rellenar solo la tabla de asignación de destino: propaga todos los valores únicamente a la tabla de datos de destino.
Si las opciones de columnas de origen y de destino no bastan, se pueden agregar otras columnas a la tabla de datos de destino de varias maneras:
- Propagar todo insertará todas las columnas de origen en la tabla de datos de destino, existan ya o no.
- Propagar seleccionadas insertará solo las columnas de origen seleccionadas.
- Haga clic con el botón derecho en el lado de destino y seleccione Insertar fila para insertar una fila justo encima de la fila seleccionada.
- Haga clic con el botón derecho en el lado de destino y seleccione Anexar fila para insertar una fila al final (extremo derecho) de la tabla de datos de destino.
Eliminar columnas
Para eliminar columnas de la tabla de datos de destino, seleccione las columnas deseadas, haga clic con el botón derecho y seleccione Eliminar.
Columnas de origen que ya no figuran en la lista
Una fila de destino puede nombrar una Columna de origen que la tabla de datos de origen ya no incluye, por ejemplo, después de volver a inspeccionar el origen. El paso nunca quita una fila así por usted. En su lugar, el nombre de la columna se muestra en rojo junto a una señal de advertencia ⚠, y al pasar el cursor por encima se indica que la columna no está en las columnas de origen. En un paso con varias tablas, como una unión, cada tabla se comprueba con sus propias columnas de origen.
Una fila con una Constante, una Expresión o un resumen de Recuento (incluidos nulos) nunca se marca, porque el paso no lee su columna de origen. No se marca nada mientras la tabla de datos de origen no incluya columnas, por ejemplo, antes de inspeccionar el origen por primera vez.
Al guardar un paso que todavía tiene filas marcadas, un cuadro de diálogo Se encontraron columnas obsoletas las enumera bajo la pestaña o la tabla en la que se encuentran, y ofrece tres opciones:
- Quitar todas y guardar: quita las filas marcadas y luego guarda.
- Guardar de todos modos: guarda el paso tal como está.
- Cancelar: vuelve al paso sin guardar.
Para conservar una fila y eliminar su advertencia, vuelva a agregar la columna a la tabla de datos de origen o elija una columna que la tabla de datos de origen incluya.
Tipo de datos de la columna
Cada columna de destino tiene un Tipo. Una columna propagada desde el origen conserva el tipo de la columna de origen; una fila que usted agrega manualmente comienza como Texto, y usted define el Tipo para indicar lo que debe ser en realidad: una columna que piensa sumar u ordenar necesita su tipo numérico o de fecha, porque el texto se ordena y se suma como texto.
Un paso guardado con una columna sin ningún tipo se ejecuta igualmente. El tipo se determina cuando el paso se inicia, a partir de la columna de origen que lee esa columna. Si no hay nada de dónde leerlo, se trata como texto: las columnas de un paso Extraer SQL proceden de la consulta que usted escribió y no de un origen asignado, y cuando varios orígenes tienen el mismo nombre de columna con tipos que no coinciden, se usa texto en lugar de adivinar uno de ellos: una suposición errónea produce una conversión que el almacén puede rechazar, y todo se puede convertir a texto.
Definir el Tipo usted mismo sigue siendo la forma de indicar lo que debe ser una columna. Dejarlo sin definir significa aceptar lo que resulte ser la columna de origen.
Cambiar el orden de las columnas
Para reorganizar las columnas de la tabla de datos de destino, seleccione las columnas deseadas. Puede usar cualquiera de estas opciones:
- Flechas de movimiento masivo: seleccione la opción de movimiento deseada con las flechas de la esquina superior derecha.
- Menú contextual: haga clic con el botón derecho y seleccione Mover al principio, Subir, Bajar o Mover al final.
Reducir el resultado solo a registros distintos
Para devolver solo opciones distintas, seleccione la opción de menú Distinto. Esto mostrará un conjunto de casillas de verificación para cada columna del origen. Basta con marcar la casilla junto a la columna correspondiente para devolver solo resultados distintos.
Según la situación, quizá convenga considerar el uso de un resumen en su lugar.
El proceso de distinción conserva el primer registro único encontrado y descarta el resto. Quizá convenga aplicar una ordenación a los datos si es importante la coherencia entre ejecuciones.
Agregación y agrupación
Para agregar resultados, seleccione la opción de menú Resumir. Esto mostrará un conjunto de cuadros de selección para cada columna de la tabla de datos de destino. Elija un método de resumen adecuado para cada columna.
Cuando Inspeccionar origen llena las columnas, una columna numérica comienza como Agrupar por en lugar de Suma si su nombre se lee como un identificador, como id, customer_id, Order No o CustomerKey, si su tabla la define como clave, o si la combinación la usa como clave.
- Agrupar por
- Suma
- Mín.
- Máx.
- Primero
- Último
- Recuento
- Recuento (incluidos nulos)
- Media
- Desviación estándar
- Desviación estándar muestral
- Desviación estándar poblacional
- Varianza
- Varianza muestral
- Varianza poblacional
- Avanzado, sin agrupar
Para un uso avanzado del asignador de datos, como expresiones, limpieza y constantes, consulte Uso avanzado del asignador de datos
Columnas obsoletas
Sección titulada «Columnas obsoletas»Una fila de Join Map o de Columnas de salida de destino puede nombrar una columna que la pestaña Columnas de origen del paso ya no incluye, por ejemplo después de volver a inspeccionar las columnas de un origen. El paso nunca quita esa fila por usted. En su lugar, el nombre de la columna se muestra en rojo tras un signo de advertencia ⚠, y al pasar el puntero sobre él se indica a qué lista de origen le falta la columna.
Una fila de Columnas de salida de destino con un resumen Constante, Expresión o Recuento (incluidos nulos) nunca se marca, porque el paso no lee la columna de origen de esa fila. No se comprueba nada con un origen cuya lista está vacía, por ejemplo uno que nunca se inspeccionó.
Cuando guarda un paso que aún tiene filas marcadas, un cuadro de diálogo Se encontraron columnas obsoletas las enumera por tabla y ofrece tres opciones:
- Quitar todas y guardar: quita las filas marcadas y después guarda.
- Guardar de todos modos: guarda el paso tal como está.
- Cancelar: vuelve al paso sin guardar.
Para conservar una fila y eliminar su advertencia, vuelva a agregar la columna a la lista de ese origen en la pestaña Columnas de origen, o elija una columna que la lista contenga.
Al guardar, también se comprueba cada tabla de origen tal como está en ese momento. Si una columna que la lista de un origen incluye no existe en su tabla, se abre un cuadro de diálogo Faltan columnas de origen que nombra la tabla y la columna, con Guardar de todos modos o Cancelar. Cuando también hay filas marcadas, ambos avisos aparecen juntos en el cuadro de diálogo Se encontraron columnas obsoletas. Consulte Columnas que faltan en la tabla de origen.
Filtros de salida
Sección titulada «Filtros de salida»
Para ofrecer la máxima flexibilidad, hay filtros de datos disponibles tanto para los datos de origen como para los datos de destino. En conjuntos de datos grandes, puede ser especialmente beneficioso filtrar filas en el origen para que las operaciones restantes se realicen sobre un conjunto de datos más pequeño.
Seleccionar un subconjunto de datos
Este tipo de filtro permite filtrar los datos de origen entrantes según las condiciones especificadas.
Aplicar un filtro secundario a los datos resultantes
Este tipo de filtro permite aplicar un filtro a los datos resultantes posteriores a la transformación según las condiciones especificadas. La posibilidad de aplicar un filtro sobre el resultado transformado permite realizar exclusiones basadas en los resultados de cálculos complejos, resúmenes o funciones de ventana.
Segmentación final de la tabla de datos (límite)
La capacidad de segmentación de filas permite limitar las filas del conjunto de resultados según un intervalo y un punto de inicio.
Sintaxis de filtros
La sintaxis de filtros utiliza Python SQLAlchemy, que es la misma sintaxis que otras expresiones.
Consulte ejemplos y funciones de expresión en el área de Expresiones.
Ejemplos
Sección titulada «Ejemplos»Combinar fabricantes de automóviles con modelos
Sección titulada «Combinar fabricantes de automóviles con modelos»En este ejemplo, considere las siguientes tablas de datos de origen. La primera es una lista de fabricantes de automóviles.
| Mfg_ID | Manufacturer |
|---|---|
| 1 | Aston Martin |
| 2 | Porsche |
| 3 | Lamborghini |
| 4 | Ferrari |
| 5 | Koenigsegg |
A continuación hay una lista de modelos de automóviles con un ID de fabricante. Observe que hay varios modelos sin fabricante.
| ModelName | Mfg_ID |
|---|---|
| Aventador | 3 |
| Countach | 3 |
| DBS | 1 |
| Enzo | 4 |
| One-77 | 1 |
| Optimus Prime | |
| Batmobile | |
| Agera | 5 |
| Lightning McQueen |
Para obtener una lista de modelos por fabricante, lo lógico es combinar por Mfg_ID. Al aprovechar los conceptos de combinación externa, la salida también podrá mostrar los elementos que no tienen ninguna coincidencia.
Primero, especifique los parámetros de Table 1 Data Selection. Se selecciona la tabla de datos de origen y se enumeran todas las columnas.
A continuación, especifique los parámetros de Table 2 Data Selection. De nuevo, se selecciona la tabla de datos de origen y se enumeran todas las columnas.
Por último, las condiciones de combinación se establecen en la pestaña Table Output. Con el botón Detectar, Analyze identifica correctamente la columna Mfg_ID que se usará como Join Key. Como este ejemplo conserva las filas sin coincidencia de ambas tablas, establezca el Tipo de combinación en Combinación externa completa. Por último, las
Columnas de salida de destino se especifican automáticamente con el botón Propagar. Esto incluye de forma efectiva todas las columnas de todas las tablas, y las columnas de combinación, obviamente, se incluyen una sola vez. Observe que las columnas se ordenan alfabéticamente, primero por Manufacturer y después por ModelName.
Como era de esperar, la salida final incluye todas las filas de ambas tablas, tengan o no coincidencia en las dos. Por eso, esta vez Porsche sí aparece a pesar de no tener modelos. Además, Batmobile, Lightning McQueen y Optimus Prime se incluyen en los resultados aunque ninguno tenga fabricante. Además, ¿quién puede decirles que no?