

Export to CSV
Descripción
Sección titulada «Descripción»Escribe una tabla de proyecto de PlaidCloud en una cuenta de documentos como un archivo CSV (valores separados por comas). Es el formato de exportación más habitual: lo admiten prácticamente todos los sistemas posteriores, las herramientas de hojas de cálculo y las plataformas de BI.
Configurable: delimitador (coma, tabulación, barra vertical, personalizado), comportamiento de las comillas, fila de encabezado y codificación.
Parámetros de exportación
Sección titulada «Parámetros de exportación»Selector de archivo de exportación
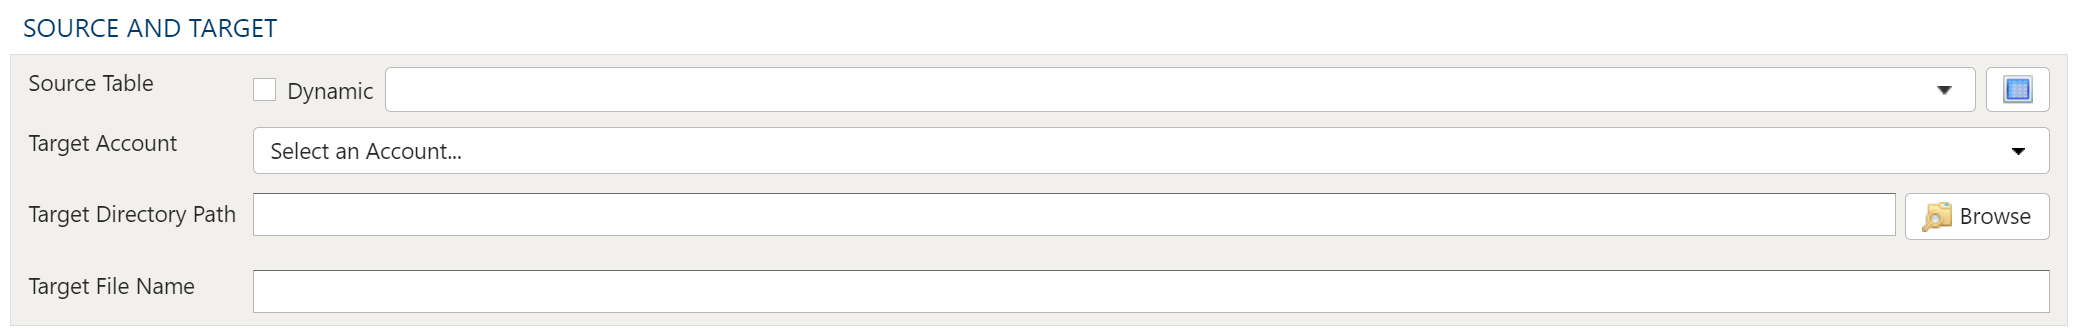
El selector de archivo de esta transformación le permite elegir un destino donde almacenar el resultado exportado en un documento de PlaidCloud.
Usted elige un directorio y especifica un nombre de archivo para el archivo de destino.
Tabla de origen
Opción dinámica
La opción dinámica permite especificar una tabla mediante texto, incluidas variables. Esto resulta útil en flujos de trabajo controlados por variables, en los que las referencias a tablas y vistas son relativas a las variables especificadas.
Un ejemplo que usa la variable current_month para apuntar dinámicamente a la tabla de origen:
legal_entity/inputs/{current_month}/ledger_valuesOpción estática
Cuando se desea una tabla concreta como origen de la exportación, deje sin marcar la casilla Dinámico y seleccione la tabla de origen.
El Explorador de tablas está siempre disponible con cualquier selección de tabla. Haga clic en el botón Explorador de tablas situado a la derecha de la selección de tabla y se abrirá una ventana del Explorador de tablas.
Selección de una cuenta de documentos
Elija una cuenta de documentos de PlaidCloud a la que tenga acceso. Esto le permitirá seleccionar un directorio en la siguiente selección.
Dentro de un proyecto, la lista también ofrece Project Default en la parte superior: un sustituto de la cuenta que el proyecto tenga establecida como predeterminada en ese momento. Un paso nuevo preselecciona Project Default cuando el proyecto tiene una; un paso existente conserva la cuenta con la que se guardó hasta que usted la cambie. Un paso que se deja en Project Default se ejecuta con la cuenta que sea la predeterminada del proyecto en ese momento; si no hay ninguna establecida, la ejecución falla y nombra el proyecto en lugar de recurrir a otra cuenta.
Ruta del directorio de destino
Seleccione el icono Examinar a la derecha de la Ruta del directorio de destino y navegue hasta la ubicación donde desea guardar el archivo.
Nombre del archivo de destino
Especifique el nombre con el que se debe guardar el archivo exportado.
Selección de la compresión de archivo
Sección titulada «Selección de la compresión de archivo»Todos los archivos exportados están sin comprimir, pero están disponibles las siguientes opciones de compresión:
- Sin compresión
- Zip
- GZip
- BZip2
Formato de datos
Sección titulada «Formato de datos»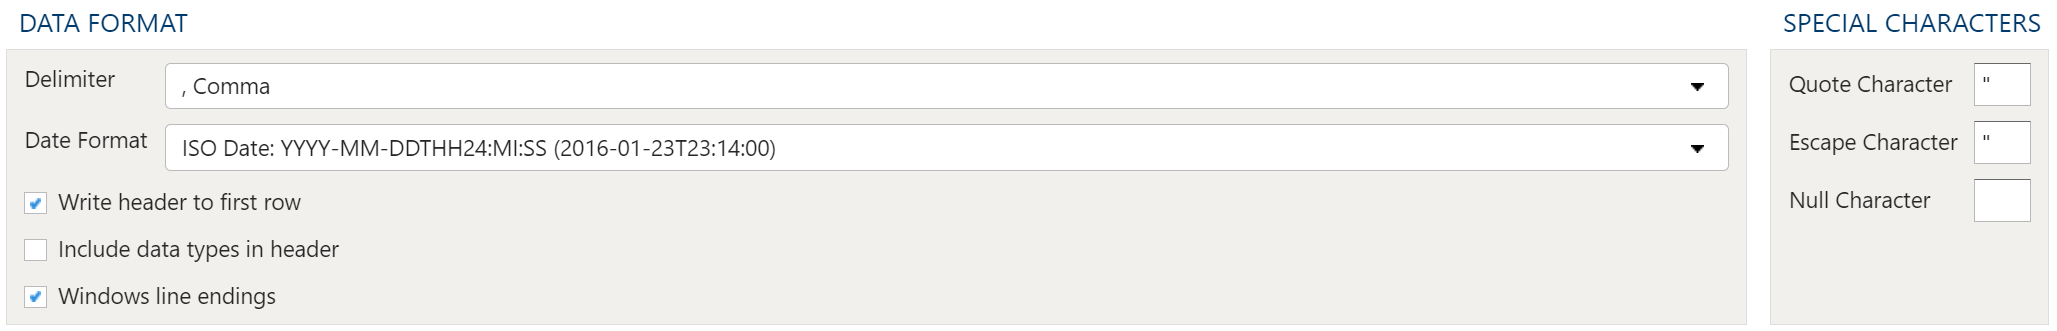
Delimitador
Sección titulada «Delimitador»La transformación Export CSV se utiliza para exportar tablas de datos a archivos de texto delimitado guardados en PlaidCloud Document. Esto incluye, entre otros, los siguientes tipos de delimitador:
-
CSV de Excel (separado por comas)
-
TSV de Excel (separado por tabulaciones)
-
Separador definido por el usuario –>
- coma (,)
- barra vertical (|)
- punto y coma (;)
- tabulación
- espacio ( )
- otro/personalizado (virgulilla, guion, etc.)
Para especificar un delimitador personalizado, seleccione Separador definido por el usuario –> y después Otro –>, y escriba el delimitador personalizado en el cuadro de texto.
Caracteres especiales
Sección titulada «Caracteres especiales»La sección Caracteres especiales permite especificar cómo tratar los datos con comillas y caracteres de escape. Elija entre las siguientes configuraciones:
- Caracteres especiales (QUOTE_MINIMAL): entrecomilla los campos con caracteres especiales (todo lo que confundiría a un analizador configurado con el mismo dialecto y las mismas opciones). Esta es la configuración predeterminada.
- Todo (QUOTE_ALL): entrecomilla todo, sea cual sea el tipo.
- No numérico (QUOTE_NONNUMERIC): entrecomilla todos los campos que no sean enteros ni de punto flotante. Cuando se usa con el lector, los campos de entrada sin comillas se convierten en números de punto flotante.
- Ninguno (QUOTE_NONE): no entrecomilla nada en la salida. Los caracteres de comillas se incluyen en la salida con el carácter de escape que proporcione el usuario. Tenga en cuenta que solo se puede proporcionar un único carácter de escape.
De forma predeterminada, una comilla dentro de un campo entrecomillado se escribe duplicada (""). Active escape_quotes para escribirla con el carácter de escape en su lugar, como hace Spark: con \ como carácter de escape, el campo say "hi" se escribe "say \"hi\"". La opción está desactivada de forma predeterminada, por lo que las exportaciones existentes no cambian.
De forma predeterminada, un valor que contiene un carácter de comillas se entrecomilla solo por ese motivo. Desmarque Entrecomillar los valores que contengan el carácter de comillas para escribir ese valor sin comillas circundantes, como hace Spark con escapeQuotes desactivado; un valor que contiene el delimitador o un salto de línea sigue entrecomillándose. La casilla está marcada de forma predeterminada. Si se desmarca, el archivo lo escribe PlaidCloud en lugar del almacén.
Deje Carácter de comillas vacío para escribir cada valor exactamente como es: no se entrecomilla ni se escapa nada. Un valor que contiene el delimitador o un salto de línea se lee entonces como más campos, así que elija un delimitador que sus datos no contengan.
Escribir el encabezado en la primera fila
Sección titulada «Escribir el encabezado en la primera fila»Si esta casilla está marcada, los encabezados de la tabla se exportan a la primera fila. Si no lo está, el archivo exportado no tendrá encabezados.
Incluir los tipos de datos en los encabezados
Sección titulada «Incluir los tipos de datos en los encabezados»Si esta casilla está marcada, los encabezados del archivo exportado contendrán el tipo de datos de la columna.
Finales de línea de Windows
Sección titulada «Finales de línea de Windows»Por último, la casilla Use Windows Compatible Line Endings está marcada de forma predeterminada para garantizar la compatibilidad con los sistemas Windows. Se recomienda dejar esta configuración activada, salvo que se trabaje únicamente en un entorno unix.
Si el archivo existe
Sección titulada «Si el archivo existe»En Más opciones de CSV, Un archivo que ya existe (if_exists) decide qué ocurre cuando el archivo ya está allí: replace (valor predeterminado) escribe un archivo nuevo, append agrega las filas al final del archivo existente sin una fila de encabezado y fail detiene el paso sin escribir nada. Una anexión descarga el archivo, agrega las filas y lo vuelve a cargar, de modo que cuando dos ejecuciones anexan al mismo archivo a la vez, prevalece la última en terminar. Con append, seleccione Volver a escribir el encabezado debajo de las filas existentes (header_on_append) para escribir de nuevo la fila de encabezado debajo de las filas que ya están allí.
Configuración adicional
Sección titulada «Configuración adicional»Más opciones de CSV contiene además estos campos:
- Ordenar filas por (
sort_columns): ordena las filas escritas según estas columnas de origen, empezando por la primera clave, cada una con una configuración de Columna, Ascendente y Nulos. No es necesario que se escriba una columna clave. Nulos es, de forma predeterminada, primero en orden ascendente y último en orden descendente. No se usa con Resumir ni Distinto. - Final de línea (
line_ending): el final de cada línea,\n,\r\no\r, en lugar de Use Windows Compatible Line Endings. - Entrecomillar (
quote_mode): qué valores se entrecomillan: Nunca, Siempre, Todos los valores salvo números y booleanos o Un valor que contiene el delimitador. De forma predeterminada, un valor se entrecomilla cuando es necesario. - Comilla de cierre (
quote_end): la comilla de cierre, cuando difiere de la comilla de apertura. - Comilla de cierre dentro de un valor (
quote_replacement): se escribe en lugar de una comilla de cierre dentro de un valor entrecomillado. Si se deja vacío, la comilla se duplica. - Delimitador dentro de un valor (
delimiter_replacement): con Entrecomillar establecido en Nunca, se escribe en lugar del delimitador dentro de un valor. - Iniciar el archivo con una marca de orden de bytes (
write_bom): inicia el archivo con una marca de orden de bytes. - Separador decimal (
decimal_separator): el carácter que se escribe para el punto decimal de un número. - Líneas antes del encabezado (
comment_lines): una matriz JSON de líneas que se escriben tal cual antes del encabezado. - Write decimal numbers as Java does (
scientific_numbers): escribe un número decimal en notación científica desde 10 millones en adelante y por debajo de 0.001, como1.0E10. - Escribir cada nombre de archivo tal como se indica, sin añadir .csv ni .tsv (
keep_file_extension): escribe cada nombre de archivo exactamente como se indica. - Con gzip, guardar el archivo con el nombre indicado, sin añadir .gz (
exact_file_name): con compresión gzip, guarda el archivo con el nombre indicado.
Selección de datos de la tabla
Sección titulada «Selección de datos de la tabla»Configuración del asignador de datos
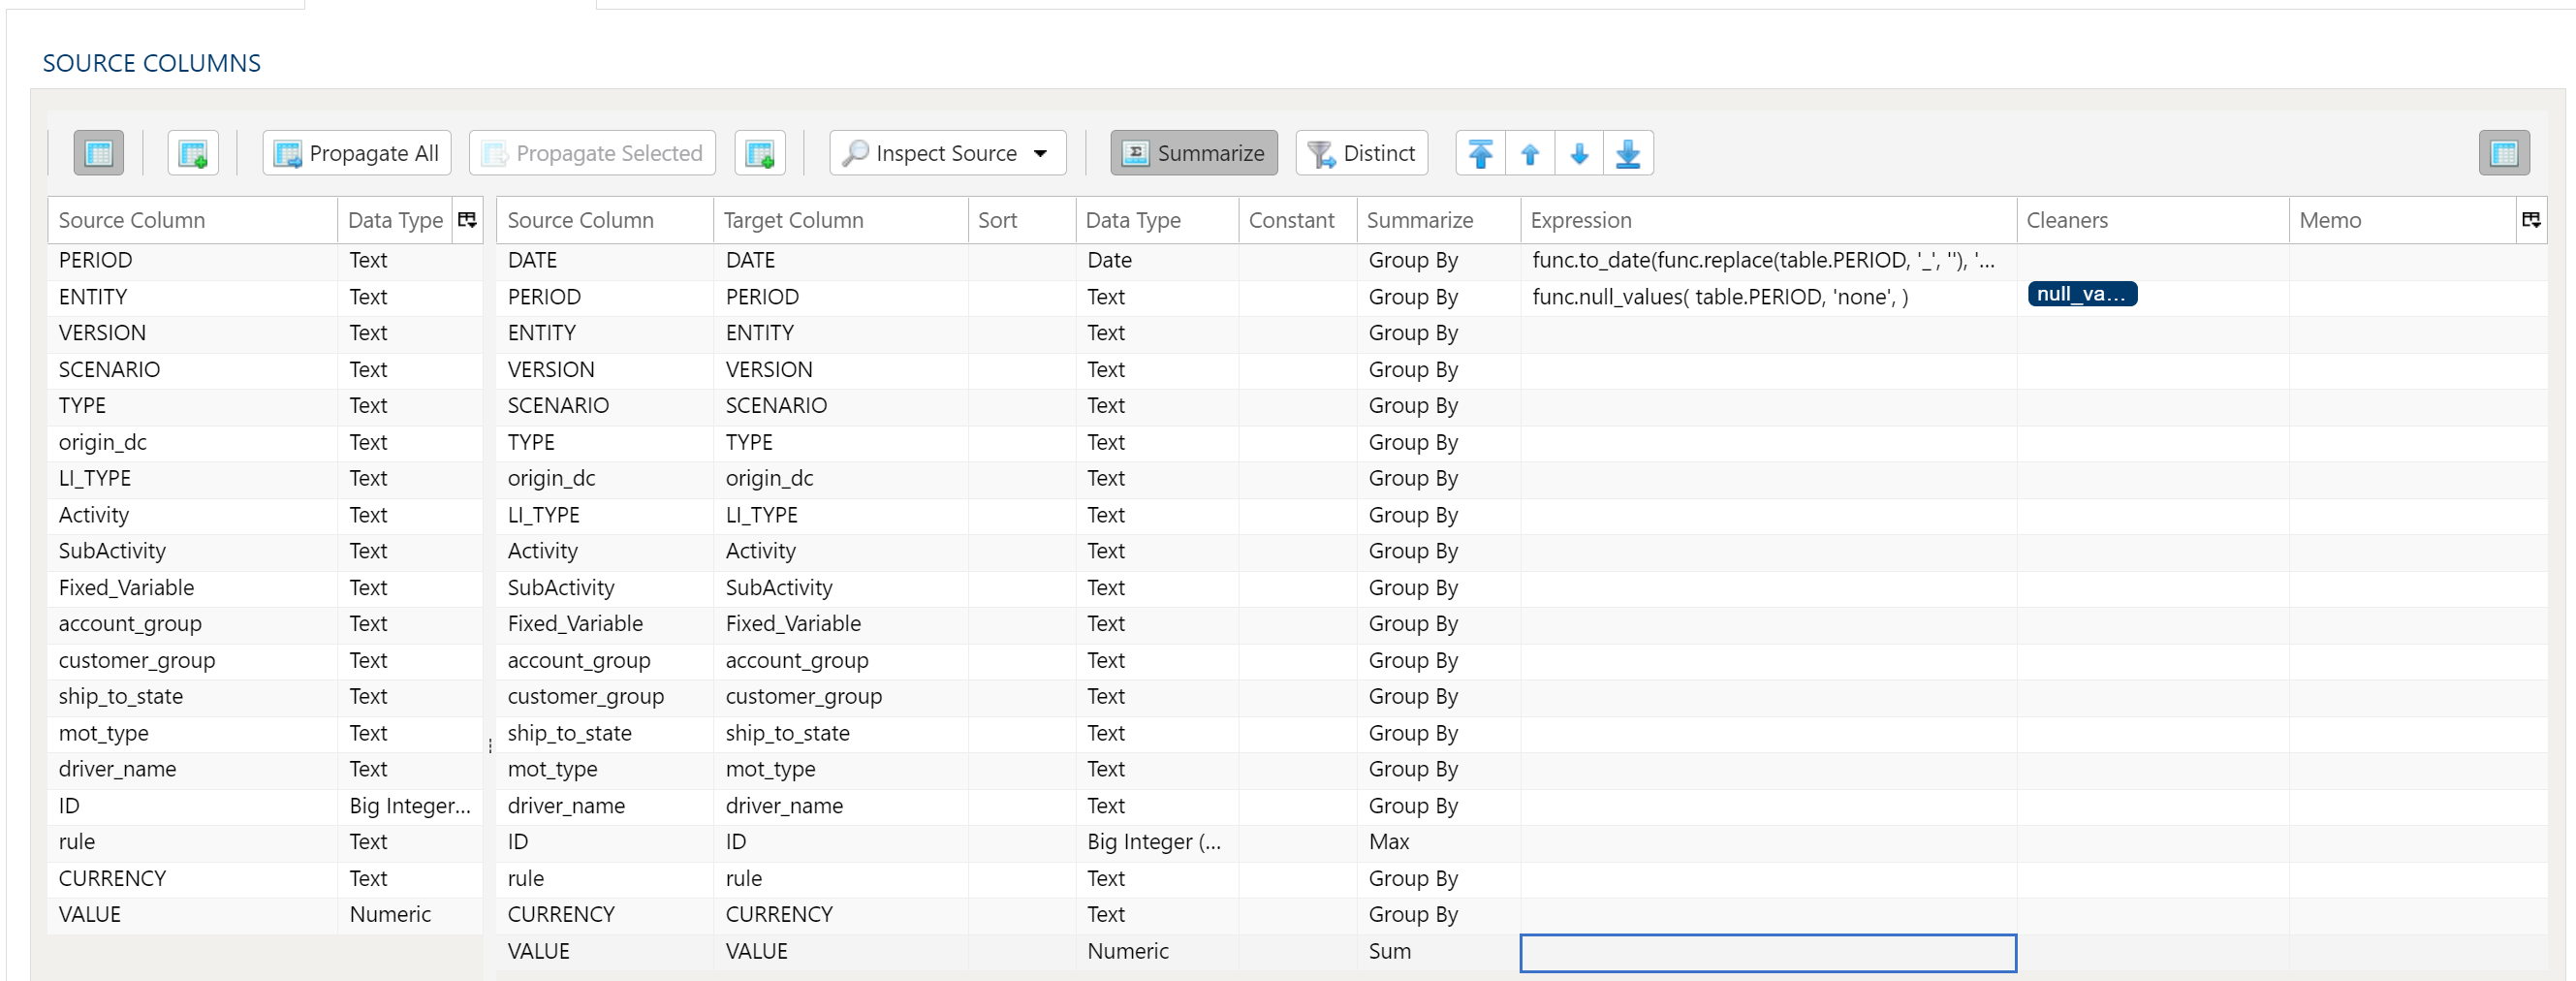
El asignador de datos se usa para asignar columnas de los datos de origen a la tabla de datos de destino.
Inspección y llenado del asignador
Usar el botón de menú Inspeccionar origen ofrece formas adicionales de asignar columnas del origen al destino:
- Rellenar ambas tablas de asignación: propaga todos los valores de la tabla de datos de origen a la tabla de datos de destino. Es la opción predeterminada.
- Rellenar solo la tabla de asignación de origen: asigna únicamente todos los valores de la tabla de datos de origen. Es útil al modificar un flujo de trabajo existente cuando la estructura de columnas de origen ha cambiado.
- Rellenar solo la tabla de asignación de destino: propaga todos los valores únicamente a la tabla de datos de destino.
Si las opciones de columnas de origen y de destino no bastan, se pueden agregar otras columnas a la tabla de datos de destino de varias maneras:
- Propagar todo insertará todas las columnas de origen en la tabla de datos de destino, existan ya o no.
- Propagar seleccionadas insertará solo las columnas de origen seleccionadas.
- Haga clic con el botón derecho en el lado de destino y seleccione Insertar fila para insertar una fila justo encima de la fila seleccionada.
- Haga clic con el botón derecho en el lado de destino y seleccione Anexar fila para insertar una fila al final (extremo derecho) de la tabla de datos de destino.
Eliminar columnas
Para eliminar columnas de la tabla de datos de destino, seleccione las columnas deseadas, haga clic con el botón derecho y seleccione Eliminar.
Columnas de origen que ya no figuran en la lista
Una fila de destino puede nombrar una Columna de origen que la tabla de datos de origen ya no incluye, por ejemplo, después de volver a inspeccionar el origen. El paso nunca quita una fila así por usted. En su lugar, el nombre de la columna se muestra en rojo junto a una señal de advertencia ⚠, y al pasar el cursor por encima se indica que la columna no está en las columnas de origen. En un paso con varias tablas, como una unión, cada tabla se comprueba con sus propias columnas de origen.
Una fila con una Constante, una Expresión o un resumen de Recuento (incluidos nulos) nunca se marca, porque el paso no lee su columna de origen. No se marca nada mientras la tabla de datos de origen no incluya columnas, por ejemplo, antes de inspeccionar el origen por primera vez.
Al guardar un paso que todavía tiene filas marcadas, un cuadro de diálogo Se encontraron columnas obsoletas las enumera bajo la pestaña o la tabla en la que se encuentran, y ofrece tres opciones:
- Quitar todas y guardar: quita las filas marcadas y luego guarda.
- Guardar de todos modos: guarda el paso tal como está.
- Cancelar: vuelve al paso sin guardar.
Para conservar una fila y eliminar su advertencia, vuelva a agregar la columna a la tabla de datos de origen o elija una columna que la tabla de datos de origen incluya.
Tipo de datos de la columna
Cada columna de destino tiene un Tipo. Una columna propagada desde el origen conserva el tipo de la columna de origen; una fila que usted agrega manualmente comienza como Texto, y usted define el Tipo para indicar lo que debe ser en realidad: una columna que piensa sumar u ordenar necesita su tipo numérico o de fecha, porque el texto se ordena y se suma como texto.
Un paso guardado con una columna sin ningún tipo se ejecuta igualmente. El tipo se determina cuando el paso se inicia, a partir de la columna de origen que lee esa columna. Si no hay nada de dónde leerlo, se trata como texto: las columnas de un paso Extraer SQL proceden de la consulta que usted escribió y no de un origen asignado, y cuando varios orígenes tienen el mismo nombre de columna con tipos que no coinciden, se usa texto en lugar de adivinar uno de ellos: una suposición errónea produce una conversión que el almacén puede rechazar, y todo se puede convertir a texto.
Definir el Tipo usted mismo sigue siendo la forma de indicar lo que debe ser una columna. Dejarlo sin definir significa aceptar lo que resulte ser la columna de origen.
Cambiar el orden de las columnas
Para reorganizar las columnas de la tabla de datos de destino, seleccione las columnas deseadas. Puede usar cualquiera de estas opciones:
- Flechas de movimiento masivo: seleccione la opción de movimiento deseada con las flechas de la esquina superior derecha.
- Menú contextual: haga clic con el botón derecho y seleccione Mover al principio, Subir, Bajar o Mover al final.
Reducir el resultado solo a registros distintos
Para devolver solo opciones distintas, seleccione la opción de menú Distinto. Esto mostrará un conjunto de casillas de verificación para cada columna del origen. Basta con marcar la casilla junto a la columna correspondiente para devolver solo resultados distintos.
Según la situación, quizá convenga considerar el uso de un resumen en su lugar.
El proceso de distinción conserva el primer registro único encontrado y descarta el resto. Quizá convenga aplicar una ordenación a los datos si es importante la coherencia entre ejecuciones.
Agregación y agrupación
Para agregar resultados, seleccione la opción de menú Resumir. Esto mostrará un conjunto de cuadros de selección para cada columna de la tabla de datos de destino. Elija un método de resumen adecuado para cada columna.
Cuando Inspeccionar origen llena las columnas, una columna numérica comienza como Agrupar por en lugar de Suma si su nombre se lee como un identificador, como id, customer_id, Order No o CustomerKey, si su tabla la define como clave, o si la combinación la usa como clave.
- Agrupar por
- Suma
- Mín.
- Máx.
- Primero
- Último
- Recuento
- Recuento (incluidos nulos)
- Media
- Desviación estándar
- Desviación estándar muestral
- Desviación estándar poblacional
- Varianza
- Varianza muestral
- Varianza poblacional
- Avanzado, sin agrupar
Para un uso avanzado del asignador de datos, como expresiones, limpieza y constantes, consulte Uso avanzado del asignador de datos
Filtros de datos
Sección titulada «Filtros de datos»
Para ofrecer la máxima flexibilidad, hay filtros de datos disponibles tanto para los datos de origen como para los datos de destino. En conjuntos de datos grandes, puede ser especialmente beneficioso filtrar filas en el origen para que las operaciones restantes se realicen sobre un conjunto de datos más pequeño.
Seleccionar un subconjunto de datos
Este tipo de filtro permite filtrar los datos de origen entrantes según las condiciones especificadas.
Aplicar un filtro secundario a los datos resultantes
Este tipo de filtro permite aplicar un filtro a los datos resultantes posteriores a la transformación según las condiciones especificadas. La posibilidad de aplicar un filtro sobre el resultado transformado permite realizar exclusiones basadas en los resultados de cálculos complejos, resúmenes o funciones de ventana.
Segmentación final de la tabla de datos (límite)
La capacidad de segmentación de filas permite limitar las filas del conjunto de resultados según un intervalo y un punto de inicio.
Sintaxis de filtros
La sintaxis de filtros utiliza Python SQLAlchemy, que es la misma sintaxis que otras expresiones.
Consulte ejemplos y funciones de expresión en el área de Expresiones.
Ejemplos
Sección titulada «Ejemplos»Todavía no hay ejemplos…