

Allocation Split
Beschreibung
Abschnitt betitelt „Beschreibung“Teilt den Wert einer Quellzeile in Teilbeträge auf und leitet jeden Teilbetrag an ein anderes Ziel, wobei die Anteile durch Treiberdaten bestimmt werden. Einfacher als Umlageregeln — verwenden Sie ihn, wenn Sie Werte lediglich ohne Zuweisungsdimension auffächern müssen.
Übliches Muster: Einen Gesamtbetrag anhand von Prozentsätzen oder Gewichten in einer Treibertabelle auf mehrere Empfänger verteilen und pro Empfänger eine Ausgabezeile erzeugen.
Datentabelleneinstellungen
Abschnitt betitelt „Datentabelleneinstellungen“Die Tabelle der zu verteilenden Werte, die Treiberdatentabelle und die Umlageergebnistabelle können dynamisch oder statisch ausgewählt werden.
Dynamische Tabellenauswahl
Abschnitt betitelt „Dynamische Tabellenauswahl“Die dynamische Tabellenoption erlaubt es, eine Tabelle mit Text und Variablen anzugeben. Das ist nützlich bei variablengesteuerten Workflows, in denen die Tabellen- oder Ansichtsverweise relativ zu den angegebenen Variablen sind.
Ein Beispiel, das die Variable current_month verwendet, um dynamisch auf eine Tabelle zu verweisen:
legal_entity/inputs/{current_month}/ledger_valuesStatische Tabellenauswahl
Abschnitt betitelt „Statische Tabellenauswahl“Wenn eine bestimmte Tabelle als Quelle gewünscht ist, lassen Sie das Kontrollkästchen Dynamic deaktiviert und wählen Sie die Quelltabelle im Dropdown-Menü aus.
Der Tabellen-Explorer ist bei jeder Tabellenauswahl verfügbar. Klicken Sie auf die Schaltfläche „Tabellen-Explorer“ rechts neben der Tabellenauswahl, und ein Fenster des Tabellen-Explorers wird geöffnet.
Tabelle der zu verteilenden Werte
Abschnitt betitelt „Tabelle der zu verteilenden Werte“Dies ist die Tabelle, die die Werte enthält, die umgelegt werden sollen. Das sind typischerweise Kosten- oder Erlöswerte.
Treiberdatentabelle
Abschnitt betitelt „Treiberdatentabelle“Die Treiberdatentabelle enthält die Werte, die der Umlageschritt zur Verteilung der Kosten verwendet.
Beispiele:
- Um in einer Lieferkette Kosten auf Kunden zu verteilen, könnten Sie Lieferdaten mit der Anzahl der Lieferungen oder dem Gewicht der Lieferungen als Treiber verwenden.
- Damit ein IT-Helpdesk seine Kosten den Abteilungen zuweisen kann, die er unterstützt, sind die Treiberdaten die Anzahl der Tickets pro Kostenstelle.
Driver Data Sign Rule
Abschnitt betitelt „Driver Data Sign Rule“Treiberdaten können sowohl positive als auch negative Werte enthalten. Mit der Driver Data Sign Rule legen Sie fest, wie widersprüchliche Vorzeichen behandelt werden.
- Error on conficting signs - Der Umlageschritt erzeugt einen Fehler und stoppt, wenn widersprüchliche Vorzeichen auftreten.
- Proceed with warning on conflicting signs - Der Umlageschritt verwendet sowohl negative als auch positive Treiberwerte, zeigt aber eine Warnung an.
- Use only positive driver values - Der Umlageschritt verwendet nur positive Treiberwerte und ignoriert negative Werte.
- Use only negative driver values - Der Umlageschritt verwendet nur negative Treiberwerte und ignoriert positive Werte.
- Use absolute values of driver data - Der Umlageschritt verwendet die Absolutwerte der Treiberdaten.
Umlageergebnistabelle
Abschnitt betitelt „Umlageergebnistabelle“Ergebnisse an Zieltabelle anhängen
Abschnitt betitelt „Ergebnisse an Zieltabelle anhängen“Wenn dieses Kontrollkästchen aktiviert ist, werden die Umlageergebnisse an die Umlageergebnistabelle angehängt. Wenn es nicht aktiviert ist, wird die Umlageergebnistabelle bei jeder Ausführung des Umlageschritts überschrieben.
Separate Spalten für umgelegte Ergebnisse
Abschnitt betitelt „Separate Spalten für umgelegte Ergebnisse“Wenn dieses Kontrollkästchen aktiviert ist, zeigt die Ergebnistabelle den Betrag jedes umgelegten Datensatzes sowie den Betrag, der tatsächlich jedem Treiberdatensatz zugewiesen wurde.
Umlagequellzuordnung
Abschnitt betitelt „Umlagequellzuordnung“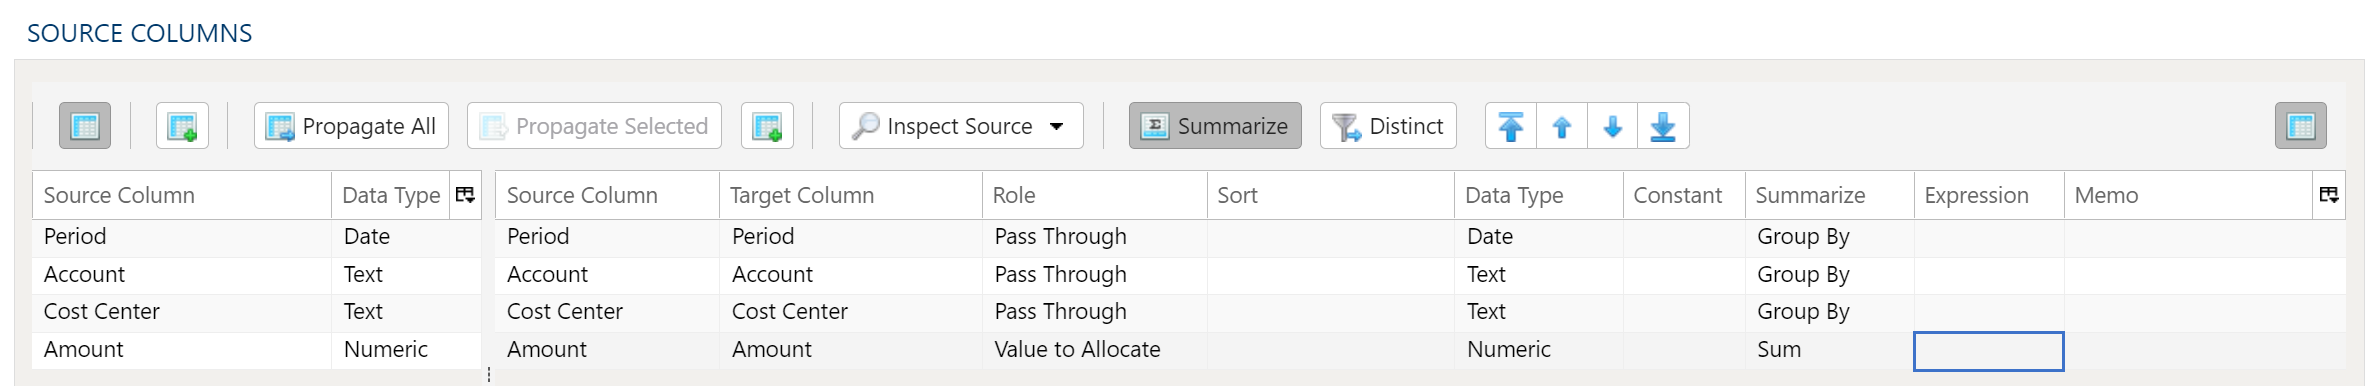
Die Umlagequellzuordnung ordnet die Spalten der Tabelle der zu verteilenden Werte zu, die im Umlageschritt verwendet werden.
Quelle untersuchen und Zuordnung füllen
Die Menüschaltfläche Quelle untersuchen bietet weitere Möglichkeiten, Spalten von der Quelle dem Ziel zuzuordnen:
- Beide Zuordnungstabellen füllen: Übernimmt alle Werte aus der Quelldatentabelle in die Zieldatentabelle. Dies ist die Standardeinstellung.
- Nur Quellzuordnungstabelle füllen: Ordnet nur alle Werte der Quelldatentabelle zu. Das ist hilfreich, wenn Sie einen bestehenden Workflow ändern und sich die Spaltenstruktur der Quelle geändert hat.
- Nur Zielzuordnungstabelle füllen: Übernimmt alle Werte nur in die Zieldatentabelle.
Reichen die Quell- und Zielspaltenoptionen nicht aus, können Sie auf mehrere Arten weitere Spalten in die Zieldatentabelle aufnehmen:
- Alle übernehmen fügt alle Quellspalten in die Zieldatentabelle ein, unabhängig davon, ob sie bereits vorhanden sind.
- Ausgewählte übernehmen fügt nur die ausgewählten Quellspalten ein.
- Klicken Sie auf der Zielseite mit der rechten Maustaste und wählen Sie Zeile einfügen, um eine Zeile direkt über der aktuell ausgewählten Zeile einzufügen.
- Klicken Sie auf der Zielseite mit der rechten Maustaste und wählen Sie Zeile anhängen, um eine Zeile am Ende (ganz rechts) der Zieldatentabelle einzufügen.
Rolle
Jeder Spalte im Data Mapper muss eine Rolle zugewiesen werden:
- Durchreichen – Diese Spalten erscheinen in der Umlageergebnistabelle.
- Umzulegender Wert – Dies ist die Spalte, die die umzulegenden Werte enthält.
Spalten löschen
Um Spalten aus der Zieldatentabelle zu löschen, wählen Sie die gewünschten Spalten aus, klicken mit der rechten Maustaste und wählen Löschen.
Spaltenreihenfolge ändern
Um Spalten in der Zieldatentabelle neu anzuordnen, wählen Sie die gewünschten Spalten aus. Dazu stehen zwei Möglichkeiten zur Verfügung:
- Pfeile zum Verschieben mehrerer Spalten: Wählen Sie die gewünschte Verschiebeoption über die Pfeile oben rechts.
- Kontextmenü: Klicken Sie mit der rechten Maustaste und wählen Sie An den Anfang verschieben, Nach oben, Nach unten oder An das Ende verschieben.
Ergebnis auf eindeutige Datensätze reduzieren
Um nur eindeutige Datensätze zurückzugeben, wählen Sie die Menüoption Eindeutig. Dadurch wird für jede Spalte der Quelle ein Kontrollkästchen eingeblendet. Aktivieren Sie das Kontrollkästchen neben der entsprechenden Spalte, um nur eindeutige Ergebnisse zurückzugeben.
Je nach Situation kann stattdessen eine Zusammenfassung sinnvoller sein.
Bei der Eindeutigkeitsprüfung bleibt der erste gefundene eindeutige Datensatz erhalten, die übrigen werden verworfen. Wenn die Konsistenz zwischen Ausführungen wichtig ist, sollten Sie die Daten sortieren.
Aggregation und Gruppierung
Um Ergebnisse zu aggregieren, wählen Sie die Menüoption Zusammenfassen. Dadurch wird für jede Spalte der Zieldatentabelle ein Auswahlfeld eingeblendet. Wählen Sie für jede Spalte eine geeignete Zusammenfassungsmethode.
- Gruppieren nach
- Summe
- Minimum
- Maximum
- Erster
- Letzter
- Anzahl
- Anzahl (einschließlich Nullwerte)
- Mittelwert
- Standardabweichung
- Stichproben-Standardabweichung
- Grundgesamtheits-Standardabweichung
- Varianz
- Stichprobenvarianz
- Grundgesamtheitsvarianz
- Erweitert, ohne Gruppierung
Informationen zur erweiterten Verwendung des Data Mapper, etwa für Ausdrücke, Bereinigung und Konstanten, finden Sie unter Erweiterte Verwendung des Data Mapper.
Umlagequellfilter
Abschnitt betitelt „Umlagequellfilter“
Für maximale Flexibilität stehen Datenfilter sowohl für die Quelldaten als auch für die Zieldaten zur Verfügung. Bei größeren Datensätzen kann es besonders vorteilhaft sein, Zeilen bereits in der Quelle herauszufiltern, sodass die übrigen Operationen auf einem kleineren Datensatz ausgeführt werden.
Teilmenge der Daten auswählen
Mit diesem Filtertyp filtern Sie die eingehenden Quelldaten anhand der angegebenen Bedingungen.
Sekundären Filter auf Ergebnisdaten anwenden
Mit diesem Filtertyp wenden Sie anhand der angegebenen Bedingungen einen Filter auf die Ergebnisdaten nach der Transformation an. Dadurch können Zeilen anhand der Ergebnisse komplexer Berechnungen, Zusammenfassungen oder Fensterfunktionen ausgeschlossen werden.
Zeilenbegrenzung der endgültigen Datentabelle (Limit)
Mit der Zeilenbegrenzung schränken Sie die Zeilen im Ergebnis anhand eines Bereichs und eines Startpunkts ein.
Filtersyntax
Die Filtersyntax nutzt Python SQLAlchemy und entspricht damit der Syntax anderer Ausdrücke.
Beispiele und Ausdrucksfunktionen finden Sie im Bereich Ausdrücke.
Treiberdatenzuordnung
Abschnitt betitelt „Treiberdatenzuordnung“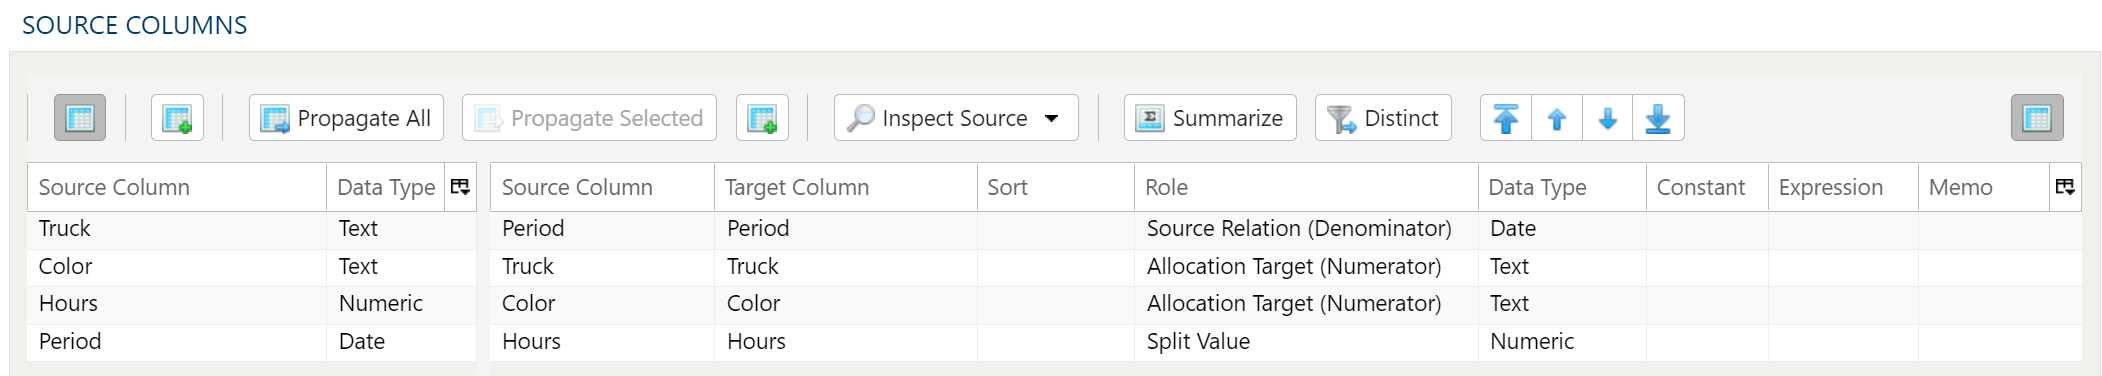
Die Treiberdatenzuordnung der Umlage ordnet die Spalten der Treiberdatentabelle zu, die im Umlageschritt verwendet werden.
Quelle untersuchen und Zuordnung füllen
Die Menüschaltfläche Quelle untersuchen bietet weitere Möglichkeiten, Spalten von der Quelle dem Ziel zuzuordnen:
- Beide Zuordnungstabellen füllen: Übernimmt alle Werte aus der Quelldatentabelle in die Zieldatentabelle. Dies ist die Standardeinstellung.
- Nur Quellzuordnungstabelle füllen: Ordnet nur alle Werte der Quelldatentabelle zu. Das ist hilfreich, wenn Sie einen bestehenden Workflow ändern und sich die Spaltenstruktur der Quelle geändert hat.
- Nur Zielzuordnungstabelle füllen: Übernimmt alle Werte nur in die Zieldatentabelle.
Reichen die Quell- und Zielspaltenoptionen nicht aus, können Sie auf mehrere Arten weitere Spalten in die Zieldatentabelle aufnehmen:
- Alle übernehmen fügt alle Quellspalten in die Zieldatentabelle ein, unabhängig davon, ob sie bereits vorhanden sind.
- Ausgewählte übernehmen fügt nur die ausgewählten Quellspalten ein.
- Klicken Sie auf der Zielseite mit der rechten Maustaste und wählen Sie Zeile einfügen, um eine Zeile direkt über der aktuell ausgewählten Zeile einzufügen.
- Klicken Sie auf der Zielseite mit der rechten Maustaste und wählen Sie Zeile anhängen, um eine Zeile am Ende (ganz rechts) der Zieldatentabelle einzufügen.
Rolle
Jeder Spalte im Data Mapper muss eine Rolle zugewiesen werden:
- Quellbezug – Diese Spalten haben entsprechende Spalten in der Tabelle der zu verteilenden Werte.
- Umlageziel – Diese Spalten sind das Ziel des Umlageschritts und erscheinen in der Umlageergebnistabelle.
- Wert aufteilen – Diese Spalte enthält die Werte, mit denen die Werte in der Tabelle der zu verteilenden Werte umgelegt werden.
Spalten löschen
Um Spalten aus der Zieldatentabelle zu löschen, wählen Sie die gewünschten Spalten aus, klicken mit der rechten Maustaste und wählen Löschen.
Spaltenreihenfolge ändern
Um Spalten in der Zieldatentabelle neu anzuordnen, wählen Sie die gewünschten Spalten aus. Dazu stehen zwei Möglichkeiten zur Verfügung:
- Pfeile zum Verschieben mehrerer Spalten: Wählen Sie die gewünschte Verschiebeoption über die Pfeile oben rechts.
- Kontextmenü: Klicken Sie mit der rechten Maustaste und wählen Sie An den Anfang verschieben, Nach oben, Nach unten oder An das Ende verschieben.
Ergebnis auf eindeutige Datensätze reduzieren
Um nur eindeutige Datensätze zurückzugeben, wählen Sie die Menüoption Eindeutig. Dadurch wird für jede Spalte der Quelle ein Kontrollkästchen eingeblendet. Aktivieren Sie das Kontrollkästchen neben der entsprechenden Spalte, um nur eindeutige Ergebnisse zurückzugeben.
Je nach Situation kann stattdessen eine Zusammenfassung sinnvoller sein.
Bei der Eindeutigkeitsprüfung bleibt der erste gefundene eindeutige Datensatz erhalten, die übrigen werden verworfen. Wenn die Konsistenz zwischen Ausführungen wichtig ist, sollten Sie die Daten sortieren.
Aggregation und Gruppierung
Um Ergebnisse zu aggregieren, wählen Sie die Menüoption Zusammenfassen. Dadurch wird für jede Spalte der Zieldatentabelle ein Auswahlfeld eingeblendet. Wählen Sie für jede Spalte eine geeignete Zusammenfassungsmethode.
- Gruppieren nach
- Summe
- Minimum
- Maximum
- Erster
- Letzter
- Anzahl
- Anzahl (einschließlich Nullwerte)
- Mittelwert
- Standardabweichung
- Stichproben-Standardabweichung
- Grundgesamtheits-Standardabweichung
- Varianz
- Stichprobenvarianz
- Grundgesamtheitsvarianz
- Erweitert, ohne Gruppierung
Informationen zur erweiterten Verwendung des Data Mapper, etwa für Ausdrücke, Bereinigung und Konstanten, finden Sie unter Erweiterte Verwendung des Data Mapper.
Treiberdatenfilter
Abschnitt betitelt „Treiberdatenfilter“
Für maximale Flexibilität stehen Datenfilter sowohl für die Quelldaten als auch für die Zieldaten zur Verfügung. Bei größeren Datensätzen kann es besonders vorteilhaft sein, Zeilen bereits in der Quelle herauszufiltern, sodass die übrigen Operationen auf einem kleineren Datensatz ausgeführt werden.
Teilmenge der Daten auswählen
Mit diesem Filtertyp filtern Sie die eingehenden Quelldaten anhand der angegebenen Bedingungen.
Sekundären Filter auf Ergebnisdaten anwenden
Mit diesem Filtertyp wenden Sie anhand der angegebenen Bedingungen einen Filter auf die Ergebnisdaten nach der Transformation an. Dadurch können Zeilen anhand der Ergebnisse komplexer Berechnungen, Zusammenfassungen oder Fensterfunktionen ausgeschlossen werden.
Zeilenbegrenzung der endgültigen Datentabelle (Limit)
Mit der Zeilenbegrenzung schränken Sie die Zeilen im Ergebnis anhand eines Bereichs und eines Startpunkts ein.
Filtersyntax
Die Filtersyntax nutzt Python SQLAlchemy und entspricht damit der Syntax anderer Ausdrücke.
Beispiele und Ausdrucksfunktionen finden Sie im Bereich Ausdrücke.