

Ihr eigenes kontrolliertes LLM verwenden
Wenn Ihre Daten geschützte Gesundheitsinformationen, personenbezogene Daten, Geschäftsgeheimnisse oder etwas enthalten, das unter einen Vertrag fällt, der festlegt, wo es verarbeitet werden darf, lautet die entscheidende Frage nicht, welches Modell am klügsten ist. Sie lautet: Wessen Infrastruktur sieht den Prompt?
PlaidCloud behandelt das Modell als austauschbare Komponente, damit Sie diese Frage selbst beantworten können.
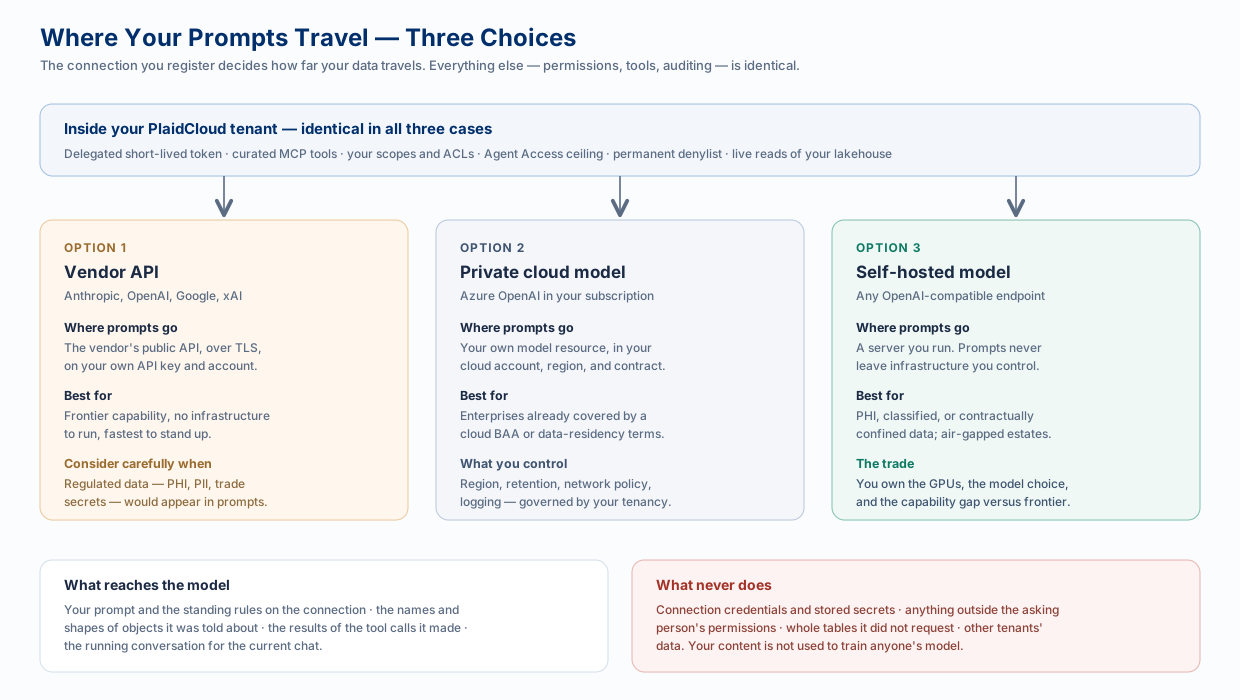
Die drei Möglichkeiten
Abschnitt betitelt „Die drei Möglichkeiten“| Anbieter-API | Privates Cloud-Modell | Selbst gehostetes Modell | |
|---|---|---|---|
| Was es ist | Die öffentliche API von Anthropic, OpenAI, Google oder xAI | Eine Azure-OpenAI-Ressource in Ihrem eigenen Abonnement | Jeder OpenAI-kompatible Endpunkt, den Sie betreiben |
| Wer den Prompt sieht | Der Anbieter, nach seinen Bedingungen und Ihrem Konto | Ihr Cloud-Tenant, nach Ihrer Vereinbarung | Nur Sie |
| Region und Aufbewahrung | Die des Anbieters | Von Ihnen festzulegen | Von Ihnen festzulegen |
| Leistungsfähigkeit | Spitzenklasse | Spitzenklasse, einen Schritt hinter der öffentlichen API | Was immer Sie hosten können |
| Sie betreiben | Nichts | Eine Cloud-Ressource | Server und GPUs |
| Geeignet für | Allgemeine Analysen mit nicht sensiblen Daten | Unternehmen, die bereits durch eine Cloud-Vereinbarung abgedeckt sind | PHI, als geheim eingestufte, vom Netz getrennte oder vertraglich eingeschränkte Daten |
Alle drei werden auf dieselbe Weise konfiguriert: eine Verbindung vom Typ LLM-Anbieter mit einem Anbieter, einem Schlüssel, einem Modell und – bei den beiden letzten – einer Basis-URL, die auf Ihren Endpunkt zeigt.
Warum sich ein kontrolliertes Modell lohnt
Abschnitt betitelt „Warum sich ein kontrolliertes Modell lohnt“Der Prompt ist die Angriffsfläche, und der Prompt enthält Ihre Daten. Ein fundierter Assistent ist gerade deshalb nützlich, weil echte Zeilen das Modell erreichen: Patientenzahlen pro Einrichtung, unveröffentlichte Preise, eine Kostenstruktur, die Sie nicht per E-Mail versenden würden. Alles andere in der Architektur – Berechtigungen, Werkzeugsteuerung, kurzlebige Token – regelt, was Ihre Systeme verlässt. Die Wahl des Modells regelt, wo es landet.
Wenn Sie PlaidCloud auf ein Modell richten, das Sie kontrollieren, bedeutet das:
- Ein Auftragsverarbeiter weniger, den Sie vertraglich abdecken müssen. Kein Drittanbieter als Unterauftragsverarbeiter, der in eine Datenschutzvereinbarung, einen BAA oder eine Anbieterprüfung aufzunehmen wäre – denn die Inferenz findet dort statt, wo bereits Abdeckung besteht.
- Nachweisbarer Datenstandort. „Verarbeitet in dieser Region, in diesem Konto, unter diesem Vertrag“ ist eine Aussage, die Sie belegen können, nicht eine, der Sie vertrauen müssen.
- Aufbewahrung und Protokollierung nach Ihren Regeln. Sie entscheiden, ob Prompts aufbewahrt werden, wie lange und wer die Protokolle lesen darf.
- Es übersteht eine Richtlinienänderung. Die Bedingungen eines Anbieters können sich ändern; Infrastruktur, die Sie betreiben, ändert sich nicht unter Ihren Händen.
- Vom Netz getrennte Umgebungen erhalten überhaupt erst einen Assistenten. Für Netzwerke, die keine öffentliche API erreichen können, ist ein selbst gehostetes Modell die einzige verfügbare Option.
Was das Modell tatsächlich erreicht
Abschnitt betitelt „Was das Modell tatsächlich erreicht“Es lohnt sich, genau zu sein, denn die Antwort ist enger, als viele annehmen.
An den Anbieter gesendet:
- Ihr Prompt und die Standardregeln der Verbindung
- die Namen und Strukturen der Objekte, über die der Agent informiert wurde – Tabellen- und Spaltennamen, Dimensions- namen, Pfade gebundener Dokumente
- die Ergebnisse der Werkzeugaufrufe, die das Modell ausgeführt hat, also die Zeilen, die es angefordert hat und erhalten durfte
- die laufende Unterhaltung des aktuellen Chats
Nie gesendet:
- Verbindungsanmeldedaten, gespeicherte Geheimnisse oder aufgelöste Autorisierungs-Header
- alles außerhalb der Berechtigungen der fragenden Person
- ganze Tabellen, die das Modell nicht angefordert hat
- Daten eines anderen Tenants
Und Ihre Inhalte werden nicht zum Training des Modells von irgendjemandem verwendet.
Für welche Oberflächen Sie das Modell kontrollieren
Abschnitt betitelt „Für welche Oberflächen Sie das Modell kontrollieren“Dieser Teil ist es wert, zweimal gelesen zu werden, denn er ist nicht einheitlich.
| Oberfläche | Wessen Modell läuft |
|---|---|
| LLM-Workflow-Schritt | Ihres. Der Schritt verwendet die Verbindung vom Typ LLM-Anbieter, die Sie festlegen, oder den Standard des Workspace. |
| KI-Assistent in der App | Ihres, über die Standardverbindung vom Typ LLM-Anbieter des Workspace. Das Multi-Agent-Backend hinter einigen Assistentenfunktionen wird pro Bereitstellung festgelegt und kann auf ein selbst gehostetes Modell gerichtet werden – stimmen Sie das mit PlaidCloud ab. |
| KI-Coding-Agents | Deren. Claude Code verwendet Anthropic; ChatGPT verwendet OpenAI. PlaidCloud ist die Datenquelle, nicht der Modell-Host. |
| Microsoft 365 Copilot | Das von Microsoft. Copilot läuft auf Modellen von Microsoft innerhalb Ihres M365-Tenants, unter Ihrer Microsoft-Vereinbarung. |
Einrichtung
Abschnitt betitelt „Einrichtung“-
Richten Sie den Endpunkt ein. Erstellen Sie die Azure-OpenAI-Ressource und -Bereitstellung in Ihrem Abonnement oder betreiben Sie Ihr Modell hinter einer OpenAI-kompatiblen API.
-
Machen Sie ihn über HTTPS unter einem auflösbaren öffentlichen Hostnamen erreichbar. Ausgehende Aufrufe werden vor der Ausführung validiert: Die Basis-URL muss HTTPS verwenden, und eine Loopback-, private, Link-Local- oder Cloud-Metadaten-Adresse wird abgelehnt, wobei Weiterleitungen deaktiviert sind. Stellen Sie einem selbst gehosteten Modell ein TLS- Gateway mit einem echten Hostnamen voran und beschränken Sie auf Netzwerkebene, wer es erreichen darf.
-
Registrieren Sie die Verbindung. Wählen Sie den Anbieter, fügen Sie den Schlüssel ein, legen Sie die Basis-URL fest und setzen Sie das Modell – bei Azure OpenAI ist das Modellfeld Ihr Bereitstellungsname.
-
Lassen Sie den Agent-Zugriff auf „Nur Lesen“, sofern nicht eine bestimmte Aufgabe mehr benötigt. Es ist die günstigste Kontrolle, die Sie haben.
-
Fügen Sie Ihre Regeln hinzu. Standardanweisungen sind der richtige Ort für Hausregeln – wie mit Kennungen umzugehen ist, was nie in einer Antwort stehen darf, welche Einschränkungen immer genannt werden sollen.
-
Machen Sie sie zum Standard des Workspace oder legen Sie sie für die konkreten Workflow-Schritte fest, die regulierte Daten verarbeiten.
Ein vernünftiger Mittelweg
Abschnitt betitelt „Ein vernünftiger Mittelweg“Die Sensibilität ist in einem Workspace selten einheitlich, und das Modell wird pro Verbindung gewählt – es kann also pro Aufgabe gewählt werden. Eine gängige Anordnung:
- ein Spitzenmodell eines Anbieters als Standard des Workspace, für Schemafragen, Dokumentationshilfe, das Erstellen von Ausdrücken und die Analyse nicht sensibler Daten
- ein kontrolliertes Modell, festgelegt für die Workflow-Schritte, die regulierte Tabellen berühren
Dieselbe Plattform, dieselben Berechtigungen, derselbe Audit-Trail – zwei unterschiedliche Schadensradien, abgestimmt auf die Daten.
Verwandte Themen
Abschnitt betitelt „Verwandte Themen“- LLM-Anbieter und Verbindungen – die Felder und die Adapter
- KI- und LLM-Architektur – der gesteuerte Pfad, den alle Oberflächen teilen
- Retrieval, Grounding und Analysepfade – warum Ihre Daten nie vorab indiziert werden