

KI- und LLM-Architektur
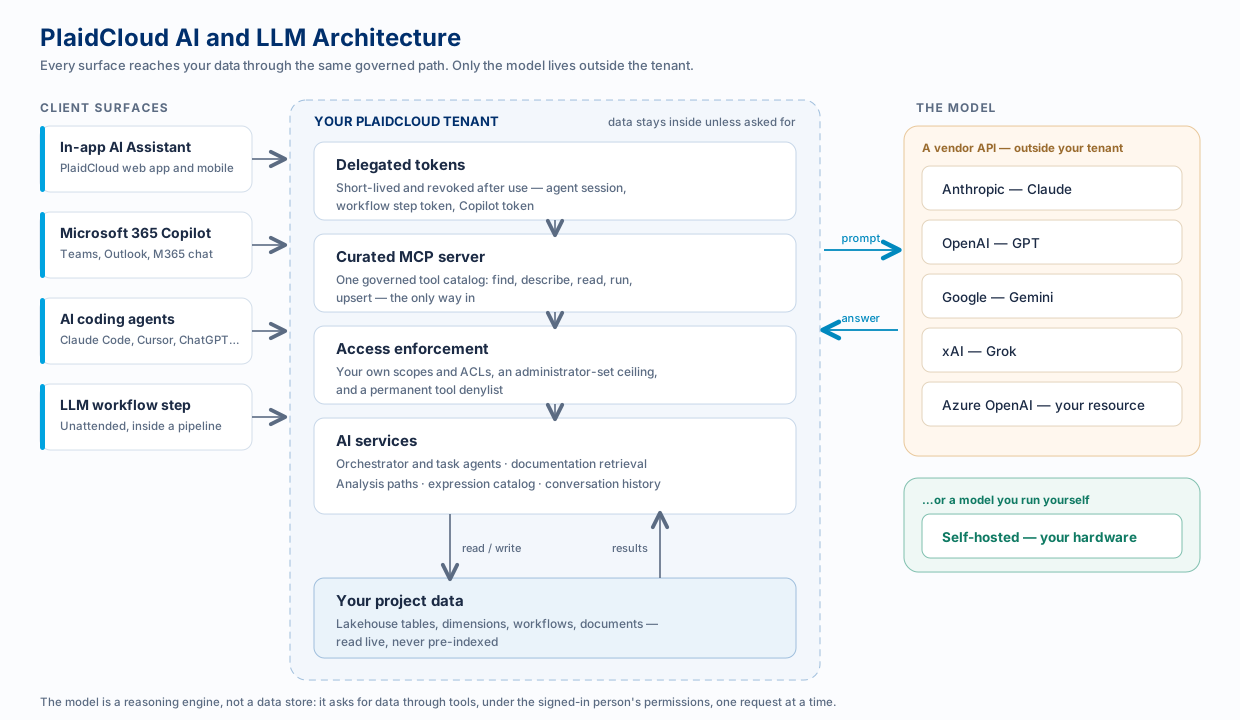
PlaidCloud hat nicht eine einzige KI-Funktion. Es gibt vier Wege zu einem Modell – den Assistenten im Produkt, Microsoft 365 Copilot, externe Coding-Agents und einen LLM-Schritt in einem Workflow – und alle vier laufen über denselben gesteuerten Pfad. Das Modell selbst ist austauschbar: Claude, GPT, Gemini, Grok, eine Azure-OpenAI-Ressource in Ihrem eigenen Abonnement oder ein Modell, das Sie selbst hosten.
Dieser Abschnitt erklärt die Architektur: was wo läuft, was die Grenze überschreitet und warum.
Die vier Oberflächen
Abschnitt betitelt „Die vier Oberflächen“| Oberfläche | Wer sie nutzt | Wie das Modell an Daten gelangt | Wo Sie beginnen |
|---|---|---|---|
| KI-Assistent in der App | Alle, die in PlaidCloud arbeiten | Die eigenen Agents von PlaidCloud rufen in Ihrem Namen interne Werkzeuge auf | Weave-KI-Chat |
| Microsoft 365 Copilot | Ganze Teams, in Teams und Outlook | Ein veröffentlichter Agent meldet die Person an und ruft dann den MCP-Server auf | Microsoft 365 Copilot |
| KI-Coding-Agents | Analysten und Entwickler | Ihr Client verbindet sich per OAuth direkt mit dem MCP-Server | Erste Schritte |
| LLM-Workflow-Schritt | Unbeaufsichtigte Pipelines | Bei Anthropic ein Token, das nur auf die von Ihnen gebundenen Objekte beschränkt ist; bei anderen Anbietern gar kein Datenzugriff – siehe die Regeln des Schritts | LLM-Schritt |
Sie unterscheiden sich darin, wer steuert und wo die Unterhaltung stattfindet. Sie unterscheiden sich nicht darin, worauf das Modell zugreifen darf.
Ein gesteuerter Pfad
Abschnitt betitelt „Ein gesteuerter Pfad“Auf welcher Oberfläche eine Frage auch ankommt, es gelten stets dieselben fünf Punkte.
-
Das Modell läuft als Person, nicht als Plattform. Jede Anfrage trägt eine kurzlebige, nach Abschluss widerrufene Berechtigung, die für den angemeldeten Benutzer steht. Hinter der KI steht kein gemeinsames Dienstkonto mit erhöhten Rechten.
-
Werkzeuge sind der einzige Zugang. Das Modell kann Ihr Lakehouse nicht direkt abfragen. Es ruft einen kuratierten Katalog von Werkzeugen auf – finden, beschreiben, lesen, ausführen, Upsert – und jeder Aufruf wird einzeln geprüft.
-
Ihre eigenen Berechtigungen begrenzen es weiterhin. Eine KI-Anfrage kann nie etwas sehen oder ändern, was Sie nicht auch selbst sehen oder ändern könnten. Die KI-Schicht schränkt den Zugriff ein; sie erweitert ihn nie.
-
Ein Administrator legt die Obergrenze fest, und sie beginnt geschlossen. Der Agent-Zugriff einer LLM-Verbindung beginnt bei „Nur Lesen“. Microsoft 365 Copilot beginnt bei gar nichts: Solange ein Administrator einer Person keine Zugriffsstufe zuweist, erhält sie als angemeldete Person keine Daten. Das sind zwei getrennte Mechanismen, aber das Anheben von beiden begrenzt immer nur, was die KI versuchen darf – es erweitert nie, worauf Sie ohnehin schon zugreifen konnten.
-
Manches ist dauerhaft tabu. Anmelde- und Verbindungseinstellungen, Identitäts- und Gruppenverwaltung, Änderungen der Zugriffskontrolle, Veröffentlichung und bereitstellbarer Code können nie von einer KI-Berechtigung aufgerufen werden – unabhängig davon, was ein Administrator gewährt hat, bei jedem Anbieter. Diese bleiben ausschließlich Menschen vorbehalten.
Der Weg einer Frage
Abschnitt betitelt „Der Weg einer Frage“Nehmen Sie die Frage „Warum sind die umgelegten IT-Kosten für Atlanta im letzten Quartal gestiegen?“, gestellt auf einer beliebigen Oberfläche:
-
Eine Berechtigung wird ausgestellt für die fragende Person, eingeschränkt und kurzlebig.
-
Werkzeuge werden dem Modell bereitgestellt – auf den Oberflächen, die einschränken, begrenzt auf das, was die Frage voraussichtlich benötigt, auf den anderen aus dem Katalog ermittelt.
-
Der Prompt geht an das Modell – die Frage, alle Standardregeln und die Werkzeugbeschreibungen. Noch keine Daten.
-
Das Modell fordert Daten an über Werkzeugaufrufe: den Analysepfad auflösen, das Schema lesen, die Umlageverfolgung ausführen, die Treiberzeilen lesen. Jeder Aufruf wird beim Eintreffen auf Berechtigungen geprüft.
-
Das Modell antwortet auf Grundlage der Ergebnisse, nennt die Dokumentationsseite, falls es eine herangezogen hat, und liefert ein Konfidenzsignal und Einschränkungen.
-
Die Berechtigung wird widerrufen. Ein abgefangenes Token kann nach Ende der Anfrage nicht erneut verwendet werden.
Das Entscheidende ist Schritt 4: Das Modell hat Ihre Daten nicht. Es fordert Ausschnitte davon an, und jede Anforderung wird einzeln beurteilt.
Weiterlesen
Abschnitt betitelt „Weiterlesen“Verwandte Themen
Abschnitt betitelt „Verwandte Themen“- Antworten, denen Sie vertrauen können – wie Antworten bewertet und mit Einschränkungen versehen werden
- Analysepfade – verständliche Namen für die Tabellen, nach denen Ihr Team fragt
- Plattformarchitektur – wo KI in der Gesamtplattform sitzt