

Retrieval, Grounding und Analysepfade
„RAG“ bedeutet meist eines: das Korpus in Fragmente zerlegen, in einen Vektorspeicher einbetten und die nächsten Treffer in den Prompt einfügen. PlaidCloud tut das für genau ein Korpus – die Produktdokumentation – und tut es bewusst nicht mit Ihren Daten.
Ihre Tabellen werden live gelesen, in dem Moment, in dem danach gefragt wird, unter Ihren Berechtigungen. Das ist keine Performance-Entscheidung; es macht eine Antwort vertrauenswürdig und eine Zugriffskontrolle aussagekräftig.
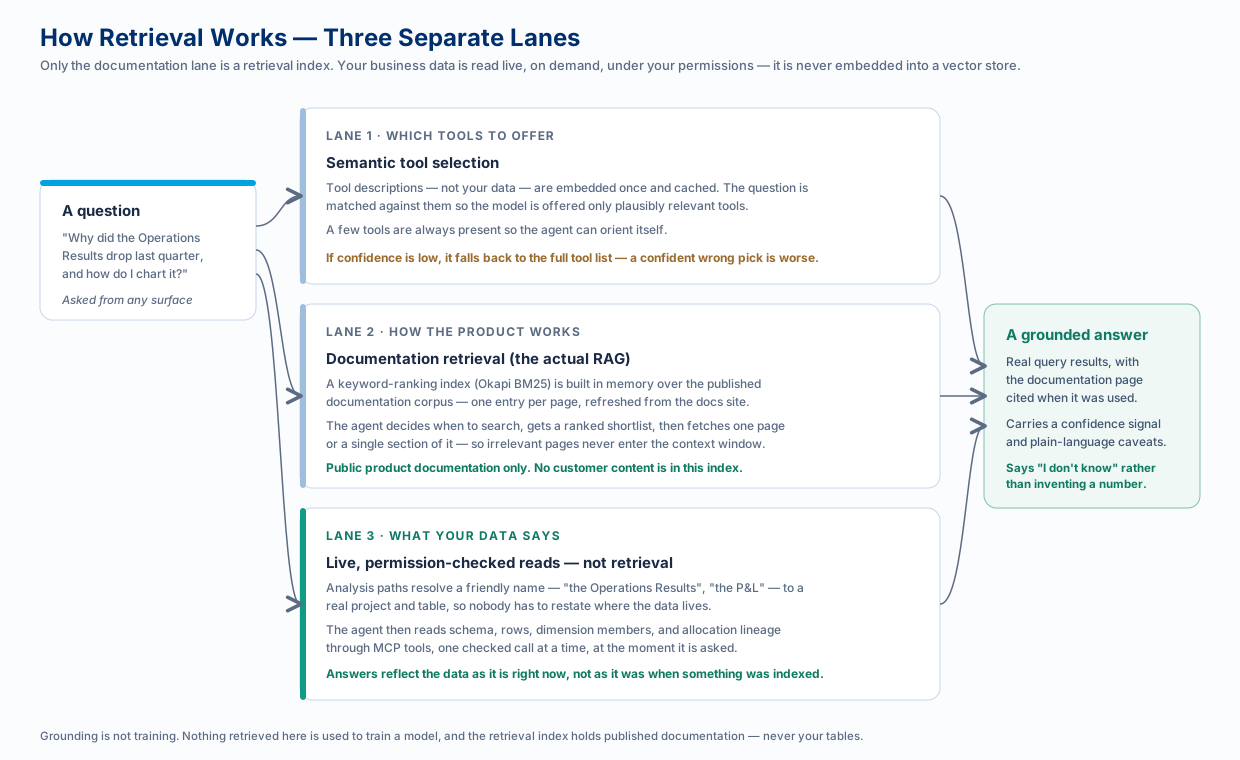
Bahn 1 – Auswahl der anzubietenden Werkzeuge
Abschnitt betitelt „Bahn 1 – Auswahl der anzubietenden Werkzeuge“Diese Bahn läuft für den Assistenten in der App, der einen eigenen Werkzeugkatalog mitbringt. Jede Werkzeugbeschreibung, die er dem Modell zeigt, kostet bei jedem Durchgang Prompt-Token. Bevor das Modell also irgendetwas sieht, wird die Frage per semantischer Ähnlichkeit mit den Werkzeugbeschreibungen abgeglichen – nie mit Ihren Daten – und nur voraussichtlich relevante Werkzeuge werden angeboten.
Auf den anderen Oberflächen übernimmt stattdessen die MCP-Verbindung den Werkzeugkatalog: Der Konnektor von Anthropic verwaltet ihn serverseitig, und die clientseitige Schleife begrenzt die Oberfläche, die sie deklariert. Die Bahnen 2 und 3 unten gelten überall.
Drei Details sind wichtig:
- Die Embeddings beschreiben Werkzeuge, nicht Inhalte. Sie werden einmal aus Werkzeugnamen und -beschreibungen berechnet, zwischengespeichert und automatisch neu aufgebaut, wenn sich eine Beschreibung ändert.
- Einige Werkzeuge sind immer vorhanden, damit sich der Agent orientieren kann – herausfinden, wer fragt und in welchem Projekt – auch wenn die Frage keines von beiden erwähnt.
- Bei geringer Konfidenz wird auf die vollständige Liste zurückgegriffen. Eine sicher falsche Eingrenzung ist schlimmer, als einmal die vollen Token-Kosten zu zahlen, daher zeigt ein unsicherer Treffer einfach alles. Sehr kurze Beiträge („danke“, „ok“) überspringen den Schritt ganz.
Bahn 2 – Fundierung in der Dokumentation
Abschnitt betitelt „Bahn 2 – Fundierung in der Dokumentation“Dies ist der eigentliche Pfad der Retrieval-Augmented Generation, und er beantwortet „Wie mache ich …“, „Was ist …“ und „Wo konfiguriere ich …“.
Die veröffentlichte Dokumentation wird als strukturiertes Korpus abgerufen – ein Eintrag pro Seite – und im Arbeitsspeicher mit Okapi BM25 indiziert, einer Schlüsselwort-Rankingfunktion. Der Agent arbeitet dann in zwei Zügen:
- Suchen liefert eine nach Rang sortierte Kurzliste von Seiten: Slug, Titel, Beschreibung, Score.
- Abrufen holt eine Seite oder einen einzelnen benannten Abschnitt davon, sobald der Agent entschieden hat, welche er tatsächlich braucht.
Der Kern des Entwurfs ist, dass der Agent entscheidet, wann er sucht und wie viel er liest. Passive Einfügung klebt etwas in jeden Prompt, ob es hilft oder nicht; werkzeuggesteuertes Retrieval hält irrelevante Seiten ganz aus dem Kontextfenster heraus und lässt den Agent die verwendete Seite zitieren, damit Sie nachfassen können.
Ist das Dokumentationskorpus kurzzeitig nicht erreichbar, antwortet der Agent ohne es, statt den Durchgang scheitern zu lassen.
Bahn 3 – Lesen Ihrer eigenen Daten
Abschnitt betitelt „Bahn 3 – Lesen Ihrer eigenen Daten“Fragen zu Ihren Zahlen werden überhaupt nicht durch Retrieval beantwortet. Der Agent liest, was er braucht, wenn er es braucht, über berechtigungsgeprüfte Werkzeuge: Tabellenschemas, Zeilen, Dimensionsmitglieder, Workflow- Herkunft, Umlageverfolgungen.
Deshalb sind Antworten aktuell – sie spiegeln die Daten, wie sie jetzt sind, nicht wie sie waren, als zuletzt etwas indiziert wurde – und deshalb funktioniert die Zugriffskontrolle: Es gibt keinen vorab erstellten Index, der über eine Berechtigungsgrenze hinweg durchsickern könnte, denn es gibt keinen Index.
Analysepfade – die Benennungsschicht
Abschnitt betitelt „Analysepfade – die Benennungsschicht“Live-Lesevorgänge müssen wissen, welche Tabelle gemeint ist. Analysepfade sind das gemeinsame Vokabular, das dies mühelos macht: ein verständlicher Name – „Operatives Ergebnis“, „die GuV“, „Mitarbeiterzahl“ – wird einmal einem echten Projekt und einer Tabelle zugeordnet und steht danach allen im Workspace zur Verfügung.
- Fragen Sie nach Namen, statt jedes Mal ein Projekt und eine Tabelle zu nennen.
- Markieren Sie einen als Standard des Workspace, damit eine unspezifische Frage wie „Was hat sich im letzten Quartal geändert?“ an einer sinnvollen Stelle landet.
- Alle meinen dasselbe. Wenn das ganze Team „die GuV“ sagt, erreicht es dieselbe Tabelle.
Ein Administrator registriert sie; jeder kann sie verwenden; jede Frage läuft weiterhin unter den eigenen Berechtigungen der fragenden Person. Sie funktionieren identisch im Assistenten in der App, in Microsoft 365 Copilot und in einem verbundenen Coding-Agent. Wie Sie sie einrichten, lesen Sie unter Analysepfade.
Der Ausdruckskatalog
Abschnitt betitelt „Der Ausdruckskatalog“Wenn der Assistent einen Ausdruck schreibt, rät er Funktionsnamen nicht aus dem Gedächtnis. Er konsultiert einen strukturierten Katalog aller PlaidCloud-Ausdrucksfunktionen – Name, Signatur, Dokumentationslink, Kategorie –, abgeglichen mit den Funktionen, die Ihr Warehouse tatsächlich bereitstellt, mit Vorschlägen für ähnliche Namen, wenn ein Name fast stimmt. Eine Nachschlageoperation, keine Ähnlichkeitssuche, denn bei Funktionsnamen ist „fast richtig“ falsch.
Grounding ist kein Training
Abschnitt betitelt „Grounding ist kein Training“Zwei Dinge, um die man sich berechtigterweise sorgt:
- Nichts, was hier abgerufen wird, trainiert ein Modell. Grounding bringt Informationen in eine einzelne Anfrage. Es ändert keine Modellgewichte, und Ihre Inhalte werden nicht zum Training des Modells von irgendjemandem verwendet.
- Der Retrieval-Index enthält ausschließlich öffentliche Dokumentation. Es werden keine Kundeninhalte darin eingebettet.
Wohin Ihre Daten gelangen – und wie Sie sie innerhalb der Infrastruktur halten, die Sie kontrollieren – steht in Ihr eigenes kontrolliertes LLM verwenden.
Warum das bessere Antworten ergibt
Abschnitt betitelt „Warum das bessere Antworten ergibt“Grounding ermöglicht es dem Assistenten, „Ich weiß es nicht“ zu sagen, statt etwas zu erfinden. Da jede Zahl aus einer echten Abfrage und jede Produktaussage aus einer echten Dokumentationsseite stammt, kann eine Antwort bewertet werden: Jede trägt ein Konfidenzsignal und verständliche Einschränkungen, und eine erzählende Zusammenfassung wird geprüft, damit sie nicht stillschweigend eine Einschränkung weglässt oder eine Zahl nennt, die die Analyse nie erzeugt hat. Siehe Antworten, denen Sie vertrauen können.
Verwandte Themen
Abschnitt betitelt „Verwandte Themen“- Analysepfade – die gemeinsamen Namen einrichten
- Umlagen nachverfolgen – fragen, warum sich ein Ergebnis verändert hat
- KI- und LLM-Architektur – die Oberflächen und der gemeinsame Pfad