

Table Melt (Schritt)
Beschreibung
Abschnitt betitelt „Beschreibung“Dient dazu, kurze, breite Datentabellen in lange, schmale Datentabellen umzuwandeln. Ausgewählte Spalten werden transponiert, wobei die Spaltennamen in Werte über mehrere Zeilen umgewandelt werden.
Am leichtesten lässt sich das vermutlich an einer Datentabelle nachvollziehen, in der Monate als Spaltenüberschriften aufgelistet sind:
Das Entpivotieren dieser Datentabelle würde alle Monatsspalten in Zeilen umwandeln.
Jan/Feb werden zu Zeilen mit Month + Value, identifiziert über die Spalten, die Sie unverändert lassen.Indem Sie festlegen, welche Spalten transponiert werden und welche unverändert bleiben, wird dies zu einem leistungsstarken Werkzeug. In anderen ETL-Tools könnte diese Umwandlung ein Dutzend zusätzliche Schritte erfordern.
Quell- und Zielparameter
Abschnitt betitelt „Quell- und Zielparameter“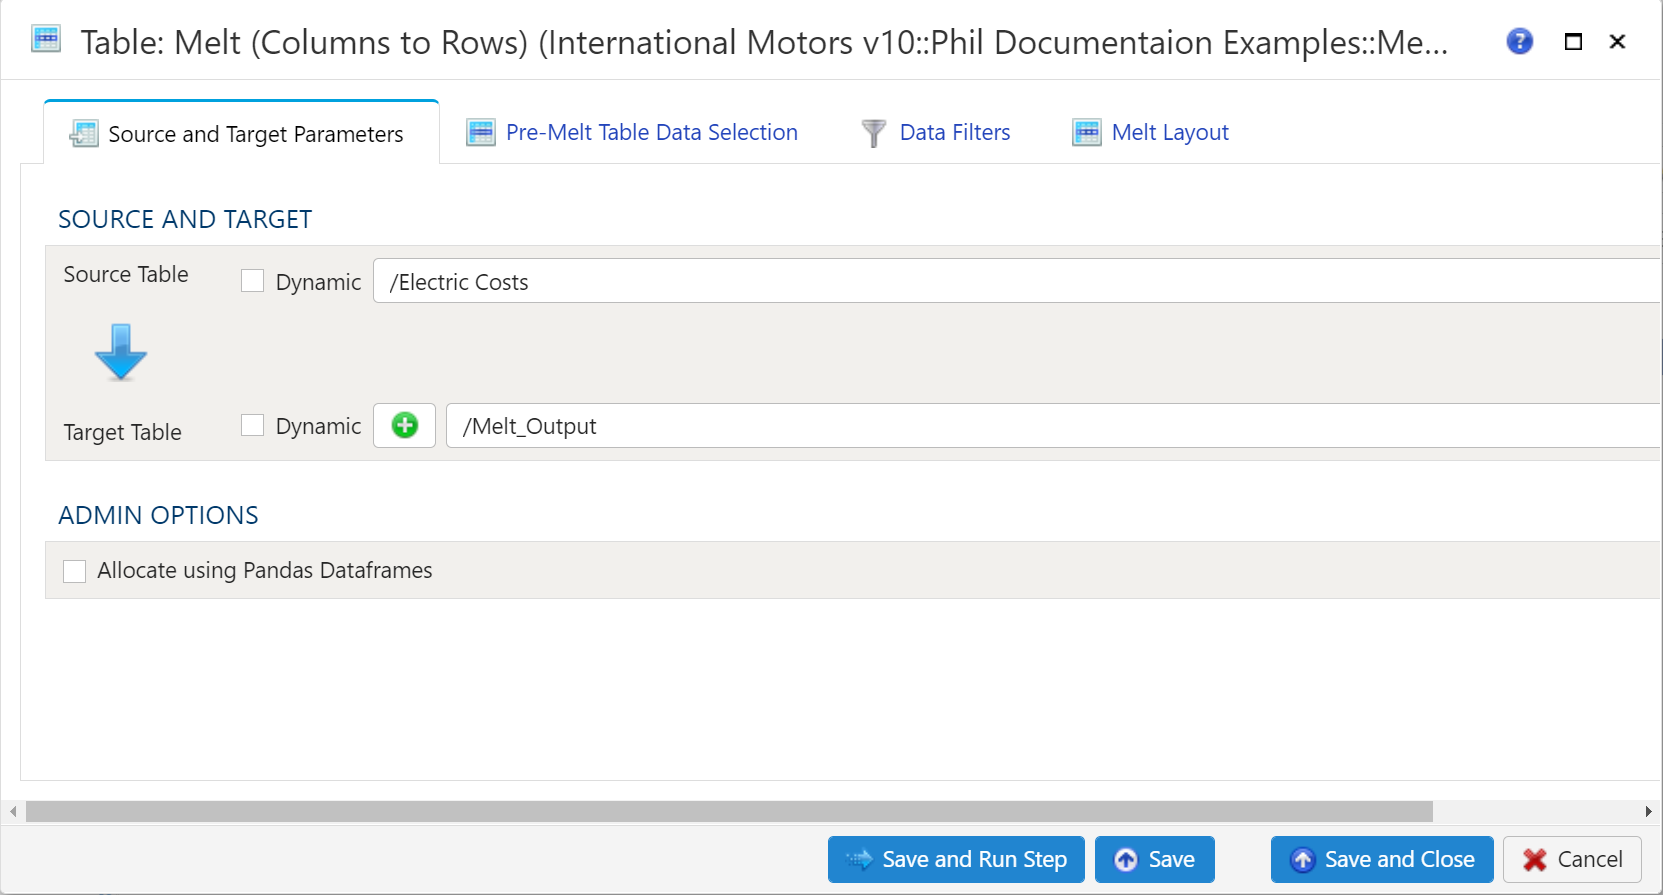
Quelle und Ziel
Abschnitt betitelt „Quelle und Ziel“Um Quelle und Ziel festzulegen, wählen Sie zunächst im Dropdown-Menü Quelltabelle die Datentabelle aus, aus der extrahiert werden soll.
Zieltabelle

Um die Zieltabelle festzulegen, wählen Sie entweder über die Dropdown-Liste Zieltabelle eine vorhandene Tabelle als Ziel oder klicken auf das grüne „+“, um eine neue Tabelle als Ziel zu erstellen.
Tabelle erstellen
Beim Erstellen einer neuen Tabelle können Sie wählen, ob sie als Ansicht oder als Tabelle erstellt wird.
Ansichten:
Ansichten sind nützlich, weil die Ausführungszeit eines Schritts deutlich kürzer ist als bei einer Tabelle. Der Nachteil von Ansichten ist, dass sie sich in der Detailansicht der Tabelle weniger gut zur Datenexploration eignen.
Tabellen:
Wenn eine Tabelle als Ziel verwendet wird, dauert die Ausführung eines Schritts länger, dafür ist die Datenexploration in der Detailansicht deutlich schneller als bei einer Ansicht.
Datenauswahl der Tabelle vor dem Unpivotieren
Abschnitt betitelt „Datenauswahl der Tabelle vor dem Unpivotieren“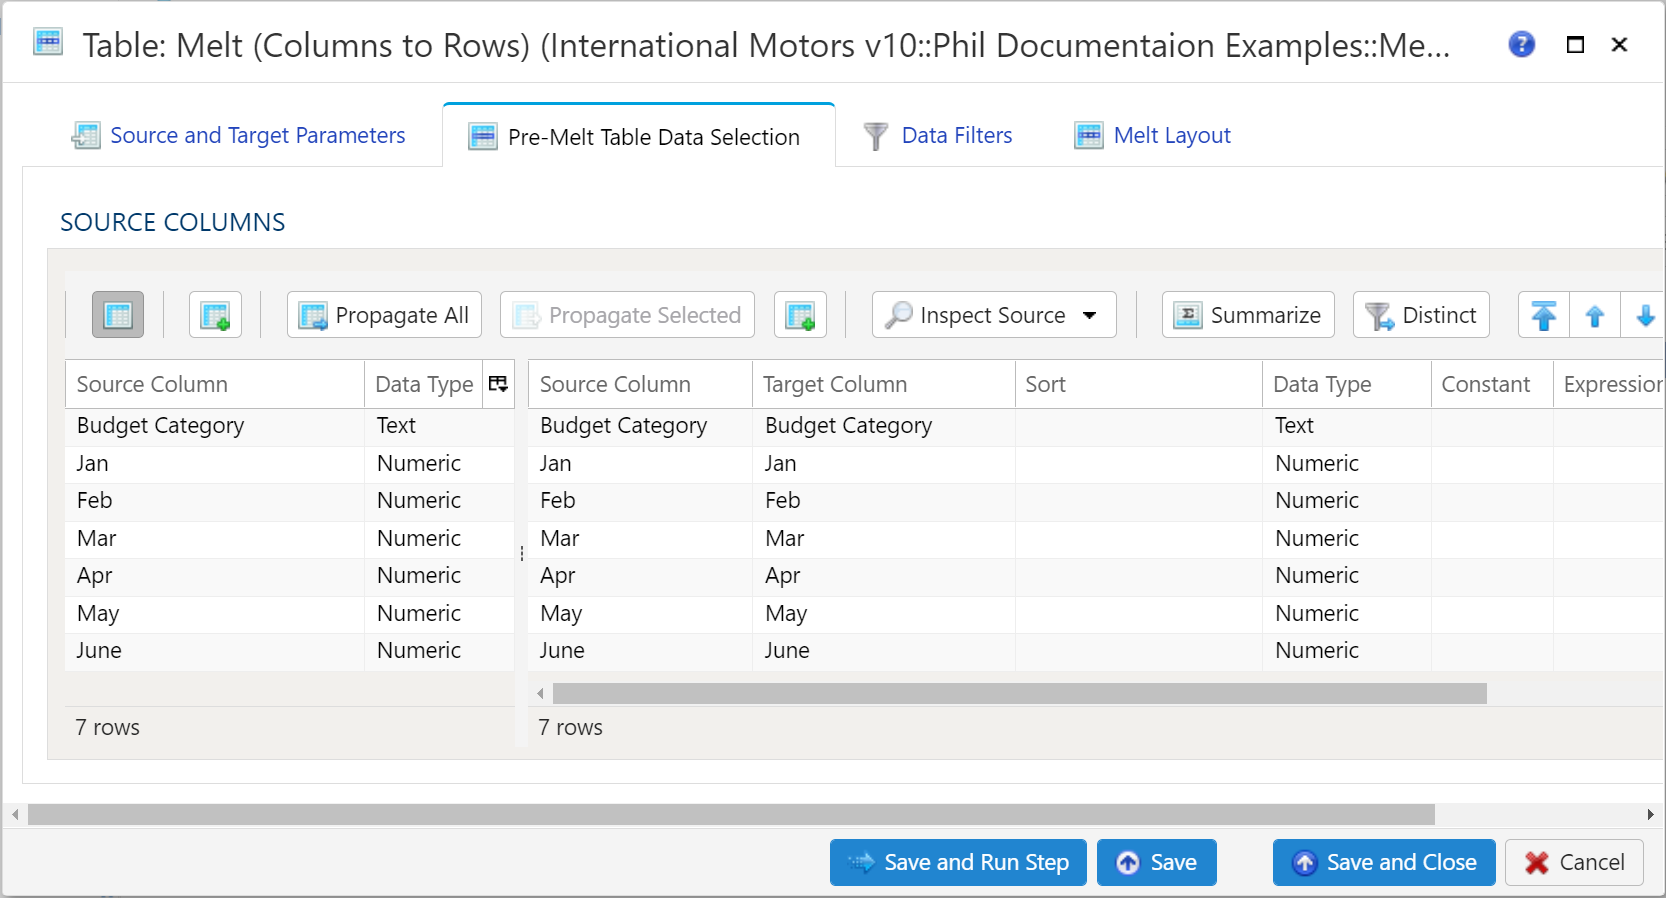
Dieser Abschnitt unterscheidet sich etwas von der üblichen Tabellendatenauswahl. Er legt im Wesentlichen fest, welche Spalten in der Melt-Operation verwendet werden. Dazu gehören ID-Spalten sowie Variablen-/Wertspalten.
Wenn Sie speichern, während eine Quelltabelle gewählt ist, aber keine Quell- oder keine Zielspalten vorhanden sind, wird die leere Seite aus der Quelle gefüllt, so wie es Beide Zuordnungstabellen füllen täte.
Datenfilter
Abschnitt betitelt „Datenfilter“Für maximale Flexibilität sind Datenfilter sowohl für die Quelldaten als auch für die Zieldaten verfügbar. Bei größeren Datensätzen kann es besonders vorteilhaft sein, Zeilen bereits in der Quelle herauszufiltern, sodass die übrigen Operationen auf einem kleineren Datensatz ausgeführt werden.
Teilmenge der Quelldaten auswählen
Abschnitt betitelt „Teilmenge der Quelldaten auswählen“Jeder gültige Python-Ausdruck ist zulässig, um die Daten auf eine Teilmenge einzugrenzen. Weitere Details und Beispiele finden Sie unter Ausdrücke
.
Sekundären Filter auf Ergebnisdaten anwenden
Abschnitt betitelt „Sekundären Filter auf Ergebnisdaten anwenden“Jeder gültige Python-Ausdruck ist zulässig, um die Daten auf eine Teilmenge einzugrenzen. Weitere Details und Beispiele finden Sie unter Ausdrücke.
Endgültige Begrenzung der Datentabelle (Limit)
Abschnitt betitelt „Endgültige Begrenzung der Datentabelle (Limit)“Um die Daten zu begrenzen, aktivieren Sie einfach das Kontrollkästchen Zeilenbegrenzung anwenden und geben Sie dann Folgendes an:
- Zu überspringende Anfangszeilen: Zu überspringende Datenzeilen (die Spaltenüberschriftszeile wird nicht mitgezählt)
- Enden bei Zeile: Letzte einzuschließende Datenzeile. Das ist etwas anderes, als einfach Zeilen am Ende zu zählen, die weggelassen werden
Unpivot-Layout
Abschnitt betitelt „Unpivot-Layout“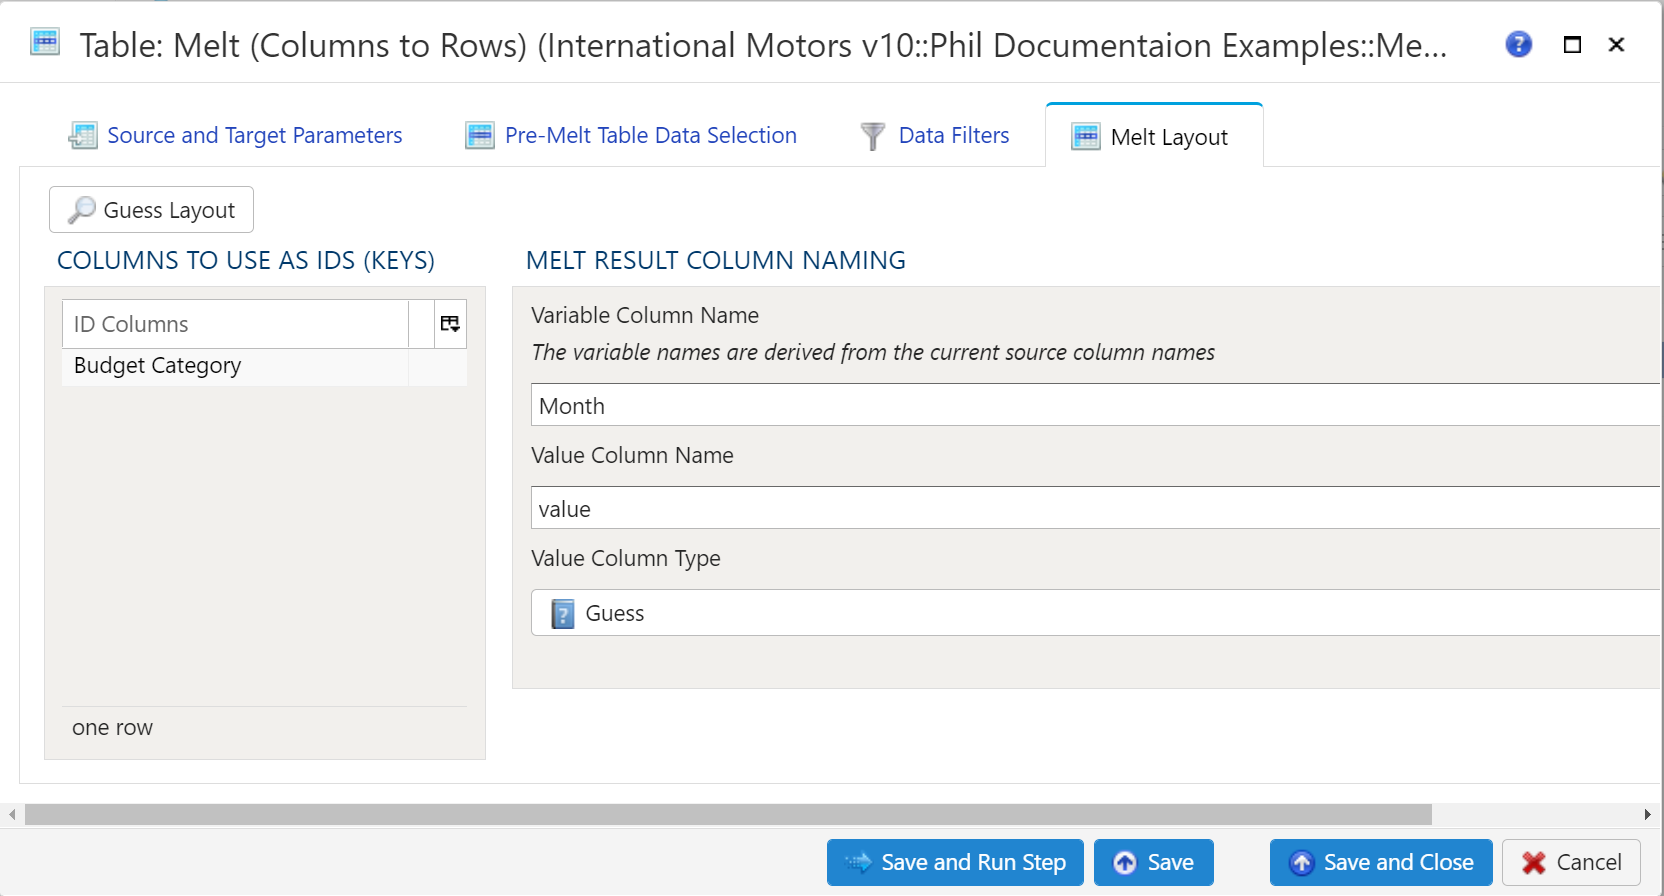
Mit der Schaltfläche Guess Layout kann Analyze einen ersten Versuch bei der Festlegung der ID-Spalten unternehmen. Standardmäßig werden alle Textspalten (Datentyp Zeichenfolge) im Abschnitt Schlüssel platziert. Numerische Spalten werden standardmäßig nicht in Schlüssel platziert, dürfen dort aber je nach Bedarf des Modells stehen.
Als IDs (Schlüssel) zu verwendende Spalten
Abschnitt betitelt „Als IDs (Schlüssel) zu verwendende Spalten“ID-Spalten sind die Spalten, die unverändert bleiben. Diese Spalten werden praktisch für jede Kombination aus Variable und Wert wiederholt. Bei einer Monatstabelle ergäbe das 12 Wiederholungen der ID-Spalten.
ID-Spalten können automatisch oder manuell hinzugefügt werden. Um die Spalten automatisch hinzuzufügen, verwenden Sie die oben erwähnte Schaltfläche Guess Layout. Um weitere Spalten manuell hinzuzufügen, klicken Sie mit der rechten Maustaste an eine beliebige Stelle im Abschnitt und wählen Sie entweder Zeile einfügen oder Zeile anhängen, um eine Zeile vor der aktuell ausgewählten Zeile oder am Ende einzufügen. Geben Sie dann den Namen der Spalte ein, die als ID verwendet werden soll.
Um ein Feld aus den IDs zu entfernen, klicken Sie einfach mit der rechten Maustaste und wählen Sie Löschen.
Benennung der Unpivot-Ergebnisspalten
Abschnitt betitelt „Benennung der Unpivot-Ergebnisspalten“Es sind 2 Werte anzugeben. Beide Werte werden zu Spaltennamen in der Zieldatentabelle.
- Name der Variablenspalte: Wie in der Transformation angegeben, werden die Variablennamen aus den aktuellen Quellspaltennamen abgeleitet. Geben Sie im Wesentlichen einen Spaltennamen an, der die Daten repräsentiert, die ursprünglich durch die Spalten der Quelldatentabelle dargestellt wurden.
- Name der Wertspalte: Geben Sie einen Spaltennamen an, der die Daten repräsentiert, die in der Quelldatentabelle enthalten sind. Typischerweise ist dies eine numerische Einheit: Dollar, Pfund, Grad, Prozent usw.
Zusätzliche Einstellungen
Abschnitt betitelt „Zusätzliche Einstellungen“Weitere Entpivotierungsoptionen enthält diese Felder:
- Auch alle anderen Spalten entpivotieren, die die Tabelle bei der Ausführung hat (
melt_all_columns): entpivotiert zusätzlich jede Spalte, die die Quelltabelle bei der Ausführung des Schritts hat, die der Schritt nicht aufführt und die keine ID-Spalte ist, in der Reihenfolge, in der die Tabelle sie hat. - Name der Positionsspalte (
position_name): schreibt zusätzlich eine Spalte mit diesem Namen, die die 0-basierte Position der Wertspalte jeder Zeile unter den Wertspalten enthält. - Name der Typspalte (
type_name): schreibt zusätzlich eine Spalte mit diesem Namen, die den Datentyp der Wertspalte jeder Zeile enthält, etwainteger,numeric,text,boolean,dateodertimestamp.
Beispiele
Abschnitt betitelt „Beispiele“In der obigen Dokumentation.