

Export to Parquet
Beschreibung
Abschnitt betitelt „Beschreibung“Schreibt eine Projekttabelle als Apache-Parquet-Datei in ein Dokumentenkonto. Parquet speichert Daten spaltenweise statt zeilenweise. Dadurch lassen sich breite Tabellen deutlich besser komprimieren als mit CSV, und ein nachgelagerter Leser kann nur die Spalten laden, die er benötigt.
Das ist in der Regel die richtige Wahl, um große Tabellen an eine Cloud-Datenplattform oder einen Data-Science-Workflow zu übergeben. Typen wie Ganzzahlen, Dezimalzahlen, Datums- und Zeitstempelwerte bleiben erhalten, und eine Spalte mit ganzen Zahlen bleibt eine Ganzzahlspalte, auch wenn einige ihrer Werte leer sind. Kombinieren Sie ihn mit Import Parquet.
Besondere Konfigurationselemente
Abschnitt betitelt „Besondere Konfigurationselemente“Komprimierung
Abschnitt betitelt „Komprimierung“Parquet komprimiert pro Spaltenblock:
- Snappy — am schnellsten zu lesen, mittlere Dateigröße
- Zstandard — kleinere Dateien, erfordert einen Leser ab Zstandard 0.8
Präfix der Zieldatei
Abschnitt betitelt „Präfix der Zieldatei“Wenn der Schritt eine Tabelle in eine einzelne Datei exportiert und der Wert bereits auf .parquet endet, etwa Loadfile1.parquet, wird die Datei genau unter diesem Namen geschrieben. Andernfalls ist der Wert ein Präfix: Jede Tabelle wird als <prefix><table name>.parquet geschrieben.
Eine Datei pro Tabelle
Abschnitt betitelt „Eine Datei pro Tabelle“Parquet-Exporte schreiben eine Datei pro Tabelle. Die Auswahl, mehrere Dateien zu schreiben, wird mit einer entsprechenden Meldung abgelehnt. Heben Sie diese Auswahl auf, um den Export auszuführen.
Wenn die Datei existiert
Abschnitt betitelt „Wenn die Datei existiert“Eine bereits vorhandene Datei (if_exists), unter Wenn die Datei existiert auf der Seite Dateiparameter:
- Überschreiben (
overwrite, Standard) ersetzt eine bereits vorhandene Datei. - Den Schritt fehlschlagen lassen, ohne etwas zu schreiben (
fail) beendet den Schritt, ohne etwas zu schreiben, wenn eine Datei, die er schreiben würde, bereits existiert.
Allgemeine Konfigurationselemente
Abschnitt betitelt „Allgemeine Konfigurationselemente“Dateiauswahl für den Export
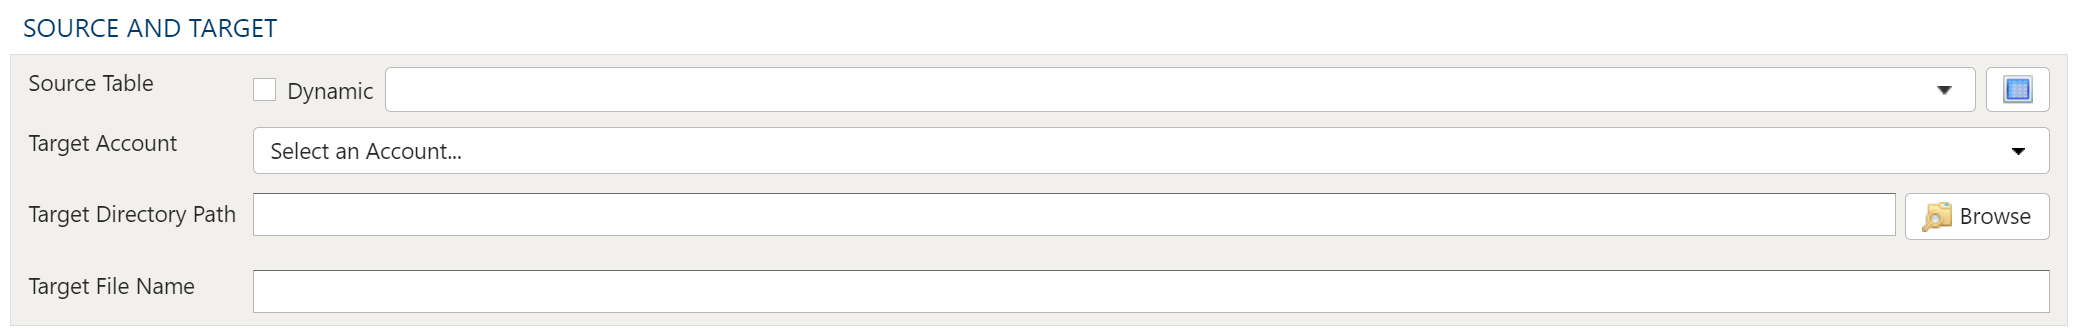
Mit der Dateiauswahl in dieser Transformation wählen Sie ein Ziel in einem PlaidCloud-Dokument, in dem das exportierte Ergebnis gespeichert wird.
Sie wählen ein Verzeichnis und geben einen Dateinamen für die Zieldatei an.
Quelltabelle
Option „Dynamisch“
Mit der Option „Dynamisch“ geben Sie eine Tabelle als Text an, auch mit Variablen. Das ist nützlich bei variablengesteuerten Workflows, in denen sich Verweise auf Tabellen und Ansichten nach den angegebenen Variablen richten.
Ein Beispiel, das die Variable current_month verwendet, um dynamisch auf die Quelltabelle zu verweisen:
legal_entity/inputs/{current_month}/ledger_valuesOption „Statisch“
Wenn eine bestimmte Tabelle als Quelle für den Export dienen soll, lassen Sie das Kontrollkästchen Dynamisch deaktiviert und wählen Sie die Quelltabelle aus.
Der Tabellen-Explorer steht bei jeder Tabellenauswahl zur Verfügung. Klicken Sie auf die Schaltfläche „Tabellen-Explorer“ rechts neben der Tabellenauswahl, um ein Tabellen-Explorer-Fenster zu öffnen.
Dokumentenkonto auswählen
Wählen Sie ein PlaidCloud-Dokumentenkonto, auf das Sie Zugriff haben. Anschließend können Sie in der nächsten Auswahl ein Verzeichnis wählen.
Innerhalb eines Projekts bietet die Liste oben auch Projektstandard an, einen Platzhalter für das Konto, das im Projekt aktuell als Standard festgelegt ist. Ein neuer Schritt wählt „Projektstandard“ vorab aus, wenn das Projekt einen hat. Ein bestehender Schritt behält das Konto, mit dem er gespeichert wurde, bis Sie es ändern. Ein Schritt, der auf „Projektstandard“ steht, wird mit dem Konto ausgeführt, das zum Zeitpunkt der Ausführung der Projektstandard ist. Ist keiner festgelegt, schlägt die Ausführung fehl und nennt das Projekt, anstatt auf ein anderes Konto auszuweichen.
Zielverzeichnispfad
Wählen Sie das Symbol Durchsuchen rechts neben dem Zielverzeichnispfad und navigieren Sie zu dem Speicherort, an dem die Datei gespeichert werden soll.
Zieldateiname
Geben Sie den Namen an, unter dem die exportierte Datei gespeichert werden soll.
Data-Mapper-Konfiguration
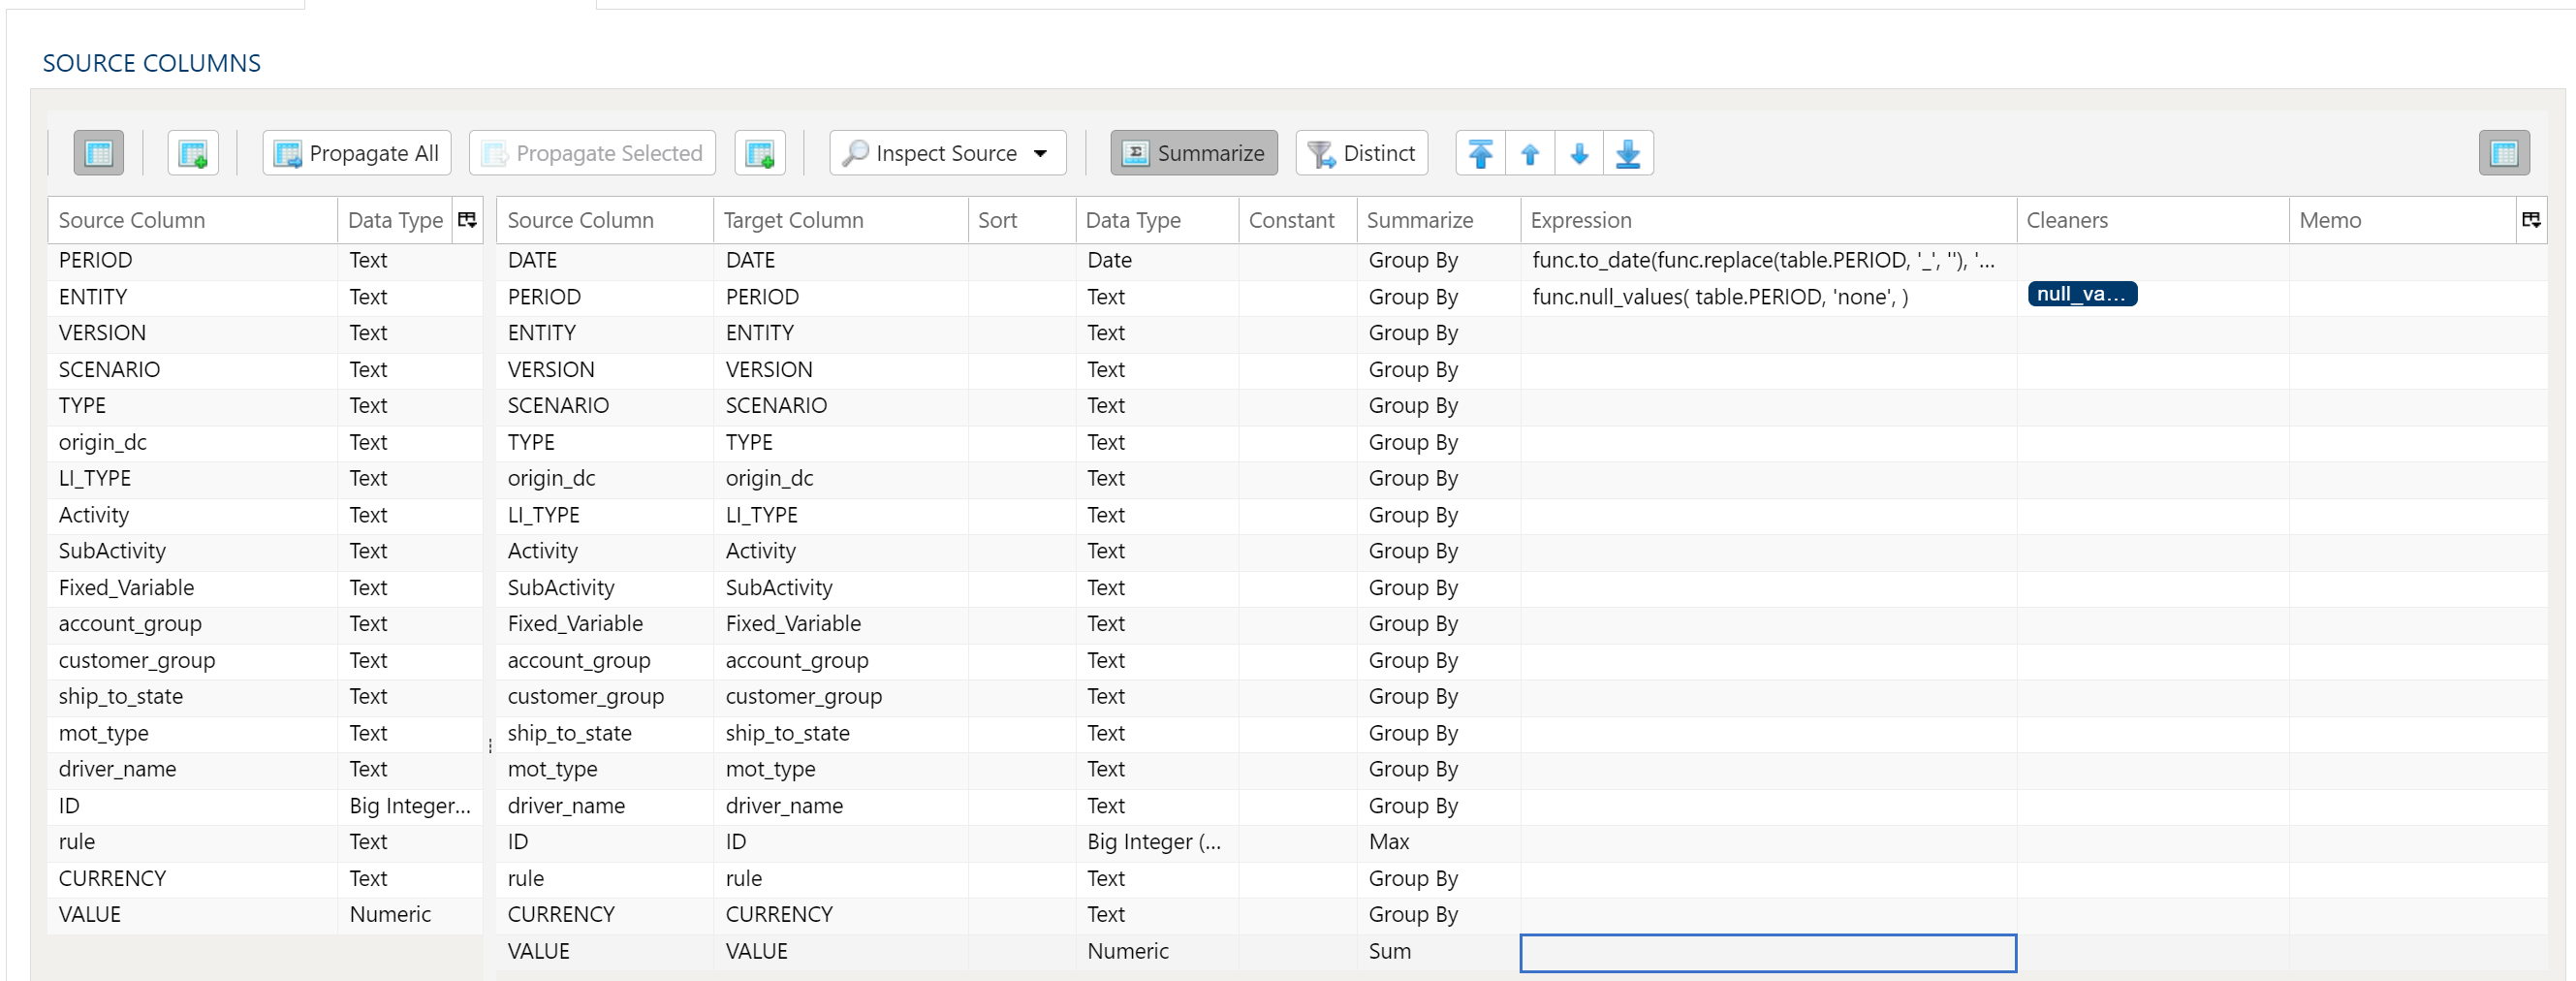
Der Data Mapper ordnet Spalten der Quelldaten der Zieldatentabelle zu.
Untersuchen und Füllen des Mappers
Mit der Menüschaltfläche Quelle untersuchen stehen Ihnen weitere Möglichkeiten zur Verfügung, Spalten von der Quelle dem Ziel zuzuordnen:
- Beide Zuordnungstabellen füllen: Übernimmt alle Werte aus der Quelldatentabelle in die Zieldatentabelle. Dies ist die Standardeinstellung.
- Nur Quellzuordnungstabelle füllen: Ordnet nur alle Werte in der Quelldatentabelle zu. Das ist hilfreich, wenn Sie einen bestehenden Workflow ändern und sich die Spaltenstruktur der Quelle geändert hat.
- Nur Zielzuordnungstabelle füllen: Übernimmt alle Werte nur in die Zieldatentabelle.
Reichen die Optionen für Quell- und Zielspalten nicht aus, können Sie auf verschiedene Weise weitere Spalten in die Zieldatentabelle einfügen:
- Alle übernehmen fügt alle Quellspalten in die Zieldatentabelle ein, unabhängig davon, ob sie dort bereits vorhanden sind.
- Ausgewählte übernehmen fügt nur die ausgewählten Quellspalten ein.
- Klicken Sie mit der rechten Maustaste auf die Zielseite und wählen Sie Zeile einfügen, um direkt über der aktuell ausgewählten Zeile eine Zeile einzufügen.
- Klicken Sie mit der rechten Maustaste auf die Zielseite und wählen Sie Zeile anhängen, um am unteren Ende (ganz rechts) der Zieldatentabelle eine Zeile einzufügen.
Spalten löschen
Um Spalten aus der Zieldatentabelle zu löschen, wählen Sie die gewünschten Spalten aus, klicken Sie mit der rechten Maustaste und wählen Sie Löschen.
Quellspalten, die nicht mehr aufgeführt sind
Eine Zielzeile kann eine Quellspalte benennen, die die Quelldatentabelle nicht mehr aufführt, zum Beispiel nachdem die Quelle erneut untersucht wurde. Der Schritt entfernt eine solche Zeile nie von selbst. Stattdessen wird der Spaltenname rot hinter einem Warnsymbol ⚠ angezeigt, und beim Daraufzeigen erscheint der Hinweis, dass die Spalte nicht in den Quellspalten enthalten ist. Bei einem Schritt mit mehreren Tabellen, etwa einer Union, wird jede Tabelle anhand ihrer eigenen Quellspalten geprüft.
Eine Zeile mit einer Konstante, einem Ausdruck oder einer Zusammenfassung Anzahl (einschließlich Nullwerte) wird nie markiert, da der Schritt ihre Quellspalte nicht liest. Solange die Quelldatentabelle keine Spalten aufführt, wird nichts markiert, zum Beispiel bevor die Quelle zum ersten Mal untersucht wurde.
Wenn Sie einen Schritt speichern, der noch markierte Zeilen enthält, listet ein Dialog Veraltete Spalten gefunden diese unter der Registerkarte oder Tabelle auf, auf der sie sich befinden, und bietet drei Optionen:
- Alle entfernen und speichern — die markierten Zeilen entfernen und anschließend speichern.
- Trotzdem speichern — den Schritt unverändert speichern.
- Abbrechen — zum Schritt zurückkehren, ohne zu speichern.
Um eine Zeile beizubehalten und ihre Warnung zu beseitigen, fügen Sie die Spalte wieder zur Quelldatentabelle hinzu oder wählen Sie eine Spalte, die die Quelldatentabelle aufführt.
Spalten, die in der Quelltabelle fehlen
Beim Speichern wird die Quelldatentabelle selbst in ihrem aktuellen Zustand geprüft. Wenn der Schritt in seinen Quellspalten eine Spalte aufführt, die die Tabelle nicht hat, etwa weil ein früherer Schritt sie umbenannt oder entfernt hat, sind die Spalten des Schritts veraltet, und ein Schritt, der eine solche Spalte liest, schlägt bei der Ausführung fehl. Beim Speichern öffnet sich dann der Dialog Fehlende Quellspalten, der jede Tabelle und die dort fehlenden Spalten nennt. Sie haben zwei Möglichkeiten:
- Trotzdem speichern – Speichert den Schritt unverändert.
- Abbrechen – Kehrt zum Schritt zurück, ohne zu speichern.
Es wird nichts für Sie entfernt, denn möglicherweise liegt der Fehler in der Tabelle, und sie kann sich vor der Ausführung des Schritts erneut ändern. Sind zusätzlich Zeilen als nicht mehr aufgeführt markiert, erscheinen beide Hinweise gemeinsam im Dialog Veraltete Spalten gefunden, und Alle entfernen und speichern entfernt nur die markierten Zeilen. Solange die Liste der Quellspalten leer ist, werden stattdessen die Spalten geprüft, die der Schritt zuordnet. Ausgenommen sind Zeilen mit einer Konstante, einem Ausdruck oder einer Zusammenfassung Anzahl (einschließlich Nullwerte), da sie keine Spalte lesen.
Eine mit einer Variablen benannte Quelle, etwa {year}/Sales, wird so geprüft, wie die Variable beim Speichern gesetzt ist, und der Dialog nennt die geprüfte Tabelle, etwa 2026/Sales (from {year}/Sales). Eine Variable, die von einer Schleife gesetzt wird, enthält den Wert der letzten Iteration. Bei einer Schleife über Tabellen unterschiedlicher Struktur kann daher eine Warnung zu einer Tabelle erscheinen, die die nächste Ausführung gar nicht liest. Nicht geprüft werden eine Tabelle, die noch nicht existiert, zum Beispiel weil ein früherer Schritt im Workflow sie erstellt, eine Quelle, deren Variable keinen Wert hat, eine Tabelle, die der Schritt erst bei der Ausführung per Suche findet, sowie eine Tabelle, die im Moment nicht gelesen werden kann.
Spaltendatentyp
Jede Zielspalte hat einen Typ. Eine aus der Quelle übernommene Spalte behält den Typ der Quellspalte; eine von Hand hinzugefügte Zeile beginnt als Text, und Sie legen den Typ fest, den sie tatsächlich haben soll — eine Spalte, die Sie summieren oder sortieren möchten, benötigt ihren numerischen Typ oder Datumstyp, denn Text wird als Text sortiert und summiert.
Ein Schritt, der mit einer Spalte ohne jeden Typ gespeichert wurde, wird trotzdem ausgeführt. Der Typ wird beim Start des Schritts anhand der Quellspalte ermittelt, die diese Spalte liest. Gibt es nichts, woraus er sich ablesen ließe, wird er als Text behandelt: Die Spalten eines Schritts SQL extrahieren stammen aus der von Ihnen geschriebenen Abfrage und nicht aus einer zugeordneten Quelle, und wenn mehrere Quellen dieselbe Spaltenbezeichnung mit unterschiedlichen Typen führen, wird Text verwendet, statt einen davon zu erraten — eine falsche Vermutung führt zu einer Konvertierung, die das Warehouse ablehnen kann, und alles lässt sich in Text umwandeln.
Den Typ selbst festzulegen ist weiterhin der Weg, um zu bestimmen, was eine Spalte sein soll. Lassen Sie ihn leer, übernehmen Sie, was auch immer die Quellspalte gerade ist.
Spaltenreihenfolge ändern
Um Spalten in der Zieldatentabelle neu anzuordnen, wählen Sie die gewünschten Spalten aus. Dazu haben Sie zwei Möglichkeiten:
- Pfeile für Massenverschiebung: Wählen Sie die gewünschte Verschiebeoption über die Pfeile oben rechts aus.
- Kontextmenü: Klicken Sie mit der rechten Maustaste und wählen Sie An den Anfang verschieben, Nach oben, Nach unten oder An das Ende verschieben.
Ergebnis auf eindeutige Datensätze beschränken
Um nur eindeutige Werte zurückzugeben, wählen Sie die Menüoption Eindeutig. Dadurch wird für jede Spalte der Quelle ein Kontrollkästchen eingeblendet. Aktivieren Sie einfach das Kontrollkästchen neben der jeweiligen Spalte, um nur eindeutige Ergebnisse zurückzugeben.
Je nach Situation kann es sinnvoll sein, stattdessen eine Zusammenfassung in Betracht zu ziehen.
Beim Eindeutig-Verfahren bleibt der erste gefundene eindeutige Datensatz erhalten, die übrigen werden verworfen. Wenn Konsistenz zwischen den Ausführungen wichtig ist, sollten Sie die Daten sortieren.
Aggregation und Gruppierung
Um Ergebnisse zu aggregieren, wählen Sie die Menüoption Zusammenfassen. Dadurch wird für jede Spalte in der Zieldatentabelle ein Auswahlfeld eingeblendet. Wählen Sie für jede Spalte eine geeignete Zusammenfassungsmethode aus.
Wenn Quelle untersuchen die Spalten füllt, beginnt eine Zahlenspalte als Gruppieren nach statt als Summe, wenn ihr Name wie ein Bezeichner aussieht, etwa id, customer_id, Order No oder CustomerKey, wenn ihre Tabelle sie als Schlüssel festlegt oder wenn der Join sie als Schlüssel verwendet.
- Gruppieren nach
- Summe
- Min
- Max
- Erster
- Letzter
- Anzahl
- Anzahl (einschließlich Nullwerte)
- Mittelwert
- Standardabweichung
- Stichproben-Standardabweichung
- Grundgesamtheits-Standardabweichung
- Varianz
- Stichprobenvarianz
- Grundgesamtheitsvarianz
- Erweitert ohne Gruppierung
Informationen zur erweiterten Nutzung des Data Mappers, etwa zu Ausdrücken, Bereinigung und Konstanten, finden Sie unter Erweiterte Nutzung des Data Mappers

Für maximale Flexibilität stehen Datenfilter sowohl für die Quelldaten als auch für die Zieldaten zur Verfügung. Bei größeren Datensätzen kann es besonders vorteilhaft sein, Zeilen bereits in der Quelle herauszufiltern, sodass die übrigen Operationen auf einem kleineren Datensatz ausgeführt werden.
Teilmenge der Daten auswählen
Mit diesem Filtertyp filtern Sie die eingehenden Quelldaten anhand der angegebenen Bedingungen.
Sekundären Filter auf Ergebnisdaten anwenden
Mit diesem Filtertyp wenden Sie anhand der angegebenen Bedingungen einen Filter auf die Ergebnisdaten nach der Transformation an. Dadurch können Zeilen anhand der Ergebnisse komplexer Berechnungen, Zusammenfassungen oder Fensterfunktionen ausgeschlossen werden.
Zeilenbegrenzung der endgültigen Datentabelle (Limit)
Mit der Zeilenbegrenzung schränken Sie die Zeilen im Ergebnis anhand eines Bereichs und eines Startpunkts ein.
Filtersyntax
Die Filtersyntax nutzt Python SQLAlchemy und entspricht damit der Syntax anderer Ausdrücke.
Beispiele und Ausdrucksfunktionen finden Sie im Bereich Ausdrücke.