

Table Upsert 步骤
在一次操作中同时完成插入和更新,以您指定为匹配键的一列或多列为依据。对于源中的每一行:如果目标中存在匹配的行(键值相同),则更新该行;否则插入新行。
当增量数据流同时包含新记录和对现有记录的修订时,请使用此步骤,例如销售更新、员工记录变更,或任何“始终反映最新状态”的场景。请谨慎指定匹配列:键值相同但其他列不同的行会被覆盖,因此键选择不当可能会悄无声息地破坏数据。
更新插入参数
Section titled “更新插入参数”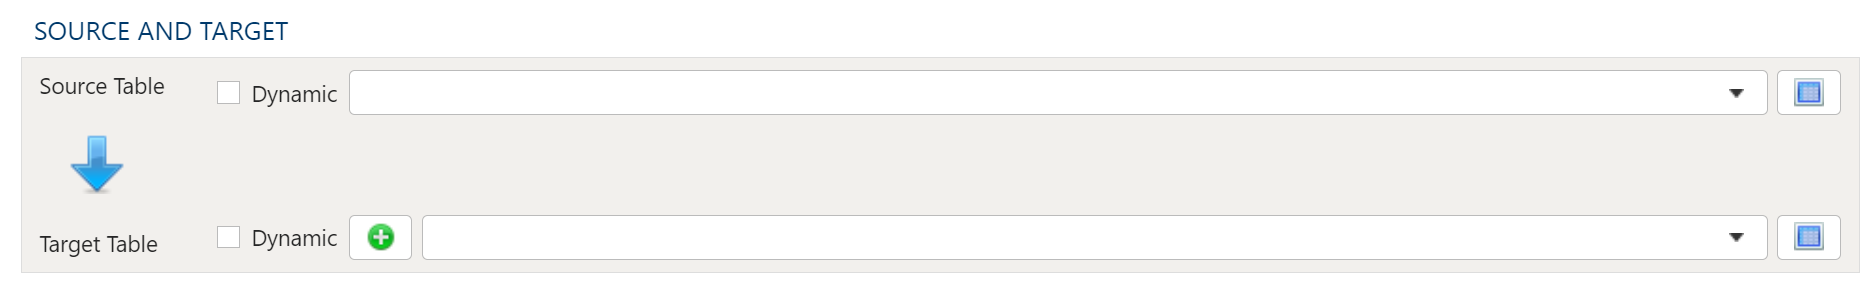
要确定源表和目标表,首先使用 源表 下拉菜单选择要从中提取数据的数据表。然后使用 目标表 下拉菜单选择一个现有的表作为目标表。
步骤运行时
Table Extract、Table Lookup、Table Inner Join、Table Cross Join、Table Outer Join、Table Anti Join、多表联接、Table Union Distinct、Table Union All、Table Pivot、Table Melt、Table In-Place Delete、Table Upsert 和 Table Append 步骤在运行时、写入任何内容之前,会检查其源表。该检查会将步骤构建的查询与每个源表此刻的状态进行比较:
- 步骤读取的列在表中不存在、联接键在表中不存在或不在步骤的源列中,或者步骤读取的源表尚未构建,都会使步骤停止。一条错误会列出每个问题及各自的修复方法。已存在的目标表保持原样,步骤需要新建的目标表则保持为空。
- 步骤列出但并不读取、且表中已不存在的列,只会增加一条警告。步骤会在没有该列的情况下运行。
- 对于尚未构建的源表,Table Union Distinct 和 Table Union All 是例外:它们会像以前一样跳过该表且不发出警告,并合并其余的表。如果其源表均未构建,它们会以警告结束,而不是失败。
目标为视图的步骤只会创建该视图,因此只有在仓库本来就会拒绝创建该视图时,才会根据其表检查步骤列出的列和联接键。其他情况下,只有尚未构建的源表或步骤未列出的联接键会使步骤停止,也不会添加警告。
只要可能,错误会指明构建该表的步骤;如果表中有一列的名称与缺失的列相近,例如仅大小写不同,也会指明该列。
源表数据选择
Section titled “源表数据选择”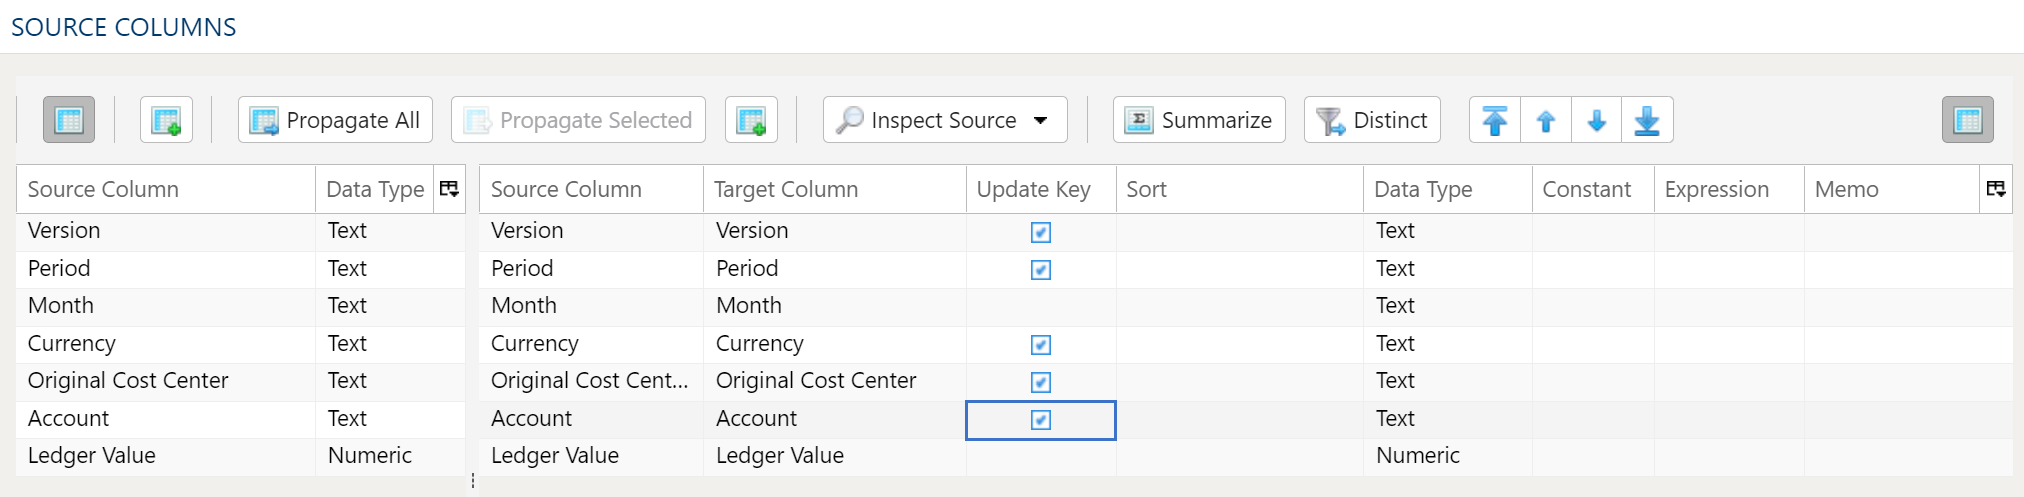
数据映射器用于将源数据中的列映射到目标数据表。
检查并填充映射器
Section titled “检查并填充映射器”使用 检查源 菜单按钮可以通过更多方式将列从源映射到目标:
- 填充两个映射表:将源数据表中的所有值传播到目标数据表。这是默认设置。
- 仅填充源映射表:仅映射源数据表中的所有值。当源列结构发生变化而需要修改现有工作流时,这很有用。
- 仅填充目标映射表:仅将所有值传播到目标数据表。
如果源列和目标列选项不够用,还可以通过几种方式向目标数据表中添加其他列:
- 全部传播 会把所有源列插入目标数据表,无论它们是否已存在。
- 传播所选项 仅插入所选的源列。
- 在目标一侧右键单击并选择 插入行,可在当前所选行的正上方插入一行。
- 在目标一侧右键单击并选择 追加行,可在目标数据表的底部(最右侧)插入一行。
要从目标数据表中删除列,请选择所需的列,然后右键单击并选择 删除。
要重新排列目标数据表中的列,请选择所需的列。您可以使用以下任一方式:
- 批量移动箭头:从右上角的箭头中选择所需的移动选项
- 上下文菜单:右键单击并选择 移到顶部、上移、下移 或 移到底部。
将结果缩减为仅非重复记录
Section titled “将结果缩减为仅非重复记录”要仅返回非重复选项,请选择 非重复 菜单选项。这会为源中的每一列切换出一组复选框。只需勾选相应列旁边的任意复选框,即可仅返回非重复结果。
根据具体情况,您可能需要考虑改用汇总。
非重复处理会保留找到的第一条唯一记录,并丢弃其余记录。如果需要在多次运行之间保持一致,您可能需要对数据应用排序。
目标列网格中有一个 更新键 列,紧跟在目标列的名称之后。在共同标识一行的那些列上勾选它:源行的键值与目标中已有某行匹配时,会更新该行,其他任何源行则会被插入。
每一列最初都被勾选,因此请取消勾选不属于键的列。没有更新键设置的列(刚由填充添加的列,或通过 API 保存而未带该设置的列)视为键。至少必须保持勾选一列。
目标表中缺少的目标列
Section titled “目标表中缺少的目标列”Upsert 会按目标表的现状在其中更新和插入行,从不向表中添加列,因此如果某个 目标列 在表中不存在,运行就会失败。步骤打开时,以及每次选择其他目标表时,表单都会读取目标表的列,并用工作流的变量填入表名中的任何变量。表中不存在的每个 目标列 都会显示为红色,并在前面加上 ⚠ 警告标志;将鼠标悬停在其上,会提示 列“region”不在目标表中。 比较名称时不区分大小写,因此 Region 与 region 匹配。源列中已不再列出的 源列(例如重新检查源之后)也会显示同样的标记,并提示 列“region”不在源列中。
目标表尚不存在时(运行会根据映射创建该表),或者无法读取其列时,不会标记任何内容。映射中省略的表列不会被标记,但服务器仍会拒绝保存该步骤,如保存时会检查什么中所述。
保存带有以这种方式标记的 目标列 的步骤时,发现过时列 对话框会在 列 下方列出已标记的行,置于 以下行指定的列无法被该步骤使用: 这一提示之后,并以 在将目标表缺少的列添加到该表或移除这些行之前,无法保存该步骤。 结尾。它提供两个选项:
- 全部移除并保存 — 移除每个已标记的行,使这些列不再加载,然后保存。
- 取消 — 返回步骤,不保存。
这里没有 仍然保存,因为服务器会拒绝保存指定了现有目标表中不存在的列的映射。要保留某一行,请将其列添加到目标表,然后再次保存该步骤。例外情况是以变量命名的目标表,例如 {year}/Customers:服务器会将该检查留到运行时进行,因此对话框仍会提供 仍然保存。如果行仅因其 源列 而被标记,对话框会提供 全部移除并保存、仍然保存 和 取消。
源数据筛选器
Section titled “源数据筛选器”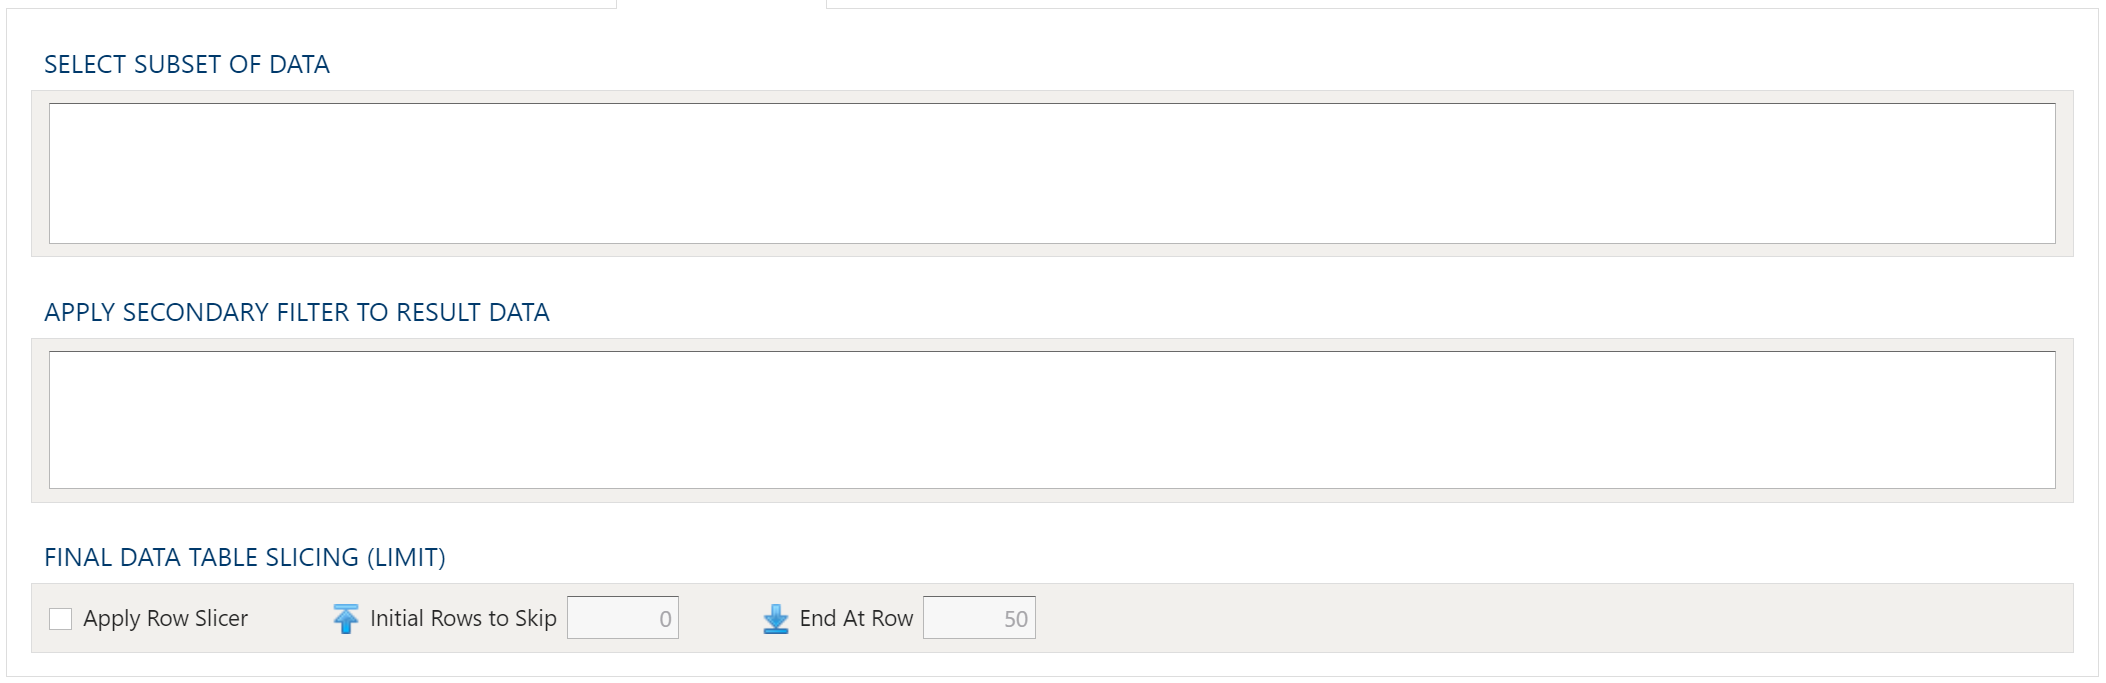
为了获得最大的灵活性,源数据和目标数据都可以使用数据筛选器。对于较大的数据集,在源端筛选掉部分行尤其有益,这样后续操作只需处理较小的数据集。
选择数据子集
此筛选器类型用于根据指定条件筛选传入的源数据。
对结果数据应用二次筛选器
此筛选器类型用于根据指定条件对转换后的结果数据应用筛选器。 对转换后的结果应用筛选器,可以基于复杂计算、汇总或窗口函数的结果进行排除。
最终数据表切片(限制)
行切片功能可根据范围和起始点限制结果集中的行数。
筛选器语法
筛选器语法使用 Python SQLAlchemy,与其他表达式的语法相同。
有关示例和表达式函数,请参阅表达式部分。
保存时会检查什么
Section titled “保存时会检查什么”- 至少一个更新键。 否则保存会被拒绝,并提示 At least one target column must be marked as Update Key.
- 映射与现有目标表一致。 当目标表已存在时,步骤必须映射它的每一列,不得映射表中没有的列,并为每一列使用该表的类型,这样 upsert 就不会丢弃表中的某列及其数据,也不会更改某列的类型。数值和货币视为相同类型。拒绝信息会指出每个差异,例如 The target columns must match the existing target table ‘customers’. The table has columns the step doesn’t map: region. 尚不存在的目标表,或用变量命名的目标表,会在步骤运行时检查。保存之前,列 选项卡就会标出表中没有的列;除非该表以变量命名,否则保存时只会提供移除该列所在行的选项。请参阅目标表中缺少的目标列。
- 空映射会自动为您填充。 在已选择源表但没有源列或目标列的情况下保存,会根据源填充空的一侧,效果与 填充两个映射表 相同。