

检索、依据与分析路径
“RAG”通常指同一件事:将语料库切成片段,嵌入向量存储,然后把最接近的匹配结果粘贴到提示词中。PlaidCloud 只对一个语料库这样做,即产品文档,并且有意不对您的数据这样做。
您的表是在被询问的那一刻,在您的权限下实时读取的。这不是出于性能考虑的决定,而是让答案值得信赖、让访问控制真正有意义的原因。
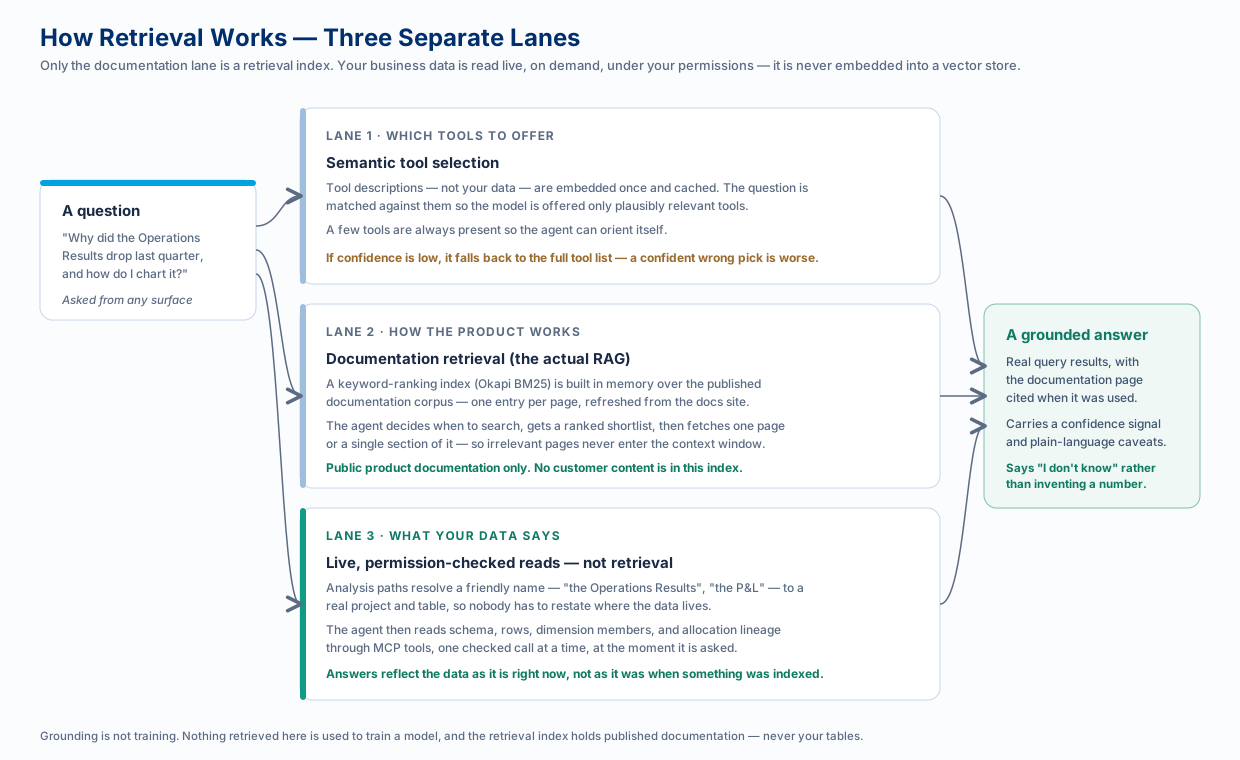
通道 1:选择提供哪些工具
Section titled “通道 1:选择提供哪些工具”此通道针对应用内助手运行,它带有自己的工具目录。它向模型展示的每条工具描述,在每一轮都会消耗提示词令牌,因此在模型看到任何内容之前,会先将问题与工具描述(绝不是您的数据)按语义相似度进行匹配,只提供可能相关的工具。
在其他入口上,工具目录改由 MCP 连接处理:Anthropic 的连接器在服务器端管理,而客户端循环会限制其声明的工具范围。下面的通道 2 和通道 3 适用于所有入口。
有三个细节值得注意:
- 嵌入描述的是工具,而不是内容。 它们由工具名称和描述一次性计算并缓存,描述变化时会自动重建。
- 始终提供少数几个工具,使代理能够自行确定方位,即弄清楚是谁在提问、在哪个项目中,即使问题两者都没有提到。
- 置信度低时回退到完整列表。 自信地收窄错误比一次性支付完整的令牌成本更糟,因此不确定的匹配会直接展示全部工具。非常简短的轮次(“谢谢”“好的”)会完全跳过此步骤。
通道 2:以文档为依据
Section titled “通道 2:以文档为依据”这是真正的检索增强生成路径,用于回答“我该如何…”“什么是…”和“在哪里配置…”。
已发布的文档会作为结构化语料库获取,每页一个条目,并使用关键词排序函数 Okapi BM25 在内存中建立索引。然后代理分两步工作:
- 搜索返回按排名排列的页面候选清单:slug、标题、描述、得分。
- 获取在代理确定实际需要哪一页之后,拉取一整页,或其中某个指定的小节。
设计要点在于由代理决定何时搜索以及读取多少。被动注入会不管有没有帮助都往每个提示词里粘贴内容;由工具驱动的检索则完全不让无关页面进入上下文窗口,并让代理引用它所使用的页面,方便您继续追问。
如果文档语料库暂时无法访问,代理会在没有它的情况下作答,而不是让这一轮失败。
通道 3:读取您自己的数据
Section titled “通道 3:读取您自己的数据”关于您自己的数字的问题完全不通过检索来回答。代理在需要时,通过经过权限检查的工具读取所需内容:表架构、数据行、维度成员、工作流谱系、分摊追踪。
这就是答案始终是最新的原因,它们反映的是数据当前的状态,而不是上次建立索引时的状态;这也是访问控制能够生效的原因:不存在可能跨越权限边界泄露的预先构建的索引,因为根本没有索引。
分析路径:命名层
Section titled “分析路径:命名层”实时读取需要知道是哪一张表。分析路径是让这件事变得轻松的共享词汇:一个易记的名称,例如“运营结果”“损益表”“人员编制”,一次性映射到真实的项目和表,此后工作区中的每个人都可以使用。
- 按名称提问,而不必每次都指明项目和表。
- 将其中一个标记为工作区默认值,使未指定目标的“上个季度发生了什么变化?”落到合理的位置。
- 每个人所指相同。 当整个团队都说“损益表”时,大家访问的是同一张表。
由管理员注册,任何人都可以使用,每个问题仍然在提问者自己的权限下运行。它们在应用内助手、Microsoft 365 Copilot 和已连接的编码代理中的工作方式完全相同。如何设置,请参见分析路径。
助手在编写表达式时,不会凭记忆猜测函数名称。它会查阅包含每个 PlaidCloud 表达式函数的结构化目录,包括名称、签名、文档链接和类别,并与您的数据仓库实际提供的函数进行交叉核对,名称接近正确时还会给出相近匹配的建议。这是查找,而不是相似度搜索,因为对于函数名称来说,“差不多对”就是错。
依据不等于训练
Section titled “依据不等于训练”人们有理由担心两件事:
- 这里检索到的任何内容都不会用于训练模型。 依据只是把信息放入一次请求中,它不会改变模型权重,并且您的内容不会被用于训练任何人的模型。
- 检索索引只包含公开文档。 没有任何客户内容被嵌入其中。
您的数据实际会去往何处,以及如何将其保留在您控制的基础设施内,请参见使用您自己控制的 LLM。
为什么这样能得到更好的答案
Section titled “为什么这样能得到更好的答案”有了依据,助手才能说“我不知道”,而不是凭空编造。由于每个数字都来自真实的查询,每个产品说法都来自真实的文档页面,答案就可以被分级:每个答案都带有置信度信号和通俗易懂的注意事项,并且会检查叙述性摘要,使其不会悄悄漏掉某项限制,也不会引用分析从未产生过的数字。请参见可信赖的答案。
- 分析路径:设置共享名称
- 追踪分摊:询问结果为什么发生变化
- AI 与 LLM 架构:各个入口和共用路径