

LLM 提供商与连接
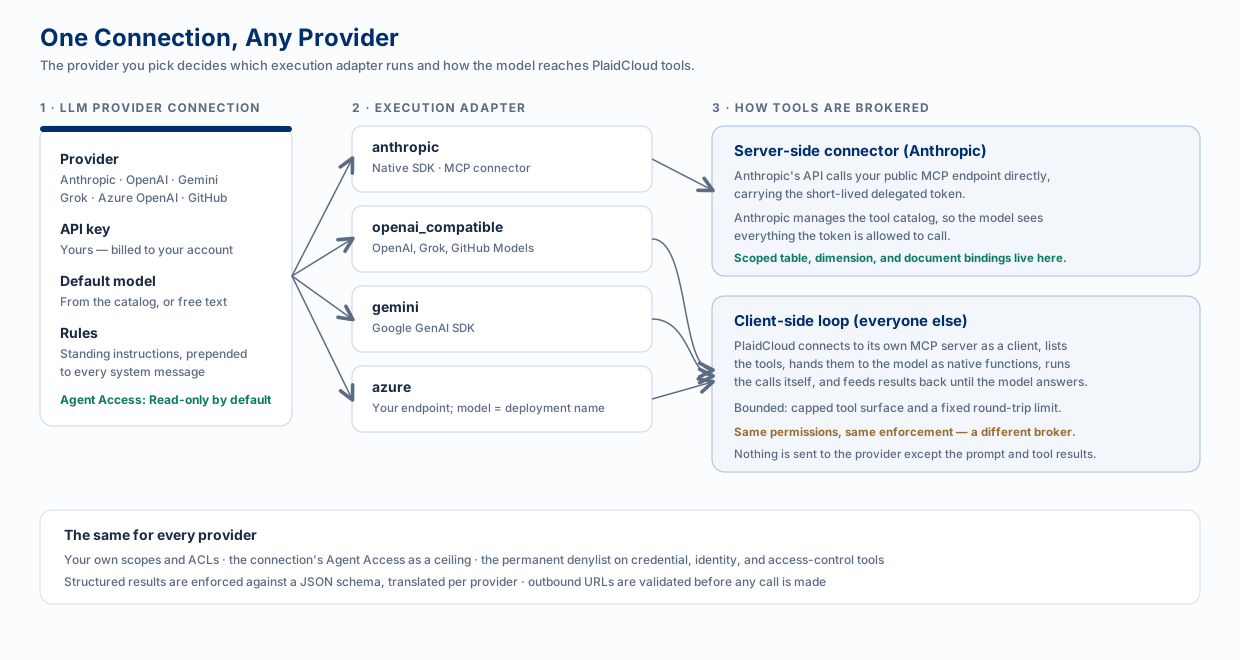
LLM 提供商连接用于选择为工作区中的 AI 提供支持的模型。它保存提供商、您的 API 密钥、默认模型和固定指令,也是管理员决定模型可以做多少事情的位置。
连接包含的内容
Section titled “连接包含的内容”| 字段 | 作用 |
|---|---|
| 提供商 | Anthropic、OpenAI、Google Gemini、xAI Grok、Azure OpenAI 或 GitHub Models。 |
| API 密钥 | 您自己的密钥。费用计入您在该提供商处的账户,不会通过 PlaidCloud 转售。 |
| 默认模型 | 从提供商自己当前的模型列表中选择,该列表使用您的 API 密钥获取。其他… 接受您输入的模型 ID,适用于列表中没有的任何模型。 |
| 基础 URL | 仅对读取该值的提供商显示:Azure OpenAI 必填(您的资源端点),OpenAI、Grok 和 GitHub Models 可选,用于覆盖默认值。Anthropic 和 Gemini 不使用。 |
| API 版本 | 仅限 Azure OpenAI。 |
| 规则 | 添加在每条系统消息前面的固定指令,例如内部约定、语气,以及绝对不能做的事。 |
| 代理访问 | 使用此连接的代理和步骤可执行操作的上限。除非调高,否则为只读。 |
名称、备注以及谁可以看到该连接也在此处设置,您可以使用测试连接在正式使用之前检查密钥。
一个工作区可以有多个连接,其中一个标记为默认。当工作流步骤需要使用与工作区默认值不同的模型时,可以指定使用某个特定连接。
工作区中可能还有较早的 Anthropic Claude 连接,它来自提供商成为单一连接类型的字段之前。它保存相同的设置,并在相同的编辑器中打开,只是提供商固定为 Anthropic。请将新连接创建为 LLM 提供商。
提供商与适配器
Section titled “提供商与适配器”六个面向用户的提供商对应四种执行适配器。适配器决定请求的构造方式以及模型可以访问的内容。下面的提供商名称是连接表单下拉列表中显示的标签。
| 提供商 | 适配器 | 备注 |
|---|---|---|
| Anthropic (Claude) | anthropic |
唯一支持限定范围的表、维度和文档绑定的路径。 |
| OpenAI (ChatGPT) | openai_compatible |
|
| xAI (Grok) | openai_compatible |
|
| GitHub Models | openai_compatible |
面向以 GitHub 为中心的团队的 GitHub 托管模型。 |
| Google (Gemini) | gemini |
|
| Azure OpenAI | azure |
您的资源端点;“模型”即您的部署名称,API 版本来自连接。 |
工具如何被代理
Section titled “工具如何被代理”LLM 只有能够调用 PlaidCloud 工具才有用。对于交互式助手,有两种机制,使用哪一种取决于提供商。(无人值守的 LLM 工作流步骤工作方式不同,请同时阅读该部分。)
服务器端连接器:Anthropic
Section titled “服务器端连接器:Anthropic”Anthropic 的 API 会携带短期有效的委托令牌,自行连接到您的 PlaidCloud MCP 端点。工具目录由 Anthropic 在其一侧管理,因此模型可以看到令牌被允许调用的所有内容,并且无需帮助即可发现工具。
这也是唯一支持限定范围的绑定的路径,详见下文。
客户端循环:其他所有提供商
Section titled “客户端循环:其他所有提供商”其他提供商没有对应的连接器,因此由 PlaidCloud 自己驱动循环:它作为客户端连接到自己的 MCP 服务器,列出工具,以原生函数定义的形式交给模型,执行模型请求的调用,将结果反馈给模型,并重复这一过程,直到模型给出答案。
有两个限制使其行为可预测:
- 工具范围有上限。 提供商会限制一次请求可声明的函数数量,并且每个架构都会消耗提示词令牌。公开的集合设有上限,同时始终保留发现类元工具,使模型仍然可以查找并调用直接列表之外的任何工具。
- 固定的往返次数上限。 失控的工具循环会被停止,而不会无限消耗令牌。
LLM 工作流步骤有所不同
Section titled “LLM 工作流步骤有所不同”上文描述的都是交互式 AI。无人值守的 LLM 工作流步骤完全不使用客户端循环,在为步骤选择提供商之前,值得先了解这一区别。
| 步骤连接上的提供商 | 步骤可以做什么 |
|---|---|
| Anthropic | 通过 MCP 连接器访问您的数据,并受限定范围的绑定限制:即您在步骤上指定的具体表、维度和文档,每个都标记为读取或写入。即使工具存在,这些对象之外的任何内容也会被拒绝。 |
| 其他所有提供商 | 没有数据访问权限。 该步骤是一次单独的结构化补全:输入提示词、规则和架构,输出 JSON。 |
由此直接产生两个结果:
- 非 Anthropic 步骤会忽略绑定。 绑定不会被悄悄接受,也不会报错:步骤会记录限定范围的数据访问仅限 Anthropic,并在没有绑定的情况下运行。如果您将带有绑定的步骤从 Anthropic 切换到其他提供商,它将不再读取您的数据。
- 非 Anthropic 步骤需要结果架构。 由于没有工具可调用,结构化输出是该步骤唯一的产出。
每个 LLM 连接都带有代理访问设置。它是一个上限,始终与执行操作者的实际权限取交集。
| 代理访问 | 使用此连接的代理和步骤可以做什么 |
|---|---|
| 只读 (默认) | 列出、描述、读取表数据、读取维度成员、读取文档、运行只读 SQL。 |
| 读取和写入 | 上述全部,外加通过 PlaidCloud 的写入工具进行该用户已被允许的更改。原始 SQL 仍为只读。 |
| 完整 (已弃用,将于 2027 年 1 月 15 日移除) | 该用户的完整工具集,包括可写入的 SQL。请改用读取和写入。 |
在每个代理访问设置下,都适用一份无条件的拒绝列表:连接和凭据设置、谁拥有或可以访问某个连接、文档账户的凭据和 ACL、成员和分组管理、密码重置、项目 ACL、项目的 ERP 过账模式、发布、用户定义函数代码以及应用部署。这些永远不能由 AI 凭据调用。
对于 Anthropic 工作流步骤,代理访问与绑定相互作用:在读取和写入下,写入权限按绑定的对象授予,因此步骤可以写入您勾选的那张表,而不能写入其他任何内容。
当步骤声明了结果架构时,答案会按该架构进行验证,而不是从散文中解析出来。由于各提供商表达架构的方式不同,架构会按提供商进行转换:OpenAI 兼容端点使用严格 JSON 方言,Gemini 使用 OpenAPI 子集;拒绝或被截断的响应会作为独立的错误呈现,而不是令人困惑的“无效 JSON”。
值得了解的安全措施
Section titled “值得了解的安全措施”- 出站 URL 在任何调用之前都会经过验证。 基础 URL 必须使用 HTTPS 并解析为公共地址;环回地址、私有范围地址、链路本地地址和云元数据地址都会被拒绝,并且禁用重定向,使响应无法将调用转移到其他地方。
- 密钥不会出现在日志和错误中。 提供商返回的错误会经过清理,而不是连同凭据一并回显。
- 规则是指令,而不是权限。 连接上的固定规则会影响模型的行为,但不能提高它被允许访问的范围。
- AI 与 LLM 架构:各个入口和共用路径
- 使用您自己控制的 LLM:Azure OpenAI 和自托管选项
- 连接:创建和管理连接的通用说明