

导入 SQL
将针对外部数据库的 SQL 查询结果导入 PlaidCloud 项目表。查询在远程数据库上运行,只有结果集会被带入 PlaidCloud。
与导入外部数据库表的区别在于,SQL 由您自己编写,这对于复杂的联接、筛选或聚合很有用,您可以让源数据库先完成这些操作,再将数据加载到 PlaidCloud。
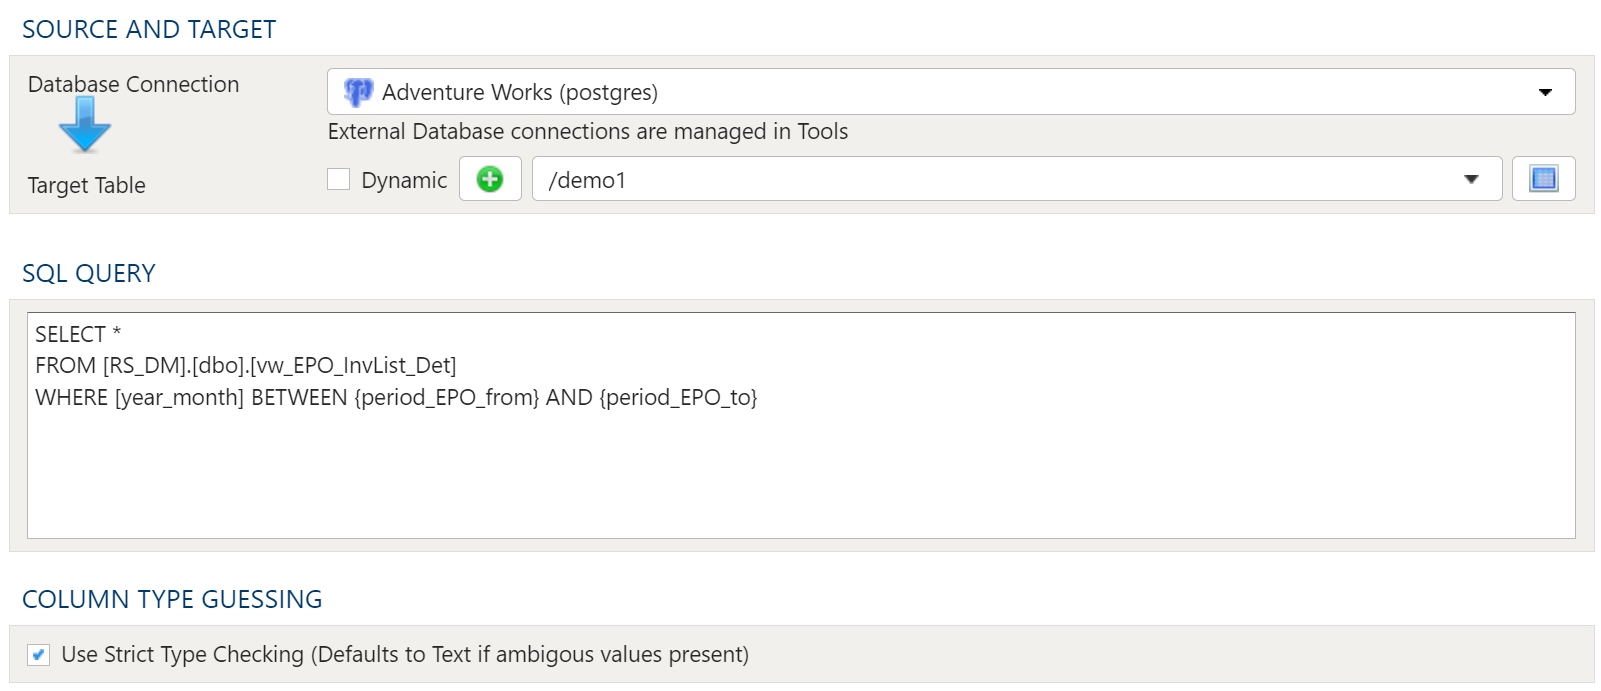
要建立数据库连接,请参阅 PlaidCloud 数据连接
目标表
导入的目标只能选择表,因为视图不包含底层数据。
动态选项
动态选项允许使用文本(包括变量)指定表。在由变量驱动的工作流中,如果表和视图的引用需要随所指定的变量而变化,此选项会很有用。
以下示例使用 current_month 变量动态指向目标表:
legal_entity/inputs/{current_month}/ledger_values静态选项
如果希望使用特定表作为导入的目标,请不要勾选Dynamic复选框,直接选择目标表。
如果目标表不存在,请选择新建表按钮,在所需位置创建该表。
任何表选择旁都可使用表资源管理器。单击表选择右侧的表资源管理器按钮,即可打开表资源管理器窗口。
SQL 查询
Section titled “SQL 查询”在此部分编写 SQL 查询以返回所需的数据。
预览
单击源选项卡上的预览,可查看步骤将读取内容的最多 100 行,而不运行它。如果结果更长,预览会说明它只显示了前几行,需要运行步骤才能读取全部行。
预览填充项目变量和工作流变量的方式与运行相同。它不支持 {x:>9} 之类的变量格式,也无法填充只在运行期间才有值的变量,例如触发值。
预览只读取数据。它会拒绝可能更改任何内容的查询,并显示一条消息而不是行:
- 预览仅支持标准 SQL 函数。请运行该步骤以查看结果。 查询使用了预览无法确认是只读的函数。请运行步骤以查看结果。
- 不是单个
SELECT的查询,或者其变量展开后成为写入语句的查询,会被拒绝。
在已锁定的项目中、在 SQL Server、Oracle 或 SQLite 连接上,或对于通过代理运行的步骤(例如 Agent Remote Execution of SQL 步骤),预览不可用。
SQL 导入可以选择在加载时尝试推测数据类型,或将所有列设置为文本类型。如果数据干净,动态设置数据类型可能更快,但在某些情况下会引发问题。
例如,如果大部分数据看起来是数值,但其中也有一些文本,它可能会尝试将其设置为数值,导致数据类型不匹配而引发加载问题。再比如,如果有一个 16 位的数字产品代码,也可能出现问题:它会裁掉前导零,得到的是一个数字,而不是 16 位代码。
不过,将数据全部设置为文本时,需要在之后使用提取步骤,把不应为文本的数据转换为合适的类型,例如日期或数值。
| 症状 | 可能原因 |
|---|---|
| 步骤明显比平时耗时更长(最多多出约半小时),而查询、连接或数据量没有任何其他变化 | 运行导入的后台工作进程在中途被中断(平台端的重启或驱逐,而非工作流中的问题),平台为您重试了该表的导入。重试只有在检测到中断后才会开始,这就是多出的时间。 |
| 延迟之后步骤仍然成功完成 | 重试会完整替换表的内容,因此结果与一次干净的运行相同,无需进一步检查或重做。 |
| 步骤失败并提示“已尝试过,无法安全地重新运行” | 对于导入 SQL 步骤,不再出现这种拒绝,运行中途的中断会被重试。在还原项目归档或加载维度时,按设计仍会看到这一提示,因为重新运行会产生重复,而不是替换任何内容。如果您在导入 SQL 步骤本身看到该提示,请提交支持工单。 |