

Import SPSS 步骤
将 SPSS 数据文件(.sav 和 .zsav 格式)导入 PlaidCloud 项目表。适用于调查数据、社会科学研究数据,或任何需要与基于 SPSS 的工具互操作的管道。
在格式支持的情况下,会保留变量标签和值标签。
暂无示例…
无
删除非 ASCII 字符选项
选择此选项后,导入将删除所有非 ASCII 内容。虽然 PlaidCloud 完全支持 Unicode (UTF-8),但现实中的文件可能包含各种编码和杂散字符,给处理带来困难。
如果文件内容预期仅包含 ASCII,勾选此复选框有助于确保导入过程顺利运行。
导入后删除文件选项
此选项允许导入过程在成功完成导入后,从 PlaidCloud 文档账户中删除该文件。
如果导入文件可以从记录系统重新生成,或者处理完毕后没有理由保留原始输入文件,此选项会很有用。
仅删除已导入的文件。导入期间被跳过或产生警告的文件会保留在文件夹中。
导入文件选择器
此转换中的文件选择器用于选择存储在 PlaidCloud 文档位置中的文件进行导入。
您也可以选择一个目录进行导入,该目录中的所有文件都将在转换运行时一并导入。
选择文档账户
选择您有权访问的 PlaidCloud 文档账户。这样您就可以在下一项选择中选取目录或文件。
在项目内,列表顶部还提供Project Default,代表项目当前设置为默认的账户。当项目设有默认账户时,新步骤会预先选中 Project Default;现有步骤会保留其已保存的账户,直到您更改为止。设为Project Default的步骤在运行时使用当时项目的默认账户;如果未设置默认账户,运行会失败并指明该项目,而不会回退到其他账户。
搜索选项
搜索选项用于在指定目录路径下查找所有要导入的匹配文件。如果需要包含许多文件,但它们存储在嵌套目录中,或与同一目录中不想导入的其他文件混在一起,此选项会特别有用。
所选的搜索路径是搜索的起始目录。搜索过程会查找该目录及其子目录中所有符合所指定搜索条件的文件。请确保搜索条件同样适用于子目录中的文件。
可使用以下条件进行搜索:
- 精确:与搜索文本完全匹配
- 开头为:匹配以搜索文本开头的任何文件
- 包含:匹配包含搜索文本的任何文件
- 结尾为:匹配以搜索文本结尾的任何文件
AI 助手或 REST API 还可以将搜索设置为 glob(通配符模式,例如 CO Store*.yxdb,对整个文件名进行匹配且忽略大小写),或 regex(整个文件名必须匹配的正则表达式)。正则表达式区分大小写,除非以 (?i) 开头。
文件或目录选择选项
如果需要导入特定的文件或目录中的文件,选择文件或目录比使用搜索更合适。
要选择文件或目录,只需使用浏览按钮,在上面所选文档账户中选取路径。
变量替换
无论使用搜索选项还是特定文件/目录选项,路径、搜索文本和文件名中都可以使用变量。
以下示例使用 current_month 变量动态指向正确的文件:
legal_entity/inputs/{current_month}/ledger_values.csv目标表
导入的目标只能选择表,因为视图不包含底层数据。
动态选项
动态选项允许使用文本(包括变量)指定表。在由变量驱动的工作流中,如果表和视图的引用需要随所指定的变量而变化,此选项会很有用。
以下示例使用 current_month 变量动态指向目标表:
legal_entity/inputs/{current_month}/ledger_values静态选项
如果希望使用特定表作为导入的目标,请不要勾选Dynamic复选框,直接选择目标表。
如果目标表不存在,请选择新建表按钮,在所需位置创建该表。
任何表选择旁都可使用表资源管理器。单击表选择右侧的表资源管理器按钮,即可打开表资源管理器窗口。
数据映射器配置
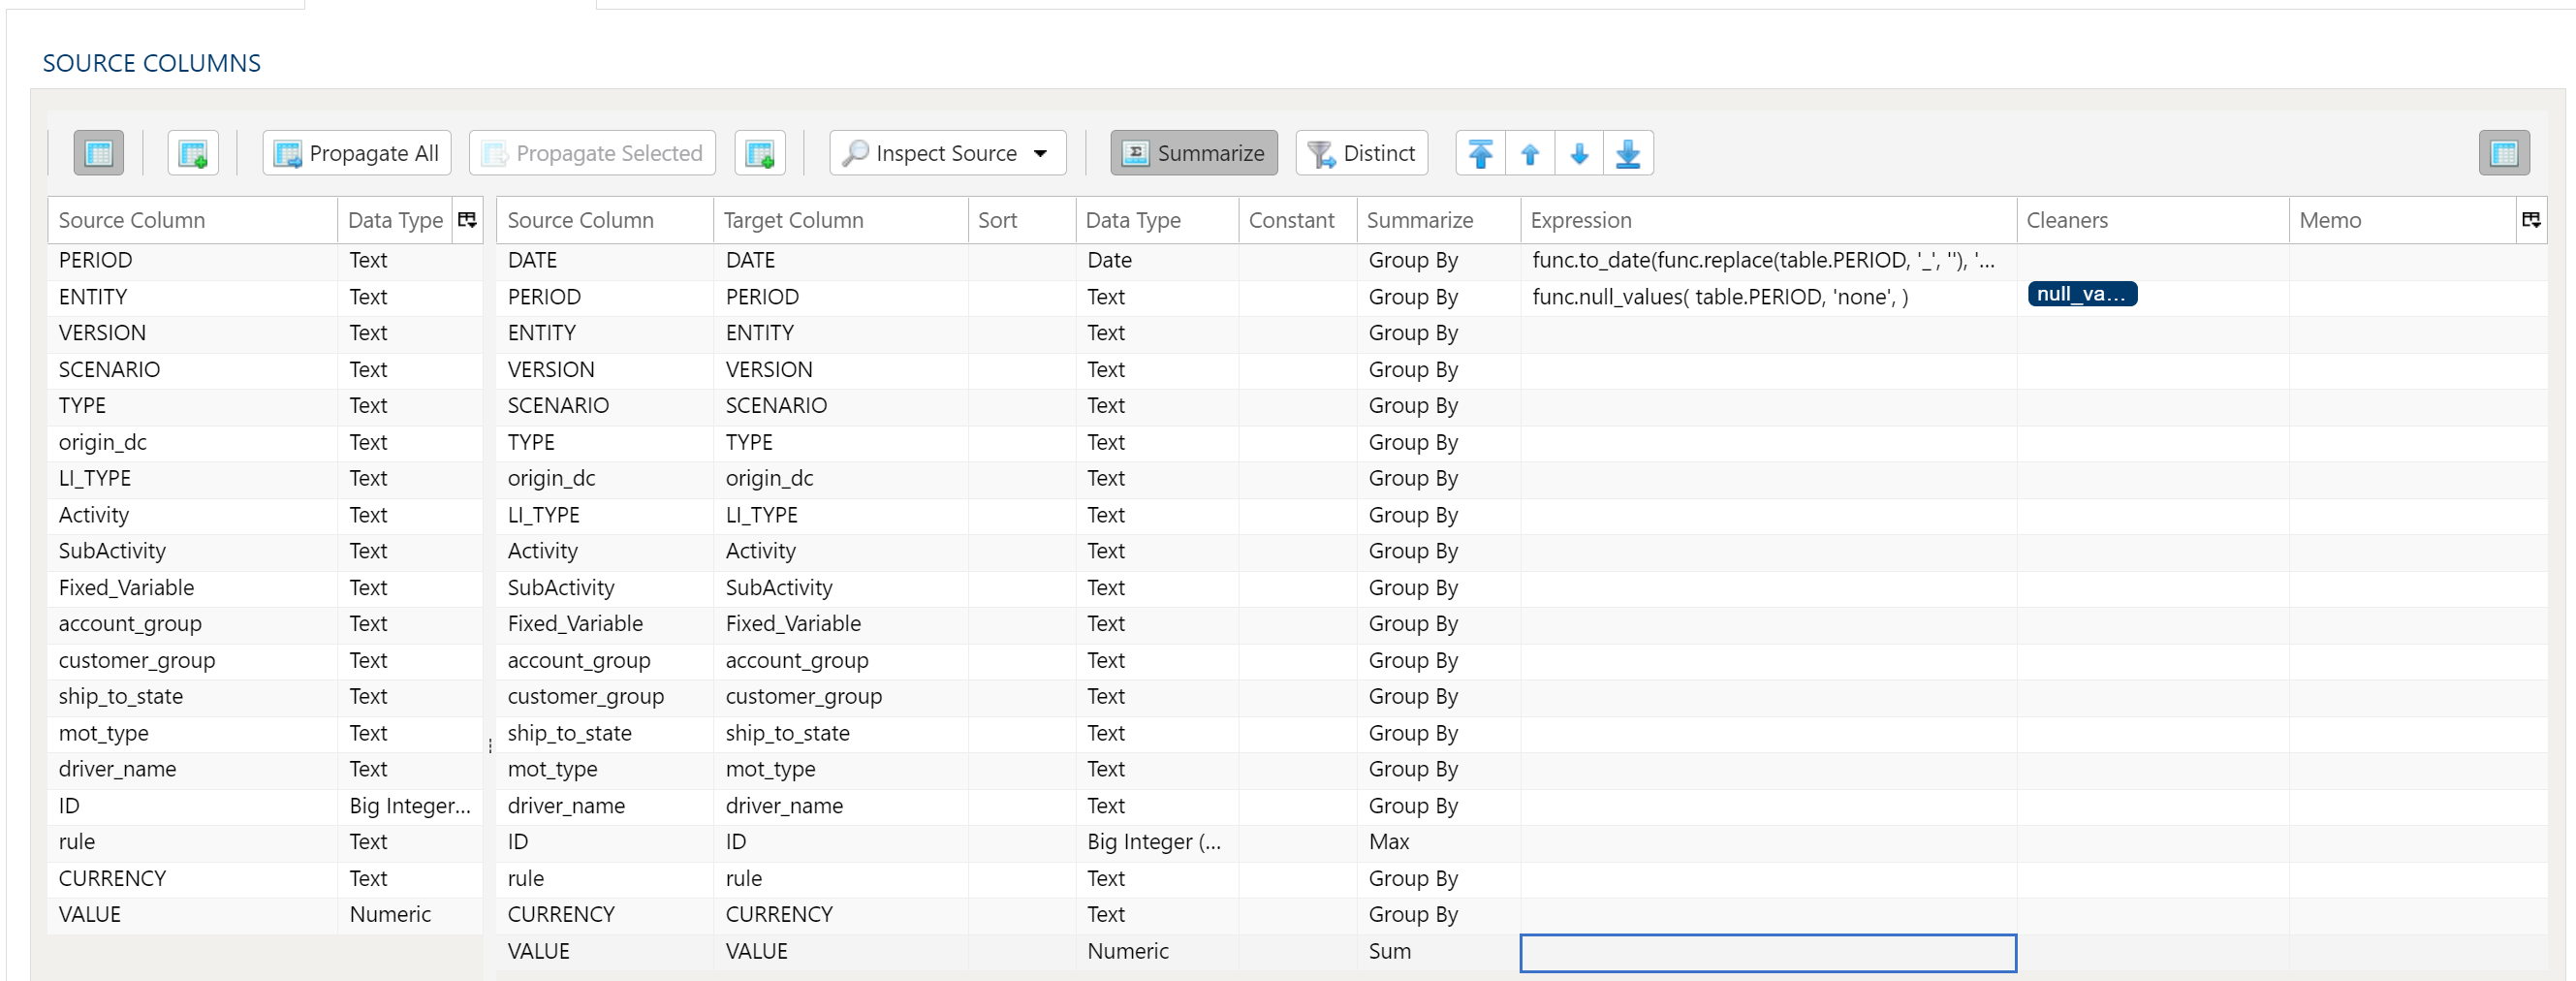
数据映射器用于将源数据中的列映射到目标数据表。
检查并填充映射器
使用 检查源 菜单按钮可以通过更多方式将源中的列映射到目标:
- 填充两个映射表:将源数据表中的所有值传播到目标数据表。这是默认行为。
- 仅填充源映射表:仅映射源数据表中的所有值。当源列结构发生变化而需要修改现有工作流时,此选项很有用。
- 仅填充目标映射表:仅将所有值传播到目标数据表。
如果上述源列和目标列选项仍不够用,还可以通过以下几种方式向目标数据表添加其他列:
- 全部传播 会将所有源列插入目标数据表,无论这些列是否已存在。
- 传播所选项 仅插入所选的源列。
- 在目标侧右键单击并选择 插入行,可在当前所选行的正上方插入一行。
- 在目标侧右键单击并选择 追加行,可在目标数据表的底部(最右侧)插入一行。
删除列
要从目标数据表中删除列,请选择所需的列,然后右键单击并选择 删除。
不再列出的源列
目标行可能指定了某个 源列,而源数据表已不再列出该列,例如在重新检查源之后。步骤绝不会自动移除这样的行,而是将列名显示为红色,并在前面加上 ⚠ 警告标志;将鼠标悬停在其上,会提示该列不在源列中。在包含多个表的步骤(如联合)中,每个表都会分别对照其自身的源列进行检查。
带有 常量、表达式 或 计数(含空值) 汇总的行不会被标记,因为步骤不会读取其源列。当源数据表没有列出任何列时(例如首次检查源之前),也不会标记任何内容。
保存仍含有已标记行的步骤时,会出现 发现过时列 对话框,按其所在的选项卡或表列出这些行,并提供三个选项:
- 全部移除并保存 — 移除已标记的行,然后保存。
- 仍然保存 — 按现状保存步骤。
- 取消 — 返回步骤,不保存。
要保留某一行并清除其警告,请将该列重新添加到源数据表,或选择源数据表中列出的某一列。
列数据类型
每个目标列都带有一个 类型。从源传播而来的列沿用源列的类型;手动添加的行起初为 文本,需要设置 类型 来指明其实际类型 — 打算求和或排序的列需要使用数值或日期类型,因为文本会按文本方式排序和求和。
保存时没有任何类型的列,步骤仍可运行。类型会在步骤启动时根据该列所读取的源列确定。如果无处可读,则视为文本:提取 SQL 步骤的列来自您编写的查询,而不是映射的源;如果多个源中存在同名列但类型不一致,则使用文本,而不是随意选择其中一种 — 猜错会产生仓库可能拒绝的转换,而任何类型都可以转换为文本。
自行设置 类型 仍然是指明列应为何种类型的方式。不设置则意味着接受源列恰好具有的类型。
更改列顺序
要重新排列目标数据表中的列,请选择所需的列。可以使用以下任一方式:
- 批量移动箭头:从右上角的箭头中选择所需的移动选项
- 上下文菜单:右键单击并选择 移到顶部、上移、下移 或 移到底部。
仅返回非重复记录
要仅返回非重复的选项,请选择 非重复 菜单选项。这会为源中的每一列切换显示一组复选框。只需勾选相应列旁边的复选框,即可仅返回非重复的结果。
视情况而定,您可能需要考虑改用汇总。
非重复处理会保留找到的第一条唯一记录,并丢弃其余记录。如果运行之间的一致性很重要,可能需要对数据进行排序。
聚合与分组
要聚合结果,请选择 汇总 菜单选项。这会为目标数据表中的每一列切换显示一组选择框。请为每一列选择合适的汇总方法。
当 检查源 填充列时,如果数值列的名称读起来像标识符(例如 id、customer_id、Order No 或 CustomerKey),或者其所在表将其设为键,或者联接将其用作键,则该列起初为 分组依据,而不是 求和。
- 分组依据
- 求和
- 最小值
- 最大值
- 第一个
- 最后一个
- 计数
- 计数(含空值)
- 平均值
- 标准差
- 样本标准差
- 总体标准差
- 方差
- 样本方差
- 总体方差
- 高级非分组
有关表达式、清理和常量等高级数据映射器用法,请参阅高级数据映射器用法

为了获得最大的灵活性,源数据和目标数据都可以使用数据筛选器。对于较大的数据集,在源端筛选掉部分行尤其有益,这样后续操作只需处理较小的数据集。
选择数据子集
此筛选器类型用于根据指定条件筛选传入的源数据。
对结果数据应用二次筛选器
此筛选器类型用于根据指定条件对转换后的结果数据应用筛选器。 对转换后的结果应用筛选器,可以基于复杂计算、汇总或窗口函数的结果进行排除。
最终数据表切片(限制)
行切片功能可根据范围和起始点限制结果集中的行数。
筛选器语法
筛选器语法使用 Python SQLAlchemy,与其他表达式的语法相同。
有关示例和表达式函数,请参阅表达式部分。