Allocation By Assignment Dimension 步骤
基于分配维度和驱动因素数据表,将源表中的值分摊到各目标。这是最灵活的分摊步骤,适用于基于驱动因素的分摊:每个源行的去向由层次结构决定,而驱动因素值决定各去向分得多少。
常见模式:使用活动工时将成本中心总额分摊到产品线;按人数在各业务单位之间分配 IT 间接费用;使用自定义权重分摊共享服务成本。
分配维度层次结构
Section titled “分配维度层次结构”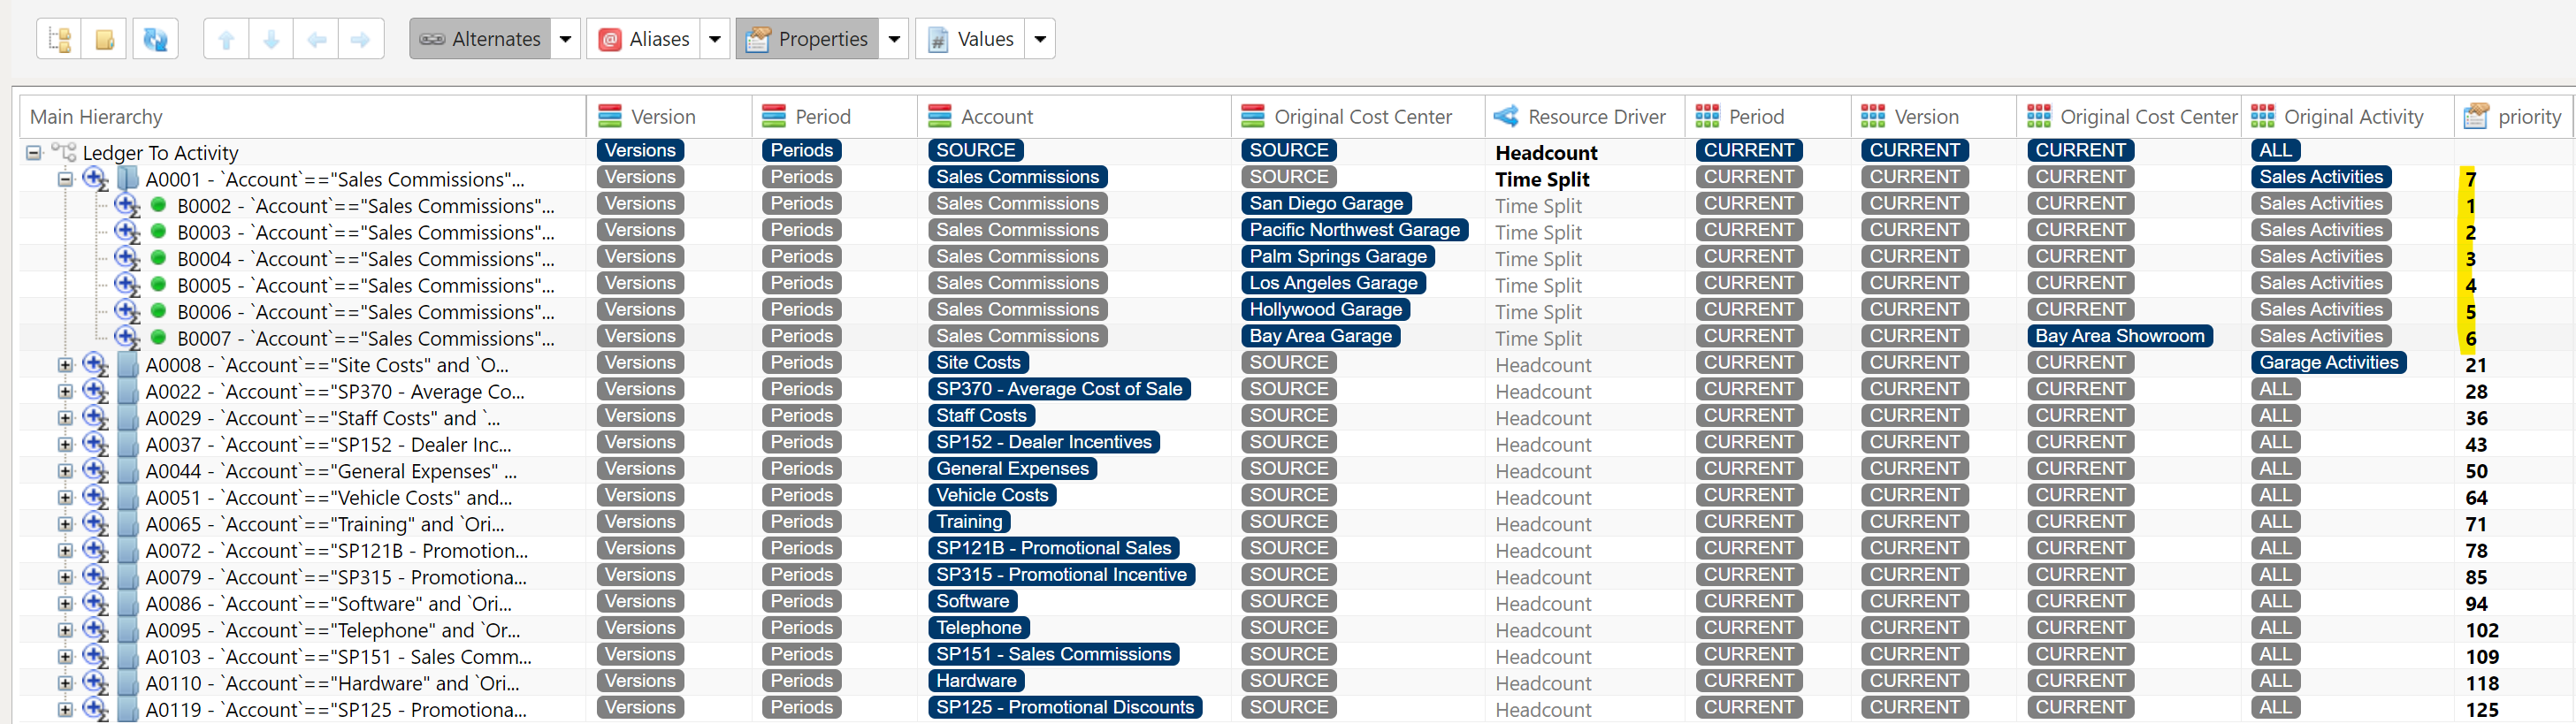
分配维度层次结构让用户可以通过点选来筛选待分摊值表和驱动因素数据表中的任意一个或两者,从而创建有针对性的分摊。 分配维度层次结构由引用待分摊值表和驱动因素数据表的维度组合而成。
创建分配维度层次结构
Section titled “创建分配维度层次结构”要创建分配维度层次结构,必须先创建要用作待分摊值表和驱动因素数据表筛选器的维度。以下链接将指导您创建这些维度。
创建主层次结构
Section titled “创建主层次结构”为待分摊值表和驱动因素数据表创建好维度后,下一步是确定待分摊值表的哪个维度将作为分配维度层次结构的主层次结构。
复制此维度的方法是:在 PlaidCloud 中转到“维度”选项卡,单击该维度,然后依次选择操作和复制维度。 复制维度时会弹出一个窗口,要求您为复制出的维度输入名称。
向分配层次结构添加维度
Section titled “向分配层次结构添加维度”打开新创建的分配维度,单击属性旁边的向下箭头,然后选择新建属性。
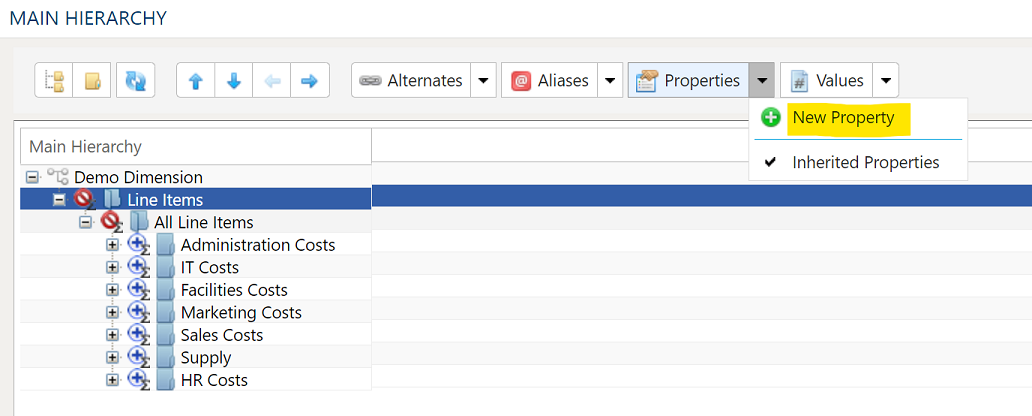
这将打开属性配置对话框:
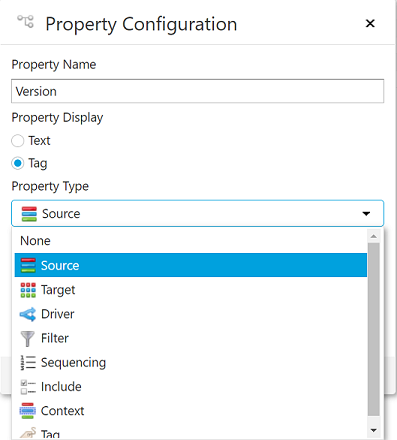
- 属性名称:通常是要添加到分配层次结构的维度的名称。
- 属性显示:应设置为“Tag”。
- 属性类型:此属性告知分摊步骤该维度与哪个表相关,是待分摊值表还是驱动因素数据表。
- 源:与待分摊值表配合使用。
- 目标:与驱动因素数据表配合使用。
- 驱动:用于针对所选的特定驱动因素筛选驱动因素数据表。
- 上下文:当待分摊值表和驱动因素数据表包含相同的维度时,可使用上下文指定这些维度之间的关联方式。当两个表都包含_利润/成本中心_或_地域_时,经常使用上下文。
- 留空:没有自身上下文的节点会采用最近一个设置了上下文的上级的上下文,因此空白单元格表示_继承_,而不是_无上下文_。只有在没有任何上级设置上下文时,驱动因素数据表才会回退为按目标维度自身的设置进行筛选。
- 当前:起到直通作用,并根据目标维度的设置筛选驱动因素数据表。例如,如果上下文基于_利润中心_维度,且_利润中心_目标维度设置为全部,则驱动因素数据会按所有_利润中心_筛选。由于它是一个存储值,因此还会终止上述继承,所以当某个上级设置了上下文时,当前就是节点表示“此处无上下文”的方式;改为清空单元格,则会让该节点获得其上级的上下文。
- 父级:选中后,待分摊值表中_利润中心_的父级将用于筛选驱动因素数据表中的驱动因素值。当特定_利润中心_有时没有驱动因素值、而其父级层次上通常有时,这很有用。
- 全部:选中后,待分摊值表中的_利润中心_不会筛选驱动因素数据表中的驱动因素值,将使用所有_利润中心_的驱动因素值。
- 未分配:不使用目标维度本会选取的驱动因素行,而是仅使用其_利润中心_完全没有值或读取为
UNASSIGNED(任何大小写)的行,并且_利润中心_不会拆分结果。可用于分摊没有任何_利润中心_拥有的成本的规则。它只作用于设置它的规则,让同一列保持空白的其他规则不受影响。
- 编辑器类型:此下拉列表应设置为Select Dimension。
为要添加到分配层次结构的维度选择好相应属性后,选择“编辑配置”。
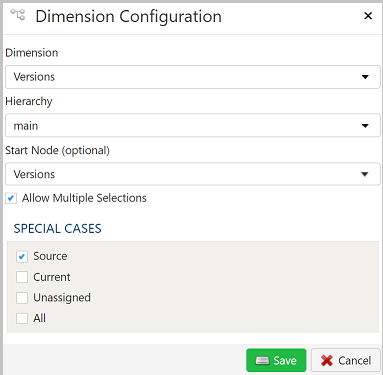
- 维度:使用下拉列表选择维度。
- 层次结构:如果所选维度具有备用层次结构,它们也会与主层次结构一起显示在此处供选择。
- Start Node:如果不希望从顶部节点开始显示该维度,可以选择层次结构内的任意节点作为显示该维度的起始节点。
- 允许多选:选中后,用户可以在层次结构中选择多个节点。
- 特殊情况:选中后,特殊情况将出现在维度下拉菜单中供选择。它们通常用于目标维度。
- 源:当维度设置为_源_时,分摊在筛选驱动因素数据表时会忽略此维度,但分摊结果会包含该维度的值。
- 当前:可在维度由_源_和_目标_共享时使用。当_目标_维度设置为当前时,驱动因素数据表将在分摊运行时按_源_维度的当前值进行筛选。例如,待分摊值表和驱动因素数据表中都有多个期间,但您希望分摊在各期间内进行而不是跨期间进行。在_业务单位_、_成本中心_和_地域_上使用当前也很常见。
- 未分配:当维度设置为_未分配_时,分摊在筛选驱动因素数据表时会忽略此维度,并且此维度的分摊结果将为_Null_值。
- 全部:当维度设置为_ALL_时,分摊将使用该维度中的所有值。
待分摊值表、驱动因素数据表和分摊结果表可以动态或静态选择。
动态表选项允许使用文本和变量指定表。这在使用由变量驱动的工作流时很有用,此时对表或视图的引用与所指定的变量相关。
下面的示例使用 current_month 变量动态指向一个表:
legal_entity/inputs/{current_month}/ledger_values如需将特定表用作源,请不要选中 Dynamic 框,并使用下拉菜单选择源表。
任何表选择都始终可以使用表资源管理器。单击表选择右侧的“表资源管理器”按钮,将打开表资源管理器窗口。
此表包含要分摊的值,这些值通常是成本或收入值。
驱动因素数据表
Section titled “驱动因素数据表”驱动因素数据表包含分摊步骤将用来分摊成本的值。
示例:
- 供应链要将成本分配给客户时,可以使用配送数据,以配送次数或配送重量作为驱动因素。
- IT 服务台要将其成本分配给其所支持的部门时,驱动因素数据可以是按成本中心统计的工单数量。
驱动因素数据符号规则
Section titled “驱动因素数据符号规则”驱动因素数据可以同时包含正值和负值。Driver Data Sign Rule 让您决定如何处理冲突的符号。
- Error on conficting signs:遇到冲突的符号时,分摊步骤会产生错误并停止。
- Proceed with warning on conflicting signs:分摊步骤会同时使用负值和正值的驱动因素值,但会显示警告。
- Use only positive driver values:分摊步骤只使用正的驱动因素值,忽略负值。
- Use only negative driver values:分摊步骤只使用负的驱动因素值,忽略正值。
- Use absolute values of driver data:分摊步骤使用驱动因素数据的绝对值。
将记录匹配到多条规则
Section titled “将记录匹配到多条规则”默认情况下,一条记录只采用它匹配的第一条规则。取消选中仅将记录匹配到一条规则后,它会改为采用匹配的每一条规则:该记录会针对每条规则各出现一次,而不匹配任何规则的记录会被排除。
还可以使用类型为排序的分配维度属性将规则拆分为多个迭代,其值是每条规则在其中运行的迭代。取消选中仅将记录匹配到一条规则的步骤无法同时做到这两点:如果要运行的规则分布在多个迭代中,步骤会停止并显示 Cannot apply rules when there are multiple iterations and records can match more than one rule。请选中该选项,或将每个迭代作为单独的步骤运行。
每次运行分摊步骤时都会创建_中间表_,并提供分摊处理的摘要。_中间表_可帮助了解分摊过程的运行情况,并用于排查意外结果。
- 路径:显示从分配层次结构汇总出的唯一分摊路径数量。
- 映射:显示待分摊值表的每一行如何映射到分摊目标。
- 摘要:显示由分配层次结构产生的每条规则,以及待分摊值表中有多少记录与之匹配。
选中仅将记录匹配到一条规则时,不匹配任何规则的记录在映射表中的规则列为空,并计入不指明任何规则的摘要行。规则留空的值同样为空。这里的空是指 null,绝不是空字符串,并且无论是否选中使用 SQL 而非 Pandas 应用规则,这三个表的列和类型都相同。
将结果追加到目标表
Section titled “将结果追加到目标表”如果选中此框,分摊结果将追加到分摊结果表。 如果未选中此框,则每次运行分摊步骤时都会覆盖分摊结果表。
分摊结果使用单独的列
Section titled “分摊结果使用单独的列”如果选中此框,则结果表会显示每条已分摊记录的金额,以及实际分摊给每条驱动因素记录的金额。
重命名维度节点
Section titled “重命名维度节点”如果选中此框,则分摊步骤运行时会重命名分配维度中的维度节点。
设置分摊步骤将使用的并发操作数量。
设置每个线程内的分摊路径数量。
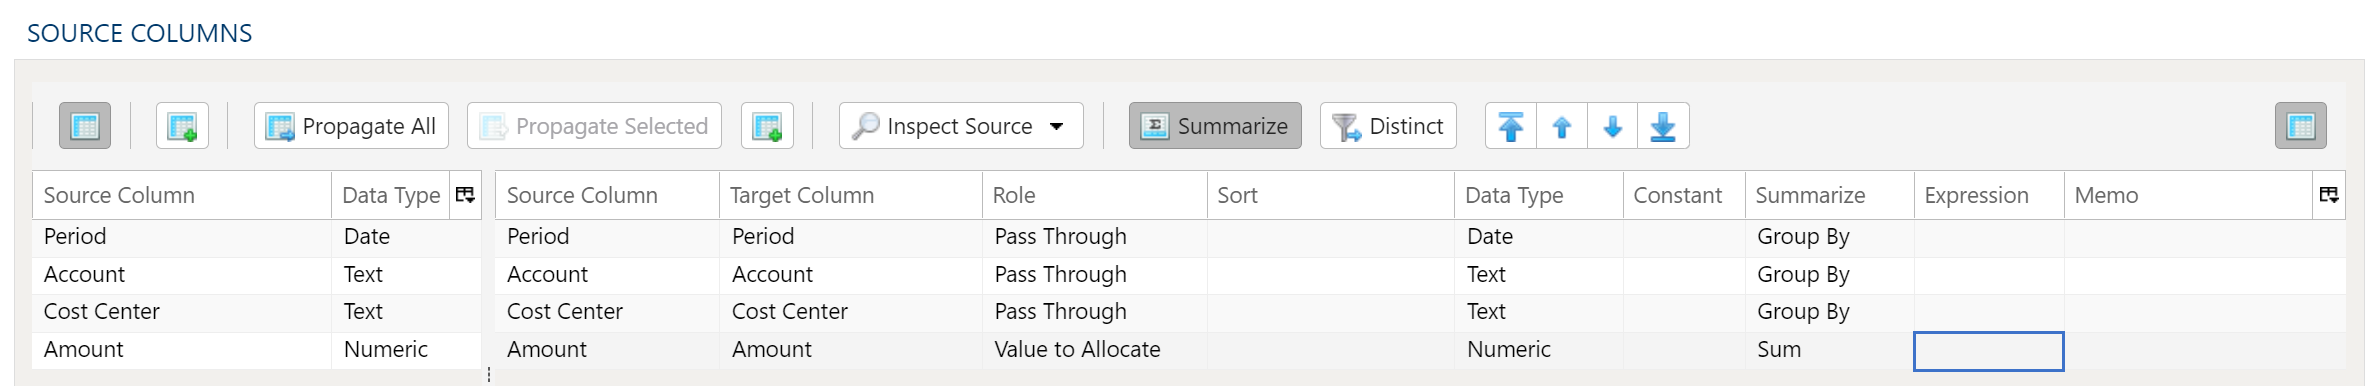
分摊源映射用于映射待分摊值表中将在分摊步骤中使用的列。
检查并填充映射器
使用 检查源 菜单按钮可通过更多方式将列从源映射到目标:
- 填充两个映射表:将源数据表中的所有值传播到目标数据表。此为默认行为。
- 仅填充源映射表:仅映射源数据表中的所有值。当源列结构发生变化而需要修改现有工作流时,此选项很有用。
- 仅填充目标映射表:仅将所有值传播到目标数据表。
如果源列和目标列选项仍不够用,还可以通过以下几种方式向目标数据表添加其他列:
- 全部传播会将所有源列插入目标数据表,无论这些列是否已存在。
- 传播所选项仅插入所选的源列。
- 在目标侧右键单击并选择插入行,即可在当前所选行的正上方插入一行。
- 在目标侧右键单击并选择追加行,即可在目标数据表底部(最右侧)插入一行。
角色
数据映射器中的每一列都必须指定一个角色:
- Pass Thought - 这些列将显示在分摊结果表中。
- 待分摊值 - 此列包含要分摊的值。
删除列
要从目标数据表中删除列,请选择所需的列,然后右键单击并选择删除。
更改列顺序
要重新排列目标数据表中的列,请选择所需的列。您可以使用以下任一方式:
- 批量移动箭头:使用右上角的箭头选择所需的移动选项
- 上下文菜单:右键单击并选择移到顶部、上移、下移或移到底部。
将结果缩减为仅非重复记录
要仅返回非重复选项,请选择非重复菜单选项。这会为源中的每一列切换显示一组复选框。只需勾选相应列旁边的复选框,即可仅返回非重复结果。
视情况而定,您也可以考虑改用汇总。
非重复处理会保留找到的第一条唯一记录,并丢弃其余记录。如果需要保证多次运行之间的一致性,建议对数据进行排序。
聚合和分组
要聚合结果,请选择汇总菜单选项。这会为目标数据表中的每一列切换显示一组选择框。请为每一列选择合适的汇总方法。
- 分组依据
- 求和
- 最小值
- 最大值
- 第一个
- 最后一个
- 计数
- 计数(含空值)
- 平均值
- 标准差
- 样本标准差
- 总体标准差
- 方差
- 样本方差
- 总体方差
- 高级非分组依据
有关表达式、清理和常量等高级数据映射器用法,请参阅高级数据映射器用法
分摊源筛选器
Section titled “分摊源筛选器”
为了获得最大的灵活性,源数据和目标数据都可以使用数据筛选器。对于较大的数据集,在源端筛选掉部分行尤其有益,这样后续操作只需处理较小的数据集。
选择数据子集
此筛选器类型用于根据指定条件筛选传入的源数据。
对结果数据应用二次筛选器
此筛选器类型用于根据指定条件对转换后的结果数据应用筛选器。 对转换后的结果应用筛选器,可以基于复杂计算、汇总或窗口函数的结果进行排除。
最终数据表切片(限制)
行切片功能可根据范围和起始点限制结果集中的行数。
筛选器语法
筛选器语法使用 Python SQLAlchemy,与其他表达式的语法相同。
有关示例和表达式函数,请参阅表达式部分。
驱动因素数据映射
Section titled “驱动因素数据映射”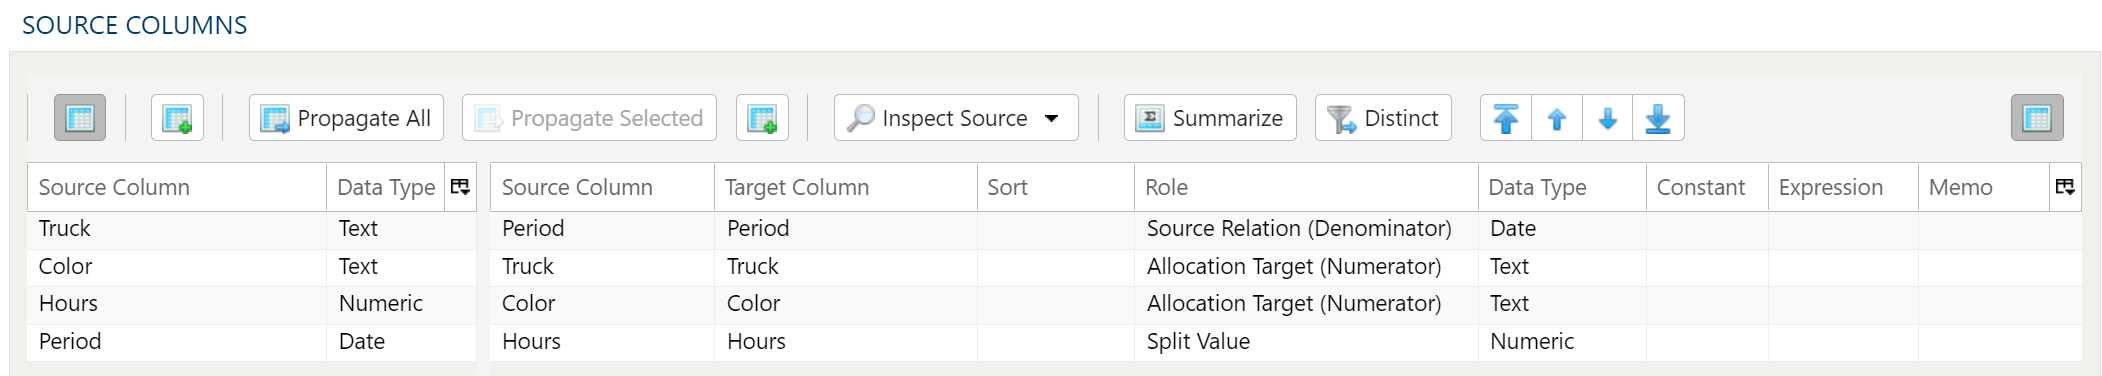
分摊驱动因素数据映射用于映射驱动因素数据表中将在分摊步骤中使用的列。
检查并填充映射器
使用 检查源 菜单按钮可通过更多方式将列从源映射到目标:
- 填充两个映射表:将源数据表中的所有值传播到目标数据表。此为默认行为。
- 仅填充源映射表:仅映射源数据表中的所有值。当源列结构发生变化而需要修改现有工作流时,此选项很有用。
- 仅填充目标映射表:仅将所有值传播到目标数据表。
如果源列和目标列选项仍不够用,还可以通过以下几种方式向目标数据表添加其他列:
- 全部传播会将所有源列插入目标数据表,无论这些列是否已存在。
- 传播所选项仅插入所选的源列。
- 在目标侧右键单击并选择插入行,即可在当前所选行的正上方插入一行。
- 在目标侧右键单击并选择追加行,即可在目标数据表底部(最右侧)插入一行。
角色
数据映射器中的每一列都必须指定一个角色:
- Source Relation - 这些列在待分摊值表中有对应的列。
- Allocation Target - 这些列将作为分摊步骤的目标,并显示在分摊结果表中。
- 拆分值 - 此列包含用于分摊待分摊值表中各值的数值。
删除列
要从目标数据表中删除列,请选择所需的列,然后右键单击并选择删除。
更改列顺序
要重新排列目标数据表中的列,请选择所需的列。您可以使用以下任一方式:
- 批量移动箭头:使用右上角的箭头选择所需的移动选项
- 上下文菜单:右键单击并选择移到顶部、上移、下移或移到底部。
将结果缩减为仅非重复记录
要仅返回非重复选项,请选择非重复菜单选项。这会为源中的每一列切换显示一组复选框。只需勾选相应列旁边的复选框,即可仅返回非重复结果。
视情况而定,您也可以考虑改用汇总。
非重复处理会保留找到的第一条唯一记录,并丢弃其余记录。如果需要保证多次运行之间的一致性,建议对数据进行排序。
聚合和分组
要聚合结果,请选择汇总菜单选项。这会为目标数据表中的每一列切换显示一组选择框。请为每一列选择合适的汇总方法。
- 分组依据
- 求和
- 最小值
- 最大值
- 第一个
- 最后一个
- 计数
- 计数(含空值)
- 平均值
- 标准差
- 样本标准差
- 总体标准差
- 方差
- 样本方差
- 总体方差
- 高级非分组依据
有关表达式、清理和常量等高级数据映射器用法,请参阅高级数据映射器用法
驱动因素数据筛选器
Section titled “驱动因素数据筛选器”
为了获得最大的灵活性,源数据和目标数据都可以使用数据筛选器。对于较大的数据集,在源端筛选掉部分行尤其有益,这样后续操作只需处理较小的数据集。
选择数据子集
此筛选器类型用于根据指定条件筛选传入的源数据。
对结果数据应用二次筛选器
此筛选器类型用于根据指定条件对转换后的结果数据应用筛选器。 对转换后的结果应用筛选器,可以基于复杂计算、汇总或窗口函数的结果进行排除。
最终数据表切片(限制)
行切片功能可根据范围和起始点限制结果集中的行数。
筛选器语法
筛选器语法使用 Python SQLAlchemy,与其他表达式的语法相同。
有关示例和表达式函数,请参阅表达式部分。
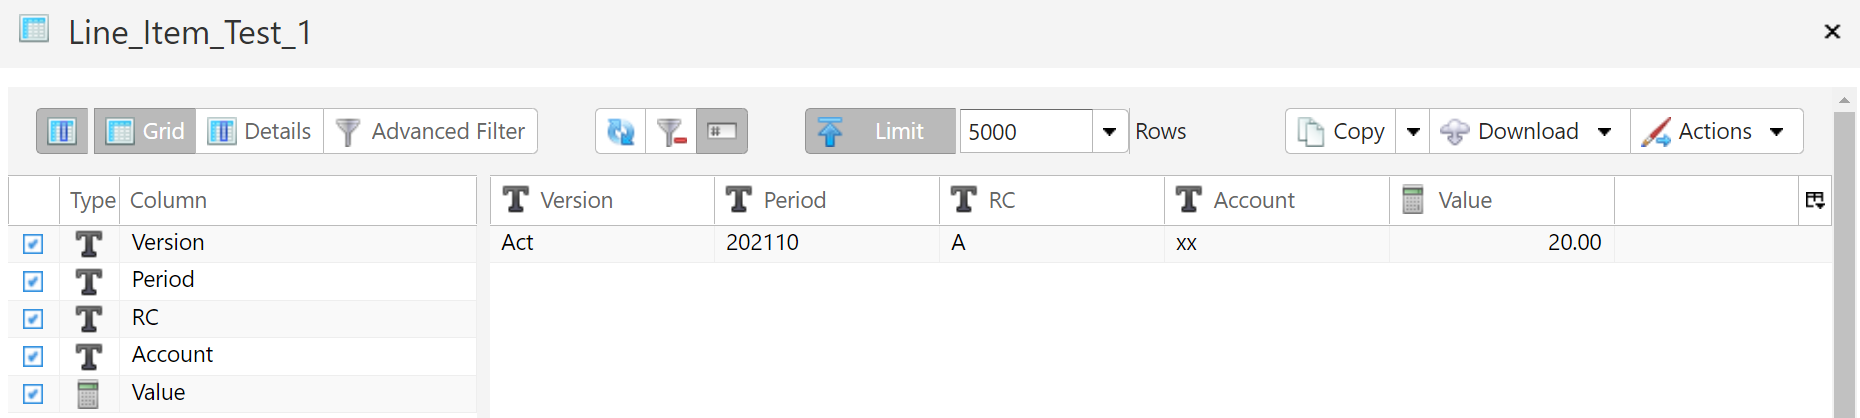
待分摊值表
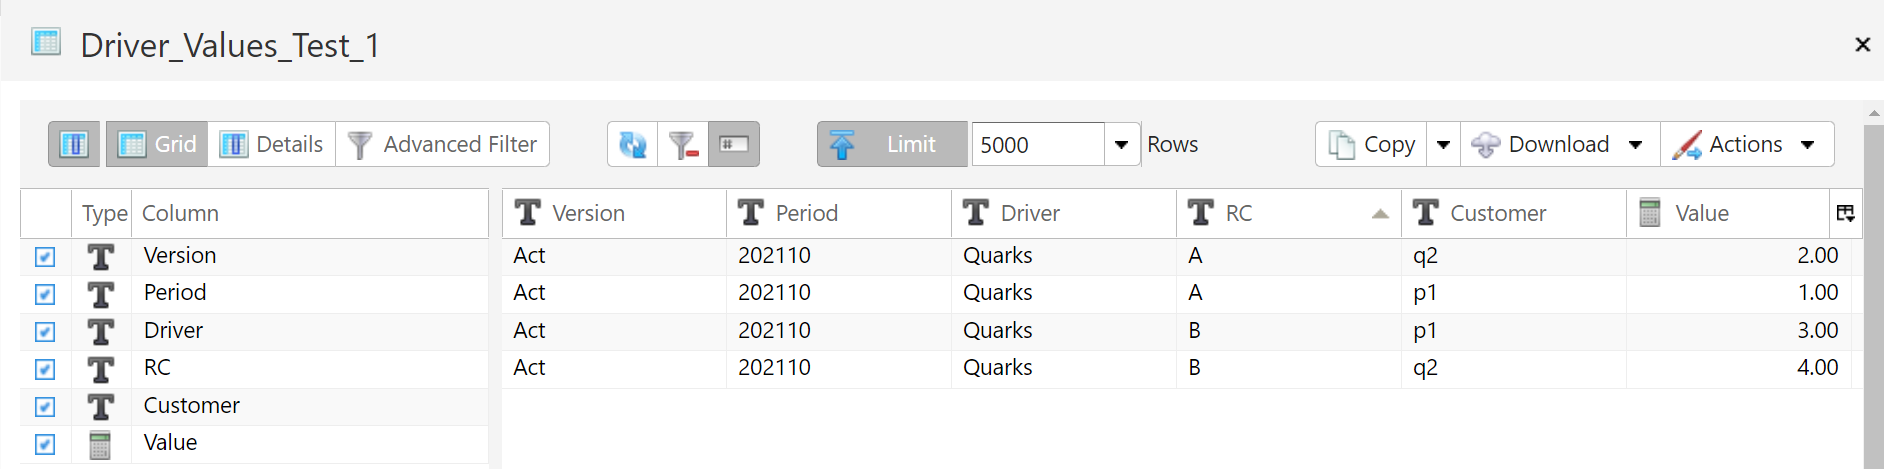
驱动因素数据表
分配维度层次结构
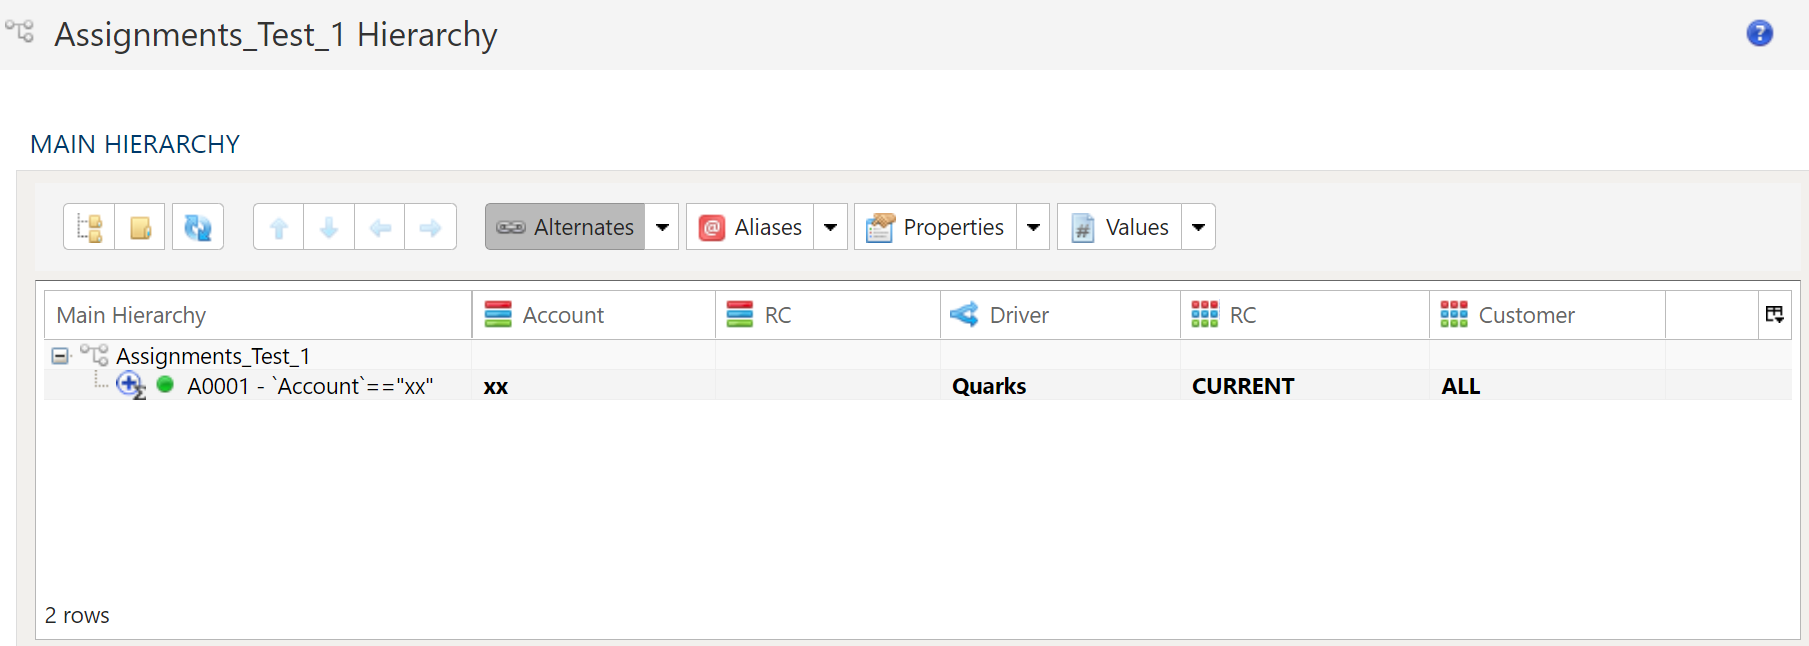
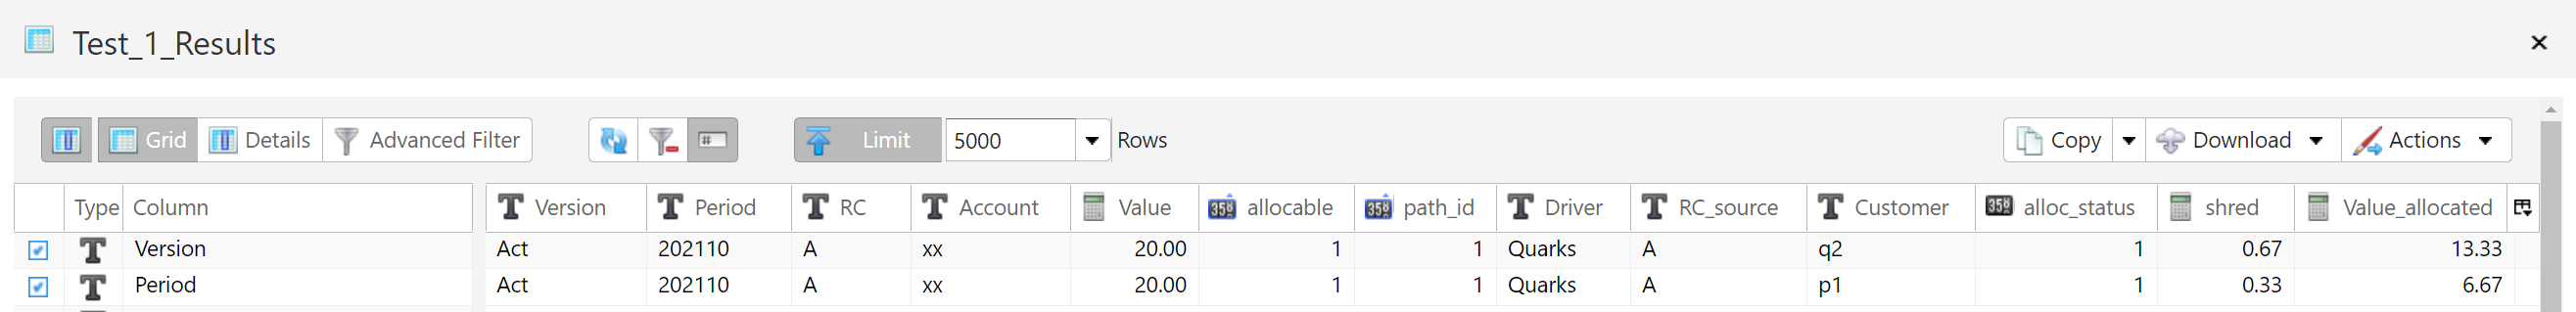
由于目标 RC 维度设置为当前,驱动因素数据将按待分摊值表中的源 RC 值进行筛选。 由于源 RC 中唯一的值是 “A”,分摊步骤将只使用 RC = A 的驱动因素值记录。
分摊结果表
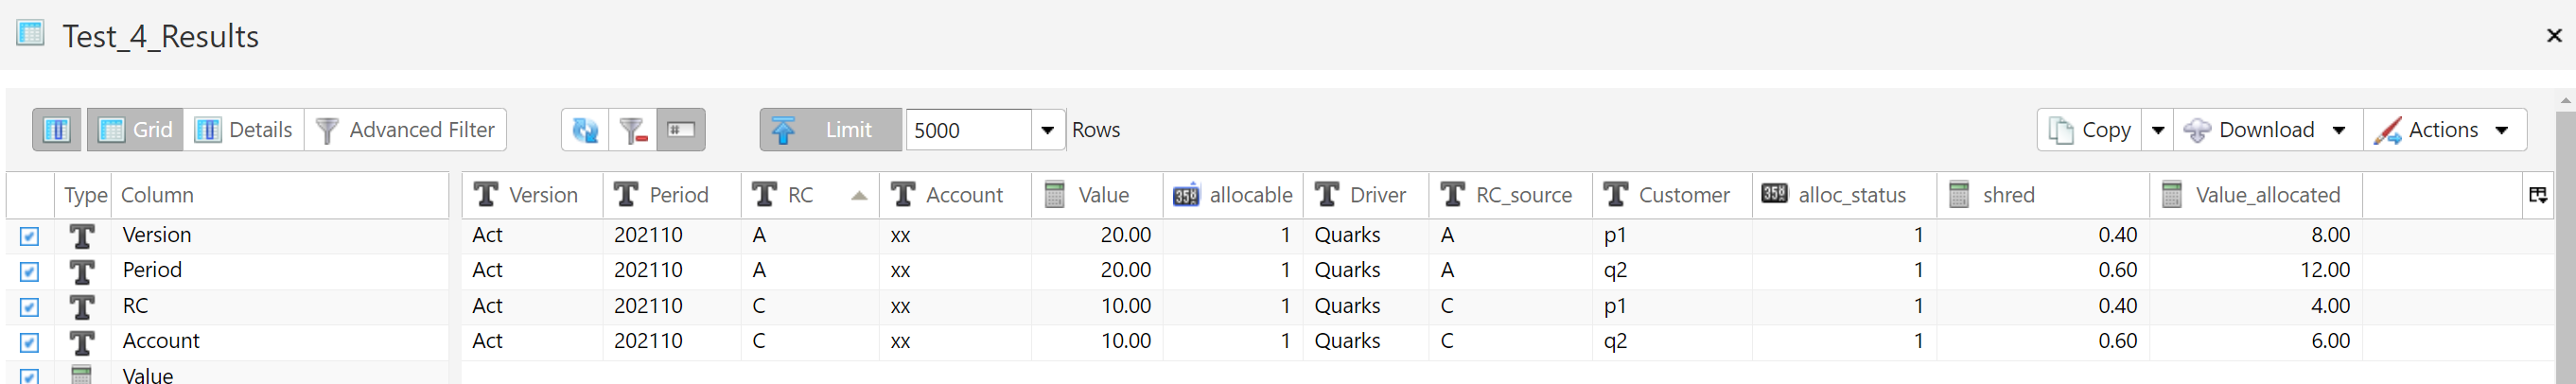
待分摊值表
驱动因素数据表
分配维度层次结构
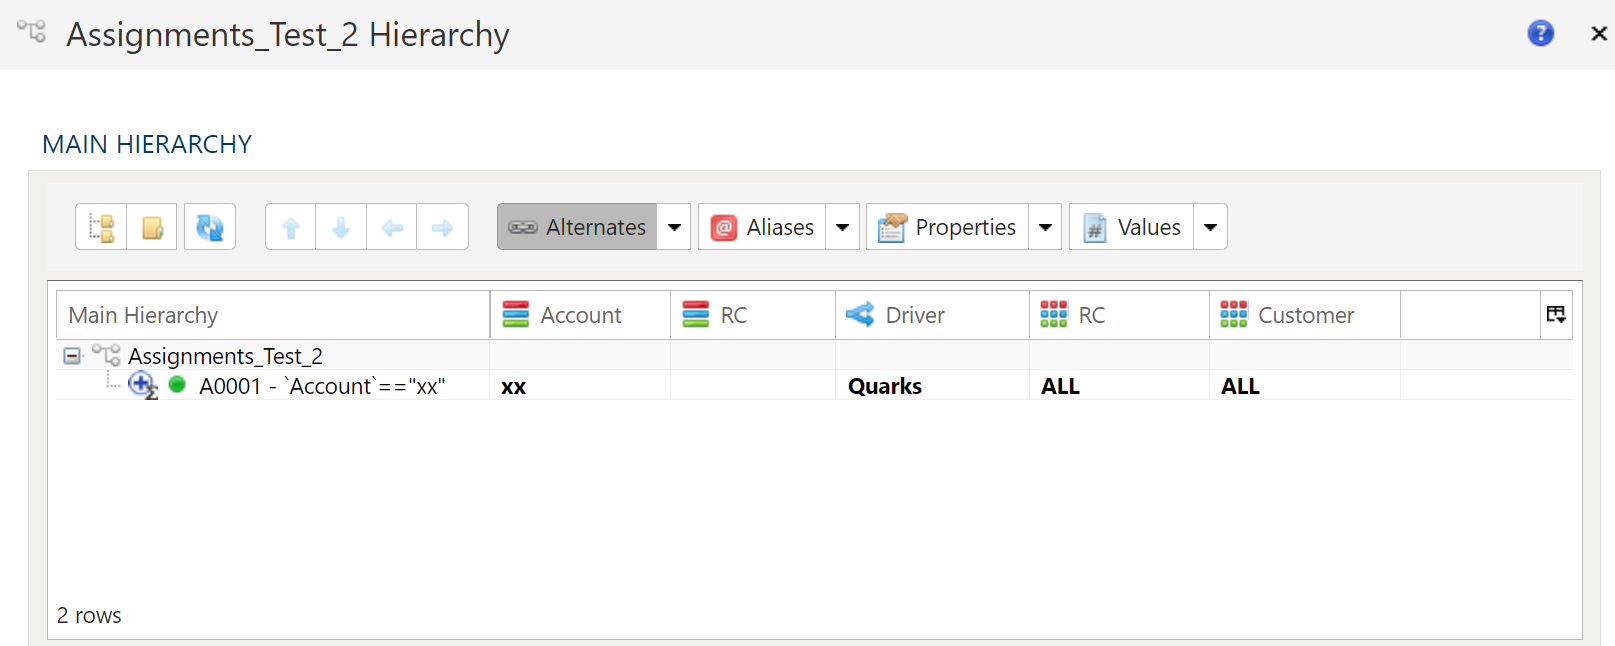
由于目标 RC 维度设置为全部,驱动因素数据将包含所有 RC 值,如分摊结果表的 RC 列中所示。
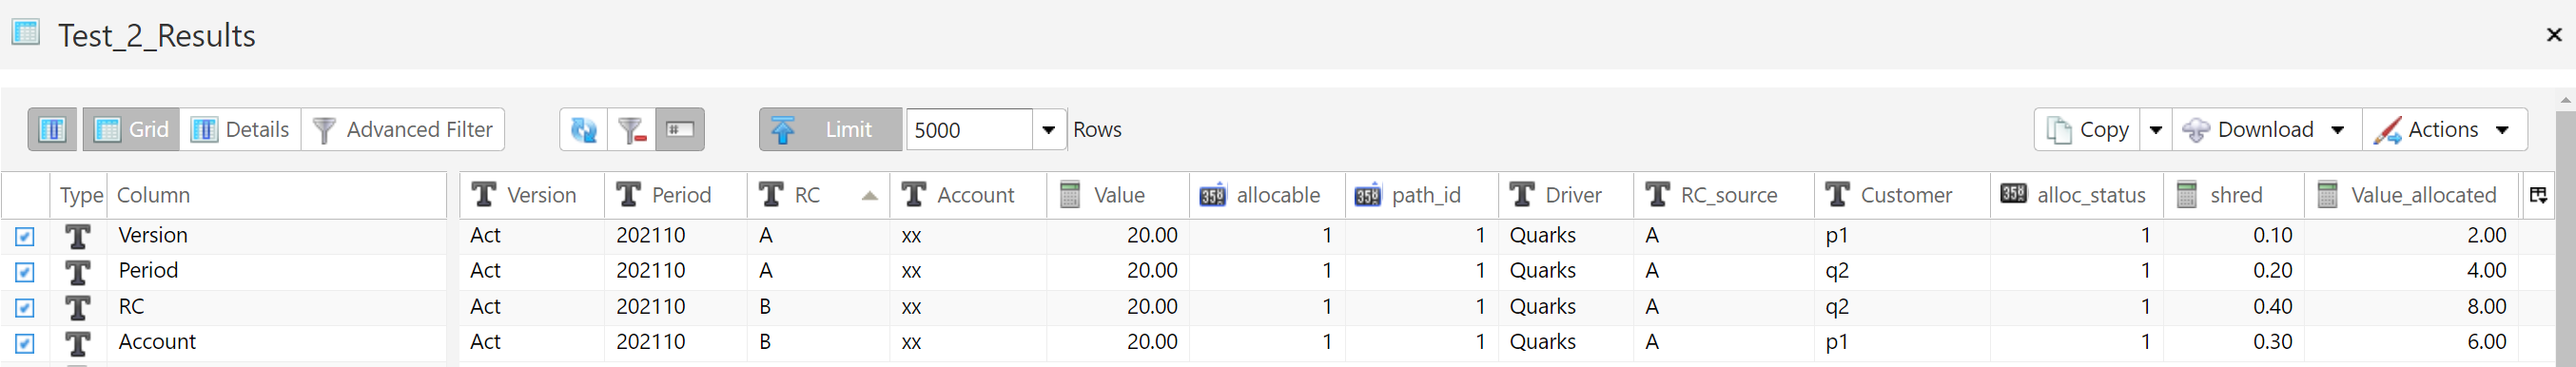
分摊结果表
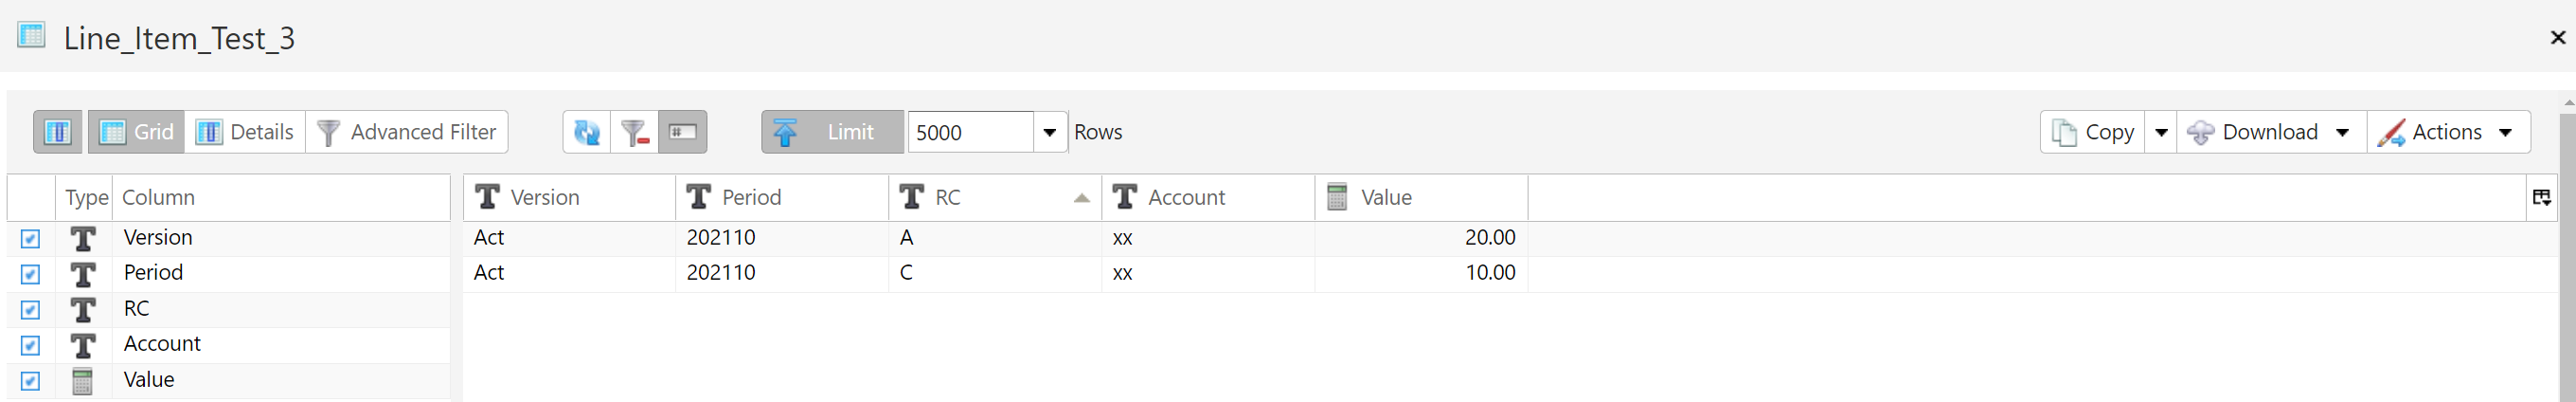
待分摊值表
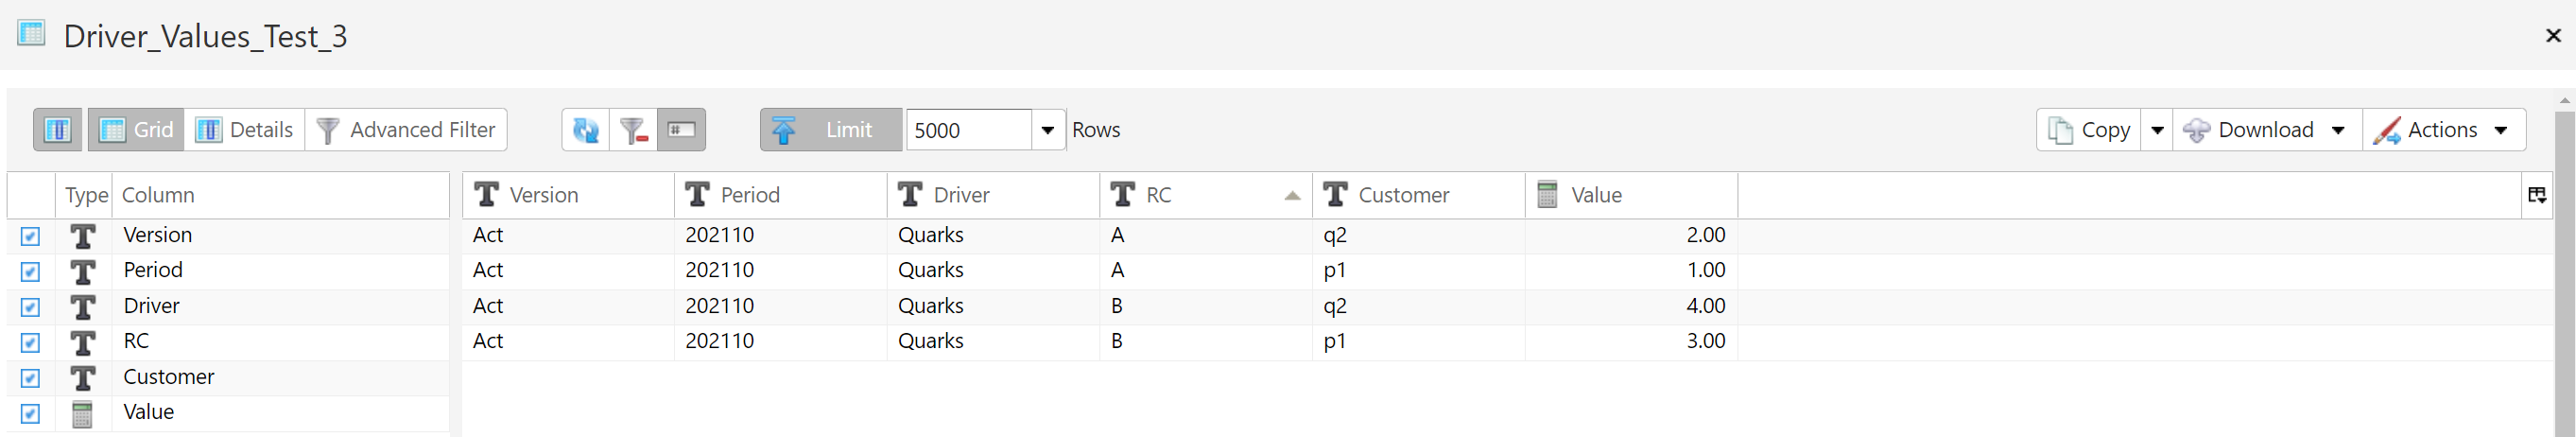
驱动因素数据表
分配维度层次结构
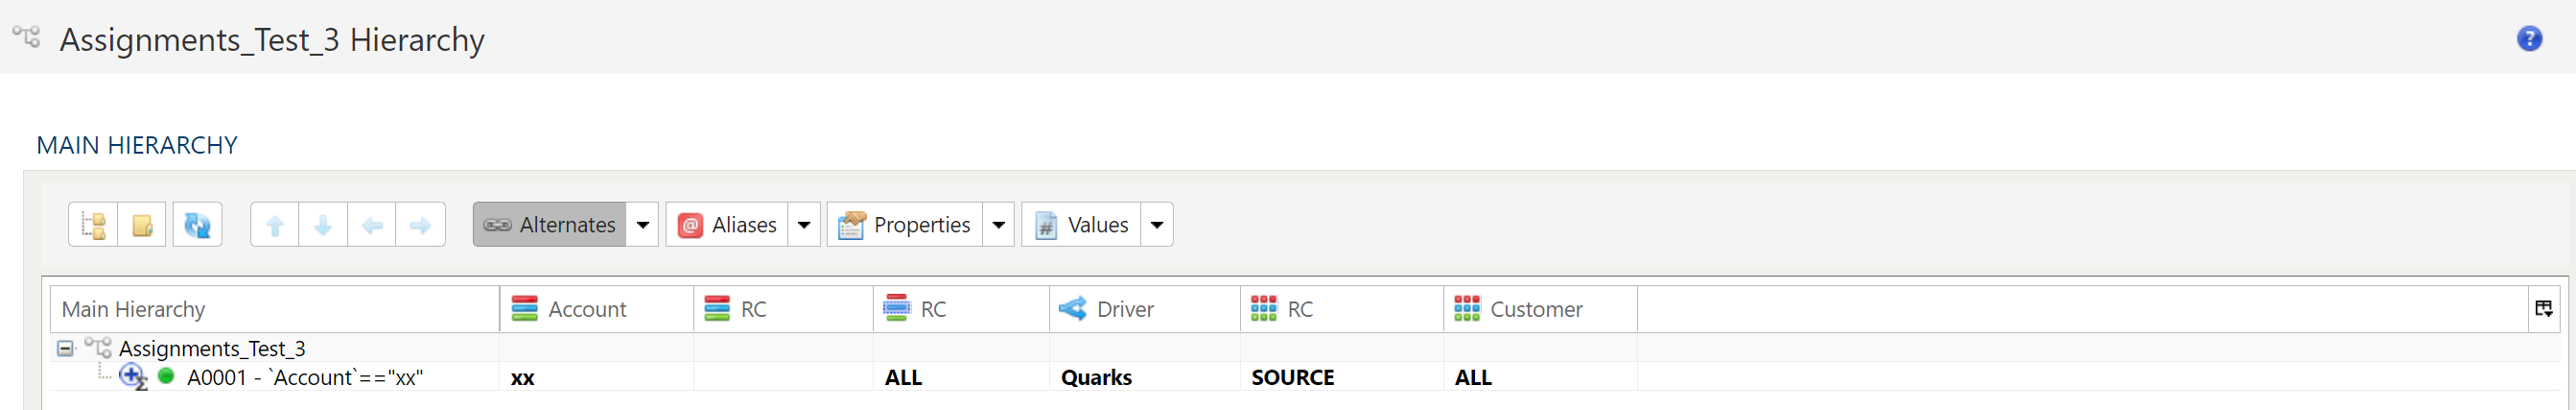
当上下文 RC 设置为全部、目标 RC 设置为源时,驱动因素数据将包含驱动因素数据中的所有RC。上下文 RC 会覆盖目标 RC 上的设置。
分摊结果表
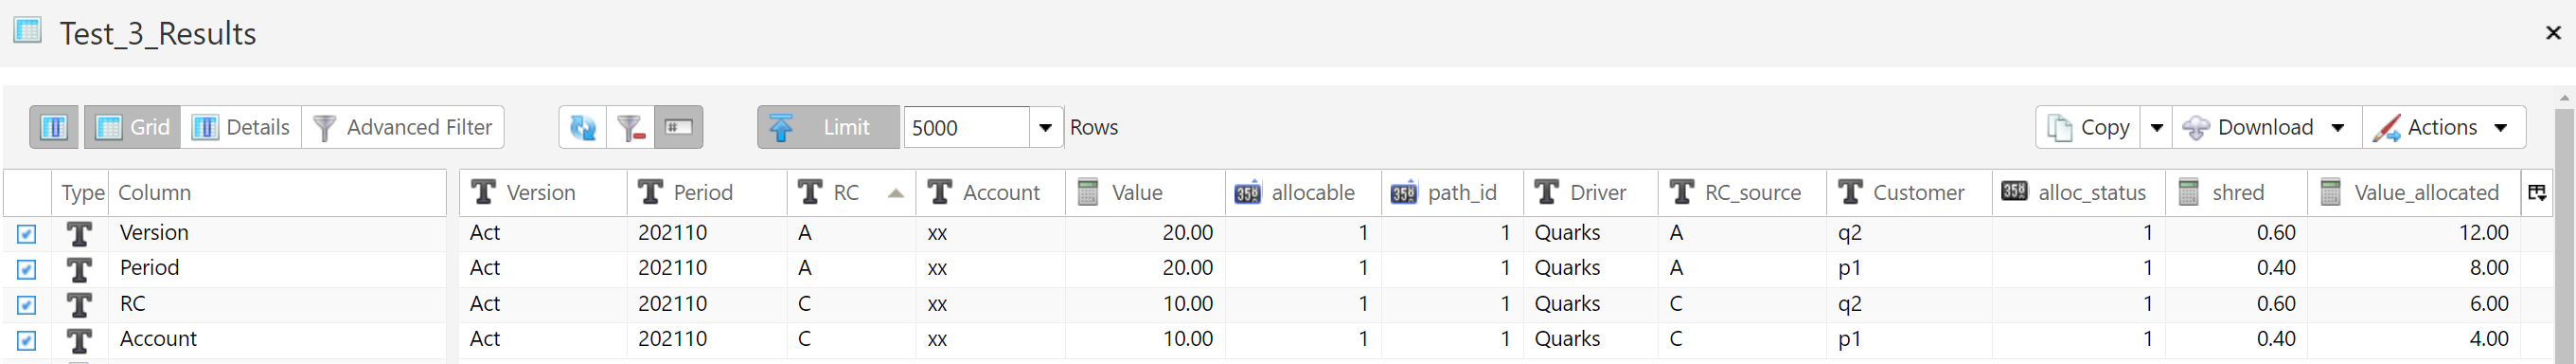
待分摊值表
驱动因素数据表
分配维度层次结构
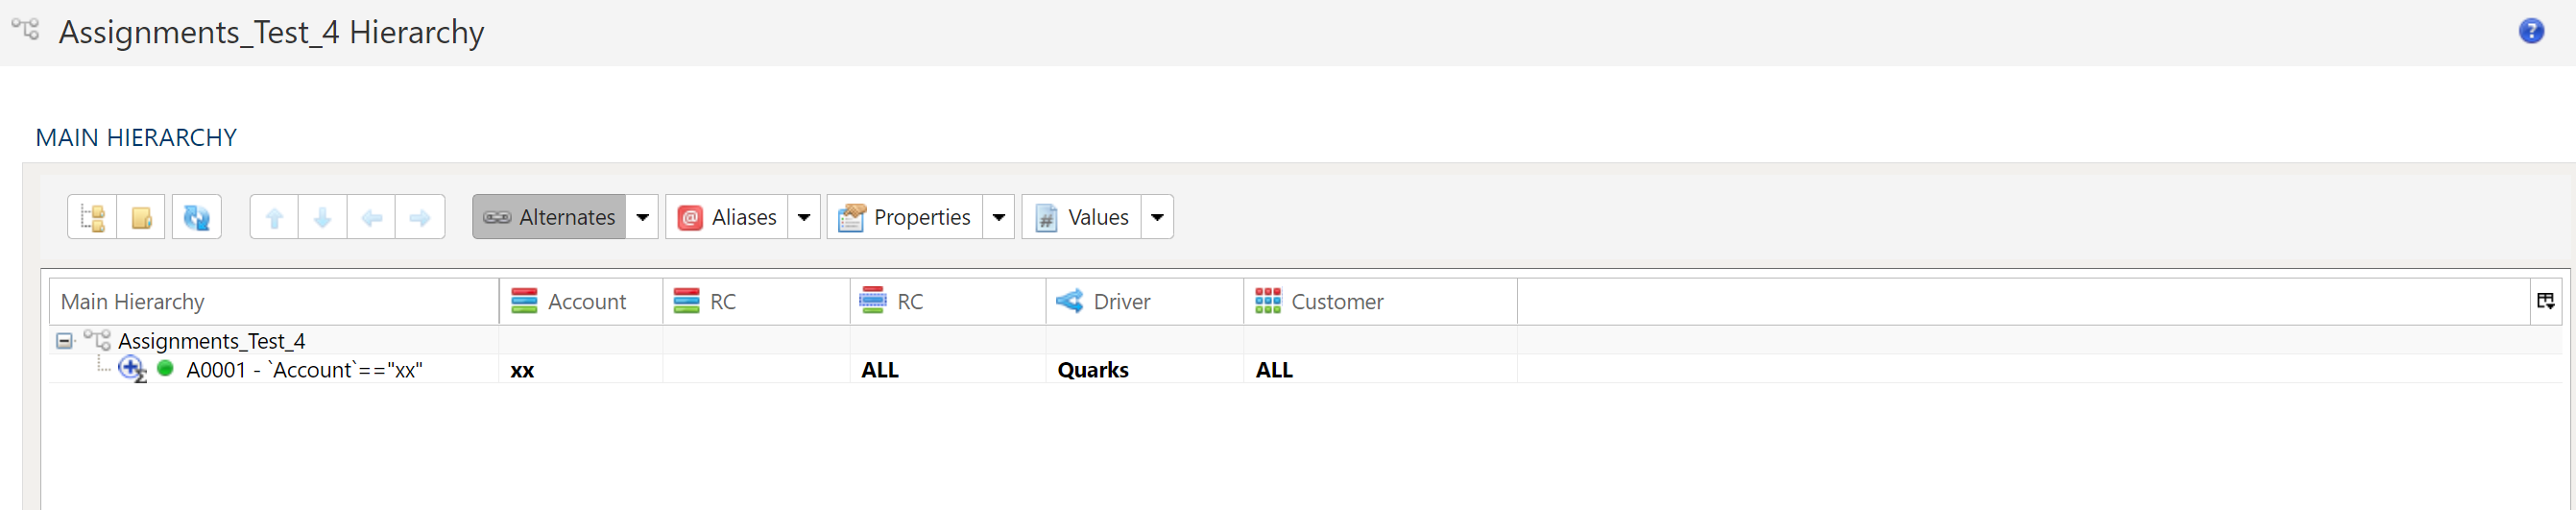
当上下文 RC 设置为全部时,驱动因素数据将包含驱动因素数据中的所有RC。
分摊结果表