

Table Union All
Description
Section intitulée « Description »Permet de combiner plusieurs tables de données ayant la même structure de colonnes en une seule table. Les données de séries temporelles, par exemple, s’y prêtent particulièrement bien. Le résultat contient tous les enregistrements des tables combinées.
La section Sources regroupe toutes les tables de données à ajouter les unes aux autres. En général, toutes les tables de données ont la même structure de colonnes (ou une structure similaire). Deux boutons permettent d’ajouter une table de données à la liste :
- Insérer une ligne
- Ajouter une ligne
Vous pouvez aussi faire un clic droit dans la fenêtre Sélectionner la source à modifier pour afficher les mêmes options. Un clic droit sur une table déjà ajoutée affiche également l’option Supprimer.
Pour que la transformation s’exécute correctement, la section Sources doit contenir une entrée pour chaque table de données source à ajouter. Ces entrées sont listées dans l’ordre où elles seront ajoutées. Pour modifier l’ordre, faites un clic droit sur une table afin d’afficher les options suivantes :
- Descendre (le cas échéant)
- Déplacer en bas (le cas échéant)
- Monter (le cas échéant)
- Déplacer en haut (le cas échéant)
Par défaut, chaque source se nomme New Frame, mais nous encourageons le modélisateur à lui donner un nom descriptif, en double-cliquant sur le nom pour le renommer.
Table cible
Section intitulée « Table cible »Par défaut, la Table cible est laissée vide. Avant de la nommer, notez que les noms des tables de données doivent respecter les conventions de nommage de Linux. Nous recommandons donc de n’utiliser que des caractères alphanumériques. Analyze supprime automatiquement les caractères non valides du nom. Il limite également la longueur à 256 caractères : soyez donc concis.
Table cible

Pour définir la table cible, sélectionnez une table existante à l’aide de la liste déroulante Table cible, ou cliquez sur le signe « + » vert pour créer une nouvelle table cible.
Création de table
Lorsque vous créez une nouvelle table, vous pouvez la créer soit comme Vue, soit comme Table.
Vues :
Les vues sont utiles car le temps d’exécution d’une étape est nettement inférieur à celui d’une étape qui utilise une table. L’inconvénient des vues est qu’elles se prêtent moins à l’exploration des données dans le mode Détails de la table.
Tables :
Lorsque la cible est une table, l’exécution d’une étape prend plus de temps, mais l’exploration des données dans le mode Détails est bien plus rapide qu’avec une vue.
Onglet Sélection des données de la table
Section intitulée « Onglet Sélection des données de la table »Table source
Section intitulée « Table source »Sélection des tables
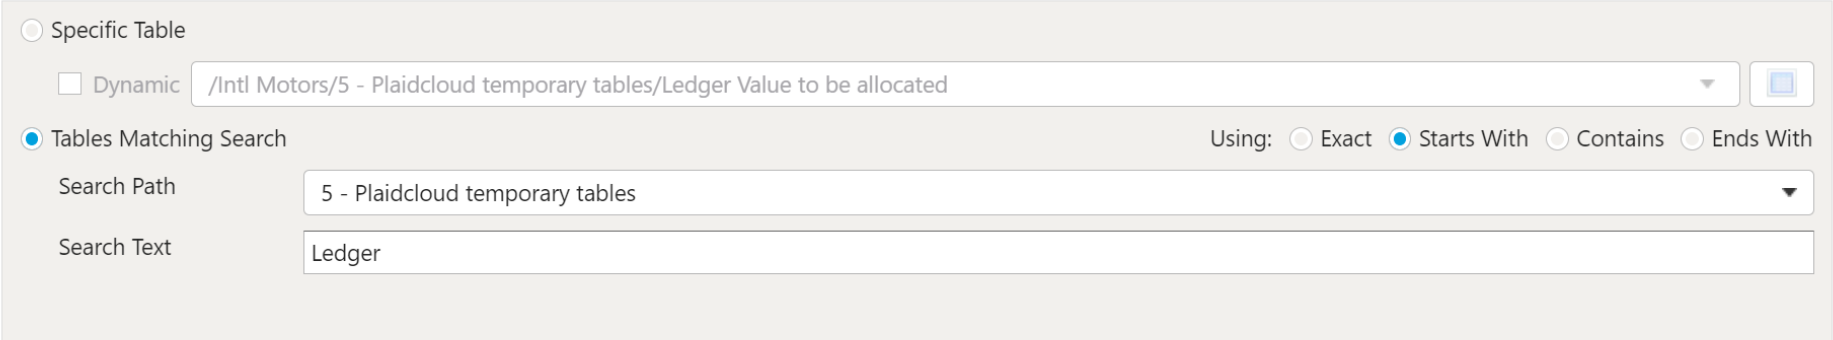
Il existe deux options pour sélectionner la table ou, avec la seconde option, les tables à utiliser :
La première option consiste à utiliser la liste déroulante Table spécifique pour sélectionner la table.
La seconde consiste à utiliser l’option Tables correspondant à la recherche, dans laquelle vous indiquez le Chemin de recherche et le Texte de recherche pour sélectionner la ou les tables qui correspondent aux critères de recherche. Cette option est très utile si vous avez un workflow qui crée une série de tables portant des noms communs, enregistrées avec la date en suffixe.
Colonnes source
Section intitulée « Colonnes source »Configuration du Data Mapper
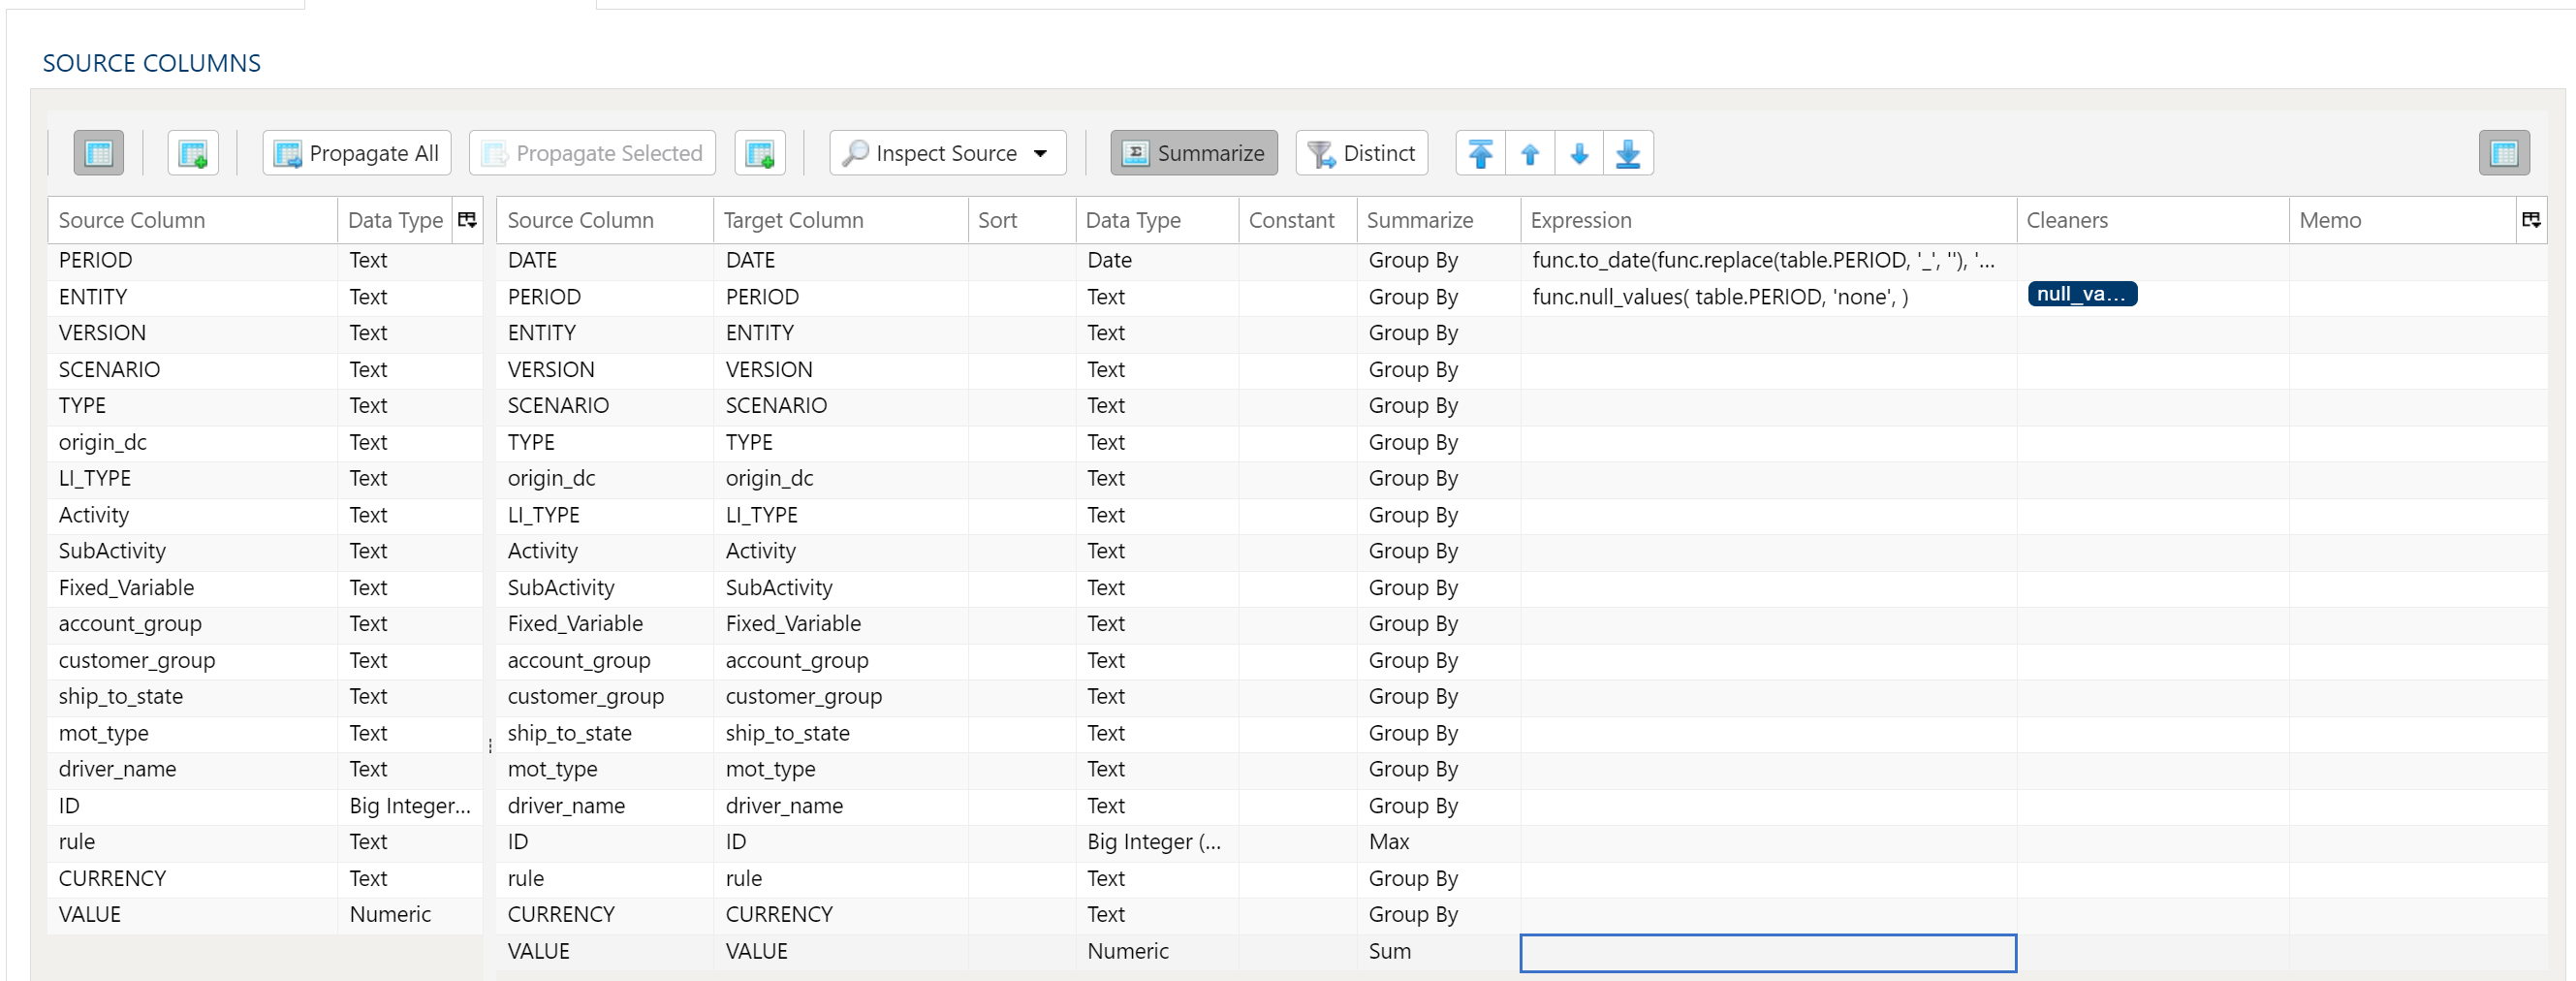
Le Data Mapper sert à mapper les colonnes des données source vers la table de données cible.
Inspection et remplissage du mappeur
Le bouton de menu Inspecter la source offre d’autres façons de mapper les colonnes de la source vers la cible :
- Renseigner les deux tables de mappage : propage toutes les valeurs de la table de données source vers la table de données cible. C’est le comportement par défaut.
- Renseigner uniquement la table de mappage source : mappe uniquement toutes les valeurs de la table de données source. C’est utile pour modifier un workflow existant lorsque la structure des colonnes source a changé.
- Renseigner uniquement la table de mappage cible : propage toutes les valeurs vers la table de données cible uniquement.
Si les options de colonnes source et cible ne suffisent pas, vous pouvez ajouter d’autres colonnes à la table de données cible de plusieurs façons :
- Tout propager insère toutes les colonnes source dans la table de données cible, qu’elles existent déjà ou non.
- Propager la sélection insère uniquement la ou les colonnes source sélectionnées.
- Faites un clic droit côté cible et sélectionnez Insérer une ligne pour insérer une ligne juste au-dessus de la ligne actuellement sélectionnée.
- Faites un clic droit côté cible et sélectionnez Ajouter une ligne pour insérer une ligne en bas (à l’extrême droite) de la table de données cible.
Suppression de colonnes
Pour supprimer des colonnes de la table de données cible, sélectionnez la ou les colonnes voulues, puis faites un clic droit et sélectionnez Supprimer.
Colonnes source qui ne sont plus listées
Une ligne cible peut nommer une Colonne source que la table de données source ne liste plus, par exemple après une nouvelle inspection de la source. L’étape ne supprime jamais une telle ligne à votre place. À la place, le nom de la colonne s’affiche en rouge derrière un signe d’avertissement ⚠, et le survol indique que la colonne ne figure pas dans les colonnes source. Dans une étape à plusieurs tables, comme une union, chaque table est vérifiée par rapport à ses propres colonnes source.
Une ligne avec une Constante, une Expression ou un résumé Nombre (valeurs nulles incluses) n’est jamais signalée, car l’étape ne lit pas sa colonne source. Rien n’est signalé tant que la table de données source ne liste aucune colonne, par exemple avant la première inspection de la source.
Lorsque vous enregistrez une étape qui contient encore des lignes signalées, une boîte de dialogue Colonnes obsolètes détectées les liste sous l’onglet ou la table concernés, et propose trois choix :
- Tout supprimer et enregistrer : supprime les lignes signalées, puis enregistre.
- Enregistrer quand même : enregistre l’étape telle quelle.
- Annuler : retourne à l’étape sans enregistrer.
Pour conserver une ligne et faire disparaître son avertissement, rajoutez la colonne à la table de données source, ou choisissez une colonne que la table de données source liste.
Colonnes absentes de la table source
Lorsque vous enregistrez, la table de données source elle-même est vérifiée dans son état actuel. Une colonne que l’étape liste dans ses colonnes source mais que la table n’a pas, par exemple une colonne qu’une étape précédente a renommée ou supprimée, signifie que les colonnes de l’étape sont obsolètes, et une étape qui lit une telle colonne échoue à l’exécution. L’enregistrement ouvre alors une boîte de dialogue Colonnes source manquantes qui nomme chaque table et les colonnes qui lui manquent, avec deux choix :
- Enregistrer quand même : enregistre l’étape telle quelle.
- Annuler : revient à l’étape sans enregistrer.
Rien n’est supprimé à votre place, car la table peut être la source du problème et peut encore changer avant l’exécution de l’étape. Lorsque des lignes sont aussi signalées comme n’étant plus listées, les deux apparaissent ensemble dans la boîte de dialogue Colonnes obsolètes détectées, et Tout supprimer et enregistrer ne supprime que les lignes signalées. Tant que la liste des colonnes source est vide, ce sont les colonnes mappées par l’étape qui sont vérifiées, à l’exception des lignes ayant un résumé Constante, Expression ou Nombre (valeurs nulles incluses), qui ne lisent aucune colonne.
Une source nommée à l’aide d’une variable, telle que {year}/Sales, est vérifiée selon la valeur de la variable au moment de l’enregistrement, et la boîte de dialogue nomme la table vérifiée, par exemple 2026/Sales (from {year}/Sales). Une variable définie par une boucle contient la valeur de sa dernière itération ; une boucle sur des tables de formes différentes peut donc avertir à propos d’une table que la prochaine exécution ne lira pas. Une table qui n’existe pas encore, par exemple une table créée par une étape antérieure du workflow, n’est pas vérifiée, pas plus qu’une source dont la variable n’a pas de valeur, qu’une table que l’étape trouve par recherche à l’exécution ou qu’une table qui ne peut pas être lue pour le moment.
Type de données d’une colonne
Chaque colonne cible possède un Type. Une colonne propagée depuis la source conserve le type de la colonne source ; une ligne que vous ajoutez à la main est de type Texte au départ, et vous définissez le Type pour indiquer ce qu’elle doit réellement être : une colonne que vous comptez additionner ou trier a besoin de son type numérique ou date, car le texte se trie et s’additionne comme du texte.
Une étape enregistrée avec une colonne sans aucun type s’exécute malgré tout. Le type est déterminé au démarrage de l’étape, à partir de la colonne source que cette colonne lit. Lorsqu’il n’y a rien à partir duquel le déduire, il est traité comme du texte : les colonnes d’une étape Extraire SQL proviennent de la requête que vous avez écrite et non d’une source mappée, et lorsque plusieurs sources portent le même nom de colonne avec des types qui divergent, le texte est utilisé plutôt que d’en deviner un : une mauvaise supposition produit une conversion que l’entrepôt peut rejeter, alors que tout se convertit en texte.
Définir vous-même le Type reste la façon d’indiquer ce qu’une colonne doit être. Le laisser vide revient à accepter ce que la colonne source se trouve être.
Modification de l’ordre des colonnes
Pour réorganiser les colonnes de la table de données cible, sélectionnez la ou les colonnes voulues. Vous pouvez utiliser l’une ou l’autre des méthodes suivantes :
- Flèches de déplacement groupé : sélectionnez l’option de déplacement voulue avec les flèches en haut à droite.
- Menu contextuel : faites un clic droit et sélectionnez Déplacer en haut, Monter, Descendre ou Déplacer en bas.
Réduire le résultat aux seuls enregistrements distincts
Pour ne renvoyer que des valeurs distinctes, sélectionnez l’option de menu Distinct. Un ensemble de cases à cocher s’affiche pour chaque colonne de la source. Il suffit de cocher la case en regard d’une colonne pour ne renvoyer que des résultats distincts.
Selon la situation, vous pouvez envisager d’utiliser plutôt la synthèse.
Le processus de distinction conserve le premier enregistrement unique trouvé et écarte les autres. Vous pouvez appliquer un tri aux données s’il est important d’obtenir des résultats cohérents d’une exécution à l’autre.
Agrégation et regroupement
Pour agréger les résultats, sélectionnez l’option de menu Résumer. Un ensemble de listes de sélection s’affiche pour chaque colonne de la table de données cible. Choisissez une méthode de synthèse adaptée à chaque colonne.
Lorsque Inspecter la source remplit les colonnes, une colonne numérique commence à Regrouper par plutôt qu’à Somme si son nom ressemble à un identifiant, comme id, customer_id, Order No ou CustomerKey, si sa table la définit comme une clé, ou si la jointure l’utilise comme clé.
- Regrouper par
- Somme
- Min
- Max
- Premier
- Dernier
- Nombre
- Nombre (valeurs nulles incluses)
- Moyenne
- Écart type
- Écart type d’échantillon
- Écart type de population
- Variance
- Variance d’échantillon
- Variance de population
- Avancé hors regroupement
Pour une utilisation avancée du Data Mapper, comme les expressions, le nettoyage et les constantes, consultez Utilisation avancée du Data Mapper.
Filtres de données
Section intitulée « Filtres de données »
Pour offrir un maximum de souplesse, des filtres de données sont disponibles sur les données source et sur les données cible. Pour les jeux de données volumineux, il peut être particulièrement avantageux de filtrer les lignes dès la source afin que les opérations suivantes portent sur un jeu de données plus petit.
Sélectionner un sous-ensemble de données
Ce type de filtre permet de filtrer les données source entrantes selon les conditions spécifiées.
Appliquer un filtre secondaire aux données de résultat
Ce type de filtre permet d’appliquer un filtre aux données de résultat après transformation, selon les conditions spécifiées. La possibilité d’appliquer un filtre au résultat transformé permet d’exclure des lignes en fonction du résultat de calculs complexes, de synthèses ou de fonctions de fenêtrage.
Découpage final de la table de données (limite)
Le découpage des lignes permet de limiter les lignes du jeu de résultats selon une plage et un point de départ.
Syntaxe des filtres
La syntaxe des filtres utilise Python SQLAlchemy, qui est la même syntaxe que celle des autres expressions.
Consultez des exemples et des fonctions d’expression dans la section Expressions.
Correspondance des colonnes
Section intitulée « Correspondance des colonnes »Faire correspondre les colonnes par, sous Table cible, détermine comment les sources s’alignent :
- Nom (par défaut) — les colonnes de chaque source sont mises en correspondance par nom avec celles de la première source.
- Position — les sources sont empilées dans l’ordre, comme le fait
unionde Spark. Le résultat reprend les noms de colonnes de la première source, et chaque source doit avoir le même nombre de colonnes. Le mappage des colonnes de chaque source n’est pas utilisé, et son onglet Sélection des données de la table est donc désactivé.
Avec Position, chaque colonne prend un type qui convient à toutes les sources : deux types numériques deviennent le plus large des deux, une date et un horodatage deviennent un horodatage, et les autres mélanges deviennent du texte. Une colonne booléenne ou binaire mélangée à un autre type n’a pas de type commun et fait échouer l’étape, de même que des sources comptant un nombre de colonnes différent.
Si toutes les tables sources sont absentes, l’étape se termine avec un avertissement au lieu d’échouer, quel que soit le mode.
Contrôles effectués à l’enregistrement
Section intitulée « Contrôles effectués à l’enregistrement »Chaque source doit produire les mêmes colonnes que la première source : les mêmes noms de colonnes et, lorsque les deux en déclarent un, le même type. La table cible est construite à partir des colonnes de la première source. Une source peut lister ses colonnes dans un ordre différent, car elles sont mises en correspondance par nom. L’enregistrement d’une étape dont les sources diffèrent est refusé, avec le détail de chaque différence : La source « east » doit produire les mêmes colonnes que « west » : region manquante ; absente de « west » : area.
L’enregistrement renseigne aussi, à partir de sa table, le mappage de chaque source qui a une table source mais aucune colonne source ou cible, comme le ferait Renseigner les deux tables de mappage.