

Architecture IA et LLM
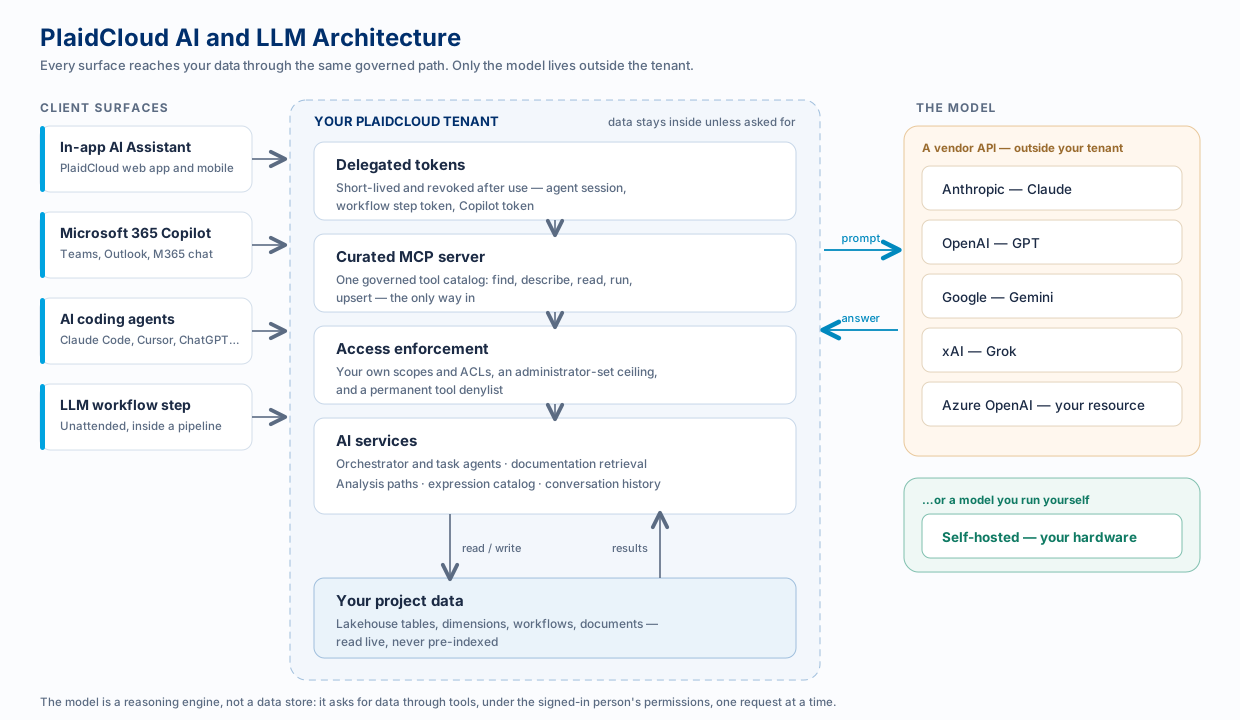
PlaidCloud n’a pas une seule fonctionnalité d’IA. Il offre quatre façons d’accéder à un modèle (l’assistant intégré au produit, Microsoft 365 Copilot, les agents de codage externes et une étape LLM dans un workflow), et toutes les quatre passent par le même chemin gouverné. Le modèle lui-même est interchangeable : Claude, GPT, Gemini, Grok, une ressource Azure OpenAI dans votre propre abonnement, ou un modèle que vous hébergez vous-même.
Cette section explique cette architecture : ce qui s’exécute où, ce qui franchit la frontière, et pourquoi.
Les quatre surfaces
Section intitulée « Les quatre surfaces »| Surface | Qui l’utilise | Comment le modèle accède aux données | Pour commencer |
|---|---|---|---|
| Assistant IA intégré | Toute personne travaillant dans PlaidCloud | Les agents propres à PlaidCloud appellent des outils internes en votre nom | Weave AI Chat |
| Microsoft 365 Copilot | Des équipes entières, dans Teams et Outlook | Un agent publié authentifie la personne, puis appelle le serveur MCP | Microsoft 365 Copilot |
| Agents de codage IA | Analystes et développeurs | Leur client se connecte directement au serveur MCP via OAuth | Prise en main |
| Étape de workflow LLM | Pipelines automatisés | Avec Anthropic, un jeton limité aux seuls objets que vous liez ; avec les autres fournisseurs, aucun accès aux données (voir les règles de l’étape) | Étape LLM |
Elles diffèrent par la personne qui pilote et par l’endroit où la conversation a lieu. Elles ne diffèrent pas par ce que le modèle est autorisé à toucher.
Un chemin gouverné unique
Section intitulée « Un chemin gouverné unique »Quelle que soit la surface par laquelle arrive une question, les cinq mêmes principes s’appliquent.
-
Le modèle s’exécute en tant que personne, pas en tant que plateforme. Chaque requête porte un identifiant de courte durée, révoqué dès qu’elle est terminée, qui représente l’utilisateur connecté. Aucun compte de service partagé disposant de droits élevés ne se cache derrière l’IA.
-
Les outils sont la seule voie d’accès. Le modèle ne peut pas interroger directement votre Lakehouse. Il appelle un catalogue organisé d’outils (rechercher, décrire, lire, exécuter, upsert), et chaque appel est vérifié indépendamment.
-
Vos propres autorisations la limitent toujours. Une requête d’IA ne peut jamais voir ni modifier ce que vous ne pourriez pas voir ou modifier vous-même. La couche d’IA restreint l’accès ; elle ne l’élargit jamais.
-
Un administrateur fixe le plafond, et il démarre fermé. L’Accès de l’agent d’une connexion LLM commence en lecture seule. Microsoft 365 Copilot commence sans aucun accès : tant qu’un administrateur n’a pas attribué un niveau d’accès à une personne, celle-ci connectée n’obtient aucune donnée. Ce sont deux mécanismes distincts, mais relever l’un ou l’autre ne fait que plafonner ce que l’IA peut tenter ; cela n’élargit jamais ce que vous pouviez déjà atteindre vous-même.
-
Certaines actions sont définitivement interdites. Les paramètres d’identifiants et de connexion, la gestion des identités et des groupes, les modifications du contrôle d’accès, la publication et le code déployable ne peuvent jamais être appelés par un identifiant d’IA, quelles que soient les autorisations accordées par un administrateur, avec n’importe quel fournisseur. Ces actions restent réservées aux humains.
Le parcours d’une question
Section intitulée « Le parcours d’une question »Prenons la question « Pourquoi le coût informatique alloué pour Atlanta a-t-il augmenté le trimestre dernier ? », posée depuis n’importe quelle surface :
-
Un identifiant est généré pour la personne qui pose la question, avec un périmètre limité et une courte durée.
-
Les outils sont présentés au modèle : restreints à ce dont la question a vraisemblablement besoin sur les surfaces qui font cette restriction, découverts dans le catalogue sur celles qui ne la font pas.
-
L’invite est envoyée au modèle : la question, les éventuelles règles permanentes et les descriptions des outils. Pas encore de données.
-
Le modèle demande des données par des appels d’outils : résoudre le chemin d’analyse, lire le schéma, exécuter la trace d’allocation, lire les lignes d’inducteurs. Chaque appel est soumis à un contrôle des autorisations dès son arrivée.
-
Le modèle répond à partir de ce qui lui est revenu, cite la page de documentation s’il en a consulté une, et fournit un indicateur de confiance ainsi que des réserves.
-
L’identifiant est révoqué. Un jeton capturé ne peut pas être rejoué une fois la requête terminée.
Le détail important se situe à l’étape 4 : le modèle ne possède pas vos données. Il en demande des extraits, et chaque demande est examinée.
À lire ensuite
Section intitulée « À lire ensuite »Voir aussi
Section intitulée « Voir aussi »- Des réponses fiables : comment les réponses sont notées et assorties de réserves
- Chemins d’analyse : des noms conviviaux pour les tables sur lesquelles votre équipe pose des questions
- Architecture de la plateforme : la place de l’IA dans l’ensemble de la plateforme