

Utiliser votre propre LLM maîtrisé
Si vos données incluent des informations de santé protégées, des données personnelles, des secrets commerciaux ou quoi que ce soit relevant de un contrat qui précise où elles peuvent être traitées, la question qui compte n’est pas de savoir quel modèle est le plus intelligent. C’est l’infrastructure de qui voit l’invite.
PlaidCloud traite le modèle comme un composant remplaçable, afin que vous puissiez répondre vous-même à cette question.
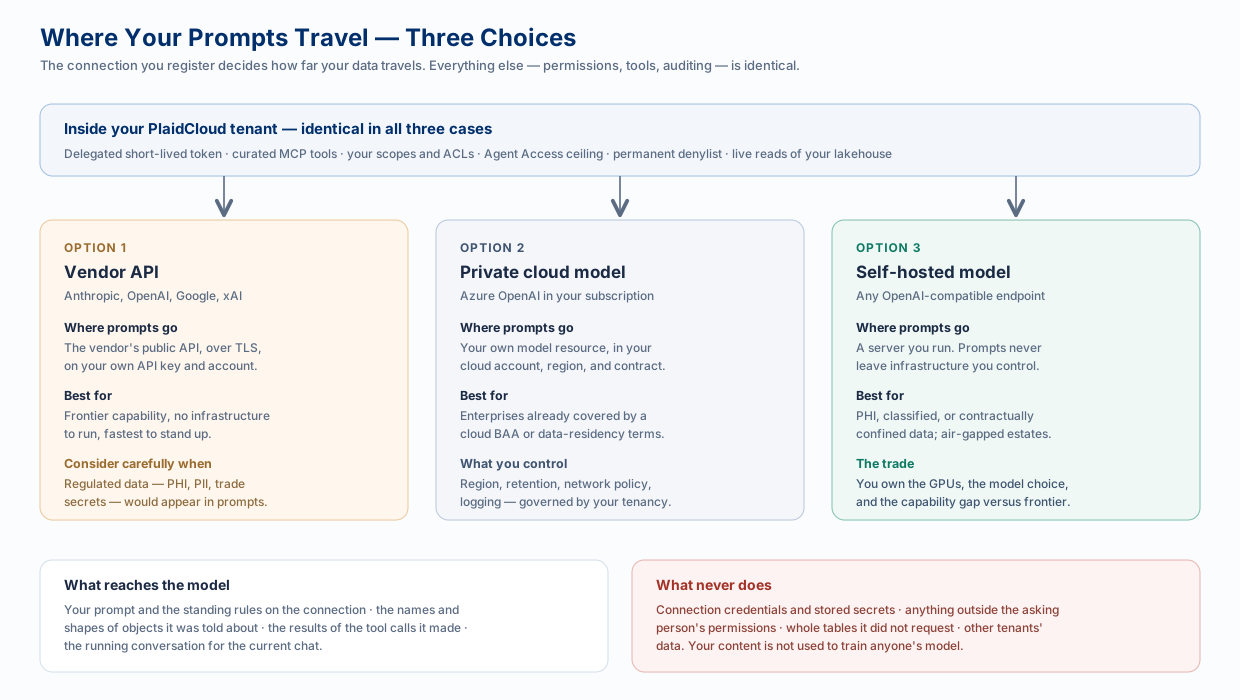
Les trois choix
Section intitulée « Les trois choix »| API de fournisseur | Modèle de cloud privé | Modèle auto-hébergé | |
|---|---|---|---|
| De quoi il s’agit | L’API publique d’Anthropic, OpenAI, Google ou xAI | Une ressource Azure OpenAI dans votre propre abonnement | Tout point de terminaison compatible OpenAI que vous exploitez |
| Qui voit l’invite | Le fournisseur, selon ses conditions et votre compte | Votre locataire cloud, selon votre contrat | Vous seul |
| Région et conservation | Celles du fournisseur | À définir par vous | À définir par vous |
| Capacité | De pointe | De pointe, un cran derrière l’API publique | Ce que vous pouvez héberger |
| Vous exploitez | Rien | Une ressource cloud | Des serveurs et des GPU |
| Convient pour | L’analytique générale sur des données non sensibles | Les entreprises déjà couvertes par un contrat cloud | Les données de santé (PHI), classifiées, isolées du réseau ou contractuellement confinées |
Les trois se configurent de la même manière : une connexion Fournisseur LLM avec un fournisseur, une clé, un modèle et, pour les deux derniers, une URL de base pointant vers votre point de terminaison.
Pourquoi un modèle maîtrisé vaut l’effort
Section intitulée « Pourquoi un modèle maîtrisé vaut l’effort »L’invite est l’exposition, et l’invite contient vos données. Un assistant ancré dans les données est utile précisément parce que de vraies lignes parviennent au modèle : effectifs de patients par établissement, tarifs non publiés, une structure de coûts que vous n’enverriez pas par e-mail. Tout le reste de l’architecture (autorisations, filtrage des outils, jetons de courte durée) régit ce qui quitte vos systèmes. Le choix du modèle régit l’endroit où cela atterrit.
Pointer PlaidCloud vers un modèle que vous maîtrisez signifie :
- Un sous-traitant de moins à régulariser. Aucun sous-traitant tiers à ajouter à un accord de protection des données, à un BAA ou à une revue de fournisseur, car l’inférence a lieu dans un environnement déjà couvert.
- Une résidence des données démontrable. « Traité dans cette région, dans ce compte, selon ce contrat » est une affirmation que vous pouvez prouver, pas une que vous devez croire sur parole.
- Conservation et journalisation selon vos conditions. Vous décidez si les invites sont conservées, pendant combien de temps, et qui peut lire les journaux.
- Cela résiste à un changement de politique. Les conditions d’un fournisseur peuvent changer ; une infrastructure que vous exploitez ne change pas sous vos pieds.
- Les parcs isolés du réseau obtiennent enfin un assistant. Pour les réseaux qui ne peuvent pas joindre une API publique, un modèle auto-hébergé est la seule option qui existe.
Ce qui atteint réellement le modèle
Section intitulée « Ce qui atteint réellement le modèle »Il est utile d’être précis, car la réponse est plus restreinte que ce que l’on suppose.
Envoyé au fournisseur :
- votre invite, ainsi que les règles permanentes de la connexion
- les noms et les formes des objets dont l’agent a été informé : noms des tables et des colonnes, noms des dimensions, chemins des documents liés
- les résultats des appels d’outils effectués par le modèle, c’est-à-dire les lignes qu’il a demandées et qu’il était autorisé à recevoir
- la conversation en cours pour la discussion actuelle
Jamais envoyé :
- les identifiants de connexion, les secrets stockés ou les en-têtes d’autorisation résolus
- tout ce qui dépasse les autorisations de la personne qui pose la question
- des tables entières que le modèle n’a pas demandées
- les données d’un autre tenant
Et votre contenu n’est utilisé pour entraîner le modèle de personne.
Pour quelles surfaces vous contrôlez le modèle
Section intitulée « Pour quelles surfaces vous contrôlez le modèle »C’est la partie à lire deux fois, car elle n’est pas uniforme.
| Surface | Quel modèle s’exécute |
|---|---|
| Étape de workflow LLM | Le vôtre. L’étape utilise la connexion Fournisseur LLM que vous épinglez ou celle par défaut de l’espace de travail. |
| Assistant IA intégré | Le vôtre, via la connexion Fournisseur LLM par défaut de l’espace de travail. Le backend multi-agents derrière certaines fonctions de l’assistant est défini par déploiement et peut pointer vers un modèle auto-hébergé ; organisez cela avec PlaidCloud. |
| Agents de codage IA | Le leur. Claude Code utilise Anthropic ; ChatGPT utilise OpenAI. PlaidCloud est la source de données, pas l’hébergeur du modèle. |
| Microsoft 365 Copilot | Celui de Microsoft. Copilot s’exécute sur les modèles de Microsoft dans votre tenant M365, selon votre contrat Microsoft. |
Mise en place
Section intitulée « Mise en place »-
Mettez en place le point de terminaison. Créez la ressource et le déploiement Azure OpenAI dans votre abonnement, ou exécutez votre modèle derrière une API compatible OpenAI.
-
Rendez-le accessible en HTTPS sur un nom d’hôte public résoluble. Les appels sortants sont validés avant d’être effectués : l’URL de base doit être en HTTPS, et une adresse de bouclage, de plage privée, de lien local ou de métadonnées cloud est refusée, les redirections étant désactivées. Placez un modèle auto-hébergé derrière une passerelle TLS sur un vrai nom d’hôte et restreignez au niveau du réseau les personnes qui peuvent y accéder.
-
Enregistrez la connexion. Choisissez le fournisseur, collez la clé, définissez l’URL de base et définissez le modèle ; pour Azure OpenAI, le champ du modèle correspond à votre Nom du déploiement.
-
Laissez l’Accès de l’agent sur Lecture seule sauf si une tâche précise exige davantage. C’est le contrôle le plus économique dont vous disposez.
-
Ajoutez vos règles. Les instructions permanentes sont l’endroit idéal pour les conventions de la maison : comment traiter les identifiants, ce qu’il ne faut jamais inclure dans une réponse, quelles réserves toujours mentionner.
-
Faites-en la valeur par défaut de l’espace de travail, ou épinglez-la sur les étapes de workflow précises qui traitent des données réglementées.
Un compromis raisonnable
Section intitulée « Un compromis raisonnable »La sensibilité est rarement uniforme dans un espace de travail, et le modèle se choisit par connexion : il peut donc se choisir par tâche. Une organisation courante :
- un modèle de fournisseur de pointe par défaut dans l’espace de travail, pour les questions de schéma, l’aide à la documentation, la rédaction d’expressions et l’analyse de données non sensibles
- un modèle maîtrisé épinglé sur les étapes de workflow qui touchent des tables réglementées
Même plateforme, mêmes autorisations, même piste d’audit : deux rayons d’impact différents, adaptés aux données.
Voir aussi
Section intitulée « Voir aussi »- Fournisseurs LLM et connexions : les champs et les adaptateurs
- Architecture IA et LLM : le chemin gouverné commun à toutes les surfaces
- Récupération, ancrage et chemins d’analyse : pourquoi vos données ne sont jamais pré-indexées