

Fournisseurs LLM et connexions
Une connexion Fournisseur LLM est l’endroit où vous choisissez le modèle qui alimente l’IA dans votre espace de travail. Elle contient le fournisseur, votre clé API, un modèle par défaut et des instructions permanentes, et c’est le point où un administrateur décide de ce que le modèle est autorisé à faire.
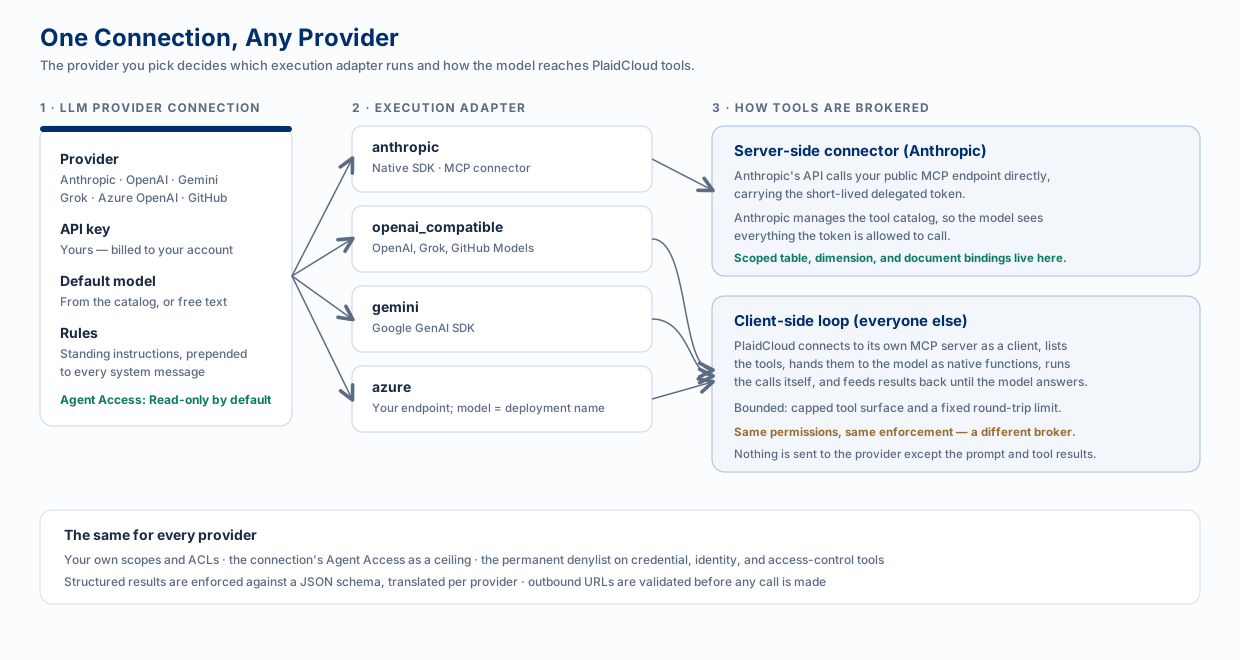
Ce que contient la connexion
Section intitulée « Ce que contient la connexion »| Champ | Rôle |
|---|---|
| Fournisseur | Anthropic, OpenAI, Google Gemini, xAI Grok, Azure OpenAI ou GitHub Models. |
| Clé API | La vôtre. L’utilisation est facturée sur votre compte auprès de ce fournisseur, et non revendue par PlaidCloud. |
| Modèle par défaut | Choisi dans la gamme actuelle du fournisseur, récupérée avec votre clé API. Autre… accepte un identifiant de modèle que vous saisissez, pour tout ce que la liste ne contient pas. |
| URL de base | Affichée uniquement pour les fournisseurs qui en lisent une : obligatoire pour Azure OpenAI (le point de terminaison de votre ressource), et remplacement facultatif pour OpenAI, Grok et GitHub Models. Anthropic et Gemini ne l’utilisent pas. |
| Version de l’API | Azure OpenAI uniquement. |
| Règles | Instructions permanentes ajoutées en tête de chaque message système : conventions de la maison, ton, ce qu’il ne faut jamais faire. |
| Accès de l’agent | Le plafond de ce que les agents et les étapes utilisant cette connexion peuvent faire. Lecture seule, sauf s’il est relevé. |
Le nom, le mémo et les personnes autorisées à voir la connexion se définissent également ici, et Tester la connexion vérifie la clé avant que vous ne vous y fiez.
Un espace de travail peut contenir plusieurs connexions ; l’une d’elles est marquée par défaut. Une étape de workflow peut épingler une connexion précise lorsqu’elle a besoin d’un autre modèle que celui par défaut de l’espace de travail.
Un espace de travail peut aussi contenir une ancienne connexion Anthropic Claude, antérieure au moment où le fournisseur est devenu un champ d’un seul type de connexion. Elle contient les mêmes paramètres et s’ouvre dans le même éditeur, avec le fournisseur figé sur Anthropic. Créez les nouvelles connexions comme Fournisseur LLM.
Fournisseurs et adaptateurs
Section intitulée « Fournisseurs et adaptateurs »Six fournisseurs visibles par l’utilisateur correspondent à quatre adaptateurs d’exécution. L’adaptateur détermine la forme de la requête et ce que le modèle peut atteindre. Les noms de fournisseurs ci-dessous sont les libellés tels qu’ils apparaissent dans la liste déroulante du formulaire de connexion.
| Fournisseur | Adaptateur | Remarques |
|---|---|---|
| Anthropic (Claude) | anthropic |
Le seul chemin avec des liaisons limitées vers des tables, des dimensions et des documents. |
| OpenAI (ChatGPT) | openai_compatible |
|
| xAI (Grok) | openai_compatible |
|
| GitHub Models | openai_compatible |
Modèles hébergés par GitHub pour les équipes centrées sur GitHub. |
| Google (Gemini) | gemini |
|
| Azure OpenAI | azure |
Le point de terminaison de votre ressource ; le « modèle » est votre nom du déploiement, et la version de l’API vient de la connexion. |
Comment les outils sont relayés
Section intitulée « Comment les outils sont relayés »Un LLM n’est utile ici que s’il peut appeler les outils PlaidCloud. Pour l’assistant interactif, il existe deux mécanismes, et celui qui s’exécute dépend du fournisseur. (L’étape de workflow LLM non supervisée fonctionne différemment ; lisez aussi cette section.)
Connecteur côté serveur : Anthropic
Section intitulée « Connecteur côté serveur : Anthropic »L’API d’Anthropic se connecte elle-même à votre point de terminaison MCP PlaidCloud, en portant le jeton délégué de courte durée. Anthropic gère le catalogue d’outils de son côté, de sorte que le modèle voit tout ce que le jeton est autorisé à appeler et découvre les outils sans aide.
C’est aussi le seul chemin qui prend en charge les liaisons limitées : voir ci-dessous.
Boucle côté client : tous les autres
Section intitulée « Boucle côté client : tous les autres »Les autres fournisseurs n’ont pas de connecteur équivalent ; PlaidCloud pilote donc lui-même la boucle : il se connecte à son propre serveur MCP en tant que client, liste les outils, les transmet au modèle sous forme de définitions de fonctions natives, exécute les appels demandés par le modèle, lui renvoie les résultats et recommence jusqu’à ce que le modèle produise une réponse.
Deux limites garantissent un comportement prévisible :
- Une surface d’outils plafonnée. Les fournisseurs limitent le nombre de fonctions qu’une requête peut déclarer, et chaque schéma consomme des jetons d’invite. L’ensemble exposé est plafonné, les méta-outils de découverte étant toujours présents pour que le modèle puisse encore trouver et invoquer tout ce qui se trouve hors de la liste directe.
- Une limite fixe d’allers-retours. Une boucle d’outils qui s’emballe s’arrête au lieu de consommer des jetons indéfiniment.
L’étape de workflow LLM est différente
Section intitulée « L’étape de workflow LLM est différente »Tout ce qui précède décrit l’IA interactive. L’étape de workflow LLM non supervisée n’utilise pas du tout la boucle côté client, et il vaut la peine de comprendre cette différence avant de choisir un fournisseur pour une telle étape.
| Fournisseur de la connexion de l’étape | Ce que l’étape peut faire |
|---|---|
| Anthropic | Accède à vos données via le connecteur MCP, limité aux liaisons limitées : les tables, dimensions et documents précis que vous avez nommés sur l’étape, chacun marqué en lecture ou en écriture. Tout ce qui se trouve hors de ces objets est refusé, même si l’outil existe. |
| Tous les autres | Aucun accès aux données. L’étape est une unique complétion structurée : invite, règles et schéma en entrée ; JSON en sortie. |
Deux conséquences en découlent directement :
- Les liaisons sont ignorées sur une étape non Anthropic. Elles ne sont ni honorées silencieusement ni source d’erreur : l’étape consigne que l’accès limité aux données est réservé à Anthropic et s’exécute sans elles. Si vous faites passer une étape liée d’Anthropic à un autre fournisseur, elle cesse de lire vos données.
- Un schéma de résultat est obligatoire sur une étape non Anthropic. Sans outils à appeler, la sortie structurée est la seule chose que produit l’étape.
Accès de l’agent
Section intitulée « Accès de l’agent »Chaque connexion LLM comporte un paramètre Accès de l’agent. C’est un plafond, toujours croisé avec les autorisations réelles de la personne qui agit.
| Accès de l’agent | Ce que les agents et les étapes de cette connexion peuvent faire |
|---|---|
| Lecture seule (par défaut) | Lister, décrire, lire les données de table, lire les membres de dimension, lire les documents, exécuter du SQL en lecture seule. |
| Lecture et écriture | Ce qui précède, plus les modifications que la personne est déjà autorisée à effectuer, via les outils d’écriture de PlaidCloud. Le SQL brut reste en lecture seule. |
| Complet (obsolète, supprimé le 15 janvier 2027) | L’ensemble complet des outils de la personne, y compris le SQL qui écrit. Utilisez plutôt Lecture et écriture. |
Quel que soit le réglage de l’Accès de l’agent, une liste d’interdictions inconditionnelle s’applique : les paramètres de connexion et d’identifiants, la propriété d’une connexion ou l’accès à celle-ci, les identifiants et ACL des comptes de documents, la gestion des membres et des groupes, la réinitialisation de mot de passe, les ACL de projet, le mode de comptabilisation ERP d’un projet, la publication, le code des fonctions définies par l’utilisateur et les déploiements d’applications. Ces éléments ne peuvent jamais être appelés par un identifiant d’IA.
Pour une étape de workflow Anthropic, l’Accès de l’agent interagit avec les liaisons : avec Lecture et écriture, l’écriture est accordée objet lié par objet lié, de sorte qu’une étape peut écrire dans la seule table que vous avez cochée et nulle part ailleurs.
Résultats structurés
Section intitulée « Résultats structurés »Lorsqu’une étape déclare un schéma de résultat, la réponse est validée par rapport à celui-ci plutôt qu’extraite de la prose. Comme les fournisseurs expriment les schémas différemment, le schéma est traduit pour chacun (le dialecte JSON strict pour les points de terminaison compatibles OpenAI, le sous-ensemble OpenAPI pour Gemini), et un refus ou une réponse tronquée est signalé comme une erreur à part entière au lieu d’un déroutant « JSON invalide ».
Garde-fous à connaître
Section intitulée « Garde-fous à connaître »- Les URL sortantes sont validées avant tout appel. Une URL de base doit être en HTTPS et doit se résoudre en une adresse publique ; les adresses de bouclage, de plage privée, de lien local et de métadonnées cloud sont rejetées, et les redirections sont désactivées pour qu’une réponse ne puisse pas détourner l’appel ailleurs.
- Les clés restent hors des journaux et des erreurs. Les erreurs des fournisseurs sont expurgées au lieu d’être renvoyées telles quelles avec des identifiants.
- Les règles sont des instructions, pas des autorisations. Les règles permanentes d’une connexion façonnent le comportement du modèle. Elles ne peuvent pas relever ce qu’il est autorisé à atteindre.
Voir aussi
Section intitulée « Voir aussi »- Architecture IA et LLM : les surfaces et le chemin commun
- Utiliser votre propre LLM maîtrisé : Azure OpenAI et options auto-hébergées
- Connexions : création et gestion des connexions en général