

Récupération, ancrage et chemins d'analyse
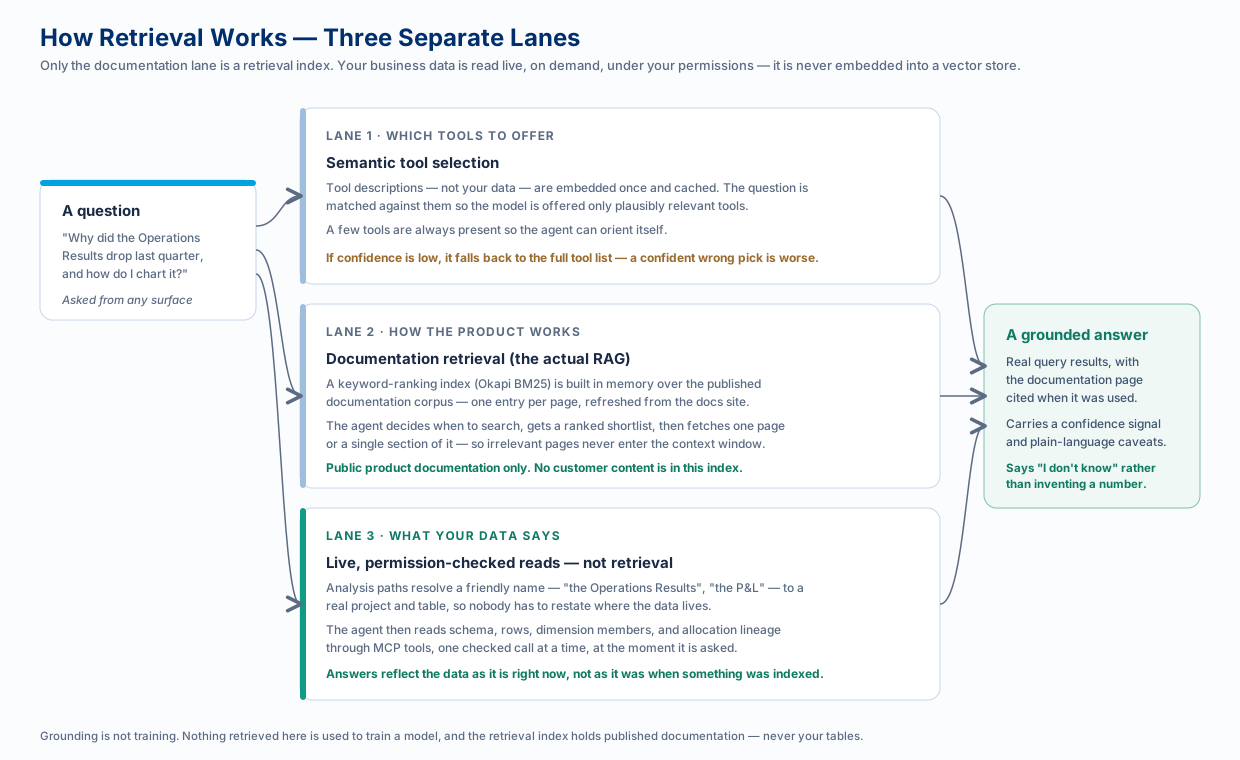
Le terme « RAG » désigne généralement une seule chose : découper le corpus en fragments, les vectoriser dans un magasin vectoriel et coller les correspondances les plus proches dans l’invite. PlaidCloud le fait pour un seul corpus, la documentation du produit, et ne le fait délibérément pas pour vos données.
Vos tables sont lues en direct, au moment où on les interroge, avec vos autorisations. Ce n’est pas un choix de performance ; c’est ce qui rend une réponse fiable et un contrôle d’accès significatif.
Voie 1 : choisir les outils à proposer
Section intitulée « Voie 1 : choisir les outils à proposer »Cette voie s’exécute pour l’assistant intégré, qui possède son propre catalogue d’outils. Chaque description d’outil qu’il présente au modèle consomme des jetons d’invite à chaque tour ; avant que le modèle ne voie quoi que ce soit, la question est donc comparée par similarité sémantique aux descriptions des outils (jamais à vos données), et seuls les outils vraisemblablement pertinents sont proposés.
Sur les autres surfaces, le catalogue d’outils est géré par la connexion MCP : le connecteur d’Anthropic le gère côté serveur, et la boucle côté client plafonne la surface qu’elle déclare. Les voies 2 et 3 ci-dessous s’appliquent partout.
Trois détails comptent :
- Les embeddings décrivent les outils, pas le contenu. Ils sont calculés une seule fois à partir des noms et des descriptions des outils, mis en cache, puis reconstruits automatiquement lorsqu’une description change.
- Quelques outils sont toujours présents pour que l’agent puisse s’orienter (déterminer qui pose la question et dans quel projet), même lorsque la question ne mentionne ni l’un ni l’autre.
- Une faible confiance revient à la liste complète. Une restriction faite avec assurance mais à tort est pire que de payer une fois le coût complet en jetons ; une correspondance incertaine affiche donc tout. Les tours très courts (« merci », « ok ») sautent entièrement cette étape.
Voie 2 : s’ancrer dans la documentation
Section intitulée « Voie 2 : s’ancrer dans la documentation »C’est la véritable voie de génération augmentée par la récupération, qui répond à « comment puis-je… », « qu’est-ce que… » et « où configurer… ».
La documentation publiée est récupérée sous forme de corpus structuré (une entrée par page) et indexée en mémoire avec Okapi BM25, une fonction de classement par mots-clés. L’agent procède alors en deux temps :
- La recherche renvoie une présélection classée de pages : slug, titre, description, score.
- La récupération extrait une page, ou une seule section nommée de celle-ci, une fois que l’agent a décidé laquelle lui est réellement nécessaire.
Le principe de conception est que l’agent décide quand chercher et quelle quantité lire. L’injection passive colle quelque chose dans chaque invite, que cela aide ou non ; la récupération pilotée par les outils garde les pages non pertinentes totalement hors de la fenêtre de contexte et permet à l’agent de citer la page qu’il a utilisée afin que vous puissiez y donner suite.
Si le corpus de documentation est brièvement injoignable, l’agent répond sans lui plutôt que de faire échouer le tour.
Voie 3 : lire vos propres données
Section intitulée « Voie 3 : lire vos propres données »Les questions sur vos chiffres ne reçoivent pas de réponse par la récupération. L’agent lit ce dont il a besoin, quand il en a besoin, via des outils soumis au contrôle des autorisations : schémas de tables, lignes, membres de dimension, lignage de workflow, traces d’allocation.
C’est pourquoi les réponses sont à jour (elles reflètent les données telles qu’elles sont maintenant, et non telles qu’elles étaient lors de la dernière indexation) et c’est pourquoi le contrôle d’accès fonctionne : il n’existe aucun index préconstruit susceptible de fuiter à travers une frontière d’autorisations, car il n’y a pas d’index.
Chemins d’analyse : la couche de nommage
Section intitulée « Chemins d’analyse : la couche de nommage »Les lectures en direct doivent savoir quelle table lire. Les chemins d’analyse sont le vocabulaire partagé qui rend cela simple : un nom convivial (« Résultats opérationnels », « le compte de résultat », « Effectifs ») associé une fois pour toutes à un projet et à une table réels, puis utilisable par tous les membres de l’espace de travail.
- Interrogez par nom au lieu de nommer un projet et une table à chaque fois.
- Marquez-en un comme valeur par défaut de l’espace de travail pour qu’un « qu’est-ce qui a changé le trimestre dernier ? » sans cible précise aboutisse quelque part de sensé.
- Tout le monde parle de la même chose. Quand toute l’équipe dit « le compte de résultat », elle atteint la même table.
Un administrateur les enregistre ; tout le monde peut les utiliser ; chaque question s’exécute toujours avec les propres autorisations de la personne qui la pose. Ils fonctionnent de la même façon depuis l’assistant intégré, Microsoft 365 Copilot et un agent de codage connecté. Consultez Chemins d’analyse pour savoir comment les configurer.
Le catalogue d’expressions
Section intitulée « Le catalogue d’expressions »Lorsque l’assistant écrit une expression, il ne devine pas les noms de fonctions de mémoire. Il consulte un catalogue structuré de toutes les fonctions d’expression PlaidCloud (nom, signature, lien vers la documentation, catégorie), recoupé avec les fonctions que votre entrepôt fournit réellement, avec des suggestions de correspondances proches lorsqu’un nom est presque juste. C’est une consultation, pas une recherche par similarité, car pour les noms de fonctions, « presque juste » veut dire faux.
L’ancrage n’est pas l’entraînement
Section intitulée « L’ancrage n’est pas l’entraînement »Deux choses préoccupent légitimement les gens :
- Rien de ce qui est récupéré ici n’entraîne un modèle. L’ancrage place de l’information dans une seule requête. Il ne modifie pas les poids du modèle, et votre contenu n’est utilisé pour entraîner le modèle de personne.
- L’index de récupération ne contient que de la documentation publique. Aucun contenu client n’y est vectorisé.
Où vont vos données, et comment les garder dans une infrastructure que vous contrôlez, est expliqué dans Utiliser votre propre LLM maîtrisé.
Pourquoi cela produit de meilleures réponses
Section intitulée « Pourquoi cela produit de meilleures réponses »L’ancrage permet à l’assistant de dire « je ne sais pas » plutôt que d’inventer quelque chose. Comme chaque chiffre provient d’une vraie requête et chaque affirmation sur le produit d’une vraie page de documentation, une réponse peut être notée : chacune porte un indicateur de confiance et des réserves en langage clair, et un résumé narratif est vérifié pour qu’il ne puisse pas omettre discrètement une limitation ni citer un chiffre que l’analyse n’a jamais produit. Consultez Des réponses fiables.
Voir aussi
Section intitulée « Voir aussi »- Chemins d’analyse : configurer les noms partagés
- Tracer les allocations : demander pourquoi un résultat a varié
- Architecture IA et LLM : les surfaces et le chemin commun