

Importer depuis SQL
Description
Section intitulée « Description »Importe le résultat d’une requête SQL exécutée sur une base de données externe dans une table de projet PlaidCloud. La requête s’exécute sur la base de données distante ; seul le jeu de résultats est amené dans PlaidCloud.
Diffère de Importer les tables de base de données externe en ce que vous écrivez vous-même le SQL, ce qui est utile pour les jointures, filtres ou agrégations complexes que vous voulez faire effectuer par la base de données source avant que les données n’arrivent dans PlaidCloud.
Paramètres d’importation
Section intitulée « Paramètres d’importation »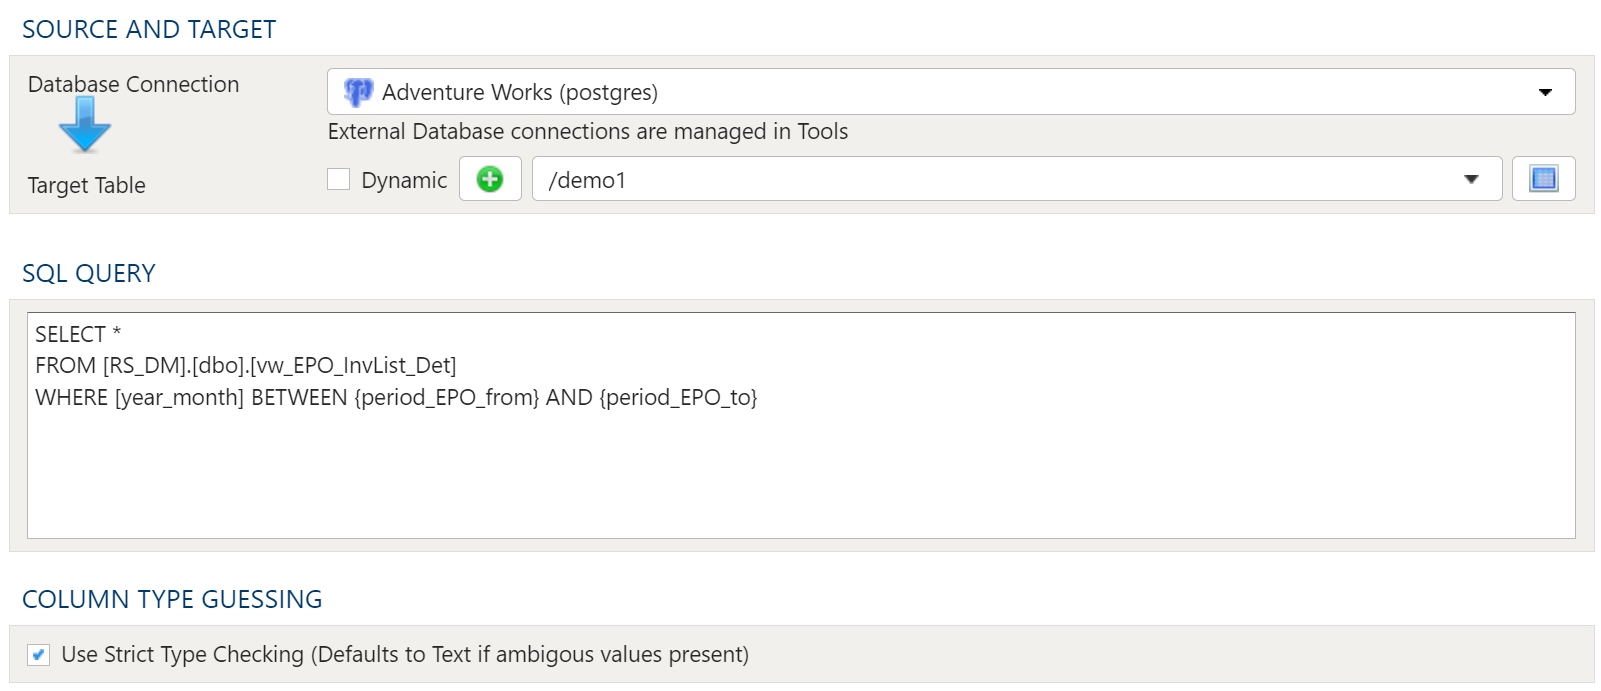
Source et cible
Section intitulée « Source et cible »Connexion à la base de données
Section intitulée « Connexion à la base de données »Pour établir une Connexion à la base de données, consultez Connexions de données PlaidCloud
Table cible
La sélection de la cible pour les importations est limitée aux tables, car les vues ne contiennent pas de données sous-jacentes.
Option dynamique
L’option dynamique permet de spécifier une table à l’aide de texte, y compris des variables. C’est utile dans les workflows pilotés par des variables, où les références de tables et de vues sont relatives aux variables spécifiées.
Exemple qui utilise la variable current_month pour pointer dynamiquement vers la table cible :
legal_entity/inputs/{current_month}/ledger_valuesOption statique
Lorsque vous souhaitez une table précise comme cible de l’importation, laissez la case Dynamique décochée et sélectionnez la table cible.
Si la table cible n’existe pas, sélectionnez le bouton Créer pour créer la table à l’emplacement souhaité.
L’Explorateur de tables est toujours disponible pour toute sélection de table. Cliquez sur le bouton Explorateur de tables à droite de la sélection de table : une fenêtre Explorateur de tables s’ouvre.
Requête SQL
Section intitulée « Requête SQL »Dans cette section, écrivez la requête SQL qui renvoie les données requises.
Aperçu
Cliquez sur Aperçu dans l’onglet Source pour voir jusqu’à 100 lignes de ce que l’étape lirait, sans l’exécuter. Si le résultat est plus long, l’aperçu indique qu’il affiche les premières lignes et qu’il faut exécuter l’étape pour toutes les lire.
L’aperçu renseigne les variables de projet et de workflow de la même manière qu’une exécution. Il ne prend pas en charge les formats de variables comme {x:>9}, et il ne peut pas renseigner une variable qui n’a de valeur que pendant une exécution, comme une valeur de déclencheur.
L’aperçu ne fait que lire des données. Il refuse une requête susceptible de modifier quoi que ce soit et affiche un message au lieu de lignes :
- Preview only supports standard SQL functions. Run the step to see results. La requête utilise une fonction que l’aperçu ne peut pas vérifier comme étant en lecture seule. Exécutez l’étape pour voir le résultat.
- Une requête qui n’est pas un seul
SELECT, ou dont les variables se développent en une instruction qui écrit, est refusée.
L’aperçu n’est pas disponible sur un projet verrouillé, sur les connexions SQL Server, Oracle ou SQLite, ni pour les étapes qui s’exécutent via un agent, comme Agent Remote Execution of SQL.
Détection du type de colonne
Section intitulée « Détection du type de colonne »Les importations SQL peuvent tenter de deviner le type de données pendant le chargement, ou définir toutes les colonnes sur le type Texte. Définir les types de données dynamiquement peut être plus rapide si les données sont propres, mais peut poser des problèmes dans certaines circonstances.
Par exemple, si la plupart des données semblent numériques mais qu’il y a aussi du texte, l’importation peut tenter de les définir comme numériques, ce qui provoque des problèmes de chargement dus à des types de données incompatibles. Des problèmes peuvent aussi survenir avec un code produit numérique de 16 chiffres, par exemple : les zéros de tête seraient supprimés, ce qui donnerait un nombre au lieu d’un code à 16 chiffres.
Définir toutes les données sur du texte exige en revanche une étape Extract ultérieure pour convertir au type approprié, comme des dates ou des valeurs numériques, toute donnée qui ne devrait pas être du texte.
Dépannage
Section intitulée « Dépannage »| Symptôme | Cause probable |
|---|---|
| L’étape a pris nettement plus de temps que d’habitude, jusqu’à une demi-heure de plus environ, sans que rien d’autre ne change dans votre requête, votre connexion ou le volume de données | Le worker d’arrière-plan qui exécutait l’importation a été interrompu en cours de route (un redémarrage ou une éviction côté plateforme, et non un élément de votre workflow), et la plateforme a retenté l’importation de la table pour vous. La nouvelle tentative ne démarre qu’une fois l’interruption détectée, ce qui explique le temps supplémentaire. |
| L’étape s’est quand même terminée avec succès après ce délai | La nouvelle tentative remplace intégralement le contenu de la table ; le résultat est donc le même que pour une seule exécution propre, et il n’y a rien d’autre à vérifier ni à refaire. |
| L’étape échoue avec « has already been attempted and cannot be safely re-run » | Pour une étape Importer depuis SQL, ce refus ne se produit plus : une interruption en cours d’exécution est retentée. Vous le verrez toujours, par conception, pour la restauration d’une archive de projet ou le chargement d’une dimension, où une réexécution créerait un doublon au lieu de remplacer quoi que ce soit. Ouvrez un ticket d’assistance si vous le voyez depuis une étape Importer depuis SQL elle-même. |