

Importer depuis Excel
Description
Section intitulée « Description »Importe des feuilles de calcul précises de fichiers Microsoft Excel depuis PlaidCloud Document. Analyze prend en charge l’ancien format Excel (XP/2003) ainsi que le nouveau format (2007/2010/2013). Cela comprend, sans s’y limiter, les types de fichiers suivants :
- XLS
- XLSX
- XLSB
- XLSM
Les classeurs binaires (XLSB), les fichiers XLS hérités et les fichiers ODS importent les feuilles de calcul et les plages de cellules de la même façon que XLSX.
Les importations Excel transitent par un stockage temporaire au lieu de charger tout le classeur en mémoire, de sorte que les très gros fichiers s’importent sans manquer de mémoire. Les types de données source (décimaux, dates et horodatages) sont conservés dans la table cible au lieu de passer par du texte.
Exemples
Section intitulée « Exemples »Aucun exemple pour le moment…
Paramètres d’importation
Section intitulée « Paramètres d’importation »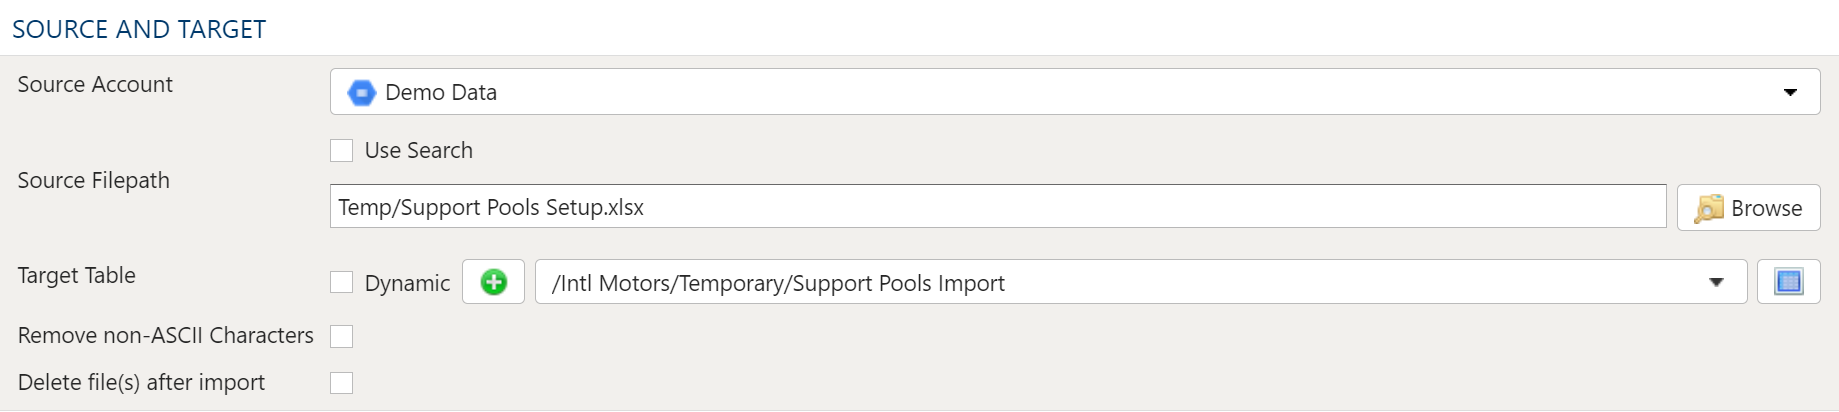
Le sélecteur de fichier de cette étape vous permet de choisir un fichier stocké dans un emplacement PlaidCloud Document à importer.
Vous pouvez aussi choisir un répertoire à importer ; tous les fichiers qu’il contient seront alors importés lors de l’exécution de l’étape.
Compte source
Choisissez un compte de documents PlaidCloud Document auquel vous avez accès. Il vous permettra de sélectionner un répertoire ou un fichier dans la sélection suivante.
Dans un projet, la liste propose aussi Project Default en haut : un substitut du compte que le projet a actuellement défini par défaut. Une nouvelle étape présélectionne Project Default lorsque le projet en a un ; une étape existante conserve le compte avec lequel elle a été enregistrée jusqu’à ce que vous le changiez. Une étape laissée sur Project Default s’exécute avec le compte qui est le compte par défaut du projet à ce moment-là ; si aucun n’est défini, l’exécution échoue et nomme le projet, au lieu de se rabattre sur un autre compte.
Option de recherche
L’option Rechercher permet de trouver tous les fichiers correspondants sous un chemin de répertoire donné pour les importer. Elle peut être particulièrement utile lorsque de nombreux fichiers doivent être inclus, mais qu’ils sont stockés dans des répertoires imbriqués ou mélangés à d’autres fichiers du même répertoire que vous ne voulez pas importer.
Le chemin de recherche sélectionné est le répertoire de départ de la recherche. Le processus de recherche examine tous les fichiers de ce répertoire ainsi que des sous-répertoires qui correspondent aux conditions de recherche spécifiées. Assurez-vous que les critères de recherche peuvent aussi s’appliquer aux fichiers des sous-répertoires.
La recherche peut s’appliquer selon les conditions suivantes :
- Exact : correspond exactement au texte recherché
- Commence par : correspond à tout fichier dont le nom commence par le texte recherché
- Contient : correspond à tout fichier dont le nom contient le texte recherché
- Se termine par : correspond à tout fichier dont le nom se termine par le texte recherché
Un assistant IA ou l’API REST peut aussi définir la recherche sur glob, un motif à caractères génériques tel que CO Store*.yxdb comparé au nom de fichier complet sans tenir compte de la casse, ou sur regex, une expression régulière à laquelle le nom de fichier complet doit correspondre. Une expression régulière est sensible à la casse, sauf si elle commence par (?i).
Chemin du fichier source
Lorsqu’un fichier ou un répertoire de fichiers précis doit être importé, choisir le fichier ou le répertoire est préférable à l’utilisation de la recherche.
Pour sélectionner le fichier ou le répertoire, utilisez simplement le bouton de parcours afin de choisir le chemin dans le compte de documents sélectionné ci-dessus.
Substitution de variables
Pour l’option de recherche comme pour l’option de fichier ou de répertoire précis, vous pouvez utiliser des variables dans le chemin, le texte de recherche et les noms de fichiers.
Voici un exemple qui utilise la variable current_month pour pointer dynamiquement vers le bon fichier :
legal_entity/inputs/{current_month}/ledger_values.csvTable cible
La sélection de la cible pour les importations est limitée aux tables, car les vues ne contiennent pas de données sous-jacentes.
Option dynamique
L’option Dynamique permet de spécifier une table à l’aide de texte, y compris des variables. C’est utile pour les workflows pilotés par des variables, où les références aux tables et aux vues dépendent des variables spécifiées.
Voici un exemple qui utilise la variable current_month pour pointer dynamiquement vers la table cible :
legal_entity/inputs/{current_month}/ledger_valuesOption statique
Lorsque vous souhaitez une table précise comme cible de l’importation, laissez la case Dynamique décochée et sélectionnez la table cible.
Si la table cible n’existe pas, sélectionnez le bouton Créer pour créer la table à l’emplacement voulu.
L’Explorateur de tables est toujours disponible avec toute sélection de table. Cliquez sur le bouton Explorateur de tables à droite de la sélection de table pour ouvrir une fenêtre Explorateur de tables.
Option de suppression des caractères non ASCII
Lorsque vous sélectionnez cette option, l’importation supprime tout contenu qui n’est pas ASCII. Bien que PlaidCloud prenne entièrement en charge Unicode (UTF-8), les fichiers du monde réel peuvent contenir toutes sortes d’encodages et de caractères parasites qui les rendent difficiles à traiter.
Si le contenu du fichier est censé être uniquement ASCII, cocher cette case contribue à garantir le bon déroulement de l’importation.
Option de suppression des fichiers après l’importation
Cette option permet au processus d’importation de supprimer le fichier du compte de documents PlaidCloud Document une fois l’importation terminée avec succès.
Elle peut être utile si les fichiers d’importation sont générés et peuvent être recréés à partir d’un système de référence, ou s’il n’y a aucune raison de conserver les fichiers d’entrée bruts une fois qu’ils ont été traités.
Seuls les fichiers importés sont supprimés. Un fichier ignoré ou qui a produit un avertissement pendant l’importation reste dans le dossier.
Option d’omission de la réimportation si les fichiers source sont inchangés
Lorsque cette option est activée, une exécution de workflow de cette étape omet toute l’importation (téléchargement, conversion et reconstruction de la table) si les fichiers source et les paramètres de l’étape sont inchangés depuis la dernière exécution réussie. Cela évite de répéter le travail lorsqu’un workflow planifié s’exécute de nouveau sur des fichiers source qui n’ont pas changé.
L’étape compare chaque fichier source par son chemin, sa taille et sa date de dernière modification (ainsi qu’une empreinte du contenu lorsque la source en fournit une). Si un fichier est ajouté, supprimé ou modifié, ou si la configuration de l’étape change, l’importation s’exécute normalement. L’option est activée par défaut (décochez-la pour toujours réimporter), et les importations manuelles ponctuelles s’exécutent toujours.
L’omission exige aussi que la table cible contienne toujours les lignes chargées par la dernière importation. Si la table a été vidée depuis, ou si son nombre de lignes ne peut pas être lu, l’importation s’exécute de nouveau au lieu d’être omise, ce qui évite de laisser les étapes en aval sans données.
Certaines sources (par exemple SFTP) ne fournissent pas d’empreinte du contenu ; pour celles-ci, le signal de changement se limite donc à la taille et à la date de dernière modification du fichier. Un fichier remplacé sur place avec la même taille et la même date de modification serait alors considéré comme inchangé et omis : décochez cette option pour une étape dont la source peut être mise à jour de cette manière.
Comme les fichiers Excel peuvent contenir ou non des en-têtes, PlaidCloud permet soit d’utiliser les en-têtes, soit de les ignorer, soit de se fonder sur l’ordre des colonnes pour déterminer leur alignement.
- Sans en-tête : le fichier ne contient aucun en-tête. Utilisez la liste source du Data Mapper pour déterminer l’alignement des colonnes.
- Avec en-tête : utiliser l’en-tête et remplacer la liste des champs : le fichier a un en-tête. Utilisez les noms d’en-tête indiqués et ignorez la liste source du Data Mapper.
- Avec en-tête : ignorer l’en-tête et utiliser la liste des champs : le fichier a un en-tête, mais il doit être ignoré. Utilisez les noms d’en-tête indiqués par la liste source du Data Mapper.
Les espaces et les sauts de ligne au début et à la fin des cellules d’en-tête sont supprimés des noms de colonnes.
Sélection des lignes
Section intitulée « Sélection des lignes »Pour les fichiers d’entrée contenant des enregistrements superflus, vous pouvez indiquer un nombre de lignes à ignorer avant de traiter les données. C’est utile si les fichiers contiennent des blocs d’en-tête qu’il faut sauter avant d’arriver aux données tabulaires.
Sélectionnez Keep Empty Text Cells As Empty String pour charger une cellule de texte vide comme une chaîne vide au lieu de NULL.
Autres options Excel contient les champs suivants :
- Ignorer les lignes masquées par la feuille (
skip_hidden_rows) : les lignes que la feuille masque ne sont pas importées. - Importer une cellule en erreur de formule sous forme de son texte d’erreur (#DIV/0!), pas vide (
keep_error_cells) : une cellule en erreur de formule est importée sous forme de son texte d’erreur, tel que#DIV/0!, au lieu d’être vide. - Chiffres significatifs (
significant_digits) : arrondit chaque nombre décimal à ce nombre de chiffres significatifs. Excel en conserve 15. - Position de la feuille (
sheet_index) : importe la feuille de calcul située à cette position, comptée à partir de 0, dans le classeur, à la place des feuilles choisies par nom.
Dans Feuilles de calcul à importer, sélectionnez Importer la première feuille contenant des données (sheet_first_with_data) pour importer la première feuille de calcul qui contient des données, en ignorant les feuilles vides qui la précèdent. Lorsqu’aucune ne contient de données, la première feuille du classeur est lue.
Classeur
Section intitulée « Classeur »Variable du mot de passe du classeur ouvre les classeurs protégés par mot de passe. Saisissez la variable de workflow ou de projet qui contient le mot de passe, par exemple {xlsx_password}, et non le mot de passe lui-même : une étape dont le champ de mot de passe contient autre chose qu’une référence de variable est refusée à l’enregistrement, de sorte que le mot de passe n’apparaît jamais dans l’étape, ses versions ou ses copies. Les étapes qui contenaient un mot de passe saisi avant cette règle l’ont vu déplacé automatiquement dans une nouvelle variable de projet, visible uniquement des Architectes, et référencent désormais cette variable.
Ce qu’il faut lire
Section intitulée « Ce qu’il faut lire »Chaque entrée de l’importation sélectionne une feuille de calcul, une plage nommée définie dans le classeur ou une plage de cellules précise ; ces trois éléments sont équivalents, et une importation peut les mélanger dans plusieurs entrées.
- Feuille de calcul : lit une feuille entière, sélectionnée par nom.
- Plage nommée : lit une plage pour laquelle le classeur lui-même définit un nom. Les plages nommées sont listées avec les feuilles de calcul dans le sélecteur (voir Rechercher les feuilles dans le fichier sélectionné ci-dessous), vous les sélectionnez donc comme vous sélectionneriez une feuille.
- Plage de cellules : lit une plage rectangulaire précise qui n’est associée ni à une feuille de calcul ni à un nom de classeur. Choisissez la feuille où se trouve la plage, puis saisissez la plage après un
$. Trois formes sont prises en charge :Sheet1$A1:J100: une plage bornée.Sheet1$A1:J: ouverte ; lit deA1jusqu’à la dernière ligne des colonnes A à J.Sheet1$A:BJ: colonnes entières ; lit les colonnes A à BJ de la feuille, la forme qu’Alteryx écrit pour une entrée Excel.
Les plages nommées sont lues dans les classeurs XLSX et XLSM. Les classeurs XLSB, XLS et ODS proposent des feuilles de calcul et des plages de cellules.
Feuilles de calcul à importer
Section intitulée « Feuilles de calcul à importer »Comme les classeurs peuvent contenir de nombreuses feuilles de calcul avec des données différentes, il est possible de sélectionner les feuilles à importer dans le traitement d’importation en cours. Les options sont :
- Toutes les feuilles de calcul
- Feuilles de calcul correspondant à la recherche
- Feuilles de calcul sélectionnées
Utiliser la recherche de feuilles de calcul
Section intitulée « Utiliser la recherche de feuilles de calcul »La recherche de feuilles de calcul permet d’inclure les feuilles qui correspondent aux critères de recherche. Les critères disponibles sont :
- Commence par : le nom de la feuille de calcul commence par le texte recherché
- Contient : le nom de la feuille de calcul contient le texte recherché
- Se termine par : le nom de la feuille de calcul se termine par le texte recherché
Rechercher les feuilles dans le fichier sélectionné
Section intitulée « Rechercher les feuilles dans le fichier sélectionné »Le bouton de recherche des feuilles ouvre le fichier Excel et liste les feuilles de calcul et les plages nommées disponibles dans la table. Cochez les cases de la table pour les feuilles de calcul et/ou les plages nommées à inclure dans l’importation. Un classeur contenu dans un fichier .zip fonctionne aussi : ses feuilles de calcul et ses plages nommées sont listées.
Correspondance des feuilles
Section intitulée « Correspondance des feuilles »Une Correspondance des feuilles lit un ensemble différent de feuilles de calcul dans chaque classeur. Choisissez une Table de correspondance des feuilles comportant une ligne par feuille de calcul à lire, dont la Colonne de classeur contient le chemin ou le nom de fichier du classeur et la Colonne de feuille la feuille de calcul. Lorsqu’une correspondance des feuilles est définie, seuls les classeurs nommés par la table sont lus, chacun pour les feuilles de calcul qu’elle liste, dans l’ordre des lignes de la table. Une feuille de calcul vide lit la première feuille du classeur.
Fichiers sans la feuille de calcul sélectionnée
Section intitulée « Fichiers sans la feuille de calcul sélectionnée »Lorsqu’une importation lit plusieurs fichiers, un fichier qui ne contient pas la feuille de calcul sélectionnée, ou qui n’a aucune feuille correspondant à votre recherche, est ignoré. L’étape se termine avec un avertissement qui nomme le fichier ignoré et liste les feuilles de calcul qu’il contient, et les autres fichiers sont tout de même importés. Si tous les fichiers sont ignorés, l’étape réussit quand même, la table cible reste vide et un avertissement en explique la raison. Les noms de feuilles de calcul doivent correspondre exactement, majuscules et minuscules comprises.
Un fichier ignoré reste dans le dossier, même avec Delete Files After Import activé, et déclenche de nouveau un avertissement à chaque exécution jusqu’à ce que vous le supprimiez ou le corrigiez. Les avertissements d’une importation de plusieurs fichiers apparaissent sur l’étape : jusqu’à cinq sont listés, plus le nombre des autres.
Sélection des données de la table
Section intitulée « Sélection des données de la table »Configuration du Data Mapper
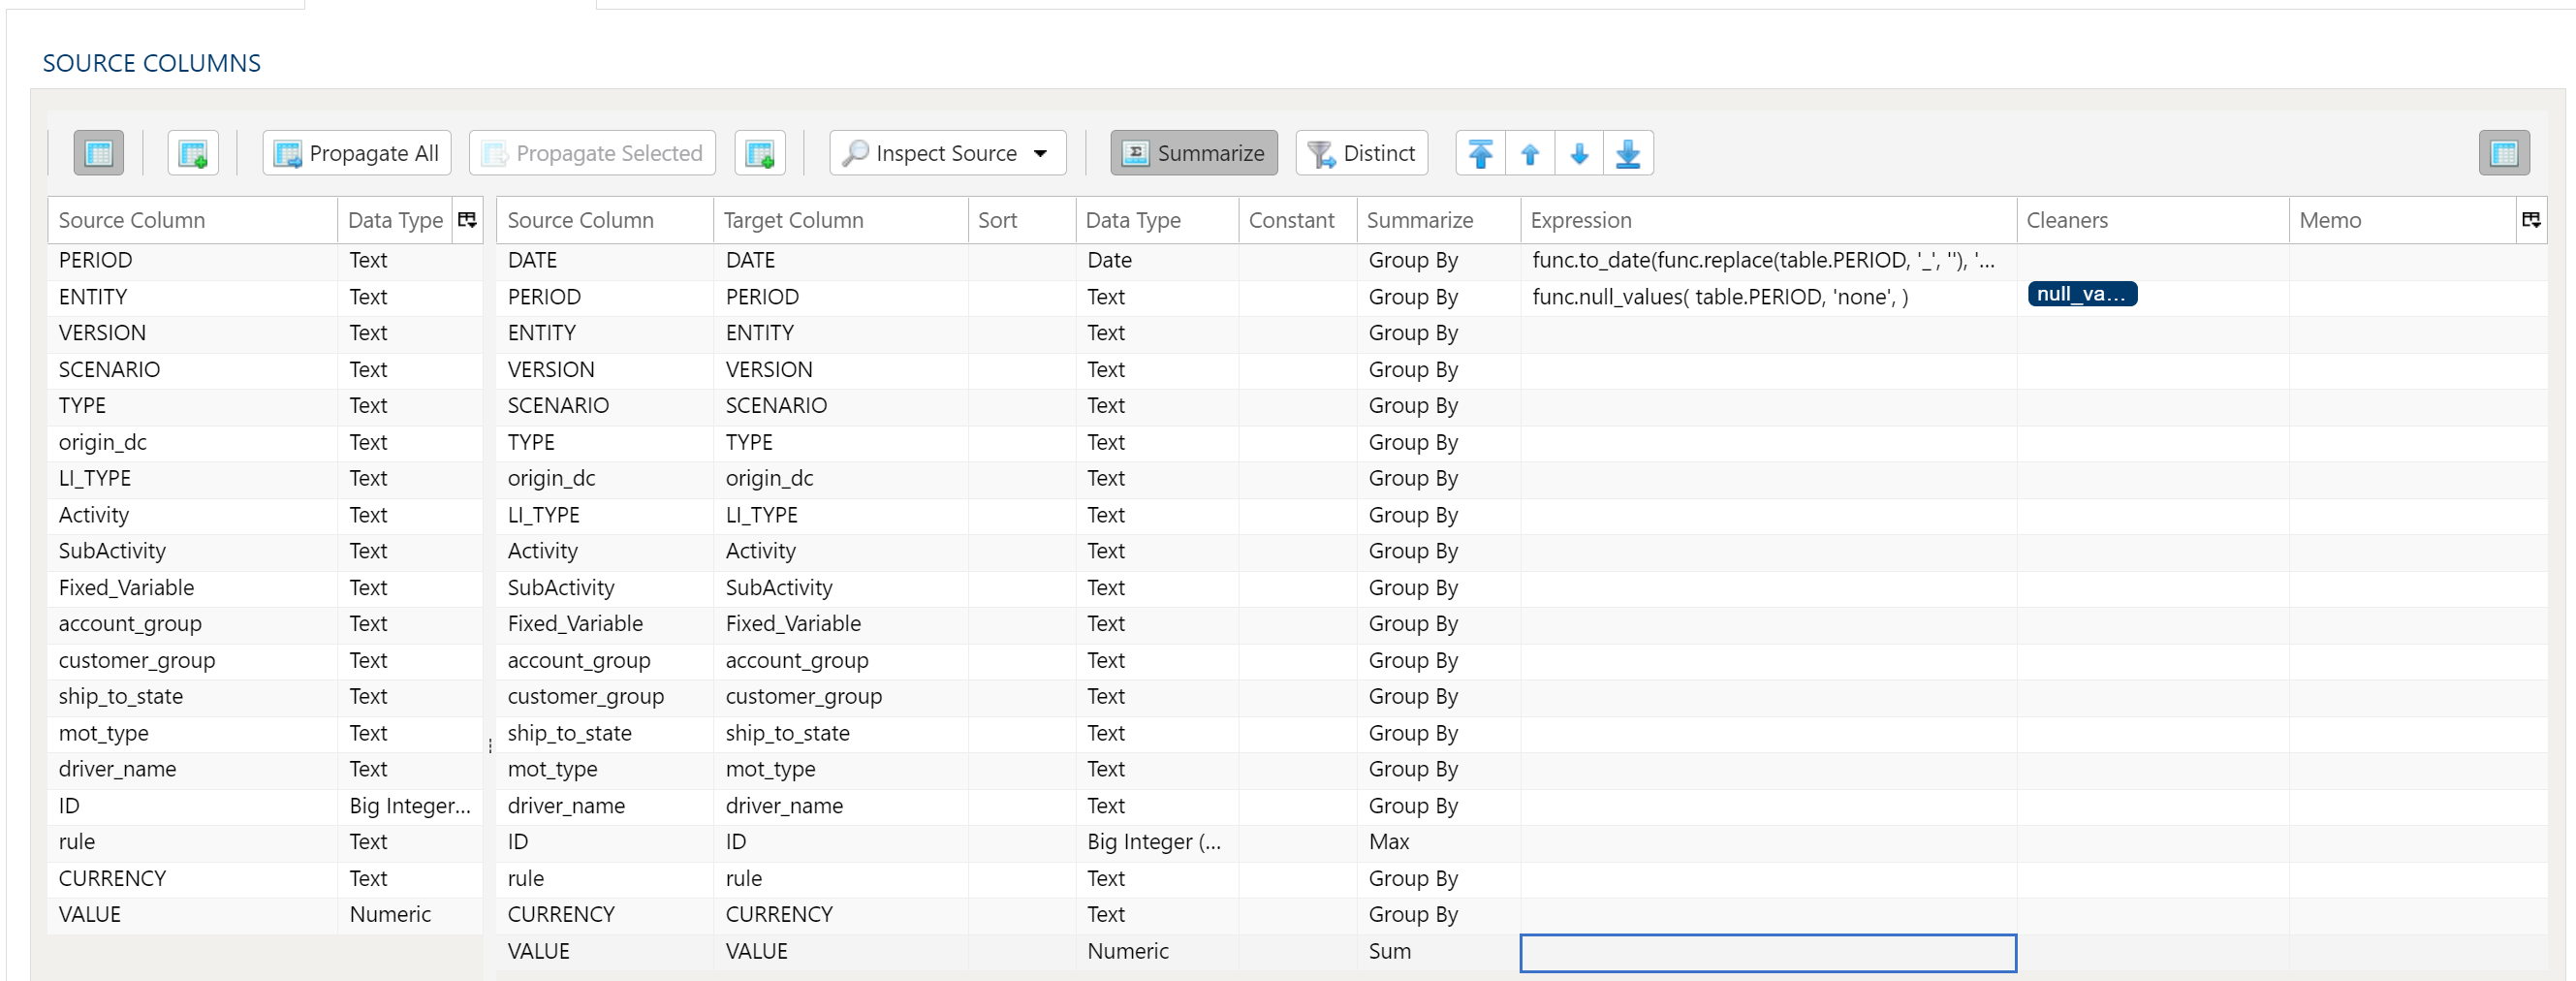
Le Data Mapper sert à mapper les colonnes des données source vers la table de données cible.
Inspection et remplissage du mappeur
Le bouton de menu Inspecter la source offre d’autres façons de mapper les colonnes de la source vers la cible :
- Renseigner les deux tables de mappage : propage toutes les valeurs de la table de données source vers la table de données cible. C’est le comportement par défaut.
- Renseigner uniquement la table de mappage source : mappe uniquement toutes les valeurs de la table de données source. C’est utile pour modifier un workflow existant lorsque la structure des colonnes source a changé.
- Renseigner uniquement la table de mappage cible : propage toutes les valeurs vers la table de données cible uniquement.
Si les options de colonnes source et cible ne suffisent pas, vous pouvez ajouter d’autres colonnes à la table de données cible de plusieurs façons :
- Tout propager insère toutes les colonnes source dans la table de données cible, qu’elles existent déjà ou non.
- Propager la sélection insère uniquement la ou les colonnes source sélectionnées.
- Faites un clic droit côté cible et sélectionnez Insérer une ligne pour insérer une ligne juste au-dessus de la ligne actuellement sélectionnée.
- Faites un clic droit côté cible et sélectionnez Ajouter une ligne pour insérer une ligne en bas (à l’extrême droite) de la table de données cible.
Suppression de colonnes
Pour supprimer des colonnes de la table de données cible, sélectionnez la ou les colonnes voulues, puis faites un clic droit et sélectionnez Supprimer.
Colonnes source qui ne sont plus listées
Une ligne cible peut nommer une Colonne source que la table de données source ne liste plus, par exemple après une nouvelle inspection de la source. L’étape ne supprime jamais une telle ligne à votre place. À la place, le nom de la colonne s’affiche en rouge derrière un signe d’avertissement ⚠, et le survol indique que la colonne ne figure pas dans les colonnes source. Dans une étape à plusieurs tables, comme une union, chaque table est vérifiée par rapport à ses propres colonnes source.
Une ligne avec une Constante, une Expression ou un résumé Nombre (valeurs nulles incluses) n’est jamais signalée, car l’étape ne lit pas sa colonne source. Rien n’est signalé tant que la table de données source ne liste aucune colonne, par exemple avant la première inspection de la source.
Lorsque vous enregistrez une étape qui contient encore des lignes signalées, une boîte de dialogue Colonnes obsolètes détectées les liste sous l’onglet ou la table concernés, et propose trois choix :
- Tout supprimer et enregistrer : supprime les lignes signalées, puis enregistre.
- Enregistrer quand même : enregistre l’étape telle quelle.
- Annuler : retourne à l’étape sans enregistrer.
Pour conserver une ligne et faire disparaître son avertissement, rajoutez la colonne à la table de données source, ou choisissez une colonne que la table de données source liste.
Type de données d’une colonne
Chaque colonne cible possède un Type. Une colonne propagée depuis la source conserve le type de la colonne source ; une ligne que vous ajoutez à la main est de type Texte au départ, et vous définissez le Type pour indiquer ce qu’elle doit réellement être : une colonne que vous comptez additionner ou trier a besoin de son type numérique ou date, car le texte se trie et s’additionne comme du texte.
Une étape enregistrée avec une colonne sans aucun type s’exécute malgré tout. Le type est déterminé au démarrage de l’étape, à partir de la colonne source que cette colonne lit. Lorsqu’il n’y a rien à partir duquel le déduire, il est traité comme du texte : les colonnes d’une étape Extraire SQL proviennent de la requête que vous avez écrite et non d’une source mappée, et lorsque plusieurs sources portent le même nom de colonne avec des types qui divergent, le texte est utilisé plutôt que d’en deviner un : une mauvaise supposition produit une conversion que l’entrepôt peut rejeter, alors que tout se convertit en texte.
Définir vous-même le Type reste la façon d’indiquer ce qu’une colonne doit être. Le laisser vide revient à accepter ce que la colonne source se trouve être.
Modification de l’ordre des colonnes
Pour réorganiser les colonnes de la table de données cible, sélectionnez la ou les colonnes voulues. Vous pouvez utiliser l’une ou l’autre des méthodes suivantes :
- Flèches de déplacement groupé : sélectionnez l’option de déplacement voulue avec les flèches en haut à droite.
- Menu contextuel : faites un clic droit et sélectionnez Déplacer en haut, Monter, Descendre ou Déplacer en bas.
Réduire le résultat aux seuls enregistrements distincts
Pour ne renvoyer que des valeurs distinctes, sélectionnez l’option de menu Distinct. Un ensemble de cases à cocher s’affiche pour chaque colonne de la source. Il suffit de cocher la case en regard d’une colonne pour ne renvoyer que des résultats distincts.
Selon la situation, vous pouvez envisager d’utiliser plutôt la synthèse.
Le processus de distinction conserve le premier enregistrement unique trouvé et écarte les autres. Vous pouvez appliquer un tri aux données s’il est important d’obtenir des résultats cohérents d’une exécution à l’autre.
Agrégation et regroupement
Pour agréger les résultats, sélectionnez l’option de menu Résumer. Un ensemble de listes de sélection s’affiche pour chaque colonne de la table de données cible. Choisissez une méthode de synthèse adaptée à chaque colonne.
Lorsque Inspecter la source remplit les colonnes, une colonne numérique commence à Regrouper par plutôt qu’à Somme si son nom ressemble à un identifiant, comme id, customer_id, Order No ou CustomerKey, si sa table la définit comme une clé, ou si la jointure l’utilise comme clé.
- Regrouper par
- Somme
- Min
- Max
- Premier
- Dernier
- Nombre
- Nombre (valeurs nulles incluses)
- Moyenne
- Écart type
- Écart type d’échantillon
- Écart type de population
- Variance
- Variance d’échantillon
- Variance de population
- Avancé hors regroupement
Pour une utilisation avancée du Data Mapper, comme les expressions, le nettoyage et les constantes, consultez Utilisation avancée du Data Mapper.
Une colonne source dans plusieurs colonnes cibles
Section intitulée « Une colonne source dans plusieurs colonnes cibles »Une même colonne source peut alimenter plusieurs colonnes cibles. Mappez la même colonne source sur au moins deux lignes cibles, chacune avec son propre nom, son propre type ou sa propre expression. Par exemple, lisez Amount une fois comme colonne de texte et une autre fois comme colonne numérique, ou construisez deux colonnes de texte à partir de la même cellule. Une cible numérique ne convertit plus la source avant l’exécution de votre expression, de sorte qu’une expression peut d’abord nettoyer une valeur telle que 1,500.
Cela fonctionne de la même façon dans toutes les importations de fichiers qui utilisent le Data Mapper, à l’exception de Importer depuis CSV : Importer depuis Excel, largeur fixe, JSON, Avro, Parquet, DBF, XML et YXDB.
Filtres de données
Section intitulée « Filtres de données »
Pour offrir un maximum de souplesse, des filtres de données sont disponibles sur les données source et sur les données cible. Pour les jeux de données volumineux, il peut être particulièrement avantageux de filtrer les lignes dès la source afin que les opérations suivantes portent sur un jeu de données plus petit.
Sélectionner un sous-ensemble de données
Ce type de filtre permet de filtrer les données source entrantes selon les conditions spécifiées.
Appliquer un filtre secondaire aux données de résultat
Ce type de filtre permet d’appliquer un filtre aux données de résultat après transformation, selon les conditions spécifiées. La possibilité d’appliquer un filtre au résultat transformé permet d’exclure des lignes en fonction du résultat de calculs complexes, de synthèses ou de fonctions de fenêtrage.
Découpage final de la table de données (limite)
Le découpage des lignes permet de limiter les lignes du jeu de résultats selon une plage et un point de départ.
Syntaxe des filtres
La syntaxe des filtres utilise Python SQLAlchemy, qui est la même syntaxe que celle des autres expressions.
Consultez des exemples et des fonctions d’expression dans la section Expressions.