

Étape Export External Database Tables
Description
Section intitulée « Description »Écrit des tables de projet dans une base de données externe via une connexion, plutôt que dans un fichier. Utilisez-la pour renvoyer des résultats modélisés vers une base de données de reporting, un entrepôt de données ou un système opérationnel.
C’est le pendant de Importer les tables de base de données externe : plusieurs tables sont déplacées en une seule étape, et les tables cibles peuvent être sélectionnées explicitement ou trouvées par un motif de recherche.
Éléments de configuration spécifiques
Section intitulée « Éléments de configuration spécifiques »Connexion
Section intitulée « Connexion »La connexion de données qui identifie la base de données cible.
Type d’exportation
Section intitulée « Type d’exportation »La façon dont chaque table cible est préparée avant l’écriture des lignes :
- Ajouter uniquement — ajoute des lignes à la table existante ; échoue si elle n’existe pas.
- Tronquer puis ajouter — vide la table, conserve sa structure, puis écrit.
- Créer puis ajouter — crée la table si elle est absente, puis écrit.
- Supprimer, créer, puis ajouter — supprime et recrée la table, puis écrit. À utiliser lorsque le schéma source a changé.
Nom du cadre
Section intitulée « Nom du cadre »Le nom du cadre sous lequel l’étape s’exécute.
Ajout de cibles
Section intitulée « Ajout de cibles »Utilisez le bouton d’ajout et de suppression de cible pour construire la liste des tables cibles. Sélectionnez une cible pour la configurer dans le volet de droite, et utilisez Basculer la sélection pour activer ou désactiver l’exportation des cibles sélectionnées. L’exportation n’analyse pas la base de données cible à la recherche de tables ; ajoutez chaque cible vous-même. Importer les tables de base de données externe est l’étape qui permet de découvrir les tables d’une base de données externe.
Onglets de la cible
Section intitulée « Onglets de la cible »Une cible sélectionnée comporte trois onglets.
Source et cible
Section intitulée « Source et cible »Choisissez les tables de projet à exporter et leur destination.
- Source — Table spécifique désigne une table de projet, avec une option Dynamique pour un nom qui change à l’exécution. Tables correspondant à la recherche exporte chaque table de projet trouvée par un Chemin de recherche et un Texte de recherche, mis en correspondance selon Exact, Commence par, Contient ou Se termine par.
- Table externe cible — Activer pour l’exportation active ou désactive la cible. Schéma cible et Table cible désignent la table de destination. Utiliser le même nom que la table source réutilise le nom de chaque table source.
Sélection des données de la table
Section intitulée « Sélection des données de la table »Le mappeur de colonnes de la cible, dans son propre onglet pleine hauteur. Inspecter la source lit les colonnes de la table source du projet dans le mappeur.
Filtres de données
Section intitulée « Filtres de données »Filtrez les lignes écrites dans la cible.
Éléments de configuration communs
Section intitulée « Éléments de configuration communs »Configuration du Data Mapper
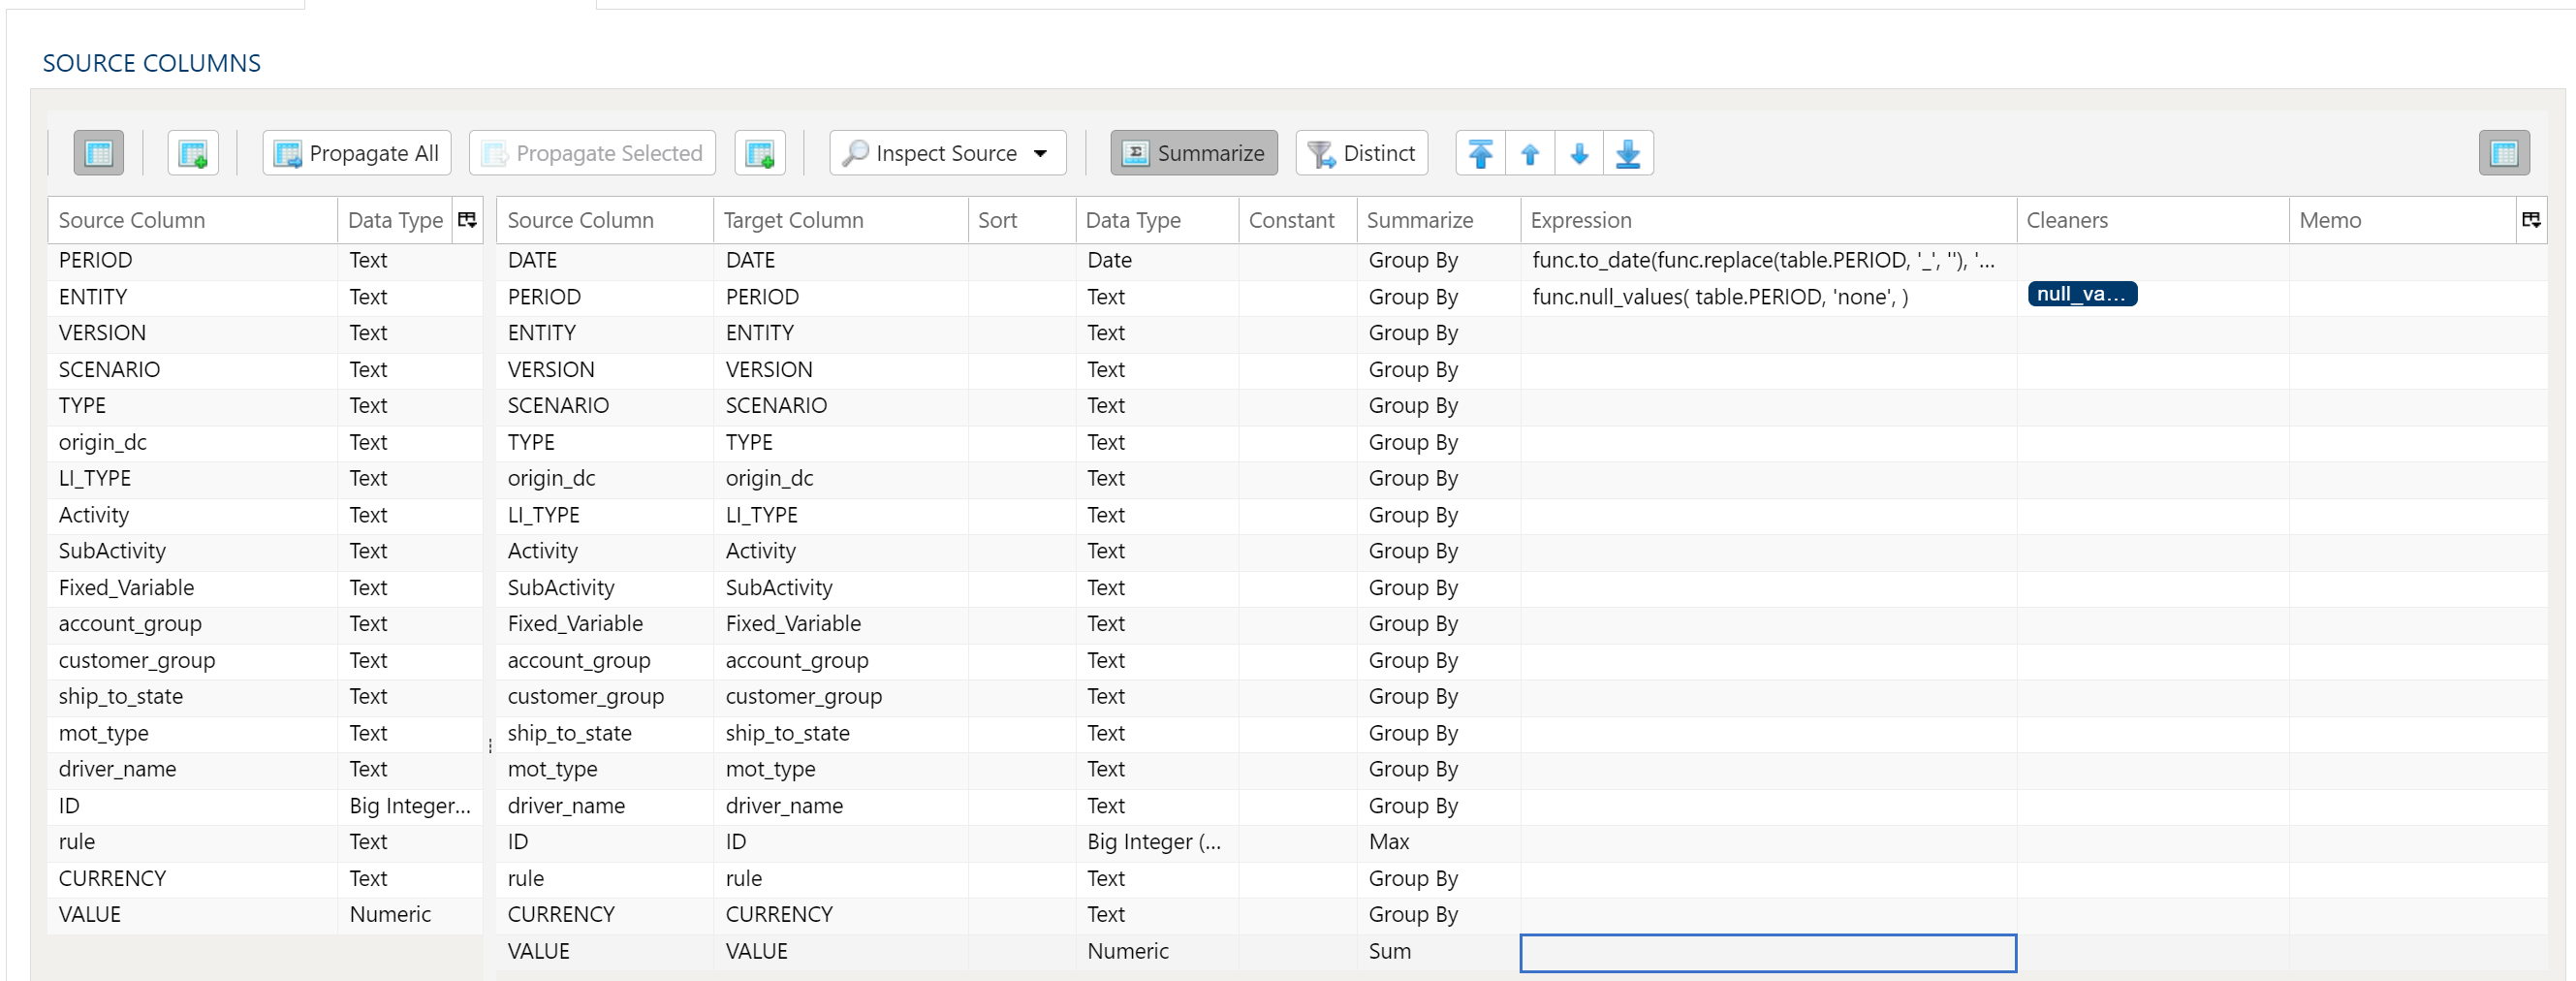
Le Data Mapper sert à mapper les colonnes des données source vers la table de données cible.
Inspection et remplissage du mappeur
Le bouton de menu Inspecter la source offre d’autres façons de mapper les colonnes de la source vers la cible :
- Renseigner les deux tables de mappage : propage toutes les valeurs de la table de données source vers la table de données cible. C’est le comportement par défaut.
- Renseigner uniquement la table de mappage source : mappe uniquement toutes les valeurs de la table de données source. C’est utile pour modifier un workflow existant lorsque la structure des colonnes source a changé.
- Renseigner uniquement la table de mappage cible : propage toutes les valeurs vers la table de données cible uniquement.
Si les options de colonnes source et cible ne suffisent pas, vous pouvez ajouter d’autres colonnes à la table de données cible de plusieurs façons :
- Tout propager insère toutes les colonnes source dans la table de données cible, qu’elles existent déjà ou non.
- Propager la sélection insère uniquement la ou les colonnes source sélectionnées.
- Faites un clic droit côté cible et sélectionnez Insérer une ligne pour insérer une ligne juste au-dessus de la ligne actuellement sélectionnée.
- Faites un clic droit côté cible et sélectionnez Ajouter une ligne pour insérer une ligne en bas (à l’extrême droite) de la table de données cible.
Suppression de colonnes
Pour supprimer des colonnes de la table de données cible, sélectionnez la ou les colonnes voulues, puis faites un clic droit et sélectionnez Supprimer.
Colonnes source qui ne sont plus listées
Une ligne cible peut nommer une Colonne source que la table de données source ne liste plus, par exemple après une nouvelle inspection de la source. L’étape ne supprime jamais une telle ligne à votre place. À la place, le nom de la colonne s’affiche en rouge derrière un signe d’avertissement ⚠, et le survol indique que la colonne ne figure pas dans les colonnes source. Dans une étape à plusieurs tables, comme une union, chaque table est vérifiée par rapport à ses propres colonnes source.
Une ligne avec une Constante, une Expression ou un résumé Nombre (valeurs nulles incluses) n’est jamais signalée, car l’étape ne lit pas sa colonne source. Rien n’est signalé tant que la table de données source ne liste aucune colonne, par exemple avant la première inspection de la source.
Lorsque vous enregistrez une étape qui contient encore des lignes signalées, une boîte de dialogue Colonnes obsolètes détectées les liste sous l’onglet ou la table concernés, et propose trois choix :
- Tout supprimer et enregistrer : supprime les lignes signalées, puis enregistre.
- Enregistrer quand même : enregistre l’étape telle quelle.
- Annuler : retourne à l’étape sans enregistrer.
Pour conserver une ligne et faire disparaître son avertissement, rajoutez la colonne à la table de données source, ou choisissez une colonne que la table de données source liste.
Type de données d’une colonne
Chaque colonne cible possède un Type. Une colonne propagée depuis la source conserve le type de la colonne source ; une ligne que vous ajoutez à la main est de type Texte au départ, et vous définissez le Type pour indiquer ce qu’elle doit réellement être : une colonne que vous comptez additionner ou trier a besoin de son type numérique ou date, car le texte se trie et s’additionne comme du texte.
Une étape enregistrée avec une colonne sans aucun type s’exécute malgré tout. Le type est déterminé au démarrage de l’étape, à partir de la colonne source que cette colonne lit. Lorsqu’il n’y a rien à partir duquel le déduire, il est traité comme du texte : les colonnes d’une étape Extraire SQL proviennent de la requête que vous avez écrite et non d’une source mappée, et lorsque plusieurs sources portent le même nom de colonne avec des types qui divergent, le texte est utilisé plutôt que d’en deviner un : une mauvaise supposition produit une conversion que l’entrepôt peut rejeter, alors que tout se convertit en texte.
Définir vous-même le Type reste la façon d’indiquer ce qu’une colonne doit être. Le laisser vide revient à accepter ce que la colonne source se trouve être.
Modification de l’ordre des colonnes
Pour réorganiser les colonnes de la table de données cible, sélectionnez la ou les colonnes voulues. Vous pouvez utiliser l’une ou l’autre des méthodes suivantes :
- Flèches de déplacement groupé : sélectionnez l’option de déplacement voulue avec les flèches en haut à droite.
- Menu contextuel : faites un clic droit et sélectionnez Déplacer en haut, Monter, Descendre ou Déplacer en bas.
Réduire le résultat aux seuls enregistrements distincts
Pour ne renvoyer que des valeurs distinctes, sélectionnez l’option de menu Distinct. Un ensemble de cases à cocher s’affiche pour chaque colonne de la source. Il suffit de cocher la case en regard d’une colonne pour ne renvoyer que des résultats distincts.
Selon la situation, vous pouvez envisager d’utiliser plutôt la synthèse.
Le processus de distinction conserve le premier enregistrement unique trouvé et écarte les autres. Vous pouvez appliquer un tri aux données s’il est important d’obtenir des résultats cohérents d’une exécution à l’autre.
Agrégation et regroupement
Pour agréger les résultats, sélectionnez l’option de menu Résumer. Un ensemble de listes de sélection s’affiche pour chaque colonne de la table de données cible. Choisissez une méthode de synthèse adaptée à chaque colonne.
Lorsque Inspecter la source remplit les colonnes, une colonne numérique commence à Regrouper par plutôt qu’à Somme si son nom ressemble à un identifiant, comme id, customer_id, Order No ou CustomerKey, si sa table la définit comme une clé, ou si la jointure l’utilise comme clé.
- Regrouper par
- Somme
- Min
- Max
- Premier
- Dernier
- Nombre
- Nombre (valeurs nulles incluses)
- Moyenne
- Écart type
- Écart type d’échantillon
- Écart type de population
- Variance
- Variance d’échantillon
- Variance de population
- Avancé hors regroupement
Pour une utilisation avancée du Data Mapper, comme les expressions, le nettoyage et les constantes, consultez Utilisation avancée du Data Mapper.

Pour offrir un maximum de souplesse, des filtres de données sont disponibles sur les données source et sur les données cible. Pour les jeux de données volumineux, il peut être particulièrement avantageux de filtrer les lignes dès la source afin que les opérations suivantes portent sur un jeu de données plus petit.
Sélectionner un sous-ensemble de données
Ce type de filtre permet de filtrer les données source entrantes selon les conditions spécifiées.
Appliquer un filtre secondaire aux données de résultat
Ce type de filtre permet d’appliquer un filtre aux données de résultat après transformation, selon les conditions spécifiées. La possibilité d’appliquer un filtre au résultat transformé permet d’exclure des lignes en fonction du résultat de calculs complexes, de synthèses ou de fonctions de fenêtrage.
Découpage final de la table de données (limite)
Le découpage des lignes permet de limiter les lignes du jeu de résultats selon une plage et un point de départ.
Syntaxe des filtres
La syntaxe des filtres utilise Python SQLAlchemy, qui est la même syntaxe que celle des autres expressions.
Consultez des exemples et des fonctions d’expression dans la section Expressions.