

Allocation Split
Description
Section intitulée « Description »Découpe la valeur d’une ligne source en parts et oriente chaque part vers une cible différente, avec des proportions déterminées par les données de l’inducteur. Plus simple que Allocation By Assignment Dimension : utilisez-la lorsque vous avez simplement besoin de répartir des valeurs sans dimension d’affectation.
Schéma courant : prendre un montant total, le répartir entre plusieurs bénéficiaires selon des pourcentages ou des pondérations d’une table d’inducteurs, et produire une ligne de sortie par bénéficiaire.
Paramètres de la table de données
Section intitulée « Paramètres de la table de données »La Table des valeurs à allouer, la Table de données de l’inducteur et la Table de résultat d’allocation peuvent être sélectionnées de façon dynamique ou statique.
Sélection dynamique de table
Section intitulée « Sélection dynamique de table »L’option de table dynamique permet de spécifier une table à l’aide de texte et de variables. Elle est utile dans les workflows pilotés par des variables, où les références de tables ou de vues sont relatives aux variables indiquées.
Exemple utilisant la variable current_month pour pointer dynamiquement vers une table :
legal_entity/inputs/{current_month}/ledger_valuesSélection statique de table
Section intitulée « Sélection statique de table »Lorsque vous souhaitez une table précise comme source, laissez la case Dynamique décochée et sélectionnez la table source dans le menu déroulant.
L’Explorateur de tables est toujours disponible avec toute sélection de table. Cliquez sur le bouton Explorateur de tables à droite de la sélection de table pour ouvrir une fenêtre Explorateur de tables.
Table des valeurs à allouer
Section intitulée « Table des valeurs à allouer »C’est la table qui contient les valeurs à allouer. Il s’agit généralement de valeurs de coûts ou de revenus.
Table de données de l’inducteur
Section intitulée « Table de données de l’inducteur »La table de données de l’inducteur contient les valeurs que l’étape d’allocation utilisera pour allouer les coûts.
Exemples :
- Pour qu’une chaîne logistique impute des coûts à des clients, vous pouvez utiliser des données de livraison avec le nombre de livraisons ou le poids des livraisons comme inducteur.
- Pour qu’un support informatique impute ses coûts aux services qu’il assiste, les données de l’inducteur peuvent être le nombre de tickets par centre de coûts.
Règle de signe des données de l’inducteur
Section intitulée « Règle de signe des données de l’inducteur »Les données de l’inducteur peuvent contenir des valeurs positives et négatives. La Règle de signe des données de l’inducteur vous permet de décider comment les signes contradictoires sont traités.
- Erreur en cas de signes contradictoires : l’étape d’allocation produit une erreur et s’arrête si des signes contradictoires sont rencontrés.
- Continuer avec un avertissement en cas de signes contradictoires : l’étape d’allocation utilise à la fois les valeurs d’inducteur négatives et positives, mais affiche un avertissement.
- Utiliser uniquement les valeurs d’inducteur positives : l’étape d’allocation n’utilise que les valeurs d’inducteur positives et ignore les valeurs négatives.
- Utiliser uniquement les valeurs d’inducteur négatives : l’étape d’allocation n’utilise que les valeurs d’inducteur négatives et ignore les valeurs positives.
- Utiliser les valeurs absolues des données de l’inducteur : l’étape d’allocation utilise les valeurs absolues des données de l’inducteur.
Table de résultat d’allocation
Section intitulée « Table de résultat d’allocation »Ajouter les résultats à la table cible
Section intitulée « Ajouter les résultats à la table cible »Si cette case est cochée, les résultats de l’allocation sont ajoutés à la table de résultat d’allocation. Si cette case n’est pas cochée, la table de résultats d’allocation est écrasée à chaque exécution de l’étape d’allocation.
Colonnes distinctes pour les résultats alloués
Section intitulée « Colonnes distinctes pour les résultats alloués »Si cette case est cochée, la table de résultats affiche le montant de chaque enregistrement alloué ainsi que le montant réellement alloué à chaque enregistrement d’inducteur.
Mappage de la source d’allocation
Section intitulée « Mappage de la source d’allocation »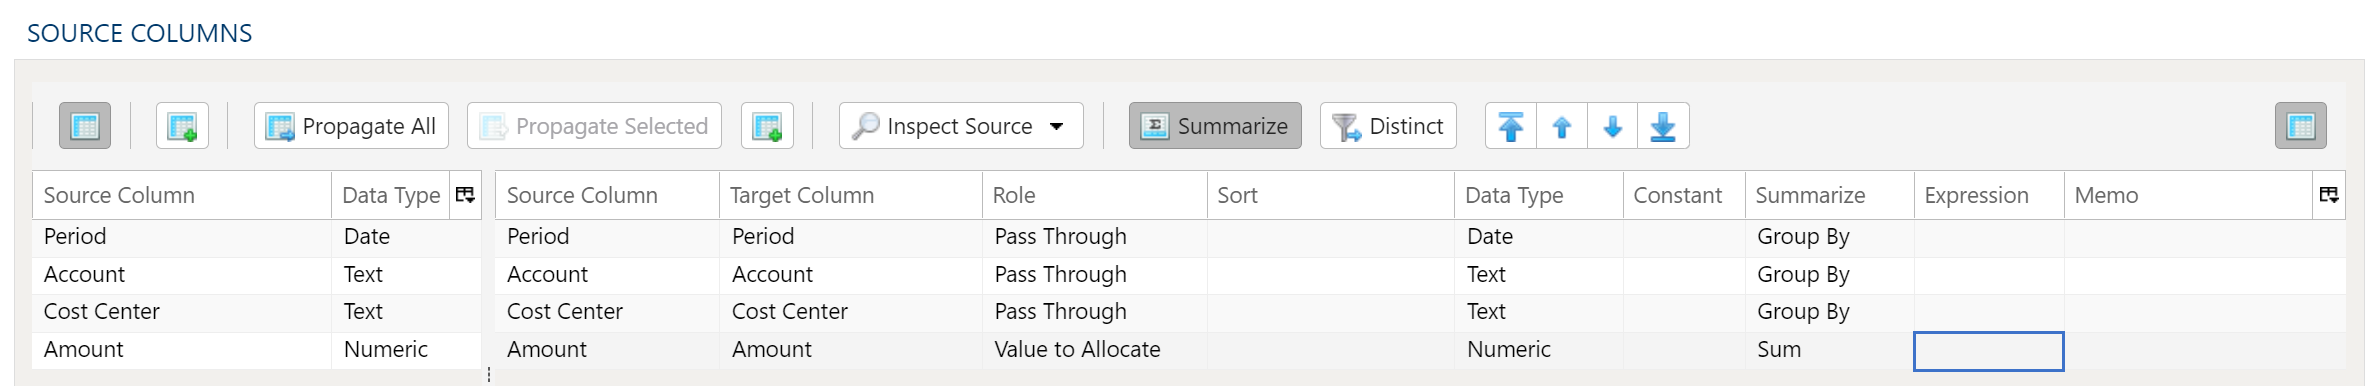
Le mappage de la source d’allocation sert à mapper les colonnes de la Table des valeurs à allouer qui seront utilisées dans l’étape d’allocation.
Inspection et renseignement du mappeur
Le bouton de menu Inspecter la source offre d’autres façons de mapper les colonnes de la source vers la cible :
- Renseigner les deux tables de mappage : propage toutes les valeurs de la table de données source vers la table de données cible. C’est le comportement par défaut.
- Renseigner uniquement la table de mappage source : mappe uniquement les valeurs de la table de données source. C’est utile lorsque vous modifiez un workflow existant dont la structure des colonnes source a changé.
- Renseigner uniquement la table de mappage cible : propage toutes les valeurs uniquement vers la table de données cible.
Si les options de colonnes source et cible ne suffisent pas, vous pouvez ajouter d’autres colonnes à la table de données cible de plusieurs façons :
- Tout propager insère toutes les colonnes source dans la table de données cible, qu’elles y figurent déjà ou non.
- Propager la sélection insère uniquement les colonnes source sélectionnées.
- Faites un clic droit côté cible et sélectionnez Insérer une ligne pour insérer une ligne juste au-dessus de la ligne actuellement sélectionnée.
- Faites un clic droit côté cible et sélectionnez Ajouter une ligne pour insérer une ligne en bas (à l’extrême droite) de la table de données cible.
Rôle
Chaque colonne du Data Mapper doit se voir attribuer un rôle :
- Transmission directe : ces colonnes apparaîtront dans la table de résultat de l’allocation.
- Valeur à allouer : c’est la colonne qui contient les valeurs à allouer.
Suppression de colonnes
Pour supprimer des colonnes de la table de données cible, sélectionnez les colonnes souhaitées, faites un clic droit, puis sélectionnez Supprimer.
Modification de l’ordre des colonnes
Pour réorganiser les colonnes de la table de données cible, sélectionnez les colonnes souhaitées. Vous pouvez utiliser l’une des deux méthodes suivantes :
- Flèches de déplacement groupé : sélectionnez l’option de déplacement souhaitée parmi les flèches en haut à droite.
- Menu contextuel : faites un clic droit et sélectionnez Déplacer en haut, Monter, Descendre ou Déplacer en bas.
Réduire le résultat aux enregistrements distincts
Pour ne renvoyer que les valeurs distinctes, sélectionnez l’option de menu Distinct. Un ensemble de cases à cocher s’affiche pour chaque colonne de la source. Il suffit de cocher la case en regard de la colonne correspondante pour ne renvoyer que les résultats distincts.
Selon la situation, il peut être préférable d’utiliser plutôt le résumé.
Le traitement des valeurs distinctes conserve le premier enregistrement unique trouvé et supprime les autres. Si la cohérence entre les exécutions est importante, il peut être utile de trier les données.
Agrégation et regroupement
Pour agréger les résultats, sélectionnez l’option de menu Résumer. Un ensemble de listes de sélection s’affiche pour chaque colonne de la table de données cible. Choisissez une méthode de résumé appropriée pour chaque colonne.
- Regrouper par
- Somme
- Min
- Max
- Premier
- Dernier
- Nombre
- Nombre (valeurs nulles incluses)
- Moyenne
- Écart type
- Écart type d’échantillon
- Écart type de population
- Variance
- Variance d’échantillon
- Variance de population
- Avancé hors regroupement
Pour l’utilisation avancée du Data Mapper, comme les expressions, le nettoyage et les constantes, consultez Utilisation avancée du Data Mapper
Filtres de la source d’allocation
Section intitulée « Filtres de la source d’allocation »
Pour offrir un maximum de souplesse, des filtres de données sont disponibles sur les données source et sur les données cible. Pour les jeux de données volumineux, il peut être particulièrement avantageux de filtrer les lignes dès la source afin que les opérations suivantes portent sur un jeu de données plus petit.
Sélectionner un sous-ensemble de données
Ce type de filtre permet de filtrer les données source entrantes selon les conditions spécifiées.
Appliquer un filtre secondaire aux données de résultat
Ce type de filtre permet d’appliquer un filtre aux données de résultat après transformation, selon les conditions spécifiées. La possibilité d’appliquer un filtre au résultat transformé permet d’exclure des lignes en fonction du résultat de calculs complexes, de synthèses ou de fonctions de fenêtrage.
Découpage final de la table de données (limite)
Le découpage des lignes permet de limiter les lignes du jeu de résultats selon une plage et un point de départ.
Syntaxe des filtres
La syntaxe des filtres utilise Python SQLAlchemy, qui est la même syntaxe que celle des autres expressions.
Consultez des exemples et des fonctions d’expression dans la section Expressions.
Mappage des données de l’inducteur
Section intitulée « Mappage des données de l’inducteur »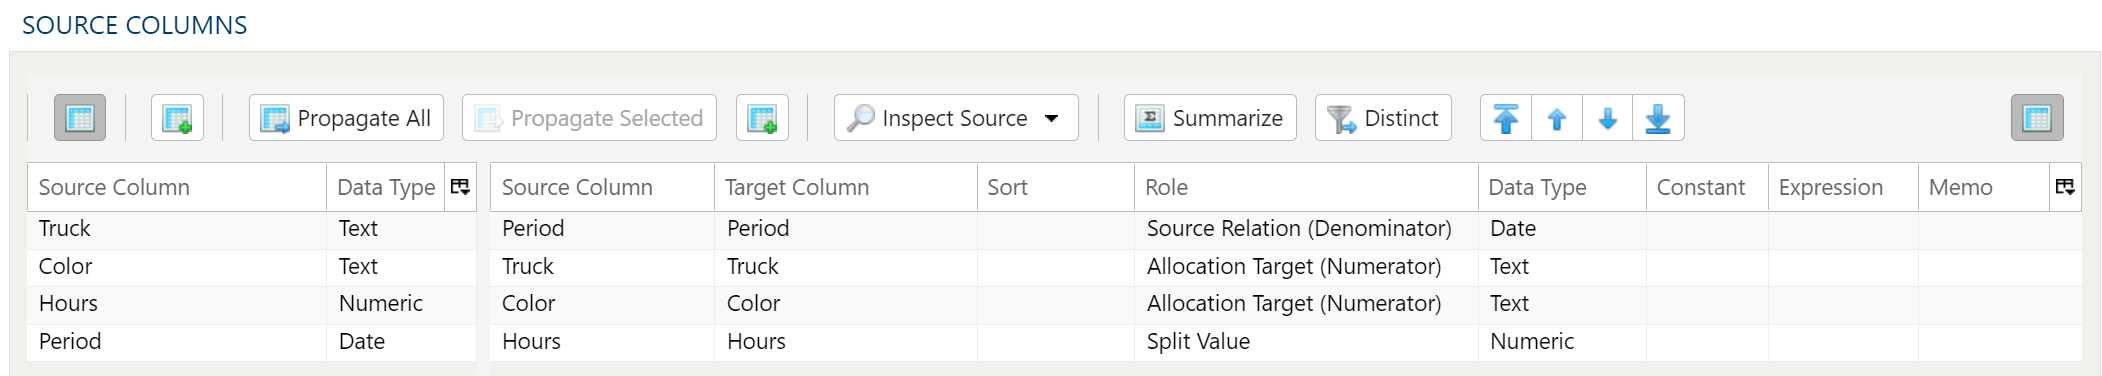
Le mappage des données de l’inducteur sert à mapper les colonnes de la Table de données de l’inducteur qui seront utilisées dans l’étape d’allocation.
Inspection et renseignement du mappeur
Le bouton de menu Inspecter la source offre d’autres façons de mapper les colonnes de la source vers la cible :
- Renseigner les deux tables de mappage : propage toutes les valeurs de la table de données source vers la table de données cible. C’est le comportement par défaut.
- Renseigner uniquement la table de mappage source : mappe uniquement les valeurs de la table de données source. C’est utile lorsque vous modifiez un workflow existant dont la structure des colonnes source a changé.
- Renseigner uniquement la table de mappage cible : propage toutes les valeurs uniquement vers la table de données cible.
Si les options de colonnes source et cible ne suffisent pas, vous pouvez ajouter d’autres colonnes à la table de données cible de plusieurs façons :
- Tout propager insère toutes les colonnes source dans la table de données cible, qu’elles y figurent déjà ou non.
- Propager la sélection insère uniquement les colonnes source sélectionnées.
- Faites un clic droit côté cible et sélectionnez Insérer une ligne pour insérer une ligne juste au-dessus de la ligne actuellement sélectionnée.
- Faites un clic droit côté cible et sélectionnez Ajouter une ligne pour insérer une ligne en bas (à l’extrême droite) de la table de données cible.
Rôle
Chaque colonne du Data Mapper doit se voir attribuer un rôle :
- Relation source : ces colonnes ont des colonnes correspondantes dans la Table des valeurs à allouer.
- Cible d’allocation : ces colonnes seront la cible de l’étape d’allocation et apparaîtront dans la Table de résultat d’allocation.
- Valeur de fractionnement : cette colonne contient les valeurs qui serviront à allouer les valeurs de la Table des valeurs à allouer.
Suppression de colonnes
Pour supprimer des colonnes de la table de données cible, sélectionnez les colonnes souhaitées, faites un clic droit, puis sélectionnez Supprimer.
Modification de l’ordre des colonnes
Pour réorganiser les colonnes de la table de données cible, sélectionnez les colonnes souhaitées. Vous pouvez utiliser l’une des deux méthodes suivantes :
- Flèches de déplacement groupé : sélectionnez l’option de déplacement souhaitée parmi les flèches en haut à droite.
- Menu contextuel : faites un clic droit et sélectionnez Déplacer en haut, Monter, Descendre ou Déplacer en bas.
Réduire le résultat aux enregistrements distincts
Pour ne renvoyer que les valeurs distinctes, sélectionnez l’option de menu Distinct. Un ensemble de cases à cocher s’affiche pour chaque colonne de la source. Il suffit de cocher la case en regard de la colonne correspondante pour ne renvoyer que les résultats distincts.
Selon la situation, il peut être préférable d’utiliser plutôt le résumé.
Le traitement des valeurs distinctes conserve le premier enregistrement unique trouvé et supprime les autres. Si la cohérence entre les exécutions est importante, il peut être utile de trier les données.
Agrégation et regroupement
Pour agréger les résultats, sélectionnez l’option de menu Résumer. Un ensemble de listes de sélection s’affiche pour chaque colonne de la table de données cible. Choisissez une méthode de résumé appropriée pour chaque colonne.
- Regrouper par
- Somme
- Min
- Max
- Premier
- Dernier
- Nombre
- Nombre (valeurs nulles incluses)
- Moyenne
- Écart type
- Écart type d’échantillon
- Écart type de population
- Variance
- Variance d’échantillon
- Variance de population
- Avancé hors regroupement
Pour l’utilisation avancée du Data Mapper, comme les expressions, le nettoyage et les constantes, consultez Utilisation avancée du Data Mapper
Filtres des données de l’inducteur
Section intitulée « Filtres des données de l’inducteur »
Pour offrir un maximum de souplesse, des filtres de données sont disponibles sur les données source et sur les données cible. Pour les jeux de données volumineux, il peut être particulièrement avantageux de filtrer les lignes dès la source afin que les opérations suivantes portent sur un jeu de données plus petit.
Sélectionner un sous-ensemble de données
Ce type de filtre permet de filtrer les données source entrantes selon les conditions spécifiées.
Appliquer un filtre secondaire aux données de résultat
Ce type de filtre permet d’appliquer un filtre aux données de résultat après transformation, selon les conditions spécifiées. La possibilité d’appliquer un filtre au résultat transformé permet d’exclure des lignes en fonction du résultat de calculs complexes, de synthèses ou de fonctions de fenêtrage.
Découpage final de la table de données (limite)
Le découpage des lignes permet de limiter les lignes du jeu de résultats selon une plage et un point de départ.
Syntaxe des filtres
La syntaxe des filtres utilise Python SQLAlchemy, qui est la même syntaxe que celle des autres expressions.
Consultez des exemples et des fonctions d’expression dans la section Expressions.