

Etapa Table Project to Project Copy
Descrição
Seção intitulada “Descrição”Copia uma tabela de um projeto para outro. Use-a para trazer uma tabela de referência compartilhada, um conjunto de resultados publicado ou uma consulta baseada em dimensão entre projetos, sem exportar para um arquivo e importá-lo de volta.
Os dois lados são nomeados explicitamente — um projeto e uma tabela de origem, e um projeto e uma tabela de destino. O projeto de destino começa como o projeto atual, mas pode ser qualquer projeto, então uma etapa pode copiar para este projeto, a partir dele ou entre outros dois. A tabela de destino é criada se não existir e deve ser uma tabela, e não uma visão.
Gerenciamento de compartilhamento de dados
Seção intitulada “Gerenciamento de compartilhamento de dados”Uma cópia precisa de até dois compartilhamentos de dados:
- Leitura, do projeto de origem para o projeto de destino, para que os dados da origem cheguem apenas aonde a origem os compartilha. Abra a guia Início do projeto de origem e, em Gerenciamento de compartilhamento de dados, clique em Novo compartilhamento de dados, selecione o projeto de destino, marque Leitura em Operações permitidas e clique em Adicionar compartilhamento de dados.
- Gravação, do projeto de destino para este projeto — o projeto em que o fluxo de trabalho está, que faz a gravação — quando o destino é outro projeto. Abra a guia Início do projeto de destino e, em Gerenciamento de compartilhamento de dados, clique em Novo compartilhamento de dados, selecione este projeto, marque Gravação em Operações permitidas e clique em Adicionar compartilhamento de dados.
Assim, uma cópia para este projeto precisa apenas do compartilhamento de Leitura, e uma cópia dentro de um único projeto não precisa de nenhum. Consulte Compartilhando dados entre projetos.
Sem um compartilhamento de que precisa, o salvamento da etapa é recusado e uma execução falha, com uma mensagem que cita cada compartilhamento a adicionar — por exemplo, Project ‘Sales’ can’t write to project ‘Finance’: in project ‘Finance’, under Data Sharing Management, add a data share for ‘Sales’ that allows Write. Uma execução recusada deixa o projeto de destino como estava, sem criar a tabela de destino. Um projeto informado como variável é verificado quando a etapa é executada.
A etapa é executada com a identidade do próprio projeto, então uma execução funciona pelos compartilhamentos, não importa quem a inicie.
Parâmetros de cópia
Seção intitulada “Parâmetros de cópia”- Projeto de origem — o projeto do qual copiar.
- Tabela de origem — a tabela a copiar, escolhida no projeto de origem.
Gravar em
Seção intitulada “Gravar em”- Projeto de destino — o projeto para o qual copiar. Ele começa como o projeto atual.
- Tabela de destino — a tabela a gravar, escolhida no projeto de destino. Escolher um Projeto de destino diferente limpa uma tabela escolhida no projeto anterior; uma tabela informada por nome ou caminho é mantida e procurada no novo projeto.
- Anexar aos dados existentes — marque para adicionar as linhas copiadas ao que a tabela de destino já contém. Deixe desmarcada para substituir as linhas da tabela pelas da origem.
Um projeto salvo que você não consegue ver, ou que foi excluído, é exibido marcado como (missing), em vez de ser trocado por outro projeto.
Itens de configuração comuns
Seção intitulada “Itens de configuração comuns”Configuração do Data Mapper
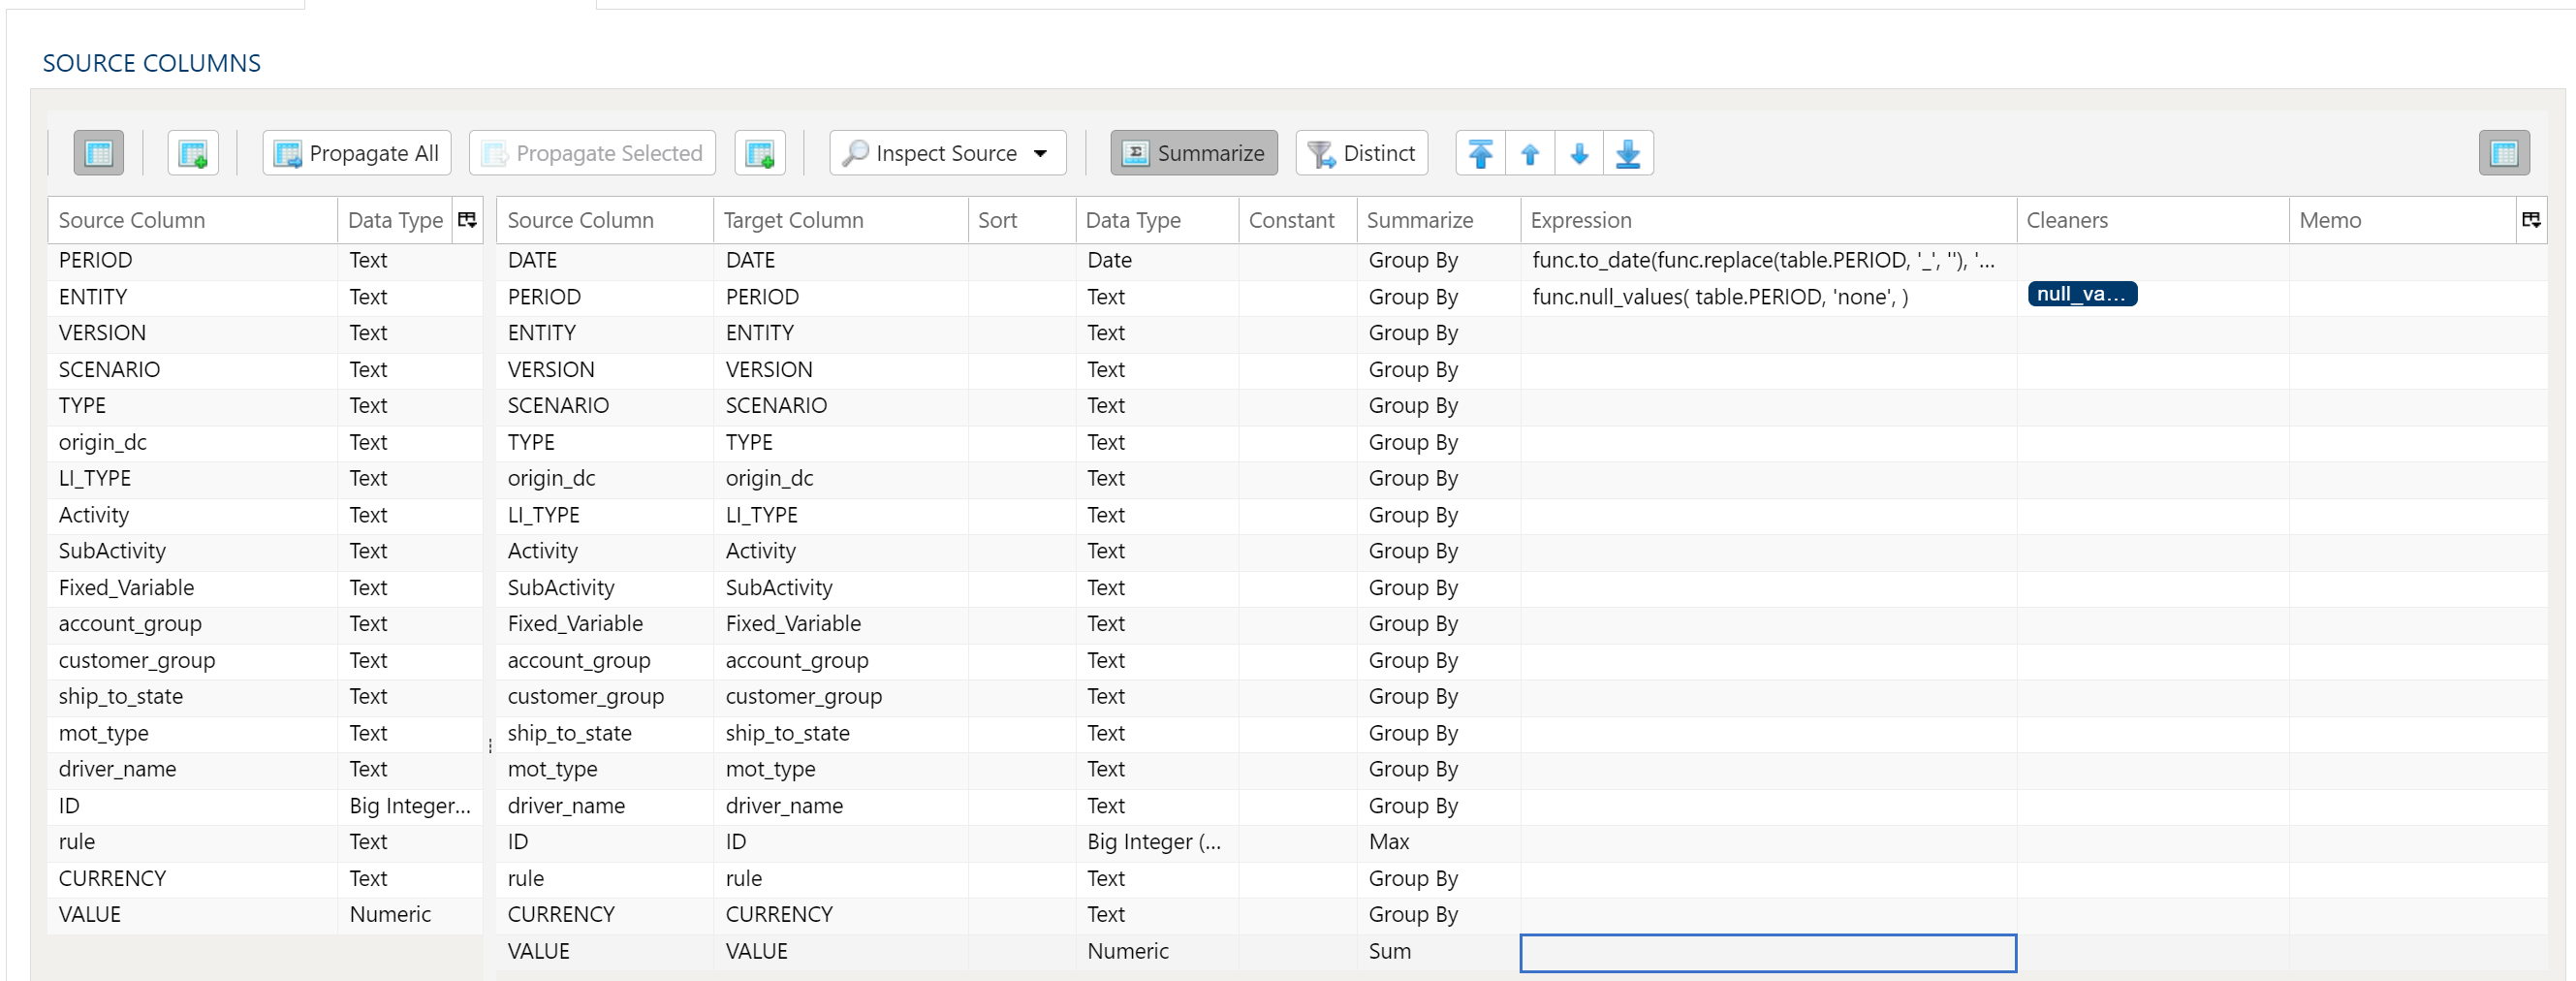
O Data Mapper é usado para mapear as colunas dos dados de origem para a tabela de dados de destino.
Inspeção e Preenchimento do Mapeador
O botão de menu Inspecionar origem oferece formas adicionais de mapear colunas da origem para o destino:
- Preencher ambas as tabelas de mapeamento: propaga todos os valores da tabela de dados de origem para a tabela de dados de destino. Este é o comportamento padrão.
- Preencher somente a tabela de mapeamento de origem: mapeia apenas todos os valores da tabela de dados de origem. Isso é útil ao modificar um fluxo de trabalho existente quando a estrutura de colunas da origem mudou.
- Preencher somente a tabela de mapeamento de destino: propaga todos os valores apenas para a tabela de dados de destino.
Se as opções de coluna de origem e de destino não forem suficientes, é possível adicionar outras colunas à tabela de dados de destino de várias maneiras:
- Propagar tudo insere todas as colunas de origem na tabela de dados de destino, quer elas já existam ou não.
- Propagar selecionadas insere apenas as colunas de origem selecionadas.
- Clique com o botão direito no lado do destino e selecione Inserir linha para inserir uma linha imediatamente acima da linha selecionada.
- Clique com o botão direito no lado do destino e selecione Anexar linha para inserir uma linha no final (extrema direita) da tabela de dados de destino.
Exclusão de Colunas
Para excluir colunas da tabela de dados de destino, selecione as colunas desejadas, clique com o botão direito e selecione Excluir.
Colunas de Origem que Não Estão Mais Listadas
Uma linha de destino pode indicar uma Coluna de origem que a tabela de dados de origem não lista mais, por exemplo depois que a origem foi inspecionada novamente. A etapa nunca remove essa linha por você. Em vez disso, o nome da coluna aparece em vermelho, após um sinal de aviso ⚠, e ao passar o mouse sobre ele é exibida a informação de que a coluna não está nas colunas de origem. Em uma etapa com várias tabelas, como uma união, cada tabela é verificada em relação às suas próprias colunas de origem.
Uma linha com resumo Constante, Expressão ou Contagem (incluindo nulos) nunca é sinalizada, porque a etapa não lê a coluna de origem dela. Nada é sinalizado enquanto a tabela de dados de origem não listar nenhuma coluna, por exemplo antes de a origem ser inspecionada pela primeira vez.
Ao salvar uma etapa que ainda tem linhas sinalizadas, uma caixa de diálogo Colunas obsoletas encontradas as lista sob a guia ou a tabela em que estão e oferece três opções:
- Remover todas e salvar — remove as linhas sinalizadas e, em seguida, salva.
- Salvar mesmo assim — salva a etapa como está.
- Cancelar — volta para a etapa sem salvar.
Para manter uma linha e eliminar o aviso dela, adicione a coluna de volta à tabela de dados de origem ou escolha uma coluna que a tabela de dados de origem liste.
Tipo de Dados da Coluna
Toda coluna de destino tem um Tipo. Uma coluna propagada da origem mantém o tipo da coluna de origem; uma linha que você adiciona manualmente começa como Texto, e você define o Tipo para indicar o que ela deve realmente ser — uma coluna que você pretende somar ou ordenar precisa do tipo numérico ou de data, porque texto é ordenado e somado como texto.
Uma etapa salva com uma coluna sem nenhum tipo ainda é executada. O tipo é determinado quando a etapa é iniciada, a partir da coluna de origem que essa coluna lê. Onde não há de onde lê-lo, ele é tratado como texto: as colunas de uma etapa Extrair SQL vêm da consulta que você escreveu, e não de uma origem mapeada, e onde várias origens têm o mesmo nome de coluna com tipos divergentes, usa-se texto em vez de adivinhar um deles — um palpite errado gera uma conversão que o data warehouse pode rejeitar, e qualquer coisa pode ser convertida em texto.
Definir o Tipo você mesmo continua sendo a forma de dizer o que uma coluna deve ser. Deixá-lo sem definição significa aceitar o tipo que a coluna de origem tiver.
Alteração da Ordem das Colunas
Para reorganizar as colunas na tabela de dados de destino, selecione as colunas desejadas. Você pode usar:
- Setas de movimentação em massa: selecione a opção de movimentação desejada nas setas no canto superior direito
- Menu de contexto: clique com o botão direito e selecione Mover para o início, Mover para cima, Mover para baixo ou Mover para o final.
Reduzir o Resultado a Registros Distintos
Para retornar apenas opções distintas, selecione a opção de menu Distintos. Isso exibe um conjunto de caixas de seleção para cada coluna da origem. Basta marcar a caixa ao lado da coluna correspondente para retornar apenas resultados distintos.
Dependendo da situação, talvez seja melhor considerar o uso de resumo.
O processo de distinção mantém o primeiro registro exclusivo encontrado e descarta os demais. Talvez você queira aplicar uma ordenação aos dados se a consistência entre execuções for importante.
Agregação e Agrupamento
Para agregar resultados, selecione a opção de menu Resumir. Isso exibe um conjunto de caixas de seleção para cada coluna da tabela de dados de destino. Escolha um método de resumo adequado para cada coluna.
Quando Inspecionar origem preenche as colunas, uma coluna numérica começa como Agrupar por em vez de Soma se o nome dela se parecer com um identificador, como id, customer_id, Order No ou CustomerKey, se a tabela dela a definir como chave ou se a junção a usar como chave.
- Agrupar por
- Soma
- Mínimo
- Máximo
- Primeiro
- Último
- Contagem
- Contagem (incluindo nulos)
- Média
- Desvio padrão
- Desvio padrão amostral
- Desvio padrão populacional
- Variância
- Variância amostral
- Variância populacional
- Avançado sem Agrupar por
Para uso avançado do Data Mapper, como expressões, limpeza e constantes, consulte Uso avançado do Data Mapper