

Recuperação, fundamentação e caminhos de análise
“RAG” normalmente significa uma coisa só: picar o corpus em fragmentos, gerar embeddings deles em um armazenamento vetorial e colar no prompt as correspondências mais próximas. O PlaidCloud faz isso para exatamente um corpus — a documentação do produto — e deliberadamente não faz isso com os seus dados.
Suas tabelas são lidas ao vivo, no momento em que se pergunta sobre elas, sob as suas permissões. Isso não é uma decisão de desempenho; é o que torna uma resposta confiável e um controle de acesso significativo.
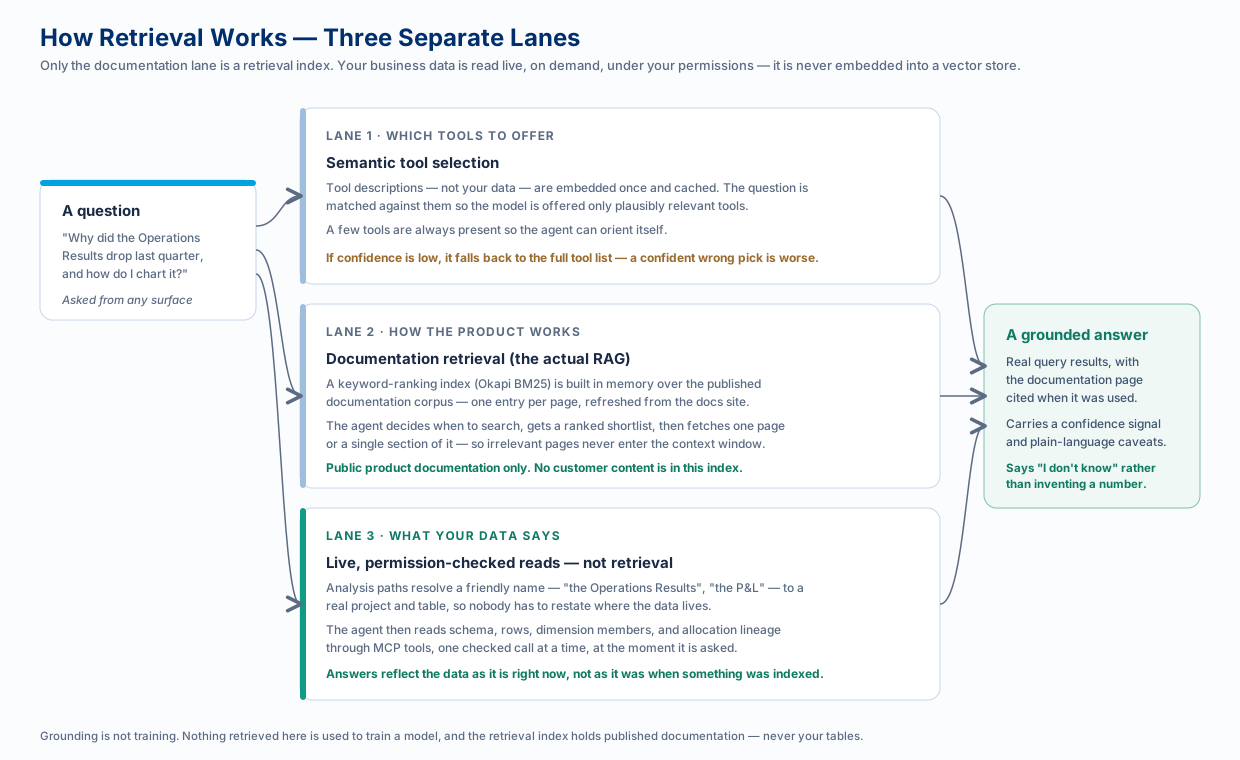
Linha 1 — Escolher quais ferramentas oferecer
Seção intitulada “Linha 1 — Escolher quais ferramentas oferecer”Esta linha é executada para o assistente no aplicativo, que traz o próprio catálogo de ferramentas. Cada descrição de ferramenta que ele mostra ao modelo consome tokens do prompt a cada turno; por isso, antes que o modelo veja qualquer coisa, a pergunta é comparada por similaridade semântica com as descrições das ferramentas — nunca com os seus dados — e apenas as ferramentas plausivelmente relevantes são oferecidas.
Nas outras superfícies, o catálogo de ferramentas é tratado pela conexão MCP: o conector da Anthropic o gerencia no lado do servidor, e o laço no lado do cliente limita a superfície que declara. As linhas 2 e 3 abaixo valem em todos os casos.
Três detalhes importam:
- Os embeddings descrevem ferramentas, não conteúdo. Eles são calculados uma única vez a partir dos nomes e das descrições das ferramentas, ficam em cache e são reconstruídos automaticamente quando uma descrição muda.
- Algumas ferramentas estão sempre presentes para que o agente possa se orientar — descobrir quem está perguntando e em qual projeto — mesmo quando a pergunta não menciona nenhum dos dois.
- Baixa confiança recorre à lista completa. Uma restrição errada com confiança é pior do que pagar uma vez o custo total em tokens; por isso, uma correspondência incerta simplesmente mostra tudo. Turnos muito curtos (“obrigado”, “ok”) pulam essa etapa por completo.
Linha 2 — Fundamentação na documentação
Seção intitulada “Linha 2 — Fundamentação na documentação”Este é o verdadeiro caminho de geração aumentada por recuperação, e responde a “como eu…”, “o que é…” e “onde eu configuro…”.
A documentação publicada é obtida como um corpus estruturado — uma entrada por página — e indexada em memória com o Okapi BM25, uma função de ranqueamento por palavras-chave. O agente então trabalha em dois movimentos:
- Pesquisar retorna uma lista curta ranqueada de páginas: slug, título, descrição, pontuação.
- Buscar traz uma página, ou uma única seção nomeada dela, quando o agente já decidiu de qual realmente precisa.
O ponto central do projeto é que o agente decide quando pesquisar e quanto ler. A injeção passiva cola algo em todo prompt, ajude ou não; a recuperação conduzida por ferramentas mantém páginas irrelevantes fora da janela de contexto e permite que o agente cite a página que usou, para que você possa dar seguimento.
Se o corpus da documentação ficar brevemente inacessível, o agente responde sem ele, em vez de fazer o turno falhar.
Linha 3 — Leitura dos seus próprios dados
Seção intitulada “Linha 3 — Leitura dos seus próprios dados”Perguntas sobre os seus números não são respondidas por recuperação. O agente lê o que precisa, quando precisa, por meio de ferramentas com verificação de permissões: esquemas de tabelas, linhas, membros de dimensões, linhagem de fluxos de trabalho, rastreamentos de alocação.
É por isso que as respostas são atuais — refletem os dados como estão agora, não como estavam quando algo foi indexado pela última vez — e é por isso que o controle de acesso funciona: não existe um índice pré-construído que possa vazar através de um limite de permissão, porque não existe índice.
Caminhos de análise — a camada de nomes
Seção intitulada “Caminhos de análise — a camada de nomes”As leituras ao vivo precisam saber qual tabela. Os caminhos de análise são o vocabulário compartilhado que torna isso simples: um nome amigável — “Resultados operacionais”, “a DRE”, “Quadro de pessoal” — mapeado uma única vez para um projeto e uma tabela reais, e utilizável por todos no espaço de trabalho a partir daí.
- Pergunte pelo nome em vez de indicar um projeto e uma tabela toda vez.
- Marque um como padrão do espaço de trabalho para que um “o que mudou no último trimestre?” sem alvo caia em algum lugar sensato.
- Todos querem dizer a mesma coisa. Quando a equipe inteira diz “a DRE”, todos chegam à mesma tabela.
Um administrador os registra; qualquer pessoa pode usá-los; toda pergunta continua sendo executada sob as permissões da própria pessoa que a fez. Eles funcionam de forma idêntica a partir do assistente no aplicativo, do Microsoft 365 Copilot e de um agente de programação conectado. Veja Caminhos de análise para saber como configurá-los.
O catálogo de expressões
Seção intitulada “O catálogo de expressões”Quando o assistente escreve uma expressão, ele não adivinha nomes de funções de memória. Ele consulta um catálogo estruturado de todas as funções de expressão do PlaidCloud — nome, assinatura, link da documentação, categoria — conferido com as funções que seu data warehouse realmente oferece, com sugestões de correspondência próxima quando um nome está quase certo. Uma consulta, não uma busca por similaridade, porque, para nomes de funções, “quase certo” é errado.
Fundamentação não é treinamento
Seção intitulada “Fundamentação não é treinamento”Duas preocupações razoáveis que as pessoas têm:
- Nada do que é recuperado aqui treina um modelo. A fundamentação coloca informações em uma única solicitação. Ela não altera os pesos do modelo, e seu conteúdo não é usado para treinar o modelo de ninguém.
- O índice de recuperação contém apenas documentação pública. Nenhum conteúdo de cliente é incorporado a ele.
Para onde seus dados realmente vão — e como mantê-los dentro da infraestrutura que você controla — é tratado em Como usar seu próprio LLM controlado.
Por que isso produz respostas melhores
Seção intitulada “Por que isso produz respostas melhores”A fundamentação é o que permite ao assistente dizer “não sei” em vez de inventar algo. Como cada número vem de uma consulta real e cada afirmação sobre o produto vem de uma página real da documentação, uma resposta pode ser avaliada: cada uma traz um indicador de confiança e ressalvas em linguagem simples, e um resumo narrativo é verificado para que não omita discretamente uma limitação nem cite um número que a análise nunca produziu. Veja Respostas em que você pode confiar.
Relacionados
Seção intitulada “Relacionados”- Caminhos de análise — configure os nomes compartilhados
- Rastreamento de alocações — perguntar por que um resultado se moveu
- Arquitetura de IA e LLM — as superfícies e o caminho compartilhado