

Arquitetura de IA e LLM
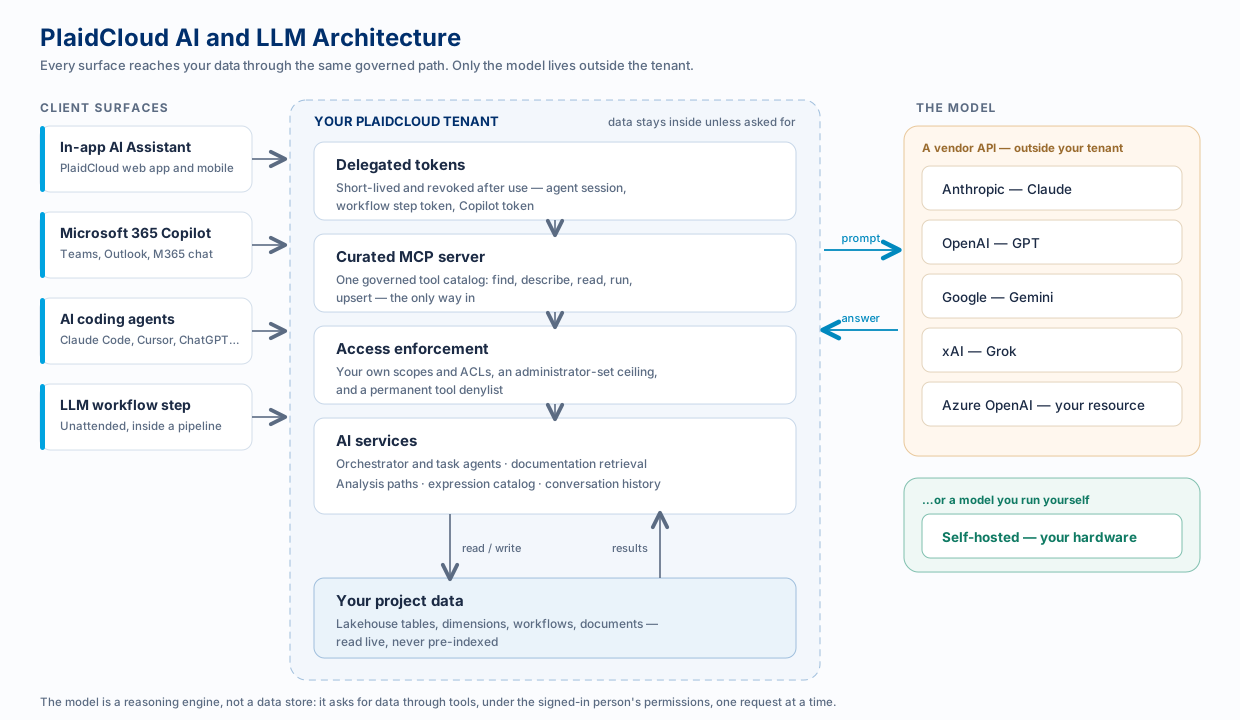
O PlaidCloud não tem um único recurso de IA. Ele oferece quatro formas de acessar um modelo — o assistente dentro do produto, o Microsoft 365 Copilot, agentes externos de programação e uma etapa de LLM dentro de um fluxo de trabalho — e as quatro seguem o mesmo caminho governado. O próprio modelo é intercambiável: Claude, GPT, Gemini, Grok, um recurso Azure OpenAI na sua própria assinatura ou um modelo hospedado por você.
Esta seção explica essa arquitetura: o que executa onde, o que cruza a fronteira e por quê.
As quatro superfícies
Seção intitulada “As quatro superfícies”| Superfície | Quem usa | Como o modelo acessa os dados | Por onde começar |
|---|---|---|---|
| Assistente de IA no aplicativo | Qualquer pessoa que trabalhe no PlaidCloud | Os agentes do próprio PlaidCloud chamam ferramentas internas em seu nome | Chat de IA do Weave |
| Microsoft 365 Copilot | Equipes inteiras, no Teams e no Outlook | Um agente publicado autentica a pessoa e depois chama o servidor MCP | Microsoft 365 Copilot |
| Agentes de programação com IA | Analistas e desenvolvedores | O cliente deles se conecta diretamente ao servidor MCP via OAuth | Primeiros passos |
| Etapa de LLM do fluxo de trabalho | Pipelines sem supervisão | No Anthropic, um token restrito apenas aos objetos que você vincula; nos demais provedores, nenhum acesso a dados — veja as regras da etapa | Etapa de LLM |
Elas diferem em quem conduz a interação e onde a conversa acontece. Não diferem no que o modelo pode acessar.
Um caminho governado
Seção intitulada “Um caminho governado”Qualquer que seja a superfície em que uma pergunta chegue, as mesmas cinco coisas são verdadeiras.
-
O modelo executa como uma pessoa, não como a plataforma. Toda solicitação carrega uma credencial de curta duração, revogada ao terminar, que representa o usuário autenticado. Não há uma conta de serviço compartilhada com direitos elevados por trás da IA.
-
As ferramentas são a única porta de entrada. O modelo não consegue consultar seu lakehouse diretamente. Ele chama um catálogo curado de ferramentas — localizar, descrever, ler, executar, fazer upsert — e cada chamada é verificada de forma independente.
-
Suas próprias permissões continuam limitando o modelo. Uma solicitação de IA nunca pode ver ou alterar algo que você mesmo não poderia ver ou alterar. A camada de IA restringe o acesso; nunca o amplia.
-
Um administrador define o teto, e ele começa fechado. O Acesso do agente de uma conexão de LLM começa como somente leitura. O Microsoft 365 Copilot começa sem nada: até que um administrador atribua um nível de acesso a alguém, a pessoa autenticada não recebe nenhum dado. São dois mecanismos separados, mas elevar qualquer um deles apenas limita o que a IA pode tentar — nunca amplia o que você já poderia alcançar por conta própria.
-
Algumas coisas ficam permanentemente fora dos limites. Configurações de credenciais e de conexão, gerenciamento de identidade e de grupos, alterações de controle de acesso, publicação e código implantável nunca podem ser chamados por uma credencial de IA — independentemente do que um administrador tenha concedido, em qualquer provedor. Isso permanece exclusivo de humanos.
A vida de uma pergunta
Seção intitulada “A vida de uma pergunta”Considere “Por que o custo de TI alocado para Atlanta aumentou no último trimestre?”, feita a partir de qualquer superfície:
-
Uma credencial é emitida para a pessoa que perguntou, com escopo restrito e curta duração.
-
As ferramentas são colocadas diante do modelo — restritas ao que a pergunta provavelmente exige nas superfícies que fazem essa restrição, e descobertas a partir do catálogo naquelas que não fazem.
-
O prompt vai para o modelo — a pergunta, as regras permanentes e as descrições das ferramentas. Ainda sem dados.
-
O modelo pede dados por meio de chamadas de ferramentas: resolver o caminho de análise, ler o esquema, executar o rastreamento da alocação, ler as linhas do direcionador. Cada chamada tem as permissões verificadas na chegada.
-
O modelo responde com base no que voltou, cita a página da documentação se consultou alguma e traz um indicador de confiança e ressalvas.
-
A credencial é revogada. Um token capturado não pode ser reutilizado depois que a solicitação termina.
O detalhe importante é a etapa 4: o modelo não tem seus dados. Ele pede fatias deles, e cada pedido é avaliado.
Leia a seguir
Seção intitulada “Leia a seguir”Relacionados
Seção intitulada “Relacionados”- Respostas em que você pode confiar — como as respostas são avaliadas e ressalvadas
- Caminhos de análise — nomes amigáveis para as tabelas sobre as quais sua equipe pergunta
- Arquitetura da plataforma — onde a IA se encaixa na plataforma como um todo