

Como usar seu próprio LLM controlado
Se seus dados incluem informações de saúde protegidas, dados pessoais, segredos comerciais ou qualquer coisa sob um contrato que determine onde podem ser processados, a pergunta que importa não é qual modelo é o mais inteligente. É a infraestrutura de quem enxerga o prompt.
O PlaidCloud trata o modelo como um componente substituível, para que você mesmo possa responder a essa pergunta.
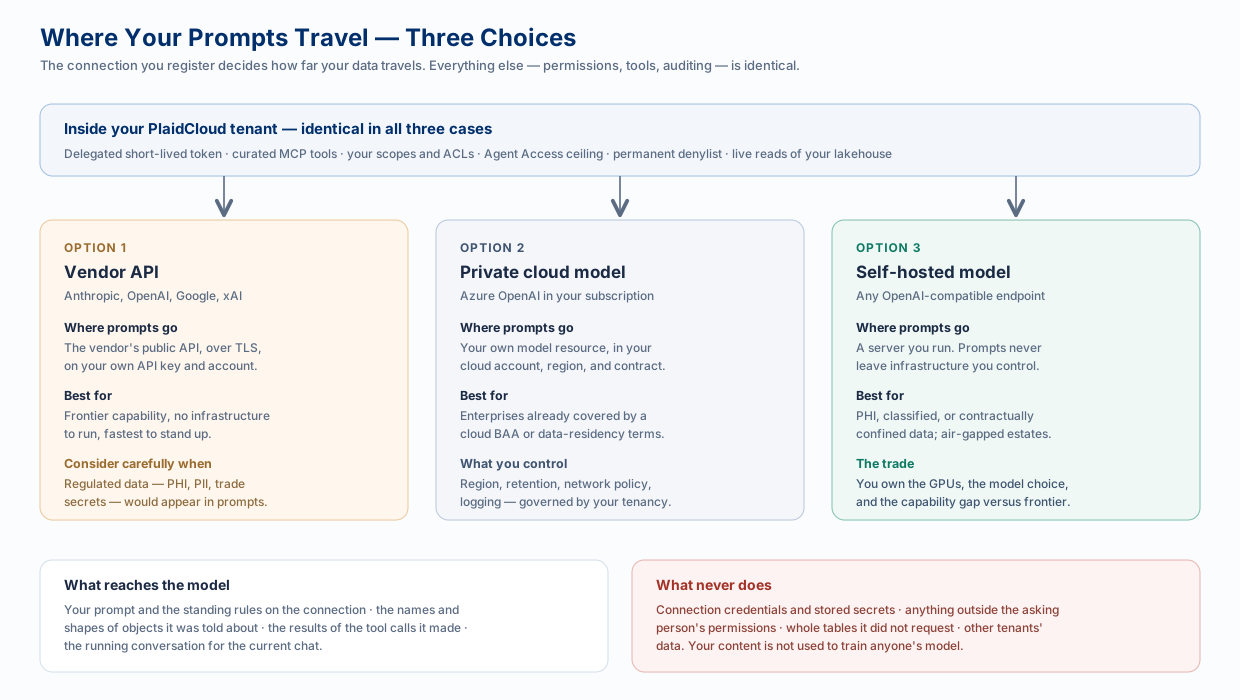
As três opções
Seção intitulada “As três opções”| API de fornecedor | Modelo em nuvem privada | Modelo autohospedado | |
|---|---|---|---|
| O que é | A API pública da Anthropic, OpenAI, Google ou xAI | Um recurso Azure OpenAI na sua própria assinatura | Qualquer endpoint compatível com OpenAI que você execute |
| Quem vê o prompt | O fornecedor, sob os termos dele e a sua conta | O seu tenant de nuvem, sob o seu contrato | Somente você |
| Região e retenção | As do fornecedor | Você define | Você define |
| Capacidade | De ponta | De ponta, um passo atrás da API pública | O que você conseguir hospedar |
| Você opera | Nada | Um recurso de nuvem | Servidores e GPUs |
| Indicado para | Análises gerais com dados não sensíveis | Empresas já cobertas por um contrato de nuvem | PHI, dados classificados, isolados da rede (air-gapped) ou contratualmente restritos |
As três são configuradas da mesma forma: uma conexão de Provedor de LLM com um provedor, uma chave, um modelo e — nas duas últimas — uma URL base apontando para o seu endpoint.
Por que vale a pena ter um modelo controlado
Seção intitulada “Por que vale a pena ter um modelo controlado”O prompt é a exposição, e o prompt contém seus dados. Um assistente fundamentado é útil justamente porque linhas reais chegam ao modelo: contagens de pacientes por unidade, preços ainda não divulgados, uma estrutura de custos que você não enviaria por e-mail. Todo o resto da arquitetura — permissões, controle de ferramentas, tokens de curta duração — governa o que sai dos seus sistemas. Escolher o modelo governa onde isso chega.
Apontar o PlaidCloud para um modelo que você controla significa:
- Um processador a menos para formalizar. Nenhum subprocessador terceiro a acrescentar a um contrato de proteção de dados, a um BAA ou a uma avaliação de fornecedor — porque a inferência acontece em um local que já está coberto.
- Residência que você pode comprovar. “Processado nesta região, nesta conta, sob este contrato” é uma afirmação que você pode evidenciar, e não uma em que precisa confiar.
- Retenção e registro nos seus termos. Você decide se os prompts são retidos, por quanto tempo e quem pode ler os logs.
- Sobrevive a uma mudança de política. Os termos de um fornecedor podem mudar; a infraestrutura que você opera não muda por baixo de você.
- Ambientes isolados da rede passam a ter um assistente. Para redes que não alcançam uma API pública, um modelo autohospedado é a única opção que existe.
O que realmente chega ao modelo
Seção intitulada “O que realmente chega ao modelo”Vale ser preciso, porque a resposta é mais restrita do que as pessoas supõem.
Enviado ao provedor:
- seu prompt e as regras permanentes da conexão
- os nomes e as formas dos objetos de que o agente foi informado — nomes de tabelas e colunas, nomes de dimensões, caminhos de documentos vinculados
- os resultados das chamadas de ferramentas feitas pelo modelo, ou seja, as linhas que ele pediu e teve permissão para receber
- a conversa em andamento no chat atual
Nunca enviado:
- credenciais de conexão, segredos armazenados ou cabeçalhos de autorização resolvidos
- qualquer coisa fora das permissões da pessoa que perguntou
- tabelas inteiras que o modelo não solicitou
- dados de outro tenant
E seu conteúdo não é usado para treinar o modelo de ninguém.
Em quais superfícies você controla o modelo
Seção intitulada “Em quais superfícies você controla o modelo”Esta é a parte que vale ler duas vezes, porque não é uniforme.
| Superfície | De quem é o modelo que executa |
|---|---|
| Etapa de LLM do fluxo de trabalho | Seu. A etapa usa a conexão de Provedor de LLM que você fixar ou o padrão do espaço de trabalho. |
| Assistente de IA no aplicativo | Seu, por meio da conexão de Provedor de LLM padrão do espaço de trabalho. O backend multiagente por trás de alguns recursos do assistente é definido por implantação e pode ser apontado para um modelo autohospedado — combine isso com o PlaidCloud. |
| Agentes de programação com IA | Deles. O Claude Code usa a Anthropic; o ChatGPT usa a OpenAI. O PlaidCloud é a fonte de dados, não o host do modelo. |
| Microsoft 365 Copilot | Da Microsoft. O Copilot executa nos modelos da Microsoft dentro do seu tenant do M365, sob o seu contrato com a Microsoft. |
Como configurar
Seção intitulada “Como configurar”-
Crie o endpoint. Crie o recurso e a implantação do Azure OpenAI na sua assinatura ou execute seu modelo por trás de uma API compatível com OpenAI.
-
Torne-o acessível por HTTPS em um nome de host público resolvível. As chamadas de saída são validadas antes de serem feitas: a URL base deve usar HTTPS, e endereços de loopback, de faixa privada, link-local ou de metadados de nuvem são recusados, com os redirecionamentos desativados. Coloque um gateway TLS em um nome de host real na frente de um modelo autohospedado e restrinja quem pode alcançá-lo na camada de rede.
-
Registre a conexão. Escolha o provedor, cole a chave, defina a URL base e defina o modelo — no Azure OpenAI, o campo de modelo é o seu nome da implantação.
-
Deixe o Acesso do agente como Somente leitura, a menos que uma tarefa específica precise de mais. É o controle mais barato que você tem.
-
Adicione suas regras. As instruções permanentes são o lugar certo para convenções da casa — como tratar identificadores, o que nunca incluir em uma resposta, quais ressalvas declarar sempre.
-
Defina-o como padrão do espaço de trabalho ou fixe-o nas etapas de fluxo de trabalho específicas que lidam com dados regulados.
Um meio-termo razoável
Seção intitulada “Um meio-termo razoável”A sensibilidade raramente é uniforme em um espaço de trabalho, e o modelo é escolhido por conexão — portanto, pode ser escolhido por tarefa. Um arranjo comum:
- um modelo de fornecedor de ponta como padrão do espaço de trabalho, para perguntas sobre esquema, ajuda com a documentação, criação de expressões e análise de dados não sensíveis
- um modelo controlado fixado nas etapas de fluxo de trabalho que tocam tabelas reguladas
Mesma plataforma, mesmas permissões, mesma trilha de auditoria — dois raios de impacto diferentes, adequados aos dados.
Relacionados
Seção intitulada “Relacionados”- Provedores e conexões de LLM — os campos e os adaptadores
- Arquitetura de IA e LLM — o caminho governado que toda superfície compartilha
- Recuperação, fundamentação e caminhos de análise — por que seus dados nunca são pré-indexados