

Table Upsert
Descrição
Seção intitulada “Descrição”Combina inserção e atualização numa única operação, com base numa ou mais colunas que designe como chave de correspondência. Para cada linha da origem: se existir no destino uma linha correspondente (com os mesmos valores de chave), atualiza-a; caso contrário, insere uma nova linha.
Utilize-o quando tiver um fluxo de dados incremental que inclua registos novos e revisões de registos existentes — atualizações de vendas, alterações a registos de colaboradores ou qualquer cenário de «refletir sempre o estado mais recente». Especifique cuidadosamente as colunas de correspondência: as linhas que partilham valores de chave mas diferem noutras colunas serão substituídas, pelo que uma má escolha de chave pode corromper os dados sem aviso.
Parâmetros de upsert
Seção intitulada “Parâmetros de upsert”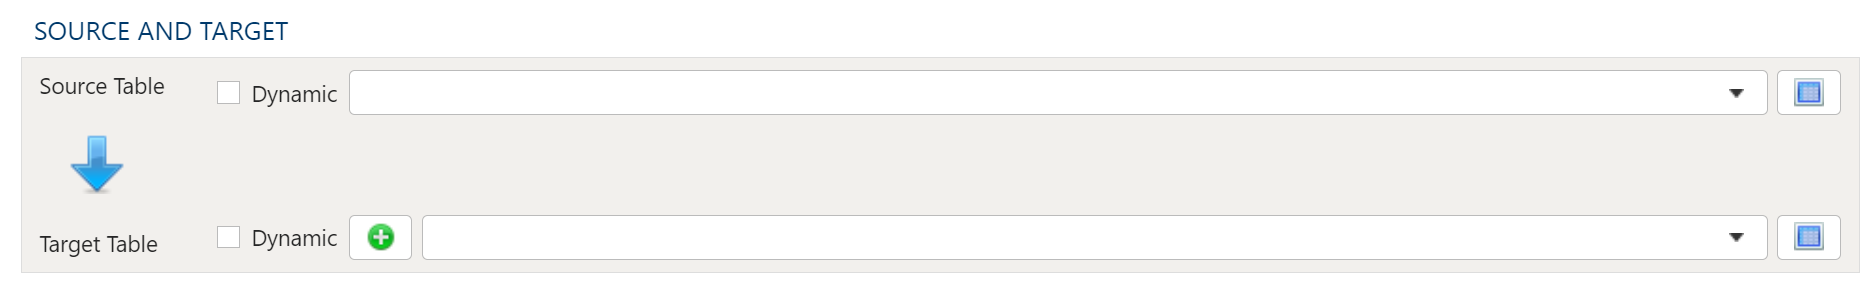
Para definir as tabelas de origem e de destino, selecione primeiro a tabela de dados da qual extrair através do menu pendente Tabela de origem. Em seguida, selecione uma tabela existente como tabela de destino através do menu pendente Tabela de destino.
Quando o passo é executado
Os passos Table Extract, Table Lookup, Table Inner Join, Table Cross Join, Table Outer Join, Table Anti Join, Junção de várias tabelas, Table Union Distinct, Table Union All, Table Pivot, Table Melt, Table In-Place Delete, Table Upsert e Table Append verificam as respetivas tabelas de origem quando são executados, antes de escreverem seja o que for. A verificação compara a consulta criada pelo passo com cada tabela de origem tal como está nesse momento:
- Uma coluna que o passo lê e que a tabela não tem, uma chave de junção que a tabela não tem ou que não consta das colunas de origem do passo, ou uma tabela de origem que o passo lê e que não foi criada impede o passo de avançar. Um único erro indica todos os problemas, cada um com a respetiva correção. Uma tabela de destino que já existia fica como estava, e uma que o passo teve de criar fica vazia.
- Uma coluna que o passo lista mas não lê, e que a tabela já não tem, acrescenta um aviso. O passo é executado sem ela.
- Table Union Distinct e Table Union All são a exceção para uma tabela de origem que não foi criada: tal como antes, deixam-na de fora, sem aviso, e combinam as restantes. Se nenhuma das respetivas tabelas de origem tiver sido criada, terminam com um aviso em vez de falharem.
Um passo cujo destino é uma vista limita-se a criar a vista, pelo que as colunas e as chaves de junção que lista só são verificadas em relação às respetivas tabelas quando o armazém de dados recusaria, de qualquer forma, criar essa vista. Nos restantes casos, apenas uma tabela de origem que não foi criada ou uma chave de junção que o passo não lista o impede de avançar, e não é acrescentado nenhum aviso.
Sempre que possível, o erro indica o passo que cria uma tabela e, quando a tabela tem uma coluna com um nome próximo do de uma coluna em falta, por exemplo uma que difere apenas na capitalização, indica também essa coluna.
Seleção de dados da tabela de origem
Seção intitulada “Seleção de dados da tabela de origem”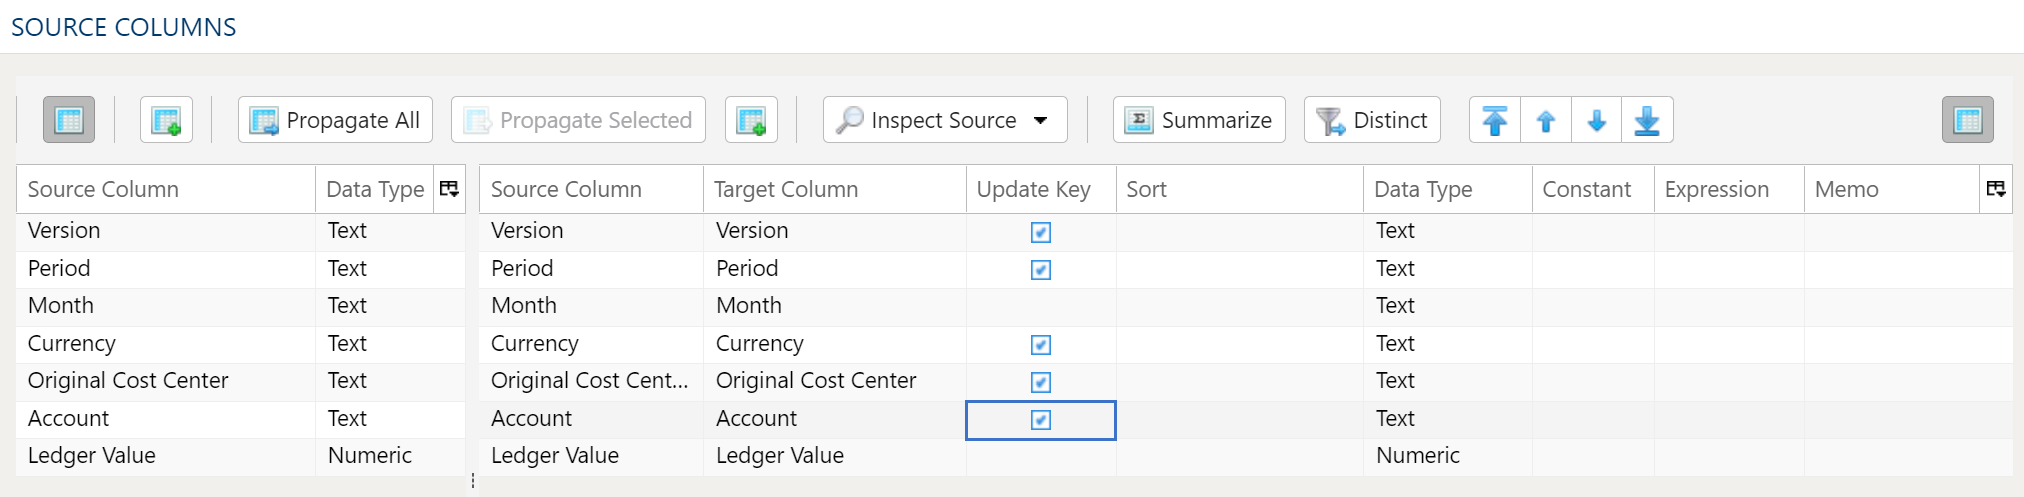
O Data Mapper é utilizado para mapear as colunas dos dados de origem para a tabela de dados de destino.
Inspeção e preenchimento do mapeador
Seção intitulada “Inspeção e preenchimento do mapeador”A utilização do botão de menu Inspecionar origem oferece formas adicionais de mapear colunas da origem para o destino:
- Preencher ambas as tabelas de mapeamento: propaga todos os valores da tabela de dados de origem para a tabela de dados de destino. É o comportamento predefinido.
- Preencher apenas a tabela de mapeamento de origem: mapeia apenas todos os valores da tabela de dados de origem. É útil ao modificar um fluxo de trabalho existente quando a estrutura de colunas da origem mudou.
- Preencher apenas a tabela de mapeamento de destino: propaga todos os valores apenas para a tabela de dados de destino.
Se as opções de colunas de origem e de destino não forem suficientes, é possível adicionar outras colunas à tabela de dados de destino de várias formas:
- Propagar tudo insere todas as colunas de origem na tabela de dados de destino, quer já existissem ou não.
- Propagar selecionadas insere apenas a(s) coluna(s) de origem selecionada(s).
- Clique com o botão direito do rato no lado do destino e selecione Inserir linha para inserir uma linha imediatamente acima da linha atualmente selecionada.
- Clique com o botão direito do rato no lado do destino e selecione Acrescentar linha para inserir uma linha no fim (extrema direita) da tabela de dados de destino.
Eliminar colunas
Seção intitulada “Eliminar colunas”Para eliminar colunas da tabela de dados de destino, selecione a(s) coluna(s) pretendida(s), clique com o botão direito do rato e selecione Eliminar.
Alterar a ordem das colunas
Seção intitulada “Alterar a ordem das colunas”Para reorganizar as colunas da tabela de dados de destino, selecione a(s) coluna(s) pretendida(s). Pode utilizar uma de duas opções:
- Setas de movimentação em bloco: selecione a opção de movimentação pretendida nas setas no canto superior direito
- Menu de contexto: clique com o botão direito do rato e selecione Mover para o início, Mover para cima, Mover para baixo ou Mover para o fim.
Reduzir o resultado apenas a registos distintos
Seção intitulada “Reduzir o resultado apenas a registos distintos”Para devolver apenas opções distintas, selecione a opção de menu Distinto. Isto apresenta um conjunto de caixas de seleção para cada coluna da origem. Basta assinalar qualquer caixa junto à coluna correspondente para devolver apenas resultados distintos.
Consoante a situação, pode ser preferível considerar a utilização de sumarização.
O processo de distinção mantém o primeiro registo único encontrado e descarta os restantes. Pode ser conveniente aplicar uma ordenação aos dados, se a consistência entre execuções for importante.
Chave de atualização
Seção intitulada “Chave de atualização”A grelha de colunas de destino tem uma coluna Chave de atualização, logo a seguir ao nome da coluna de destino. Assinale-a nas colunas que, em conjunto, identificam uma linha: uma linha de origem cujos valores de chave correspondam a uma linha já existente no destino atualiza essa linha, e qualquer outra linha de origem é inserida.
Todas as colunas começam assinaladas, por isso desassinale as colunas que não fazem parte da chave. Uma coluna sem definição de chave de atualização — uma que o preenchimento acabou de adicionar ou que foi guardada através da API sem ela — conta como chave. Pelo menos uma coluna tem de permanecer assinalada.
Colunas de destino em falta na tabela de destino
Seção intitulada “Colunas de destino em falta na tabela de destino”Um upsert atualiza e insere linhas na sua tabela de destino tal como a tabela está, e nunca lhe adiciona uma coluna, pelo que uma execução falha numa Coluna de destino que a tabela não tenha. Quando o passo é aberto, e novamente sempre que escolhe outra tabela de destino, o formulário lê as colunas da tabela de destino, preenchendo qualquer variável no respetivo nome a partir das variáveis do fluxo de trabalho. Cada Coluna de destino que a tabela não tem é apresentada a vermelho, atrás de um sinal de aviso ⚠, e, ao passar o cursor por cima, é indicado A coluna “region” não está na tabela de destino. Os nomes são comparados sem distinguir maiúsculas de minúsculas, pelo que Region corresponde a region. A mesma marca aparece numa Coluna de origem que as colunas de origem já não listam, por exemplo depois de a origem ter sido inspecionada novamente, e indica A coluna “region” não está nas colunas de origem.
Nada é marcado enquanto a tabela de destino ainda não existir, porque a execução a cria a partir do mapeamento, nem enquanto as suas colunas não puderem ser lidas. Uma coluna da tabela que o mapeamento omita não é marcada, mas o servidor continua a recusar guardar o passo, tal como descrito em O que é verificado ao guardar.
Ao guardar um passo com uma Coluna de destino marcada desta forma, a caixa de diálogo Colunas obsoletas encontradas lista as linhas marcadas sob Colunas, abaixo de Estas linhas indicam uma coluna que o passo não pode usar:, e termina com O passo não pode ser guardado até que as colunas em falta na tabela de destino lhe sejam adicionadas ou as respetivas linhas sejam removidas. Oferece duas opções:
- Remover todas e guardar — remover todas as linhas marcadas, para que essas colunas deixem de ser carregadas, e depois guardar.
- Cancelar — voltar ao passo sem guardar.
Não existe a opção Guardar mesmo assim, porque o servidor recusa guardar um mapeamento que indique uma coluna que a tabela de destino existente não tem. Para manter uma linha, adicione a respetiva coluna à tabela de destino e, em seguida, guarde novamente o passo. A exceção é uma tabela de destino cujo nome é dado por uma variável, como {year}/Customers: o servidor deixa essa verificação para a execução, pelo que a caixa de diálogo continua a oferecer Guardar mesmo assim. Quando as linhas estão marcadas apenas pela respetiva Coluna de origem, a caixa de diálogo oferece Remover todas e guardar, Guardar mesmo assim e Cancelar.
Filtros de dados de origem
Seção intitulada “Filtros de dados de origem”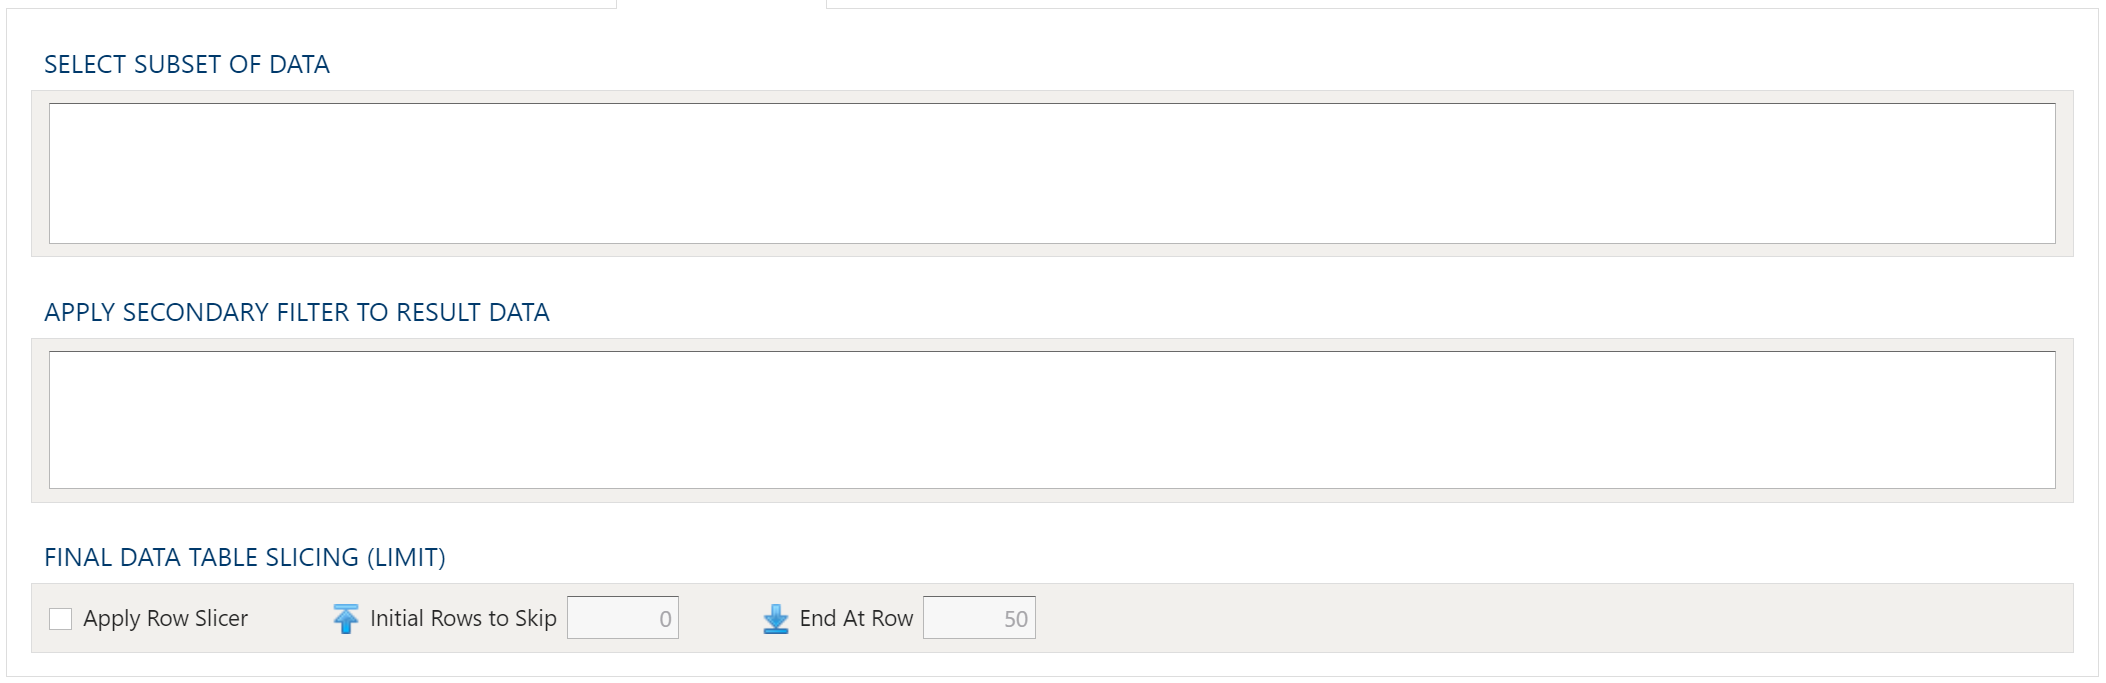
Para permitir a máxima flexibilidade, existem filtros de dados disponíveis nos dados de origem e nos dados de destino. Em conjuntos de dados maiores, pode ser especialmente vantajoso filtrar linhas na origem, para que as restantes operações sejam executadas sobre um conjunto de dados mais pequeno.
Selecionar subconjunto de dados
Este tipo de filtro permite filtrar os dados de origem recebidos com base nas condições especificadas.
Aplicar filtro secundário aos dados de resultado
Este tipo de filtro permite aplicar um filtro aos dados de resultado depois de transformados, com base nas condições especificadas. A possibilidade de aplicar um filtro ao resultado transformado permite exclusões com base nos resultados de cálculos complexos, sumarizações ou funções de janela.
Divisão final da tabela de dados (limite)
A capacidade de divisão de linhas permite limitar as linhas do conjunto de resultados com base num intervalo e num ponto de partida.
Sintaxe de filtros
A sintaxe de filtros utiliza o Python SQLAlchemy, que é a mesma sintaxe das outras expressões.
Consulte exemplos e funções de expressão na área Expressões.
O que é verificado ao guardar
Seção intitulada “O que é verificado ao guardar”- Pelo menos uma chave de atualização. Caso contrário, guardar é recusado com At least one target column must be marked as Update Key.
- O mapeamento corresponde a uma tabela de destino existente. Quando a tabela de destino já existe, o passo tem de mapear todas as suas colunas, não mapear nenhuma coluna que a tabela não tenha e atribuir a cada coluna o tipo da tabela, para que um upsert não possa eliminar uma coluna da tabela, com os respetivos dados, nem alterar o tipo de uma coluna. Numérico e moeda contam como o mesmo tipo. A recusa indica cada diferença, por exemplo The target columns must match the existing target table ‘customers’. The table has columns the step doesn’t map: region. Uma tabela de destino que ainda não existe, ou cujo nome é dado por uma variável, é verificada quando o passo é executado. O separador Colunas marca, antes de guardar, uma coluna que a tabela não tem e, a menos que o nome da tabela seja dado por uma variável, guardar oferece então apenas a opção de remover a respetiva linha. Consulte Colunas de destino em falta na tabela de destino.
- Um mapeamento vazio é preenchido por si. Guardar com uma tabela de origem escolhida mas sem colunas de origem ou de destino preenche o lado vazio a partir da origem, tal como Preencher ambas as tabelas de mapeamento faria.