

Arquitetura de IA e LLM
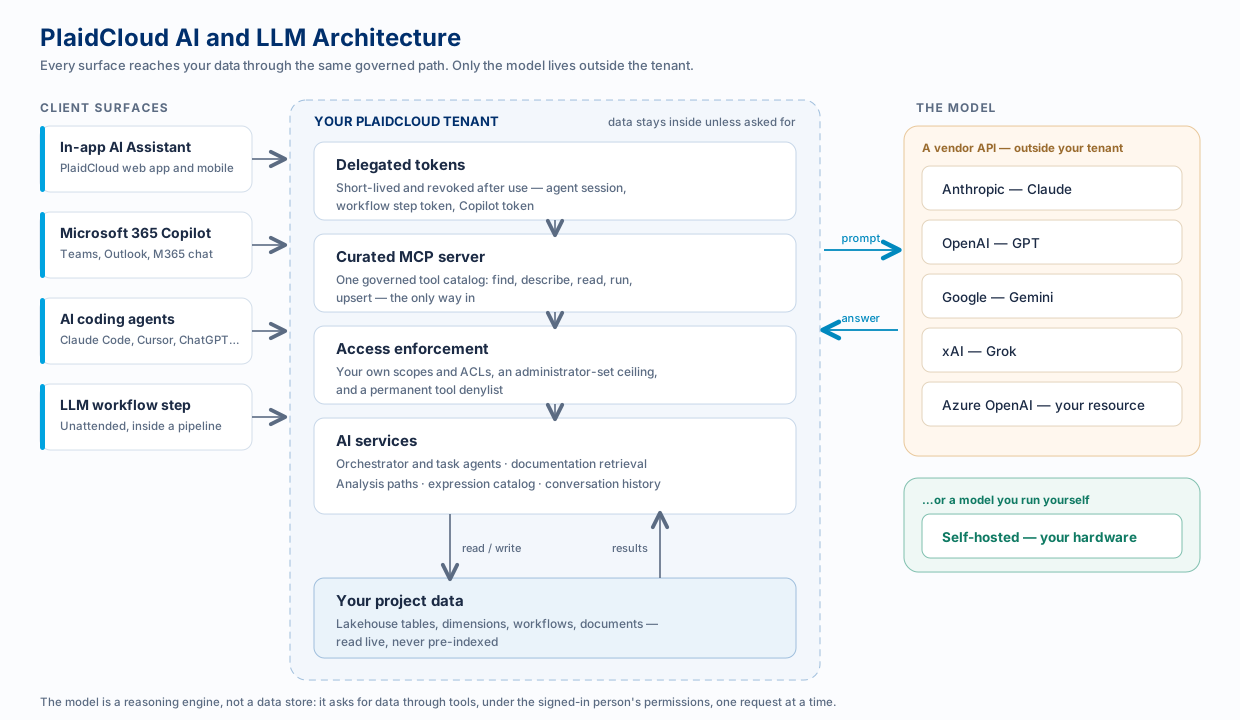
O PlaidCloud não tem uma única funcionalidade de IA. Tem quatro formas de aceder a um modelo — o assistente dentro do produto, o Microsoft 365 Copilot, agentes de programação externos e um passo LLM dentro de um fluxo de trabalho — e as quatro seguem o mesmo caminho governado. O próprio modelo é substituível: Claude, GPT, Gemini, Grok, um recurso Azure OpenAI na sua própria subscrição ou um modelo alojado por si.
Esta secção explica essa arquitetura: o que é executado onde, o que atravessa a fronteira e porquê.
As quatro superfícies
Seção intitulada “As quatro superfícies”| Superfície | Quem a utiliza | Como o modelo chega aos dados | Por onde começar |
|---|---|---|---|
| Assistente de IA integrado | Qualquer pessoa que trabalhe no PlaidCloud | Os agentes do próprio PlaidCloud chamam ferramentas internas em seu nome | Weave AI Chat |
| Microsoft 365 Copilot | Equipas inteiras, no Teams e no Outlook | Um agente publicado autentica a pessoa e depois chama o servidor MCP | Microsoft 365 Copilot |
| Agentes de programação com IA | Analistas e programadores | O respetivo cliente liga-se diretamente ao servidor MCP através de OAuth | Primeiros passos |
| Passo LLM do fluxo de trabalho | Pipelines não assistidos | No Anthropic, um token limitado apenas aos objetos que associar; nos outros fornecedores, nenhum acesso a dados — consulte as regras do passo | Passo LLM |
Diferem em quem conduz e em onde decorre a conversa. Não diferem no que o modelo pode tocar.
Um caminho governado
Seção intitulada “Um caminho governado”Em qualquer superfície em que uma pergunta chegue, aplicam-se sempre as mesmas cinco condições.
-
O modelo atua como uma pessoa, não como a plataforma. Cada pedido transporta uma credencial de curta duração, revogada no fim, que representa o utilizador autenticado. Não existe uma conta de serviço partilhada com direitos elevados por trás da IA.
-
As ferramentas são a única via de entrada. O modelo não pode consultar diretamente o seu lakehouse. Chama um catálogo selecionado de ferramentas — localizar, descrever, ler, executar, upsert — e cada chamada é verificada de forma independente.
-
As suas próprias permissões continuam a limitá-lo. Um pedido de IA nunca pode ver nem alterar algo que o utilizador não pudesse ver ou alterar. A camada de IA restringe o acesso; nunca o alarga.
-
Um administrador define o limite máximo, e este começa fechado. O Acesso do agente de uma ligação LLM começa em apenas leitura. O Microsoft 365 Copilot começa sem qualquer acesso: até que um administrador atribua a alguém um nível de acesso, uma pessoa autenticada não obtém dados. São dois mecanismos distintos, mas aumentar qualquer um deles apenas limita o que a IA pode tentar — nunca alarga o que já podia alcançar por si.
-
Algumas coisas estão permanentemente proibidas. As definições de credenciais e de ligação, a gestão de identidades e grupos, as alterações ao controlo de acesso, a publicação e o código implementável nunca podem ser chamados por uma credencial de IA — independentemente do que um administrador tenha concedido, em qualquer fornecedor. Estes permanecem exclusivamente humanos.
O percurso de uma pergunta
Seção intitulada “O percurso de uma pergunta”Tome-se a pergunta “Porque aumentou o custo de TI alocado a Atlanta no último trimestre?”, feita a partir de qualquer superfície:
-
É emitida uma credencial para a pessoa que pergunta, com âmbito limitado e curta duração.
-
As ferramentas são colocadas à frente do modelo — restringidas ao que a pergunta plausivelmente exige nas superfícies que fazem essa restrição, e descobertas a partir do catálogo nas que não a fazem.
-
O prompt segue para o modelo — a pergunta, as regras permanentes e as descrições das ferramentas. Ainda sem dados.
-
O modelo pede dados através de chamadas a ferramentas: resolver o caminho de análise, ler o esquema, executar o rastreio de alocação, ler as linhas de indutores. Cada chamada tem as permissões verificadas à chegada.
-
O modelo responde com base no que obteve, cita a página da documentação se a consultou e inclui um indicador de confiança e ressalvas.
-
A credencial é revogada. Um token capturado não pode ser reutilizado depois de o pedido terminar.
O detalhe importante é o passo 4: o modelo não tem os seus dados. Pede fatias deles, e cada pedido é julgado individualmente.
Leitura seguinte
Seção intitulada “Leitura seguinte”Relacionado
Seção intitulada “Relacionado”- Respostas em que pode confiar — como as respostas são classificadas e ressalvadas
- Caminhos de análise — nomes amigáveis para as tabelas sobre as quais a sua equipa faz perguntas
- Arquitetura da plataforma — onde a IA se insere na plataforma em geral