

Passo Extrair SQL
Descrição
Seção intitulada “Descrição”Preenche uma tabela de destino a partir de um SELECT SQL que escreve você mesmo. Enquanto Table Extract constrói a consulta a partir de colunas mapeadas e expressões, este passo entrega a consulta diretamente ao armazém de dados — para os casos em que o SQL é mais fácil de exprimir diretamente do que de montar no mapeador.
Recorra a ele quando precisar de uma construção que o mapeador não cobre: uma CTE recursiva, uma função de janela sobre uma partição que o mapeador não consegue descrever, ou uma consulta a várias tabelas que um passo de junção tornaria mais complicada.
Itens de configuração exclusivos
Seção intitulada “Itens de configuração exclusivos”Consulta SQL Select
Seção intitulada “Consulta SQL Select”O texto da consulta. Formate-o como SQL legível, em várias linhas e indentado — uma coluna ou cláusula por linha — em vez de uma única linha longa; o passo preserva o que escrever e a pessoa seguinte que o abrir tem de o ler.
A consulta é executada no Lakehouse do projeto, pelo que as funções disponíveis são o conjunto Lakehouse v1 ou v2, consoante a área de trabalho.
Pré-visualização
Clique em Pré-visualização no separador Origem para ver até 100 linhas do que o passo leria, sem o executar. Se o resultado for mais longo, a pré-visualização indica que mostra as primeiras linhas e que tem de executar o passo para as ler todas.
A pré-visualização preenche as variáveis do projeto e do fluxo de trabalho da mesma forma que uma execução. Não suporta formatos de variáveis como {x:>9} e não consegue preencher uma variável que só tem valor durante uma execução, como um valor de acionamento.
A pré-visualização só lê dados. Recusa uma consulta que possa alterar alguma coisa e mostra uma mensagem em vez de linhas:
- A pré-visualização só suporta funções SQL padrão. Execute o passo para ver os resultados. A consulta usa uma função que a pré-visualização não consegue verificar como só de leitura. Execute o passo para ver o resultado.
- Uma consulta que não seja um único
SELECT, ou cujas variáveis se expandam para uma instrução que escreve, é recusada.
A pré-visualização não está disponível num projeto bloqueado, em ligações SQL Server, Oracle ou SQLite, nem para passos que são executados através de um agente, como Agent Remote Execution of SQL.
Ao contrário dos outros passos SQL, este passo não preenche variáveis, pelo que a sua pré-visualização também não.
Itens de configuração comuns
Seção intitulada “Itens de configuração comuns”Configuração do Data Mapper
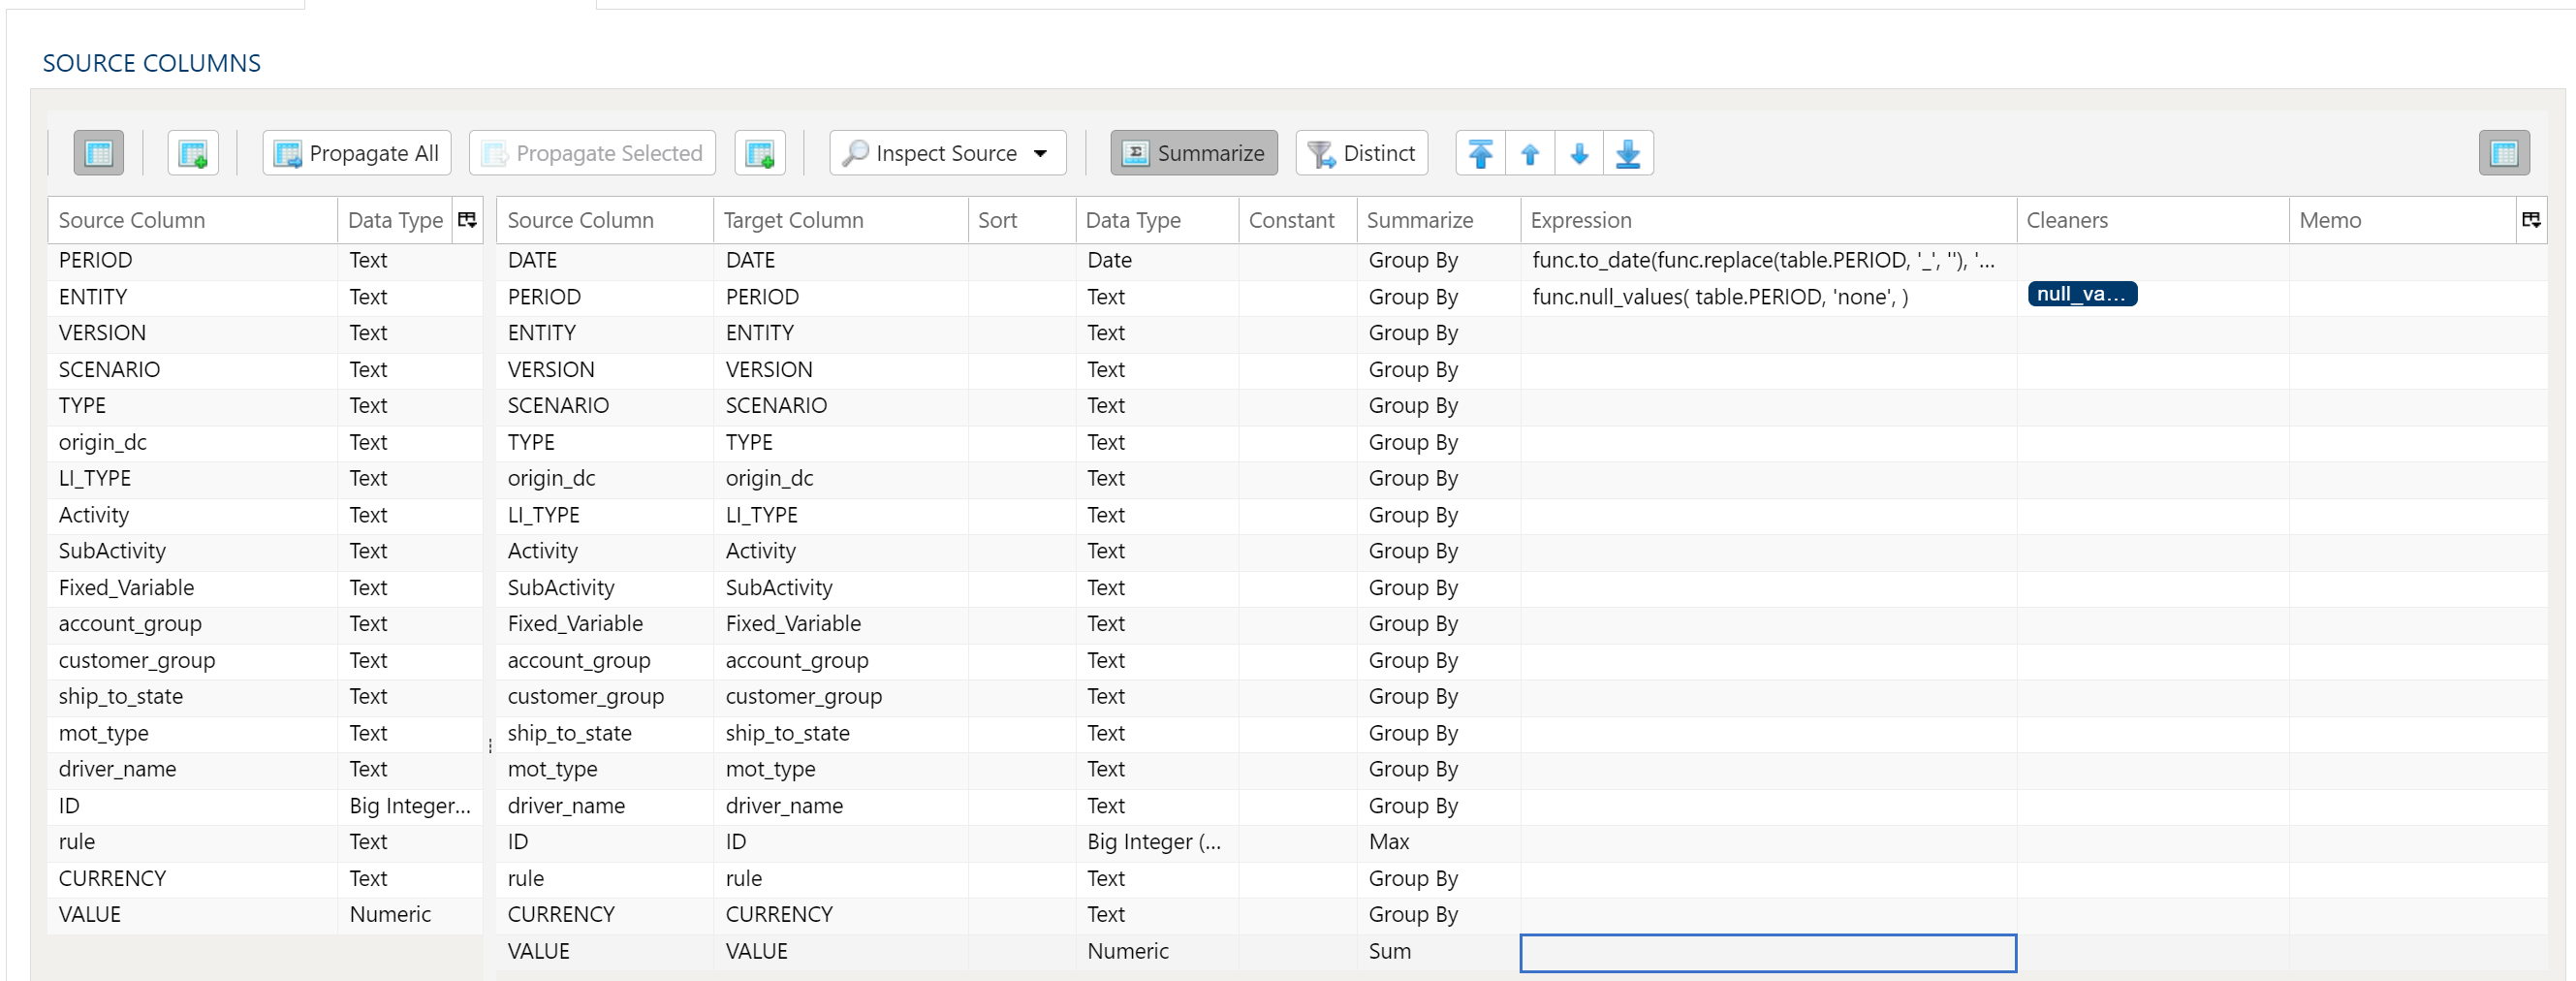
O Data Mapper serve para mapear colunas dos dados de origem para a tabela de dados de destino.
Inspeção e preenchimento do mapeador
Utilizar o botão de menu Inspecionar origem oferece formas adicionais de mapear colunas da origem para o destino:
- Preencher ambas as tabelas de mapeamento: propaga todos os valores da tabela de dados de origem para a tabela de dados de destino. É o comportamento predefinido.
- Preencher apenas a tabela de mapeamento de origem: mapeia apenas todos os valores da tabela de dados de origem. É útil ao modificar um fluxo de trabalho existente cuja estrutura de colunas de origem mudou.
- Preencher apenas a tabela de mapeamento de destino: propaga todos os valores apenas para a tabela de dados de destino.
Se as opções de colunas de origem e de destino não forem suficientes, podem adicionar-se outras colunas à tabela de dados de destino de várias formas:
- Propagar tudo insere todas as colunas de origem na tabela de dados de destino, quer já existam ou não.
- Propagar selecionadas insere apenas as colunas de origem selecionadas.
- Clique com o botão direito do rato no lado do destino e selecione Inserir linha para inserir uma linha imediatamente acima da linha atualmente selecionada.
- Clique com o botão direito do rato no lado do destino e selecione Acrescentar linha para inserir uma linha no fim (extremo direito) da tabela de dados de destino.
Eliminar colunas
Para eliminar colunas da tabela de dados de destino, selecione as colunas pretendidas, clique com o botão direito do rato e selecione Eliminar.
Colunas de origem que já não constam da lista
Uma linha de destino pode indicar uma Coluna de origem que a tabela de dados de origem já não lista, por exemplo depois de a origem ter sido inspecionada novamente. O passo nunca remove essa linha por si. Em vez disso, o nome da coluna é apresentado a vermelho, atrás de um sinal de aviso ⚠, e, ao passar o cursor por cima, é indicado que a coluna não consta das colunas de origem. Num passo com várias tabelas, como uma união, cada tabela é verificada em relação às suas próprias colunas de origem.
Uma linha com uma Constante, uma Expressão ou um resumo Contagem (incluindo nulos) nunca é sinalizada, porque o passo não lê a respetiva coluna de origem. Nada é sinalizado enquanto a tabela de dados de origem não listar colunas, por exemplo antes de a origem ser inspecionada pela primeira vez.
Ao guardar um passo que ainda tem linhas sinalizadas, uma caixa de diálogo Colunas obsoletas encontradas lista-as sob o separador ou a tabela em que se encontram e oferece três opções:
- Remover todas e guardar: remove as linhas sinalizadas e depois guarda.
- Guardar mesmo assim: guarda o passo tal como está.
- Cancelar: volta ao passo sem guardar.
Para manter uma linha e eliminar o respetivo aviso, adicione a coluna de volta à tabela de dados de origem ou escolha uma coluna que a tabela de dados de origem liste.
Tipo de dados da coluna
Cada coluna de destino tem um Tipo. Uma coluna propagada da origem mantém o tipo da coluna de origem; uma linha que adicione manualmente começa como Texto, e define o Tipo para indicar o que a coluna deve realmente ser. Uma coluna que pretenda somar ou ordenar precisa do respetivo tipo numérico ou de data, porque o texto é ordenado e somado como texto.
Um passo guardado com uma coluna sem qualquer tipo é, mesmo assim, executado. O tipo é determinado quando o passo é iniciado, a partir da coluna de origem que essa coluna lê. Quando não há nada de onde o ler, é tratado como texto: as colunas de um passo Extrair SQL vêm da consulta que escreveu e não de uma origem mapeada e, quando várias origens têm o mesmo nome de coluna com tipos discordantes, é utilizado texto em vez de adivinhar um deles, porque um palpite errado produz uma conversão que o armazém pode rejeitar, e tudo se converte em texto.
Definir o Tipo manualmente continua a ser a forma de indicar o que uma coluna deve ser. Deixá-lo por definir significa aceitar o que a coluna de origem for.
Alterar a ordem das colunas
Para reordenar as colunas na tabela de dados de destino, selecione as colunas pretendidas. Pode utilizar:
- Setas de movimento em massa: selecione a opção de movimento pretendida nas setas no canto superior direito
- Menu de contexto: clique com o botão direito do rato e selecione Mover para o início, Mover para cima, Mover para baixo ou Mover para o fim.
Reduzir o resultado apenas a registos distintos
Para devolver apenas opções distintas, selecione a opção de menu Distinto. Isto apresenta um conjunto de caixas de verificação para cada coluna da origem. Basta marcar a caixa junto da coluna correspondente para devolver apenas resultados distintos.
Consoante a situação, pode ser preferível considerar a utilização da sumarização.
O processo de distinção mantém o primeiro registo único encontrado e descarta os restantes. Pode querer aplicar uma ordenação aos dados, se for importante para a consistência entre execuções.
Agregação e agrupamento
Para agregar resultados, selecione a opção de menu Resumir. Isto apresenta um conjunto de caixas de seleção para cada coluna da tabela de dados de destino. Escolha um método de sumarização adequado para cada coluna.
Quando Inspecionar origem preenche as colunas, uma coluna numérica começa como Agrupar por em vez de Soma se o nome se assemelhar a um identificador, como id, customer_id, Order No ou CustomerKey, se a respetiva tabela a definir como chave ou se a junção a utilizar como chave.
- Agrupar por
- Soma
- Mínimo
- Máximo
- Primeiro
- Último
- Contagem
- Contagem (incluindo nulos)
- Média
- Desvio padrão
- Desvio padrão da amostra
- Desvio padrão da população
- Variância
- Variância da amostra
- Variância da população
- Avançado sem agrupar por
Para uma utilização avançada do Data Mapper, como expressões, limpeza e constantes, consulte Utilização avançada do Data Mapper