

Passo Importar SQL
Descrição
Seção intitulada “Descrição”Importa o resultado de uma consulta SQL feita a uma base de dados externa para uma tabela de projeto do PlaidCloud. A consulta é executada na base de dados remota; apenas o conjunto de resultados é trazido para o PlaidCloud.
Difere de Importar tabelas de bases de dados externas porque é você que escreve o SQL — útil para junções, filtros ou agregações complexos que pretende que a base de dados de origem execute antes de os dados chegarem ao PlaidCloud.
Parâmetros de importação
Seção intitulada “Parâmetros de importação”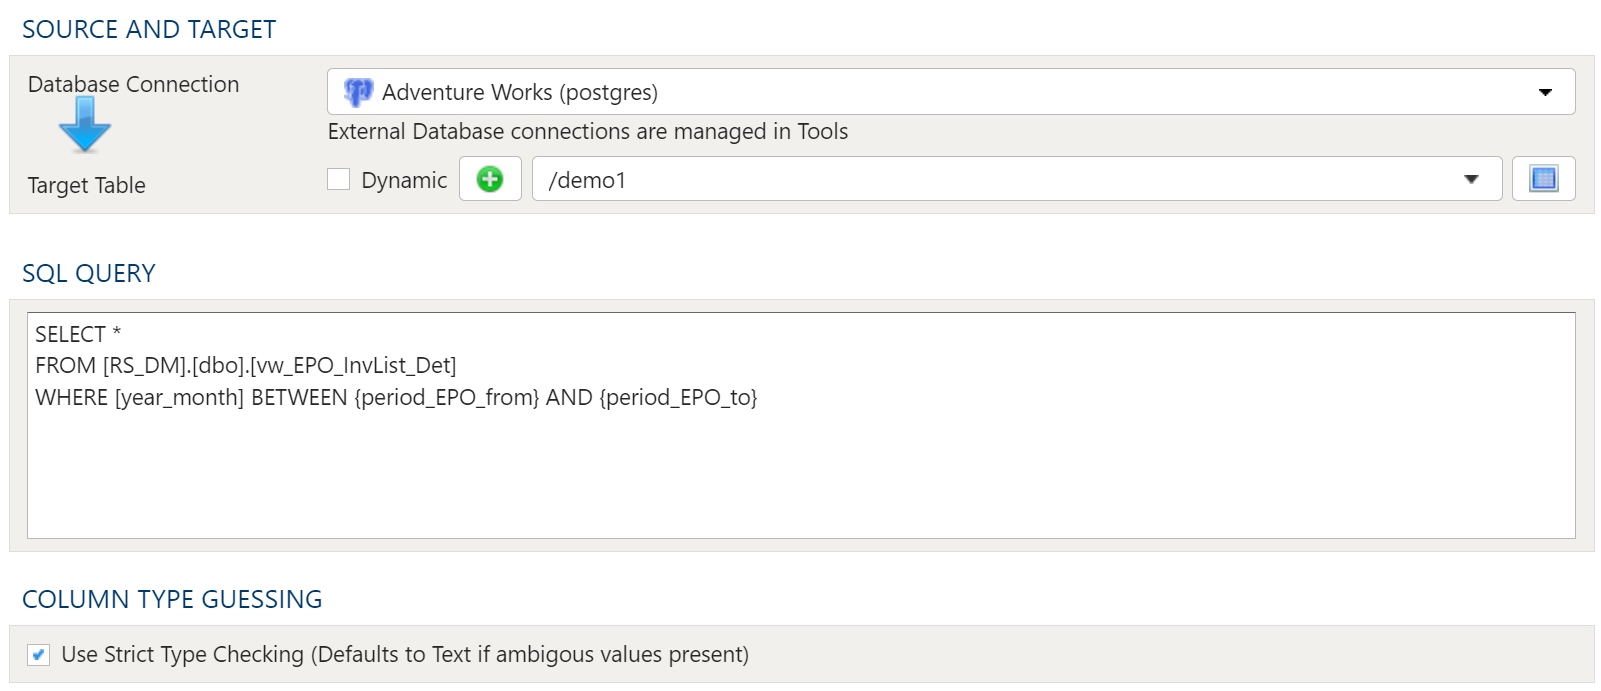
Origem e destino
Seção intitulada “Origem e destino”Ligação à base de dados
Seção intitulada “Ligação à base de dados”Para estabelecer uma Ligação à base de dados, consulte Ligações de dados do PlaidCloud
Tabela de destino
A seleção de destino para importações está limitada apenas a tabelas, uma vez que as vistas não contêm dados subjacentes.
Opção dinâmica
A opção dinâmica permite especificar uma tabela através de texto, incluindo variáveis. É útil em fluxos de trabalho orientados por variáveis, em que as referências a tabelas e vistas são relativas às variáveis especificadas.
Um exemplo que utiliza a variável current_month para apontar dinamicamente para a tabela de destino:
legal_entity/inputs/{current_month}/ledger_valuesOpção estática
Quando se pretende uma tabela específica como destino da importação, deixe a caixa Dynamic desassinalada e selecione a tabela de destino.
Se a tabela de destino não existir, selecione o botão Criar novo para criar a tabela na localização pretendida.
O Explorador de tabelas está sempre disponível com qualquer seleção de tabela. Clique no botão do Explorador de tabelas à direita da seleção da tabela e abre-se uma janela do Explorador de tabelas.
Consulta SQL
Seção intitulada “Consulta SQL”Nesta secção, escreva a consulta SQL que devolve os dados pretendidos.
Pré-visualização
Clique em Pré-visualização no separador Origem para ver até 100 linhas do que o passo leria, sem o executar. Se o resultado for mais longo, a pré-visualização indica que mostra as primeiras linhas e que tem de executar o passo para as ler todas.
A pré-visualização preenche as variáveis do projeto e do fluxo de trabalho da mesma forma que uma execução. Não suporta formatos de variáveis como {x:>9} e não consegue preencher uma variável que só tem valor durante uma execução, como um valor de acionamento.
A pré-visualização só lê dados. Recusa uma consulta que possa alterar alguma coisa e mostra uma mensagem em vez de linhas:
- A pré-visualização só suporta funções SQL padrão. Execute o passo para ver os resultados. A consulta usa uma função que a pré-visualização não consegue verificar como só de leitura. Execute o passo para ver o resultado.
- Uma consulta que não seja um único
SELECT, ou cujas variáveis se expandam para uma instrução que escreve, é recusada.
A pré-visualização não está disponível num projeto bloqueado, em ligações SQL Server, Oracle ou SQLite, nem para passos que são executados através de um agente, como Agent Remote Execution of SQL.
Dedução de tipos de coluna
Seção intitulada “Dedução de tipos de coluna”As importações SQL têm a opção de tentar deduzir o tipo de dados durante o carregamento, ou de definir todas as colunas com o tipo Texto. Definir os tipos de dados dinamicamente pode ser mais rápido se os dados estiverem limpos, mas pode causar problemas em algumas circunstâncias.
Por exemplo, se a maior parte dos dados parecer numérica mas existir também algum texto, pode tentar defini-la como numérica, causando problemas de carregamento por tipos de dados incompatíveis. Ou pode haver problemas se existir um código de produto numérico de 16 dígitos, por exemplo. Cortaria os zeros à esquerda, resultando num número em vez de um código de 16 dígitos.
Definir os dados como texto, porém, exige um passo Extract posterior para converter para o tipo adequado quaisquer tipos de dados que não devam ser texto, como datas ou valores numéricos.
Resolução de problemas
Seção intitulada “Resolução de problemas”| Sintoma | Causa provável |
|---|---|
| O passo demorou visivelmente mais do que o habitual — até cerca de meia hora a mais — sem que nada mais na sua consulta, ligação ou volume de dados tenha mudado | O trabalhador em segundo plano que executa a importação foi interrompido a meio (um reinício ou despejo do lado da plataforma, e não algo no seu fluxo de trabalho), e a plataforma repetiu a importação da tabela por si. A repetição só começa quando a interrupção é detetada, o que explica o tempo adicional. |
| O passo terminou com sucesso mesmo assim após esse atraso | A repetição substitui por completo o conteúdo da tabela, pelo que o resultado é o mesmo que o de uma única execução limpa — não há mais nada a verificar ou refazer. |
| O passo falha com “has already been attempted and cannot be safely re-run” | Num passo Importar SQL, esta recusa já não acontece — uma interrupção a meio da execução é repetida. Continuará a vê-la, por conceção, ao restaurar um arquivo de projeto ou ao carregar uma dimensão, onde voltar a executar criaria um duplicado em vez de substituir algo. Abra um pedido de suporte se a vir num próprio passo Importar SQL. |