

Importar Excel
Descrição
Seção intitulada “Descrição”Importe folhas de trabalho específicas de ficheiros Microsoft Excel a partir do PlaidCloud Document. O Analyze suporta o formato Excel antigo (XP/2003), bem como o novo formato (2007/2010/2013). Isto inclui, entre outros, os seguintes tipos de ficheiro:
- XLS
- XLSX
- XLSB
- XLSM
Os livros binários (XLSB), os ficheiros XLS antigos e os ficheiros ODS importam folhas de trabalho e intervalos de células da mesma forma que o XLSX.
As importações de Excel são transmitidas através de armazenamento temporário, em vez de carregarem o livro inteiro em memória, pelo que ficheiros muito grandes são importados sem esgotar a memória. Os tipos de dados de origem — decimais, datas e carimbos de data/hora — são preservados na tabela de destino, em vez de passarem por texto.
Exemplos
Seção intitulada “Exemplos”Ainda sem exemplos…
Parâmetros de importação
Seção intitulada “Parâmetros de importação”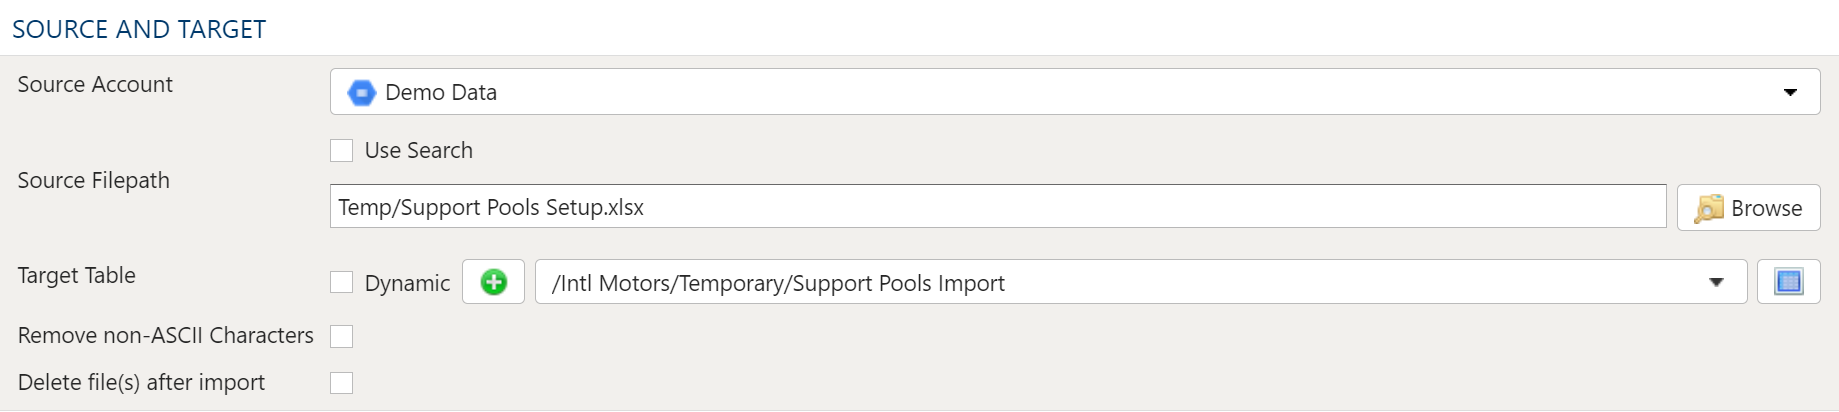
O seletor de ficheiros nesta transformação permite escolher um ficheiro guardado numa localização de documentos do PlaidCloud para importar.
Também pode escolher um diretório para importar, e todos os ficheiros nesse diretório serão importados como parte da execução da transformação.
Conta de origem
Escolha uma conta de documentos do PlaidCloud à qual tenha acesso. Isto permite-lhe selecionar um diretório ou ficheiro na seleção seguinte.
Dentro de um projeto, a lista oferece também Project Default no topo, que substitui a conta que o projeto tem atualmente definida como predefinida. Um novo passo pré-seleciona Project Default quando o projeto tem uma; um passo existente mantém a conta com que já tinha sido guardado até que a altere. Um passo deixado em Project Default é executado com a conta que for a predefinida do projeto nesse momento; se não existir nenhuma, a execução falha e indica o projeto, em vez de recorrer a outra conta.
Opção Pesquisar
A opção Pesquisar permite encontrar todos os ficheiros correspondentes abaixo de um caminho de diretório especificado para importar. Pode ser particularmente útil se for necessário incluir muitos ficheiros, mas estes estiverem guardados em diretórios aninhados ou misturados com outros ficheiros no mesmo diretório que não pretende importar.
O caminho de pesquisa selecionado é o diretório inicial onde a pesquisa é feita. O processo de pesquisa procura todos os ficheiros nesse diretório, bem como nos subdiretórios, que correspondam às condições de pesquisa especificadas. Certifique-se de que os critérios de pesquisa também se aplicam aos ficheiros nos subdiretórios.
A pesquisa pode ser aplicada com as seguintes condições:
- Exato: corresponde exatamente ao texto pesquisado
- Começa com: corresponde a qualquer ficheiro que comece com o texto pesquisado
- Contém: corresponde a qualquer ficheiro que contenha o texto pesquisado
- Termina com: corresponde a qualquer ficheiro que termine com o texto pesquisado
Um assistente de IA ou a API REST também podem definir a pesquisa como glob, um padrão com carateres universais como CO Store*.yxdb comparado com o nome completo do ficheiro sem distinguir maiúsculas de minúsculas, ou como regex, uma expressão regular com a qual o nome completo do ficheiro tem de corresponder. Uma expressão regular distingue maiúsculas de minúsculas, a menos que comece por (?i).
Caminho do ficheiro de origem
Quando é necessário importar um ficheiro ou um diretório de ficheiros específico, escolher o ficheiro ou o diretório é melhor opção do que utilizar a pesquisa.
Para selecionar o ficheiro ou o diretório, basta utilizar o botão de procura para escolher o caminho da conta de documentos selecionada acima.
Substituição de variáveis
Tanto na opção de pesquisa como na opção de ficheiro/diretório específico, podem utilizar-se variáveis no caminho, no texto de pesquisa e nos nomes dos ficheiros.
Um exemplo que utiliza a variável current_month para apontar dinamicamente para o ficheiro correto:
legal_entity/inputs/{current_month}/ledger_values.csvTabela de destino
A seleção de destino das importações está limitada a tabelas, uma vez que as vistas não contêm dados subjacentes.
Opção dinâmica
A opção dinâmica permite especificar uma tabela através de texto, incluindo variáveis. É útil quando se utilizam fluxos de trabalho orientados por variáveis, em que as referências a tabelas e vistas são relativas às variáveis especificadas.
Um exemplo que utiliza a variável current_month para apontar dinamicamente para a tabela de destino:
legal_entity/inputs/{current_month}/ledger_valuesOpção estática
Quando pretende uma tabela específica como destino da importação, deixe a caixa Dinâmico desmarcada e selecione a tabela de destino.
Se a tabela de destino não existir, selecione o botão Criar novo para criar a tabela na localização pretendida.
O Explorador de tabelas está sempre disponível com qualquer seleção de tabela. Clique no botão Explorador de tabelas à direita da seleção de tabela e abre-se uma janela do Explorador de tabelas.
Opção Remover carateres não ASCII
Ao selecionar esta opção, a importação remove todo o conteúdo que não seja ASCII. Embora o PlaidCloud suporte plenamente Unicode (UTF-8), os ficheiros do mundo real podem conter todo o tipo de codificações e carateres perdidos que dificultam o seu processamento.
Se se espera que o conteúdo do ficheiro seja apenas ASCII, selecionar esta caixa ajuda a garantir que o processo de importação decorre sem problemas.
Opção Eliminar ficheiros após a importação
Esta opção permite que o processo de importação elimine o ficheiro da conta de documentos do PlaidCloud depois de uma importação bem-sucedida.
Pode ser útil se os ficheiros de importação forem gerados e puderem ser recriados a partir de um sistema de registo, ou se não houver motivo para manter os ficheiros de entrada em bruto depois de processados.
Só são eliminados os ficheiros que foram importados. Um ficheiro que tenha sido ignorado ou que tenha produzido um aviso durante a importação permanece na pasta.
Opção Ignorar reimportação se os ficheiros de origem não tiverem sido alterados
Quando esta opção está ativada, uma execução do fluxo de trabalho deste passo ignora toda a importação (transferência, conversão e reconstrução da tabela) se os ficheiros de origem e as definições do passo não tiverem sido alterados desde a última execução bem-sucedida. Isto evita repetir o trabalho quando um fluxo de trabalho agendado é executado novamente sobre ficheiros de origem que não mudaram.
O passo compara cada ficheiro de origem pelo respetivo caminho, tamanho e hora da última modificação (e ainda por um hash do conteúdo, quando a origem o fornece). Se algum ficheiro for adicionado, removido ou alterado, ou se a configuração do passo mudar, a importação é executada normalmente. A opção está ativada por predefinição (desmarque-a para reimportar sempre) e as importações manuais e pontuais são sempre executadas.
Para ignorar a importação, é também necessário que a tabela de destino ainda contenha as linhas carregadas pela última importação. Se a tabela tiver sido entretanto esvaziada ou não for possível ler o respetivo número de linhas, a importação é executada novamente, em vez de ser ignorada e deixar os passos seguintes sem dados.
Algumas origens (por exemplo, SFTP) não fornecem um hash do conteúdo, pelo que, nesses casos, o sinal de alteração é apenas o tamanho e a hora da última modificação do ficheiro. Um ficheiro substituído no local com o mesmo tamanho e a mesma hora de modificação seria então tratado como inalterado e ignorado; desmarque esta opção num passo cuja origem possa ser atualizada dessa forma.
Cabeçalho
Seção intitulada “Cabeçalho”Como os ficheiros Excel podem ou não conter cabeçalhos, o PlaidCloud permite utilizar os cabeçalhos, ignorá-los ou utilizar a ordem das colunas para determinar o alinhamento das colunas.
- Sem cabeçalho: O ficheiro não contém cabeçalho. Utilize a lista de origem no Data Mapper para determinar o alinhamento das colunas
- Tem cabeçalho - usar cabeçalho e substituir lista de campos: O ficheiro tem um cabeçalho. Utilize os nomes de cabeçalho especificados e ignore a lista de origem no Data Mapper.
- Tem cabeçalho - ignorar cabeçalho e usar a lista de campos: O ficheiro tem um cabeçalho, mas este deve ser ignorado. Utilize os nomes de cabeçalho especificados pela lista de origem no Data Mapper.
Os espaços iniciais e finais e as quebras de linha nas células de cabeçalho são removidos dos nomes das colunas.
Seleção de linhas
Seção intitulada “Seleção de linhas”Para ficheiros de entrada com registos supérfluos, pode especificar um número de linhas a ignorar antes de processar os dados. Isto é útil se os ficheiros contiverem blocos de cabeçalho que têm de ser ignorados antes de chegar aos dados tabulares.
Selecione Keep Empty Text Cells As Empty String para carregar uma célula de texto vazia como uma cadeia vazia em vez de NULL.
Mais opções do Excel contém os seguintes campos:
- Omitir as linhas que a folha oculta (
skip_hidden_rows) — as linhas que a folha oculta não são importadas. - Importar uma célula com erro de fórmula como o texto do erro (#DIV/0!), não vazia (
keep_error_cells) — uma célula com erro de fórmula é importada como o respetivo texto de erro, como#DIV/0!, em vez de vazia. - Algarismos significativos (
significant_digits) — arredonda cada número decimal para este número de algarismos significativos. O Excel mantém 15. - Posição da folha (
sheet_index) — importa a folha de trabalho nesta posição (base 0) no livro, em vez das folhas de trabalho escolhidas por nome.
Em Folhas de trabalho a importar, selecione Importar a primeira folha que tiver dados (sheet_first_with_data) para importar a primeira folha de trabalho que tenha dados, ignorando as folhas vazias que a precedem. Quando nenhuma tem dados, é lida a primeira folha de trabalho do livro.
Variável da palavra-passe do livro abre livros protegidos por palavra-passe. Introduza a variável de fluxo de trabalho ou de projeto que contém a palavra-passe, como {xlsx_password}, e não a palavra-passe em si: um passo cujo campo de palavra-passe contenha algo que não seja uma referência a uma variável é recusado quando o guarda, para que a palavra-passe nunca apareça no passo, nas suas versões ou nas suas cópias. Os passos que tinham uma palavra-passe escrita antes desta regra tiveram-na movida automaticamente para uma nova variável de projeto, visível apenas para Arquitetos, e passam agora a referenciar essa variável.
O que ler
Seção intitulada “O que ler”Cada entrada na importação seleciona uma folha de trabalho, um intervalo nomeado definido pelo livro ou um intervalo de células específico — os três são equivalentes e uma importação pode misturá-los em várias entradas.
- Folha de trabalho: Lê uma folha completa, selecionada por nome.
- Intervalo nomeado: Lê um intervalo para o qual o próprio livro define um nome. Os intervalos nomeados são listados juntamente com as folhas de trabalho no seletor (veja Localizar folhas no ficheiro selecionado abaixo), pelo que se seleciona um da mesma forma que uma folha.
- Intervalo de células: Lê um intervalo retangular específico que não corresponde a uma folha de trabalho nem a um nome do livro. Escolha a folha onde o intervalo se encontra e depois introduza o intervalo a seguir a um
$. São suportadas três formas:Sheet1$A1:J100— um intervalo limitado.Sheet1$A1:J— sem limite final; lê a partir deA1até à última linha das colunas A a J.Sheet1$A:BJ— colunas inteiras; lê as colunas A a BJ da folha, a forma que o Alteryx escreve para uma entrada Excel.
Os intervalos nomeados são lidos em livros XLSX e XLSM. Os livros XLSB, XLS e ODS oferecem folhas de trabalho e intervalos de células.
Folhas de trabalho a importar
Seção intitulada “Folhas de trabalho a importar”Como os livros podem conter muitas folhas de trabalho com dados diferentes, é possível selecionar quais as folhas de trabalho a importar no processo de importação atual. As opções são:
- Todas as folhas de trabalho
- Folhas de trabalho correspondentes à pesquisa
- Folhas de trabalho selecionadas
Utilizar a pesquisa de folhas de trabalho
Seção intitulada “Utilizar a pesquisa de folhas de trabalho”A funcionalidade de pesquisa de folhas de trabalho permite incluir as folhas de trabalho que correspondem aos critérios de pesquisa. Os critérios de pesquisa permitem:
- Começa com: O nome da folha de trabalho começa com o texto pesquisado
- Contém: O nome da folha de trabalho contém o texto pesquisado
- Termina com: O nome da folha de trabalho termina com o texto pesquisado
Localizar folhas no ficheiro selecionado
Seção intitulada “Localizar folhas no ficheiro selecionado”O botão de localizar folhas abre o ficheiro Excel e lista as folhas de trabalho e os intervalos nomeados disponíveis na tabela. Marque as caixas de seleção na tabela para as folhas de trabalho e/ou intervalos nomeados a incluir na importação. Um livro dentro de um ficheiro .zip também funciona: as respetivas folhas de trabalho e intervalos nomeados são listados.
Mapeamento de folhas
Seção intitulada “Mapeamento de folhas”Um Mapeamento de folhas lê um conjunto diferente de folhas de trabalho de cada livro. Escolha uma Tabela de mapeamento de folhas com uma linha por folha de trabalho a ler, com a respetiva Coluna do livro a conter o caminho ou o nome do ficheiro do livro e a respetiva Coluna da folha a conter a folha de trabalho. Quando um mapeamento de folhas está definido, só são lidos os livros que a tabela indica, cada um para as folhas de trabalho que lista, pela ordem das linhas da tabela. Uma folha de trabalho em branco lê a primeira folha de trabalho do livro.
Ficheiros sem a folha de trabalho selecionada
Seção intitulada “Ficheiros sem a folha de trabalho selecionada”Quando uma importação lê vários ficheiros, um ficheiro que não contenha a folha de trabalho selecionada, ou que não tenha nenhuma folha de trabalho correspondente à sua pesquisa de folhas, é ignorado. O passo termina com um aviso que indica o ficheiro ignorado e lista as folhas de trabalho que ele tem, e os outros ficheiros continuam a ser importados. Se todos os ficheiros forem ignorados, o passo ainda assim é bem-sucedido, a tabela de destino fica vazia e um aviso explica porquê. Os nomes das folhas de trabalho têm de corresponder exatamente, incluindo maiúsculas e minúsculas.
Um ficheiro ignorado permanece na pasta, mesmo com Delete Files After Import ativado, e emite novamente o aviso em cada execução até o remover ou corrigir. Os avisos de uma importação de vários ficheiros aparecem no passo: até cinco são listados, mais uma contagem dos restantes.
Seleção de dados da tabela
Seção intitulada “Seleção de dados da tabela”Configuração do Data Mapper
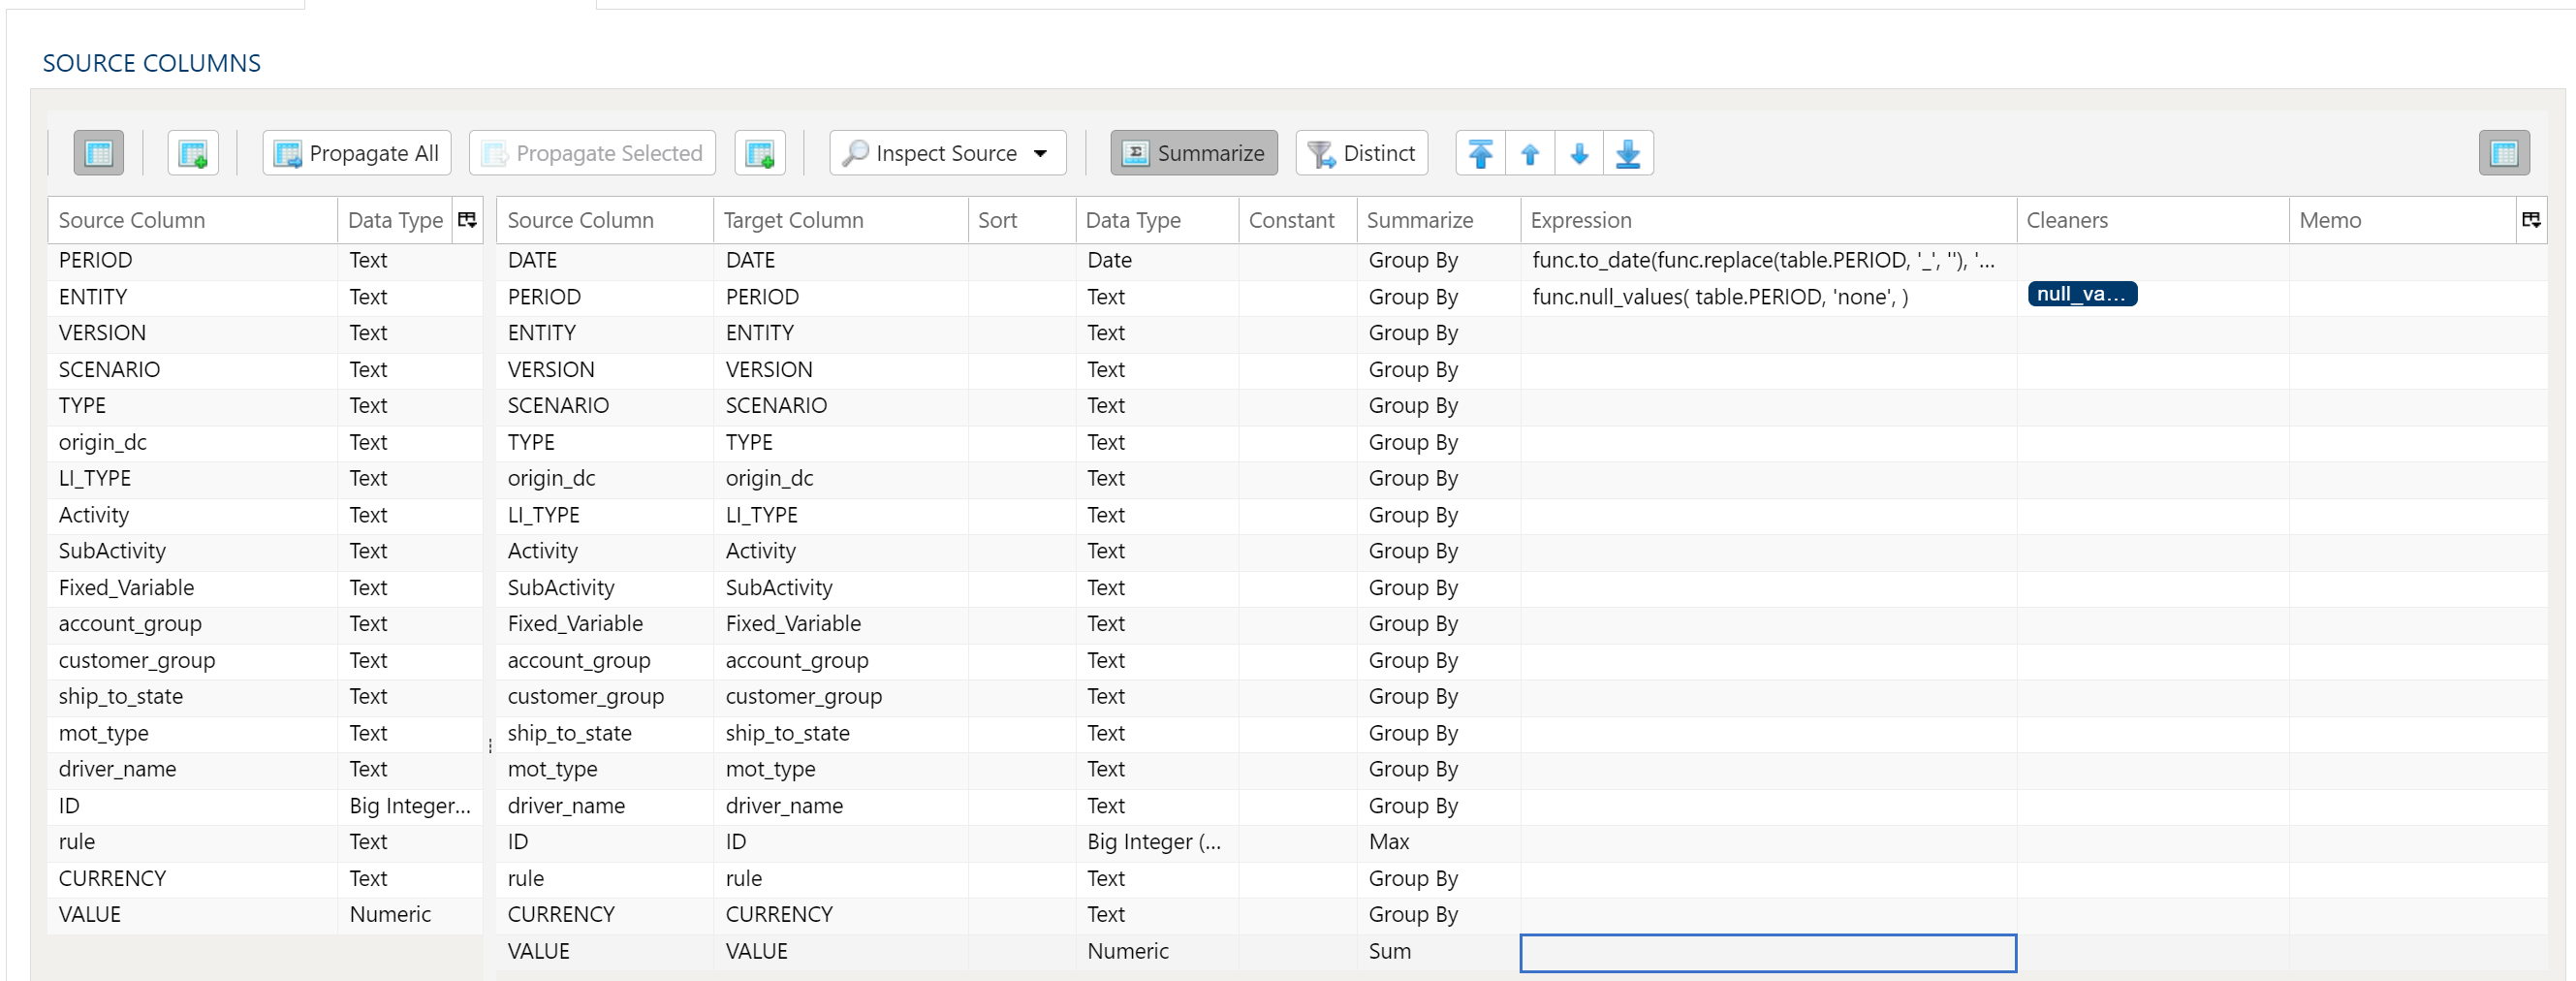
O Data Mapper serve para mapear colunas dos dados de origem para a tabela de dados de destino.
Inspeção e preenchimento do mapeador
Utilizar o botão de menu Inspecionar origem oferece formas adicionais de mapear colunas da origem para o destino:
- Preencher ambas as tabelas de mapeamento: propaga todos os valores da tabela de dados de origem para a tabela de dados de destino. É o comportamento predefinido.
- Preencher apenas a tabela de mapeamento de origem: mapeia apenas todos os valores da tabela de dados de origem. É útil ao modificar um fluxo de trabalho existente cuja estrutura de colunas de origem mudou.
- Preencher apenas a tabela de mapeamento de destino: propaga todos os valores apenas para a tabela de dados de destino.
Se as opções de colunas de origem e de destino não forem suficientes, podem adicionar-se outras colunas à tabela de dados de destino de várias formas:
- Propagar tudo insere todas as colunas de origem na tabela de dados de destino, quer já existam ou não.
- Propagar selecionadas insere apenas as colunas de origem selecionadas.
- Clique com o botão direito do rato no lado do destino e selecione Inserir linha para inserir uma linha imediatamente acima da linha atualmente selecionada.
- Clique com o botão direito do rato no lado do destino e selecione Acrescentar linha para inserir uma linha no fim (extremo direito) da tabela de dados de destino.
Eliminar colunas
Para eliminar colunas da tabela de dados de destino, selecione as colunas pretendidas, clique com o botão direito do rato e selecione Eliminar.
Colunas de origem que já não constam da lista
Uma linha de destino pode indicar uma Coluna de origem que a tabela de dados de origem já não lista, por exemplo depois de a origem ter sido inspecionada novamente. O passo nunca remove essa linha por si. Em vez disso, o nome da coluna é apresentado a vermelho, atrás de um sinal de aviso ⚠, e, ao passar o cursor por cima, é indicado que a coluna não consta das colunas de origem. Num passo com várias tabelas, como uma união, cada tabela é verificada em relação às suas próprias colunas de origem.
Uma linha com uma Constante, uma Expressão ou um resumo Contagem (incluindo nulos) nunca é sinalizada, porque o passo não lê a respetiva coluna de origem. Nada é sinalizado enquanto a tabela de dados de origem não listar colunas, por exemplo antes de a origem ser inspecionada pela primeira vez.
Ao guardar um passo que ainda tem linhas sinalizadas, uma caixa de diálogo Colunas obsoletas encontradas lista-as sob o separador ou a tabela em que se encontram e oferece três opções:
- Remover todas e guardar: remove as linhas sinalizadas e depois guarda.
- Guardar mesmo assim: guarda o passo tal como está.
- Cancelar: volta ao passo sem guardar.
Para manter uma linha e eliminar o respetivo aviso, adicione a coluna de volta à tabela de dados de origem ou escolha uma coluna que a tabela de dados de origem liste.
Tipo de dados da coluna
Cada coluna de destino tem um Tipo. Uma coluna propagada da origem mantém o tipo da coluna de origem; uma linha que adicione manualmente começa como Texto, e define o Tipo para indicar o que a coluna deve realmente ser. Uma coluna que pretenda somar ou ordenar precisa do respetivo tipo numérico ou de data, porque o texto é ordenado e somado como texto.
Um passo guardado com uma coluna sem qualquer tipo é, mesmo assim, executado. O tipo é determinado quando o passo é iniciado, a partir da coluna de origem que essa coluna lê. Quando não há nada de onde o ler, é tratado como texto: as colunas de um passo Extrair SQL vêm da consulta que escreveu e não de uma origem mapeada e, quando várias origens têm o mesmo nome de coluna com tipos discordantes, é utilizado texto em vez de adivinhar um deles, porque um palpite errado produz uma conversão que o armazém pode rejeitar, e tudo se converte em texto.
Definir o Tipo manualmente continua a ser a forma de indicar o que uma coluna deve ser. Deixá-lo por definir significa aceitar o que a coluna de origem for.
Alterar a ordem das colunas
Para reordenar as colunas na tabela de dados de destino, selecione as colunas pretendidas. Pode utilizar:
- Setas de movimento em massa: selecione a opção de movimento pretendida nas setas no canto superior direito
- Menu de contexto: clique com o botão direito do rato e selecione Mover para o início, Mover para cima, Mover para baixo ou Mover para o fim.
Reduzir o resultado apenas a registos distintos
Para devolver apenas opções distintas, selecione a opção de menu Distinto. Isto apresenta um conjunto de caixas de verificação para cada coluna da origem. Basta marcar a caixa junto da coluna correspondente para devolver apenas resultados distintos.
Consoante a situação, pode ser preferível considerar a utilização da sumarização.
O processo de distinção mantém o primeiro registo único encontrado e descarta os restantes. Pode querer aplicar uma ordenação aos dados, se for importante para a consistência entre execuções.
Agregação e agrupamento
Para agregar resultados, selecione a opção de menu Resumir. Isto apresenta um conjunto de caixas de seleção para cada coluna da tabela de dados de destino. Escolha um método de sumarização adequado para cada coluna.
Quando Inspecionar origem preenche as colunas, uma coluna numérica começa como Agrupar por em vez de Soma se o nome se assemelhar a um identificador, como id, customer_id, Order No ou CustomerKey, se a respetiva tabela a definir como chave ou se a junção a utilizar como chave.
- Agrupar por
- Soma
- Mínimo
- Máximo
- Primeiro
- Último
- Contagem
- Contagem (incluindo nulos)
- Média
- Desvio padrão
- Desvio padrão da amostra
- Desvio padrão da população
- Variância
- Variância da amostra
- Variância da população
- Avançado sem agrupar por
Para uma utilização avançada do Data Mapper, como expressões, limpeza e constantes, consulte Utilização avançada do Data Mapper
Uma coluna de origem em várias colunas de destino
Seção intitulada “Uma coluna de origem em várias colunas de destino”Uma única coluna de origem pode alimentar mais de uma coluna de destino. Mapeie a mesma coluna de origem em duas ou mais linhas de destino, cada uma com o seu próprio nome, tipo ou expressão. Por exemplo, leia Amount uma vez como coluna de texto e outra como coluna numérica, ou construa duas colunas de texto a partir da mesma célula. Uma coluna de destino numérica já não converte a origem antes de a sua expressão ser executada, pelo que uma expressão pode primeiro limpar um valor como 1,500.
Isto funciona da mesma forma em todas as importações de ficheiros que utilizam o Data Mapper, exceto Importar CSV: Importar Excel, largura fixa, JSON, Avro, Parquet, DBF, XML e YXDB.
Filtros de dados
Seção intitulada “Filtros de dados”
Para permitir a máxima flexibilidade, existem filtros de dados disponíveis nos dados de origem e nos dados de destino. Em conjuntos de dados maiores, pode ser especialmente vantajoso filtrar linhas na origem, para que as restantes operações sejam executadas sobre um conjunto de dados mais pequeno.
Selecionar subconjunto de dados
Este tipo de filtro permite filtrar os dados de origem recebidos com base nas condições especificadas.
Aplicar filtro secundário aos dados de resultado
Este tipo de filtro permite aplicar um filtro aos dados de resultado depois de transformados, com base nas condições especificadas. A possibilidade de aplicar um filtro ao resultado transformado permite exclusões com base nos resultados de cálculos complexos, sumarizações ou funções de janela.
Divisão final da tabela de dados (limite)
A capacidade de divisão de linhas permite limitar as linhas do conjunto de resultados com base num intervalo e num ponto de partida.
Sintaxe de filtros
A sintaxe de filtros utiliza o Python SQLAlchemy, que é a mesma sintaxe das outras expressões.
Consulte exemplos e funções de expressão na área Expressões.