Allocation By Assignment Dimension
Descrição
Seção intitulada “Descrição”Aloca valores de uma tabela de origem a destinos com base numa dimensão de atribuição e numa tabela de dados de driver. Este é o passo de alocação mais flexível — utilize-o para distribuições baseadas em indutores, em que o destino de cada linha de origem é determinado por uma hierarquia e os valores dos indutores determinam quanto vai para cada lado.
Padrões comuns: distribuir os totais dos centros de custo pelas linhas de produto com base nas horas de atividade; distribuir os custos gerais de TI pelas unidades de negócio com base no número de colaboradores; alocar os custos de serviços partilhados com uma ponderação personalizada.
Definições da tabela de dados
Seção intitulada “Definições da tabela de dados”Hierarquia da dimensão de atribuição
Seção intitulada “Hierarquia da dimensão de atribuição”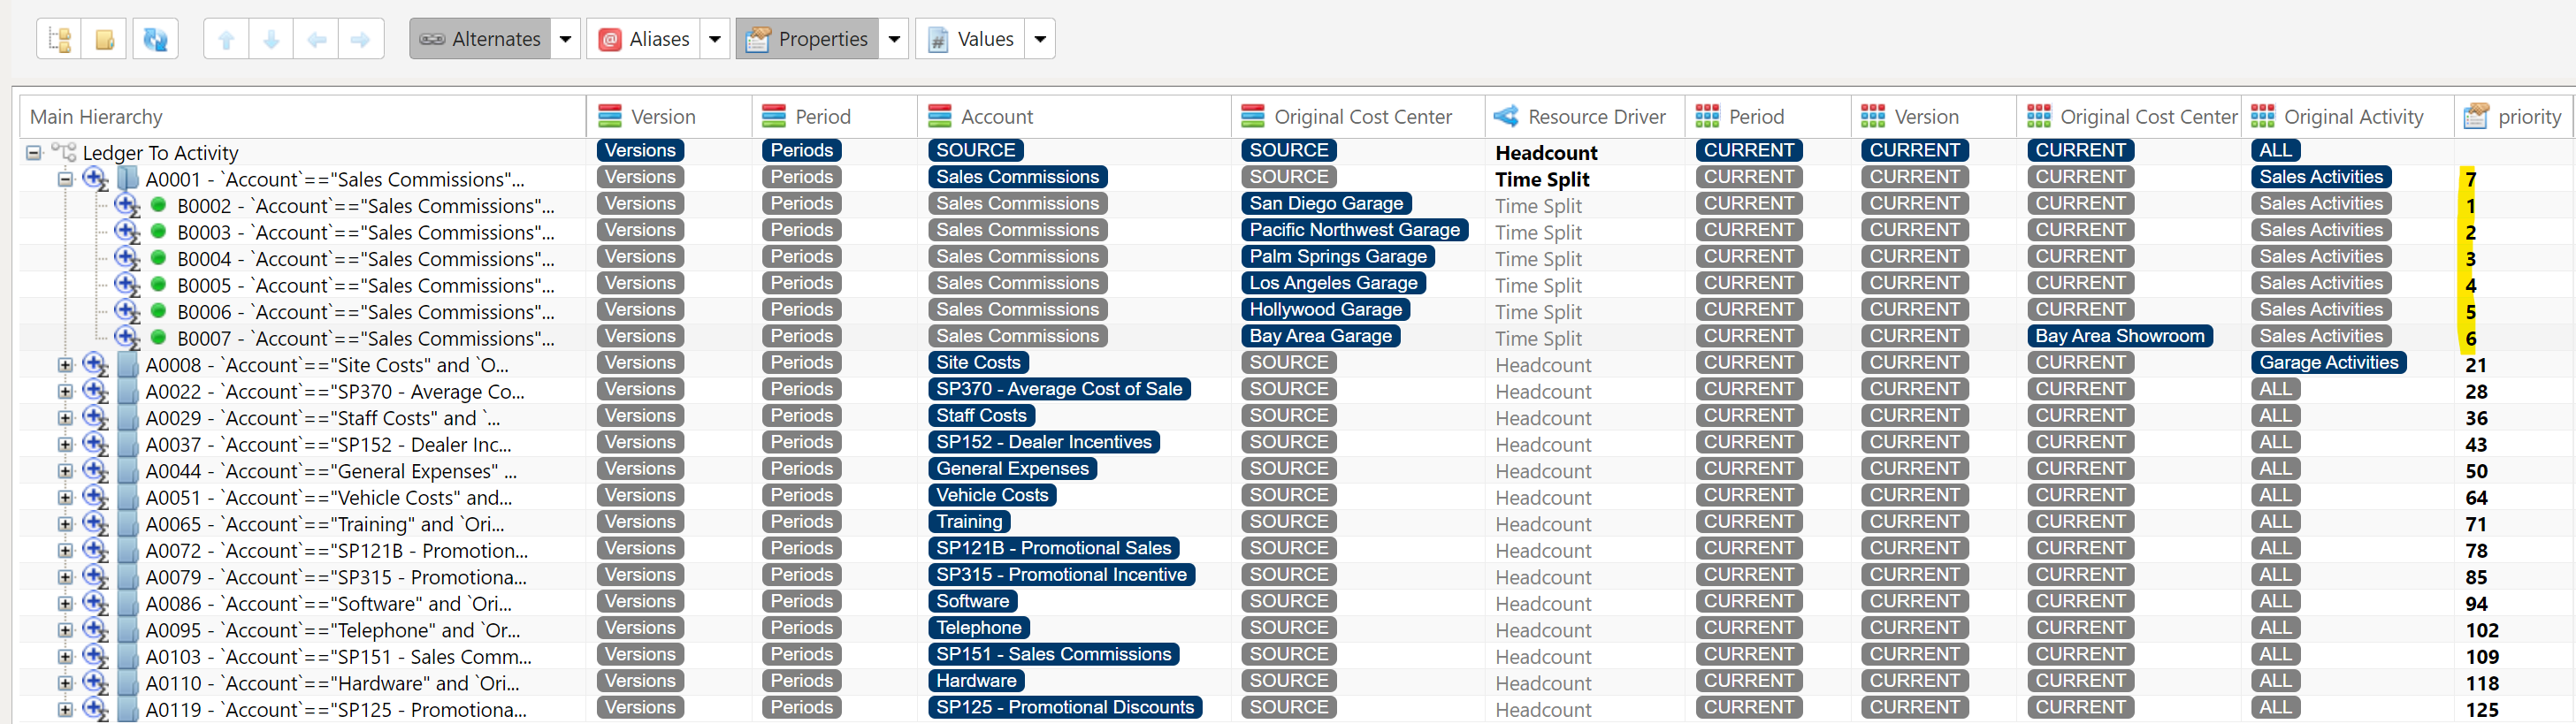
A Hierarquia da dimensão de atribuição permite ao utilizador apontar, clicar e filtrar qualquer uma das tabelas, ou ambas, Tabela de valores a alocar e Tabela de dados de driver, para criar alocações direcionadas. A Hierarquia da dimensão de atribuição é criada combinando dimensões que referenciam a Tabela de valores a alocar e a Tabela de dados de driver.
Criar uma hierarquia da dimensão de atribuição
Seção intitulada “Criar uma hierarquia da dimensão de atribuição”Para criar a Hierarquia da dimensão de atribuição, tem primeiro de criar as dimensões que pretende utilizar como filtros da Tabela de valores a alocar e da Tabela de dados de driver. As ligações abaixo guiam-no na criação dessas dimensões.
Criar a hierarquia principal
Seção intitulada “Criar a hierarquia principal”Depois de criadas as dimensões da Tabela de valores a alocar e da Tabela de dados de driver, o passo seguinte é decidir qual das dimensões da Tabela de valores a alocar servirá de Hierarquia principal para a Hierarquia da dimensão de atribuição.
Copie esta dimensão acedendo ao separador Dimensões no PlaidCloud, clicando na dimensão e selecionando Ações e Copiar dimensão. Ao copiar a dimensão, será apresentada uma janela a pedir que introduza um nome para a dimensão copiada.
Adicionar dimensões à hierarquia de atribuição
Seção intitulada “Adicionar dimensões à hierarquia de atribuição”Abra a Dimensão de atribuição recém-criada, clique na seta para baixo junto a Propriedades e selecione Nova propriedade.
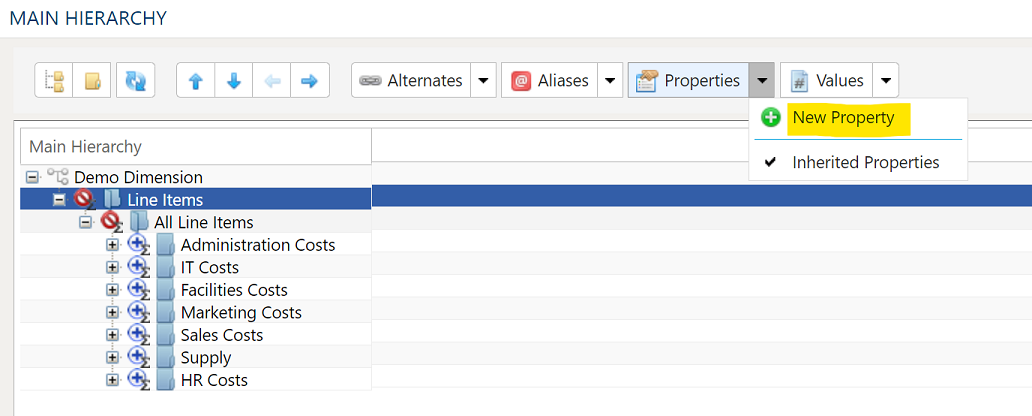
Isto abre a caixa de diálogo Configuração da propriedade:
Configuração da propriedade
Seção intitulada “Configuração da propriedade”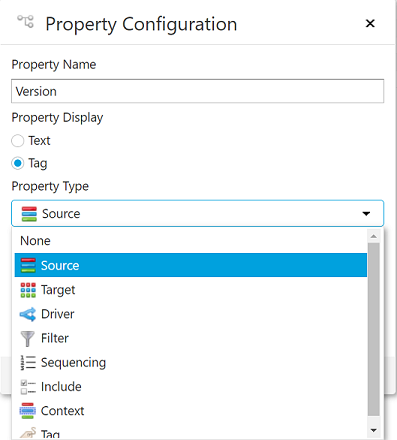
- Nome da propriedade - Normalmente é o nome da dimensão que está a ser adicionada à hierarquia de atribuição.
- Apresentação da propriedade - Deve ser definida como “Tag”.
- Tipo de propriedade - Esta propriedade indica ao passo de alocação a que tabela, Tabela de valores a alocar ou Tabela de dados de driver, esta dimensão está associada.
- Origem - É utilizada em conjunto com a Tabela de valores a alocar.
- Destino - É utilizado em conjunto com a Tabela de dados de driver.
- Indutor - É utilizado para filtrar a Tabela de dados de driver pelo indutor específico selecionado.
- Contexto - Quando a Tabela de valores a alocar e a Tabela de dados de driver contêm a mesma dimensão, o contexto pode ser utilizado para especificar como as dimensões se devem relacionar entre si. O contexto é frequentemente utilizado quando ambas as tabelas contêm Centros de lucro / custo ou Geografia.
- Deixado em branco - Um nó sem contexto próprio assume o contexto do antecessor mais próximo que defina um, pelo que uma célula em branco significa herdar, não sem contexto. Só quando nenhum antecessor define um é que a Tabela de dados de driver volta a ser filtrada pela definição da própria dimensão de destino.
- Atual - Funciona como passagem direta e filtra a Tabela de dados de driver com base nas definições da dimensão de destino. Um exemplo: se o Contexto se basear na dimensão Centro de lucro e a dimensão de destino Centro de lucro estiver definida como Todos, os dados do indutor são filtrados por todos os Centros de lucro. Por ser um valor guardado, também interrompe a herança descrita acima, pelo que Atual é a forma de um nó dizer “sem contexto aqui” quando um antecessor define um — limpar a célula faria com que o nó recebesse o contexto do antecessor.
- Superior - Quando selecionado, o superior do Centro de lucro na Tabela de valores a alocar é utilizado para filtrar os valores do indutor na Tabela de dados de driver. É útil quando, por vezes, os valores do indutor não estão disponíveis para um Centro de lucro específico, mas existem frequentemente ao nível do superior.
- Todos - Quando selecionado, o Centro de lucro na Tabela de valores a alocar não filtra os valores do indutor na Tabela de dados de driver; são utilizados os valores do indutor de todos os Centros de lucro.
- Não atribuído - Em vez das linhas de indutor que a dimensão de destino selecionaria, só são utilizadas aquelas cujo Centro de lucro não tem qualquer valor ou tem o valor
UNASSIGNED(com qualquer capitalização), e o Centro de lucro não divide o resultado. Utilize-o para uma regra que distribui custos que nenhum Centro de lucro possui. Aplica-se apenas à regra que o define — outra regra que deixe a mesma coluna em branco não é afetada.
- Tipo de editor - Este menu pendente deve ser definido como Select Dimension.
Depois de selecionadas as propriedades adequadas para a dimensão que está a ser adicionada à hierarquia de atribuição, selecione “Editar configuração”.
Configuração da dimensão
Seção intitulada “Configuração da dimensão”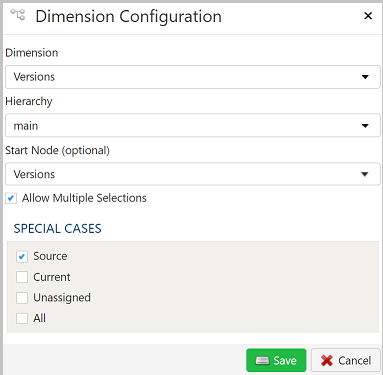
- Dimensão - Utilize o menu pendente para selecionar a dimensão.
- Hierarquia - Se a dimensão selecionada tiver hierarquias alternativas, estas aparecem e podem ser selecionadas aqui, tal como a hierarquia principal.
- Start Node - Se não pretender que a dimensão seja apresentada a partir do nó de topo, pode selecionar qualquer nó da hierarquia como o nó a partir do qual a dimensão será apresentada.
- Permitir seleções múltiplas - Se estiver selecionada, o utilizador poderá selecionar vários nós na hierarquia.
- Casos especiais - Quando selecionados, os casos especiais ficam disponíveis para seleção no menu pendente da dimensão. São normalmente utilizados em dimensões de Destino.
- Origem - Quando uma dimensão é definida como Origem, a alocação ignora esta dimensão ao filtrar a Tabela de dados de driver, mas os resultados alocados incluem os valores da dimensão.
- Atual - Pode ser utilizado quando uma dimensão é partilhada entre Origem e Destino. Quando a dimensão de Destino é definida como Atual, a Tabela de dados de driver é filtrada pelo valor atual da dimensão de Origem à medida que a alocação é executada. Um exemplo seria haver vários períodos na Tabela de valores a alocar e na Tabela de dados de driver, mas pretender que a alocação ocorra dentro dos períodos e não entre eles. É também comum utilizar Atual em Unidades de negócio, Centros de custo e Geografias.
- Não atribuído - Quando uma dimensão é definida como Não atribuído, a alocação ignora esta dimensão ao filtrar a Tabela de dados de driver e o resultado da alocação para esta dimensão é um valor Nulo.
- Todos - Quando uma dimensão é definida como TODOS, a alocação utiliza todos os valores da dimensão.
A Tabela de valores a alocar, a Tabela de dados de driver e a Tabela de resultados da alocação podem ser selecionadas de forma dinâmica ou estática.
Seleção dinâmica de tabelas
Seção intitulada “Seleção dinâmica de tabelas”A opção de tabela dinâmica permite especificar uma tabela através de texto e variáveis. Isto é útil em fluxos de trabalho orientados por variáveis, em que as referências a tabelas ou vistas são relativas às variáveis especificadas.
Um exemplo que utiliza a variável current_month para apontar dinamicamente para uma tabela:
legal_entity/inputs/{current_month}/ledger_valuesSeleção estática de tabelas
Seção intitulada “Seleção estática de tabelas”Quando pretende uma tabela específica como origem, deixe a caixa Dynamic desmarcada e selecione a tabela de origem no menu pendente.
O Explorador de tabelas está sempre disponível em qualquer seleção de tabela. Clique no botão do Explorador de tabelas à direita da seleção de tabela e será aberta uma janela do Explorador de tabelas.
Tabela de valores a alocar
Seção intitulada “Tabela de valores a alocar”Esta é a tabela que contém os valores a alocar. Normalmente, são valores de custo ou de receita.
Tabela de dados de driver
Seção intitulada “Tabela de dados de driver”A tabela de dados de driver contém os valores que o passo de alocação utilizará para alocar custos.
Exemplos:
- Para uma cadeia de abastecimento atribuir custos a clientes, pode utilizar dados de entregas com o número de entregas ou o peso das entregas como indutor.
- Para um centro de apoio de TI atribuir os seus custos aos departamentos que apoia, os dados do indutor podem ser o número de pedidos por centro de custo.
Driver Data Sign Rule
Seção intitulada “Driver Data Sign Rule”Os dados de driver podem conter valores positivos e negativos. A Driver Data Sign Rule permite-lhe decidir como os sinais em conflito serão tratados.
- Error on conficting signs - O passo de alocação produz um erro e pára se forem encontrados sinais em conflito.
- Proceed with warning on conflicting signs - O passo de alocação utiliza valores de indutor negativos e positivos, mas apresenta um aviso.
- Use only positive driver values - O passo de alocação utiliza apenas valores de indutor positivos e ignora os negativos.
- Use only negative driver values - O passo de alocação utiliza apenas valores de indutor negativos e ignora os positivos.
- Use absolute values of driver data - O passo de alocação utiliza os valores absolutos dos dados de driver.
Corresponder registos a mais do que uma regra
Seção intitulada “Corresponder registos a mais do que uma regra”Por predefinição, um registo assume apenas a primeira regra com que corresponde. Desmarque Corresponder registos a apenas uma regra e o registo assume todas as regras com que corresponde: o registo aparece uma vez por cada uma delas, e um registo que não corresponda a nenhuma regra é excluído.
As regras também podem ser repartidas por iterações com uma propriedade da dimensão de atribuição do tipo Sequenciação, cujo valor é a iteração em que cada regra é executada. Um passo com Corresponder registos a apenas uma regra desmarcado não pode fazer ambas as coisas: se as regras que são executadas estiverem em mais do que uma iteração, o passo pára com Cannot apply rules when there are multiple iterations and records can match more than one rule. Marque a opção ou execute cada iteração como um passo separado.
Tabelas intermédias
Seção intitulada “Tabelas intermédias”As Tabelas intermédias são criadas sempre que um passo de alocação é executado e fornecem um resumo do processamento da alocação. As Tabelas intermédias dão uma perspetiva de como o processo de alocação está a decorrer e são utilizadas para diagnosticar resultados inesperados.
- Caminhos - Mostra o número de caminhos de alocação únicos resumidos a partir da hierarquia de atribuição.
- Mapeamento - Mostra como cada linha da Tabela de valores a alocar é mapeada para os destinos da alocação.
- Resumo - Mostra cada regra, resultante da hierarquia de atribuição, e quantos dos registos da Tabela de valores a alocar correspondem a ela.
Com Corresponder registos a apenas uma regra marcado, um registo que nenhuma regra reconhece tem colunas de regra vazias na tabela Mapeamento e é contado na linha de Resumo que não nomeia nenhuma regra. Um valor que uma regra deixa em branco também fica vazio. Vazio significa nulo, nunca uma cadeia vazia, e as três tabelas têm as mesmas colunas e tipos, esteja ou não marcada a opção Aplicar regras com SQL, não com Pandas.
Tabela de resultados da alocação
Seção intitulada “Tabela de resultados da alocação”Acrescentar resultados à tabela de destino
Seção intitulada “Acrescentar resultados à tabela de destino”Se esta caixa estiver marcada, os resultados da alocação são acrescentados à tabela de resultados da alocação. Se esta caixa não estiver marcada, a tabela de resultados da alocação é substituída sempre que o passo de alocação é executado.
Colunas separadas para os resultados alocados
Seção intitulada “Colunas separadas para os resultados alocados”Se esta caixa estiver marcada, a tabela de resultados mostra o montante de cada registo alocado, bem como o montante realmente alocado a cada registo de indutor.
Mudar o nome dos nós da dimensão
Seção intitulada “Mudar o nome dos nós da dimensão”Se esta caixa estiver marcada, quando o passo de alocação é executado, muda o nome do nó da dimensão na dimensão de atribuição.
Opções avançadas
Seção intitulada “Opções avançadas”Número de threads
Seção intitulada “Número de threads”Define o número de operações simultâneas que o passo de alocação utilizará.
Tamanho do bloco
Seção intitulada “Tamanho do bloco”Define o número de caminhos de alocação dentro de uma thread.
Mapa de origem da alocação
Seção intitulada “Mapa de origem da alocação”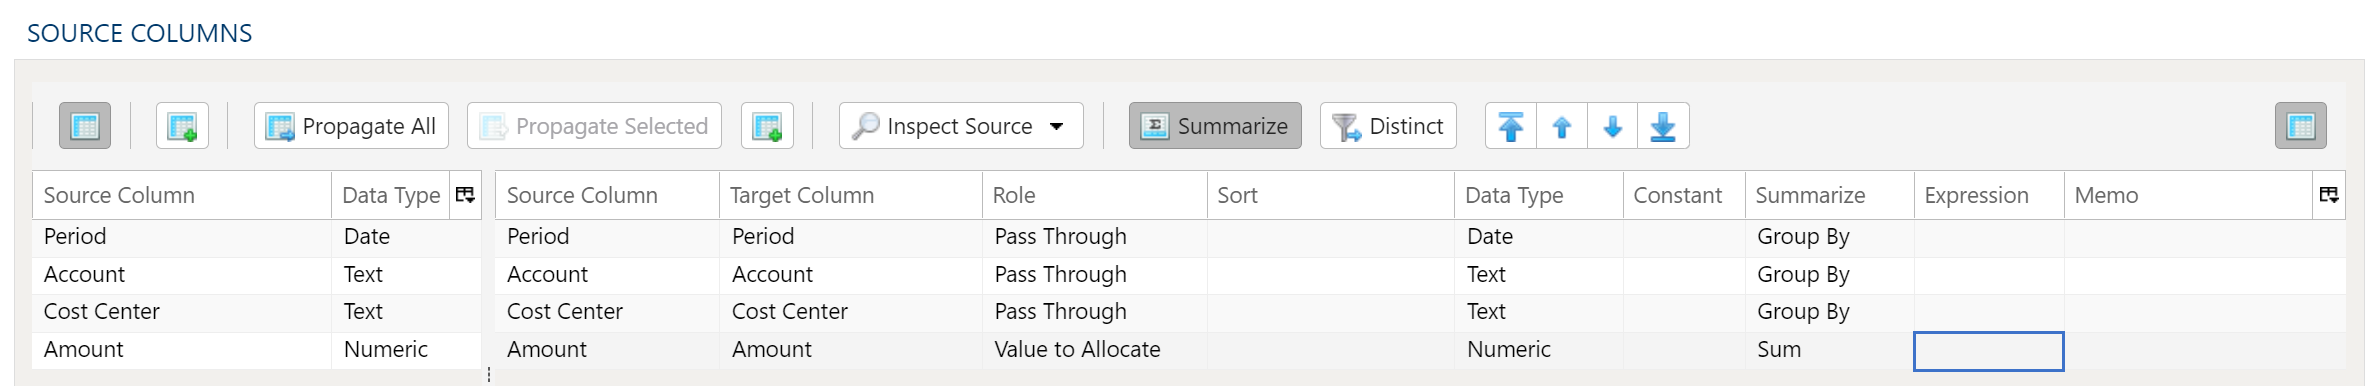
O Mapa de origem da alocação serve para mapear as colunas da Tabela de valores a alocar que serão utilizadas no passo de alocação.
Inspeção e preenchimento do mapeador
O botão de menu Inspecionar origem oferece formas adicionais de mapear colunas da origem para o destino:
- Preencher ambas as tabelas de mapeamento: propaga todos os valores da tabela de dados de origem para a tabela de dados de destino. Este é o comportamento predefinido.
- Preencher apenas a tabela de mapeamento de origem: mapeia apenas todos os valores da tabela de dados de origem. É útil ao modificar um fluxo de trabalho existente quando a estrutura das colunas de origem mudou.
- Preencher apenas a tabela de mapeamento de destino: propaga todos os valores apenas para a tabela de dados de destino.
Se as opções de colunas de origem e de destino não forem suficientes, é possível adicionar outras colunas à tabela de dados de destino de várias formas:
- Propagar tudo insere todas as colunas de origem na tabela de dados de destino, quer já existam ou não.
- Propagar selecionadas insere apenas as colunas de origem selecionadas.
- Clique com o botão direito do rato no lado do destino e selecione Inserir linha para inserir uma linha imediatamente acima da linha selecionada.
- Clique com o botão direito do rato no lado do destino e selecione Acrescentar linha para inserir uma linha no fim (extrema direita) da tabela de dados de destino.
Função
A cada coluna do mapeador de dados tem de ser atribuída uma função:
- Pass Thought - Estas colunas aparecerão na tabela de resultados da alocação.
- Valor a alocar - Esta é a coluna que contém os valores a alocar.
Eliminar colunas
Para eliminar colunas da tabela de dados de destino, selecione a(s) coluna(s) pretendida(s), clique com o botão direito do rato e selecione Eliminar.
Alterar a ordem das colunas
Para reorganizar as colunas da tabela de dados de destino, selecione a(s) coluna(s) pretendida(s). Pode utilizar:
- Setas de movimentação em massa: selecione a opção de movimentação pretendida nas setas no canto superior direito
- Menu de contexto: clique com o botão direito do rato e selecione Mover para o início, Mover para cima, Mover para baixo ou Mover para o fim.
Reduzir o resultado apenas a registos distintos
Para devolver apenas opções distintas, selecione a opção de menu Distinto. Isto alterna um conjunto de caixas de seleção para cada coluna da origem. Basta assinalar a caixa junto da coluna correspondente para devolver apenas resultados distintos.
Consoante a situação, pode ser preferível considerar a utilização de sumarização.
O processo de distinção mantém o primeiro registo único encontrado e descarta os restantes. Pode ser conveniente aplicar uma ordenação aos dados se a consistência entre execuções for importante.
Agregação e agrupamento
Para agregar resultados, selecione a opção de menu Resumir. Isto alterna um conjunto de caixas de seleção para cada coluna da tabela de dados de destino. Escolha um método de sumarização adequado para cada coluna.
- Agrupar por
- Soma
- Mínimo
- Máximo
- Primeiro
- Último
- Contagem
- Contagem (incluindo nulos)
- Média
- Desvio padrão
- Desvio padrão da amostra
- Desvio padrão da população
- Variância
- Variância da amostra
- Variância da população
- Avançado sem Agrupar por
Para uma utilização avançada do mapeador de dados, como expressões, limpeza e constantes, consulte Utilização avançada do Data Mapper
Filtros de origem da alocação
Seção intitulada “Filtros de origem da alocação”
Para permitir a máxima flexibilidade, existem filtros de dados disponíveis nos dados de origem e nos dados de destino. Em conjuntos de dados maiores, pode ser especialmente vantajoso filtrar linhas na origem, para que as restantes operações sejam executadas sobre um conjunto de dados mais pequeno.
Selecionar subconjunto de dados
Este tipo de filtro permite filtrar os dados de origem recebidos com base nas condições especificadas.
Aplicar filtro secundário aos dados de resultado
Este tipo de filtro permite aplicar um filtro aos dados de resultado depois de transformados, com base nas condições especificadas. A possibilidade de aplicar um filtro ao resultado transformado permite exclusões com base nos resultados de cálculos complexos, sumarizações ou funções de janela.
Divisão final da tabela de dados (limite)
A capacidade de divisão de linhas permite limitar as linhas do conjunto de resultados com base num intervalo e num ponto de partida.
Sintaxe de filtros
A sintaxe de filtros utiliza o Python SQLAlchemy, que é a mesma sintaxe das outras expressões.
Consulte exemplos e funções de expressão na área Expressões.
Mapa de dados de driver
Seção intitulada “Mapa de dados de driver”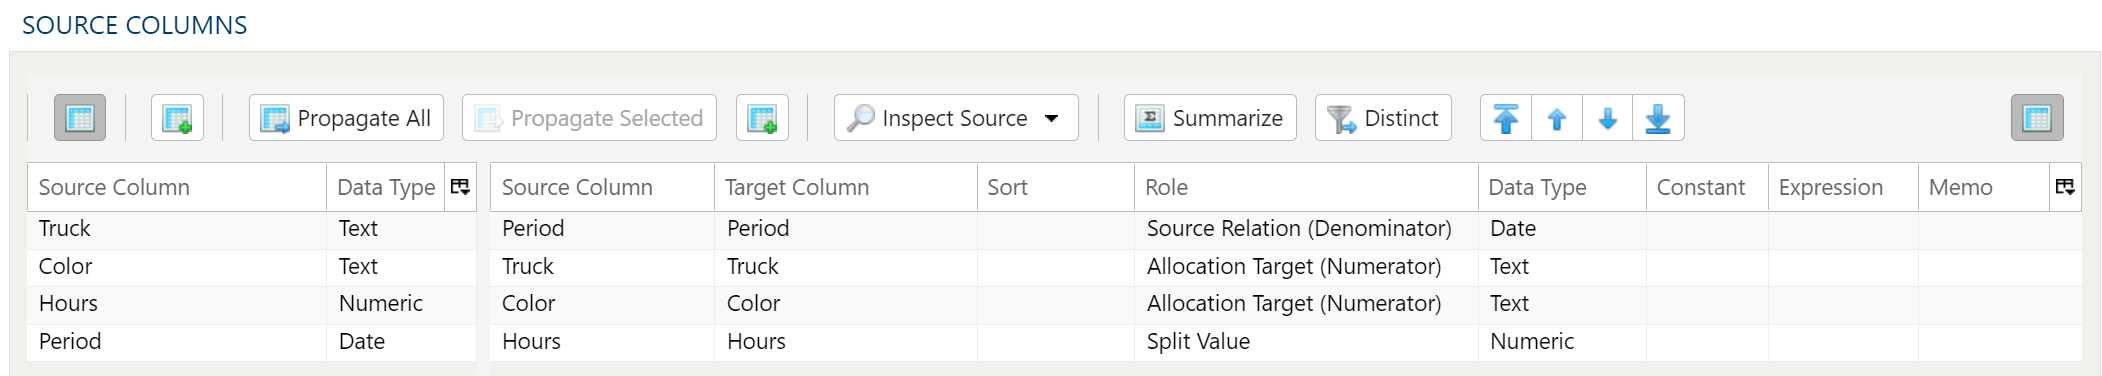
O Mapa de dados de driver da alocação serve para mapear as colunas da Tabela de dados de driver que serão utilizadas no passo de alocação.
Inspeção e preenchimento do mapeador
O botão de menu Inspecionar origem oferece formas adicionais de mapear colunas da origem para o destino:
- Preencher ambas as tabelas de mapeamento: propaga todos os valores da tabela de dados de origem para a tabela de dados de destino. Este é o comportamento predefinido.
- Preencher apenas a tabela de mapeamento de origem: mapeia apenas todos os valores da tabela de dados de origem. É útil ao modificar um fluxo de trabalho existente quando a estrutura das colunas de origem mudou.
- Preencher apenas a tabela de mapeamento de destino: propaga todos os valores apenas para a tabela de dados de destino.
Se as opções de colunas de origem e de destino não forem suficientes, é possível adicionar outras colunas à tabela de dados de destino de várias formas:
- Propagar tudo insere todas as colunas de origem na tabela de dados de destino, quer já existam ou não.
- Propagar selecionadas insere apenas as colunas de origem selecionadas.
- Clique com o botão direito do rato no lado do destino e selecione Inserir linha para inserir uma linha imediatamente acima da linha selecionada.
- Clique com o botão direito do rato no lado do destino e selecione Acrescentar linha para inserir uma linha no fim (extrema direita) da tabela de dados de destino.
Função
A cada coluna do mapeador de dados tem de ser atribuída uma função:
- Source Relation - Estas colunas têm colunas correspondentes na Tabela de valores a alocar.
- Allocation Target - As colunas serão o destino do passo de alocação e aparecerão na Tabela de resultados da alocação.
- Valor de divisão - Esta coluna contém os valores que serão utilizados para alocar os valores da Tabela de valores a alocar.
Eliminar colunas
Para eliminar colunas da tabela de dados de destino, selecione a(s) coluna(s) pretendida(s), clique com o botão direito do rato e selecione Eliminar.
Alterar a ordem das colunas
Para reorganizar as colunas da tabela de dados de destino, selecione a(s) coluna(s) pretendida(s). Pode utilizar:
- Setas de movimentação em massa: selecione a opção de movimentação pretendida nas setas no canto superior direito
- Menu de contexto: clique com o botão direito do rato e selecione Mover para o início, Mover para cima, Mover para baixo ou Mover para o fim.
Reduzir o resultado apenas a registos distintos
Para devolver apenas opções distintas, selecione a opção de menu Distinto. Isto alterna um conjunto de caixas de seleção para cada coluna da origem. Basta assinalar a caixa junto da coluna correspondente para devolver apenas resultados distintos.
Consoante a situação, pode ser preferível considerar a utilização de sumarização.
O processo de distinção mantém o primeiro registo único encontrado e descarta os restantes. Pode ser conveniente aplicar uma ordenação aos dados se a consistência entre execuções for importante.
Agregação e agrupamento
Para agregar resultados, selecione a opção de menu Resumir. Isto alterna um conjunto de caixas de seleção para cada coluna da tabela de dados de destino. Escolha um método de sumarização adequado para cada coluna.
- Agrupar por
- Soma
- Mínimo
- Máximo
- Primeiro
- Último
- Contagem
- Contagem (incluindo nulos)
- Média
- Desvio padrão
- Desvio padrão da amostra
- Desvio padrão da população
- Variância
- Variância da amostra
- Variância da população
- Avançado sem Agrupar por
Para uma utilização avançada do mapeador de dados, como expressões, limpeza e constantes, consulte Utilização avançada do Data Mapper
Filtros de dados de driver
Seção intitulada “Filtros de dados de driver”
Para permitir a máxima flexibilidade, existem filtros de dados disponíveis nos dados de origem e nos dados de destino. Em conjuntos de dados maiores, pode ser especialmente vantajoso filtrar linhas na origem, para que as restantes operações sejam executadas sobre um conjunto de dados mais pequeno.
Selecionar subconjunto de dados
Este tipo de filtro permite filtrar os dados de origem recebidos com base nas condições especificadas.
Aplicar filtro secundário aos dados de resultado
Este tipo de filtro permite aplicar um filtro aos dados de resultado depois de transformados, com base nas condições especificadas. A possibilidade de aplicar um filtro ao resultado transformado permite exclusões com base nos resultados de cálculos complexos, sumarizações ou funções de janela.
Divisão final da tabela de dados (limite)
A capacidade de divisão de linhas permite limitar as linhas do conjunto de resultados com base num intervalo e num ponto de partida.
Sintaxe de filtros
A sintaxe de filtros utiliza o Python SQLAlchemy, que é a mesma sintaxe das outras expressões.
Consulte exemplos e funções de expressão na área Expressões.
Exemplos
Seção intitulada “Exemplos”Exemplo 1
Seção intitulada “Exemplo 1”Tabela de valores a alocar
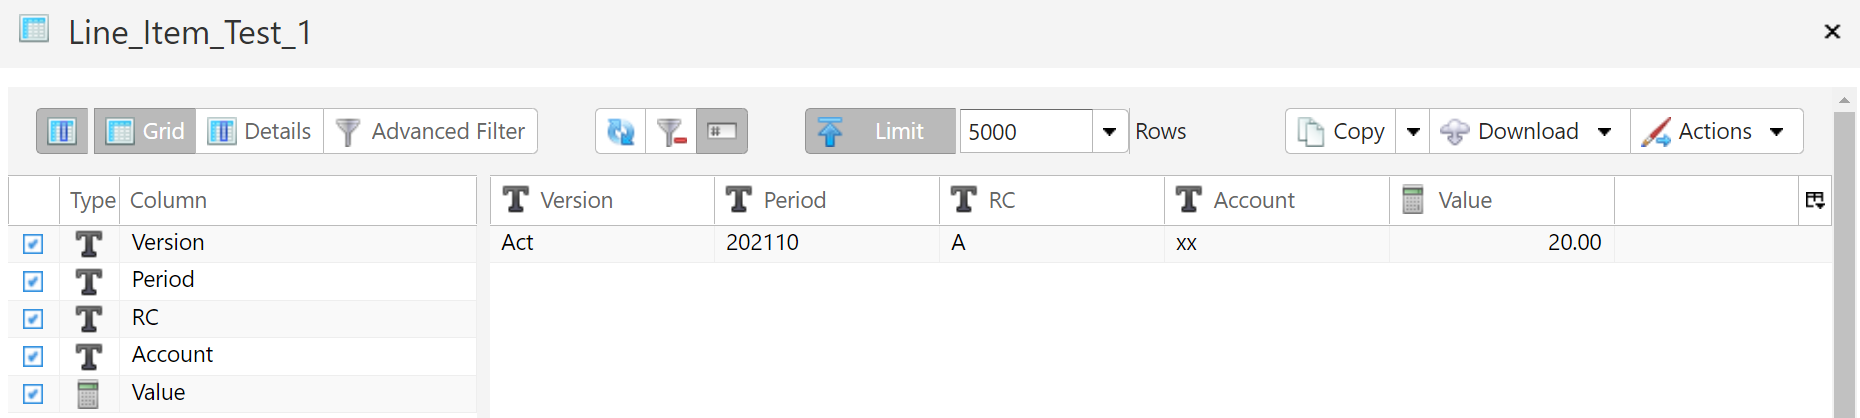
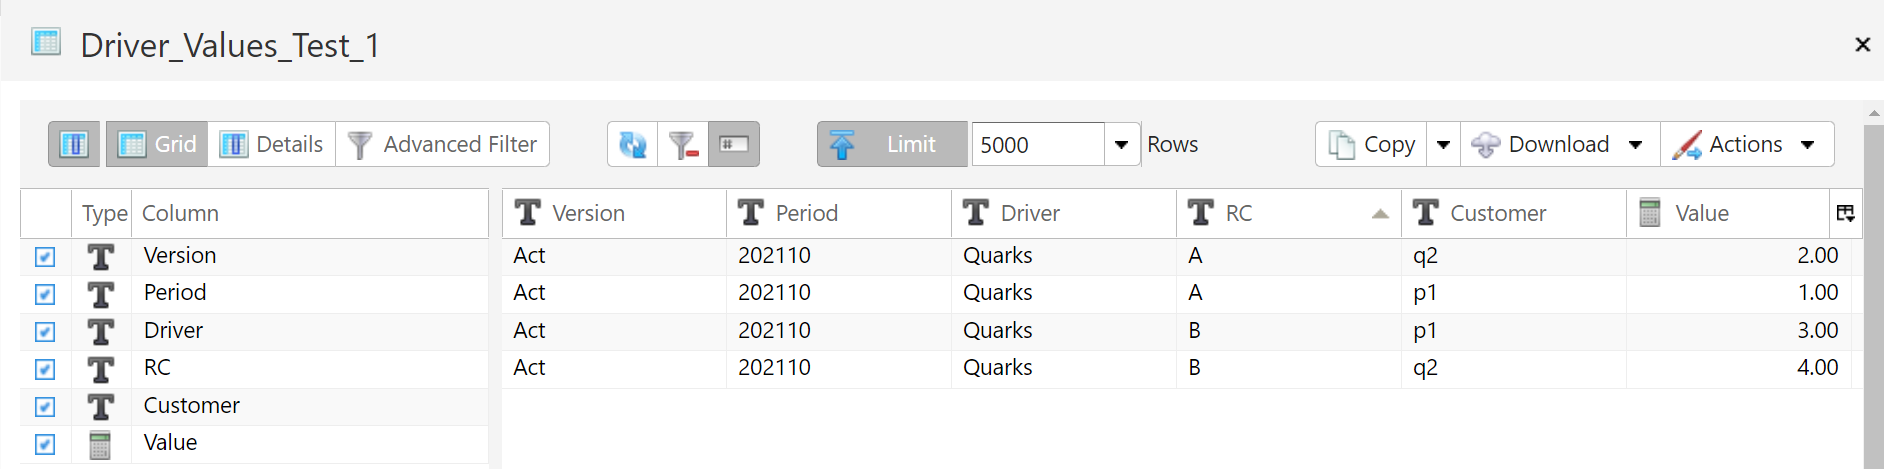
Tabela de dados de driver
Hierarquia da dimensão de atribuição
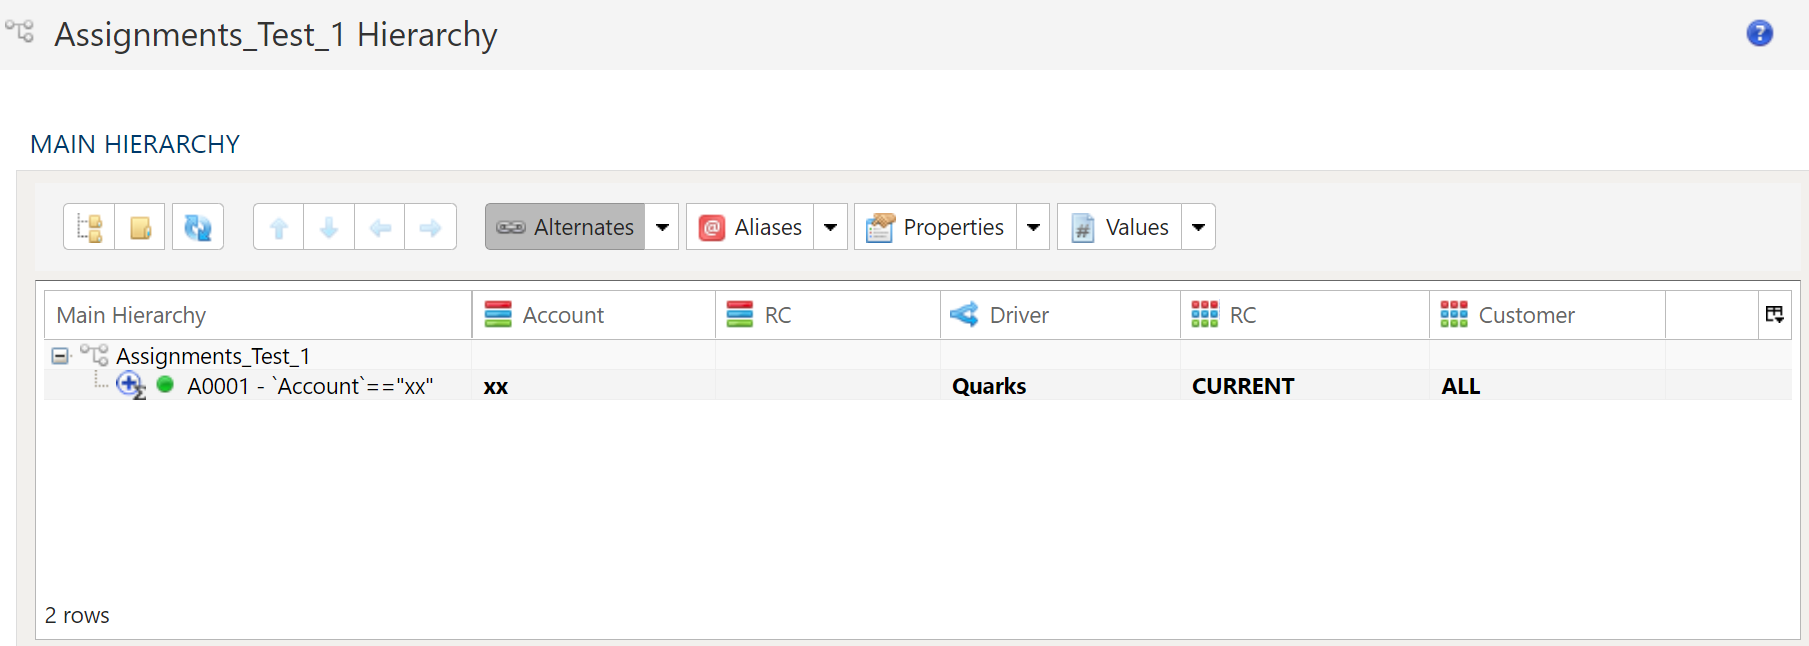
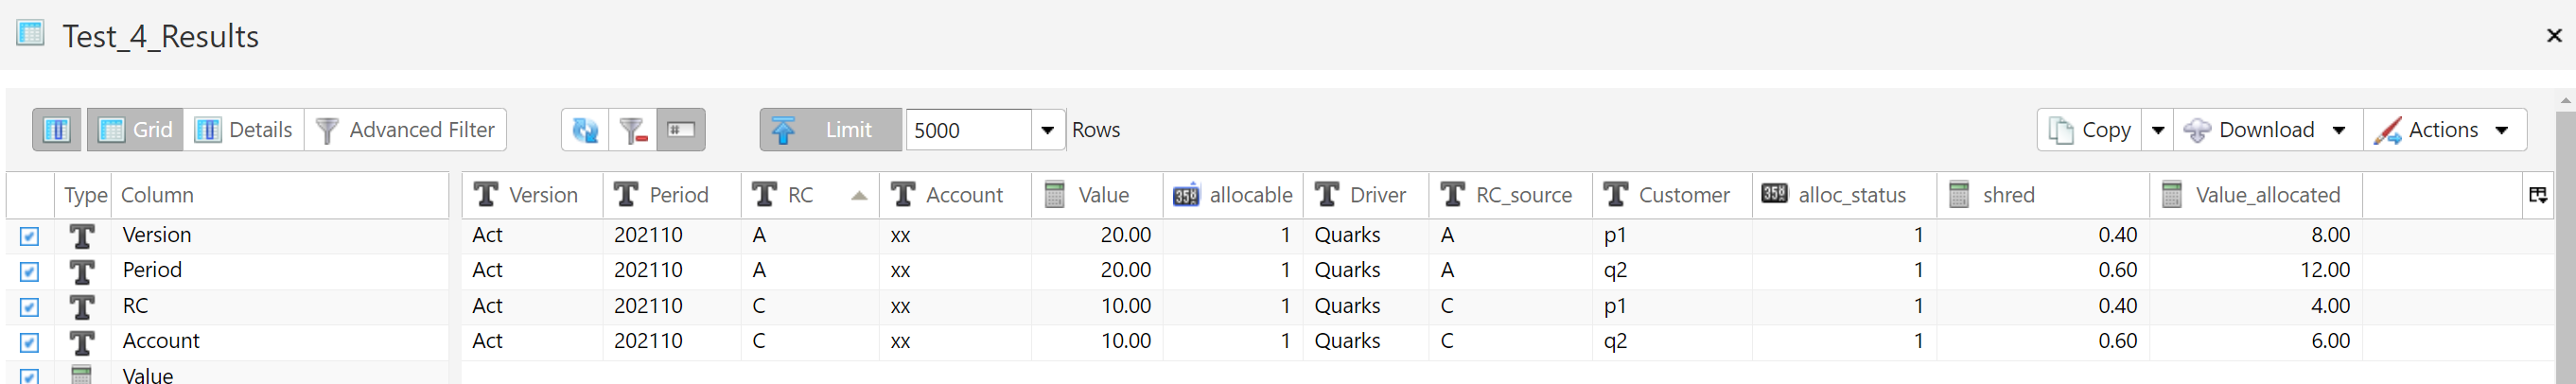
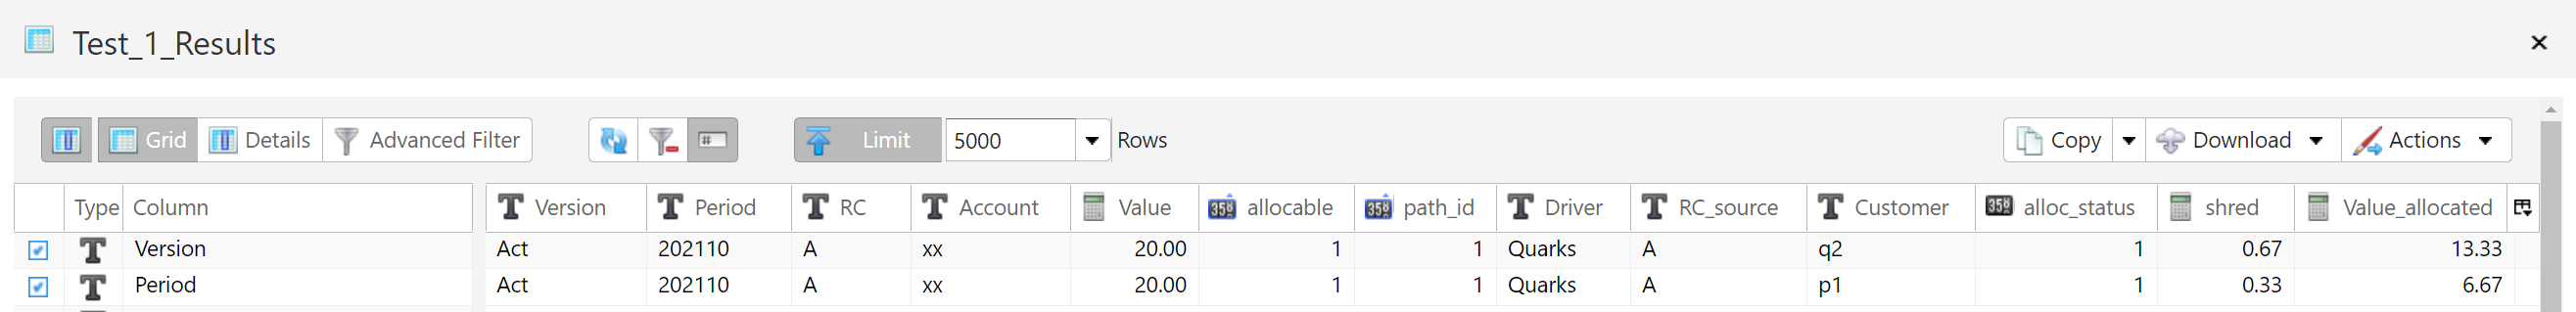
Como a dimensão Target RC está definida como Atual, os dados do indutor serão filtrados pelos valores de Source RC na Tabela de valores a alocar. Como o único valor em Source RC é “A”, só serão utilizados no passo de alocação os registos de valores do indutor em que RC = A.
Tabela de resultados da alocação
Exemplo 2
Seção intitulada “Exemplo 2”Tabela de valores a alocar
Tabela de dados de driver
Hierarquia da dimensão de atribuição
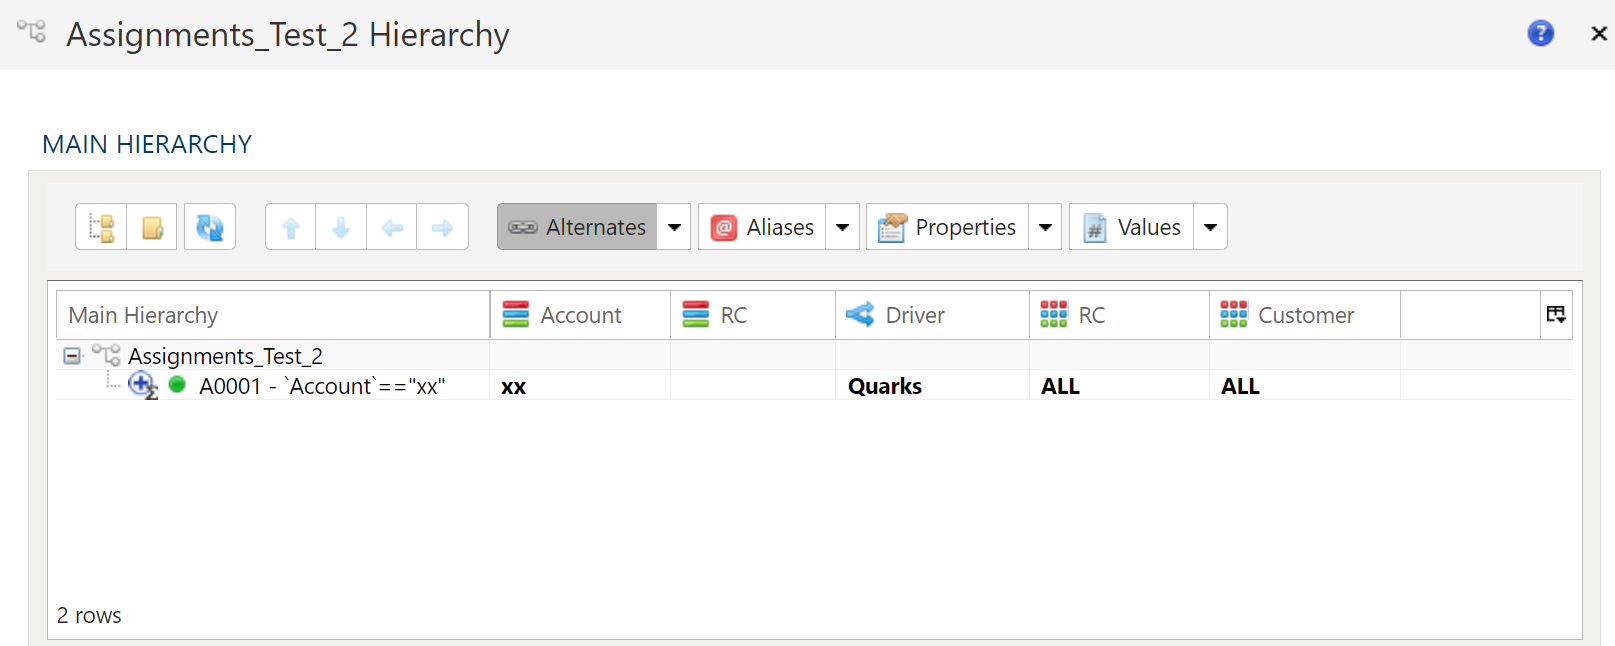
Como a dimensão Target RC está definida como Todos, os dados do indutor incluirão todos os valores de RC, como pode ver na coluna RC da Tabela de resultados da alocação.
Tabela de resultados da alocação
Exemplo 3
Seção intitulada “Exemplo 3”Tabela de valores a alocar
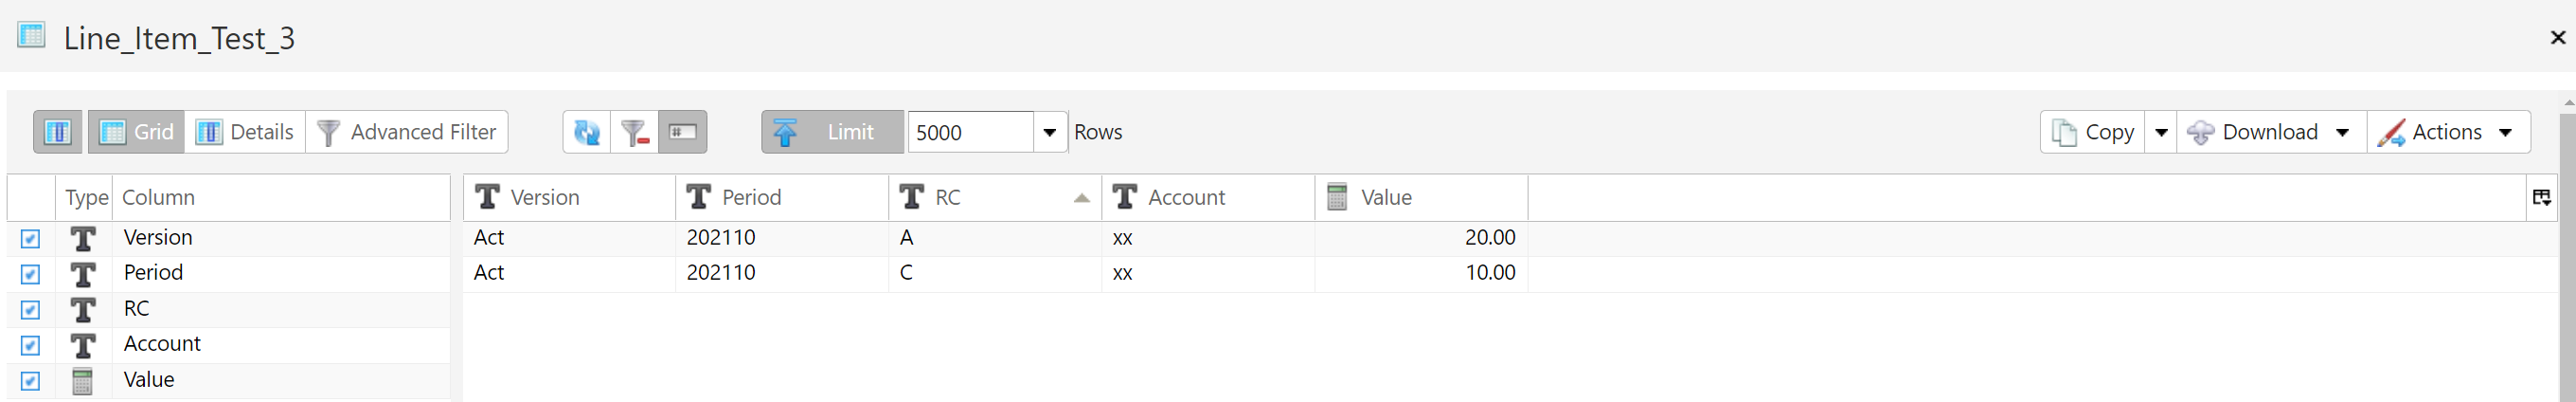
Tabela de dados de driver
Hierarquia da dimensão de atribuição
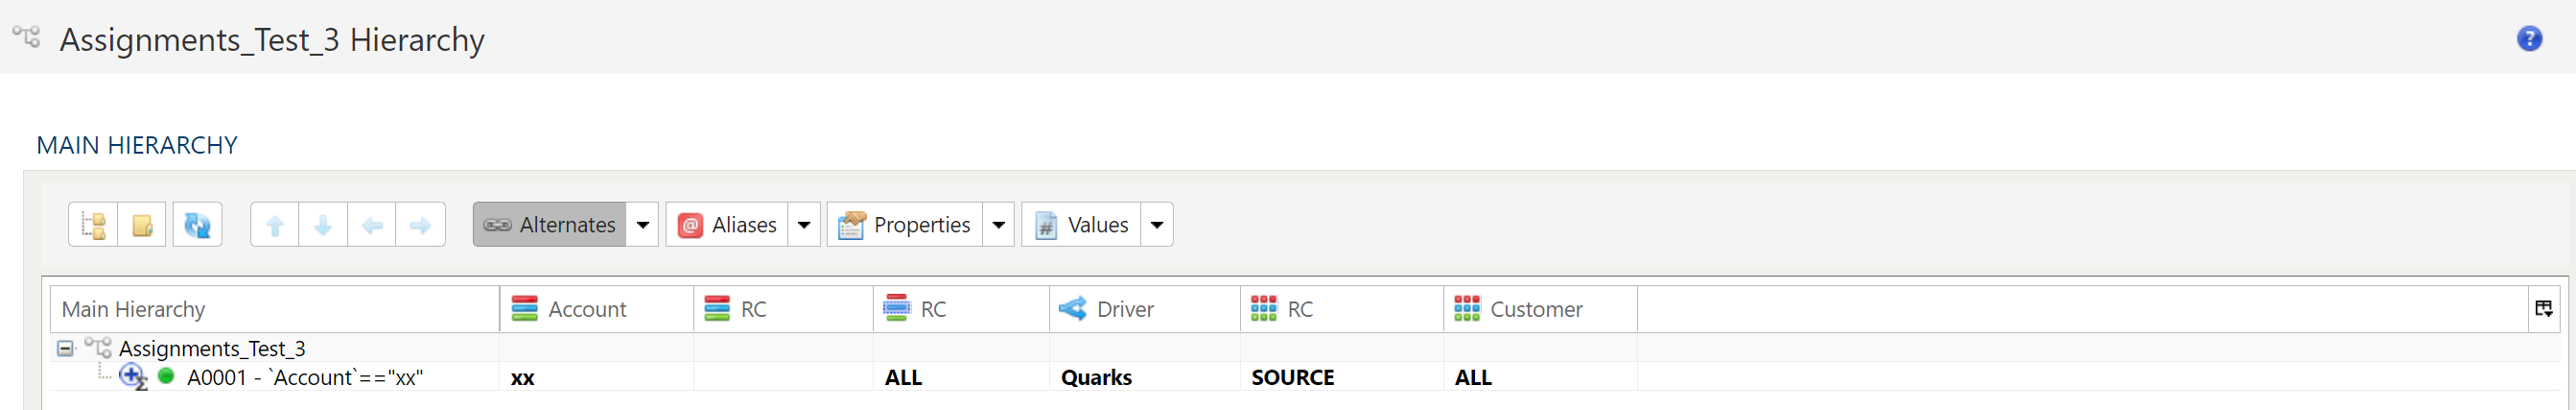
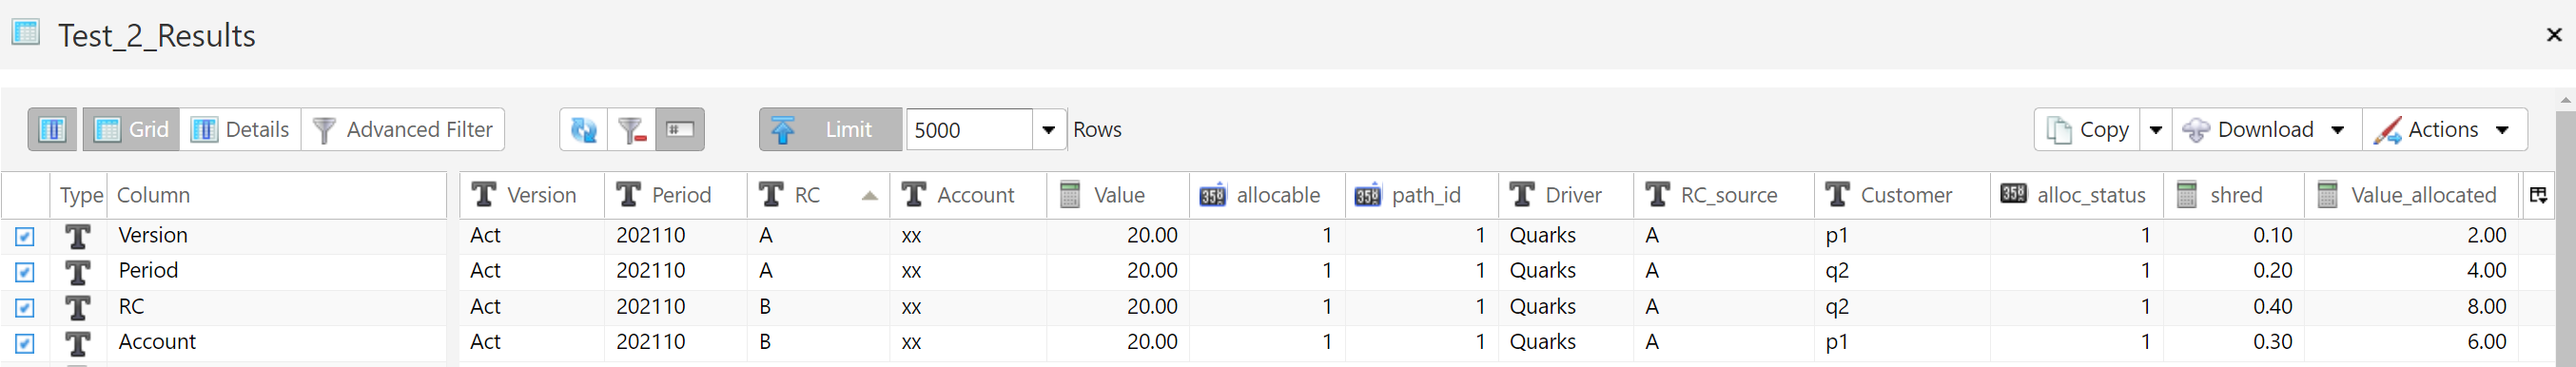
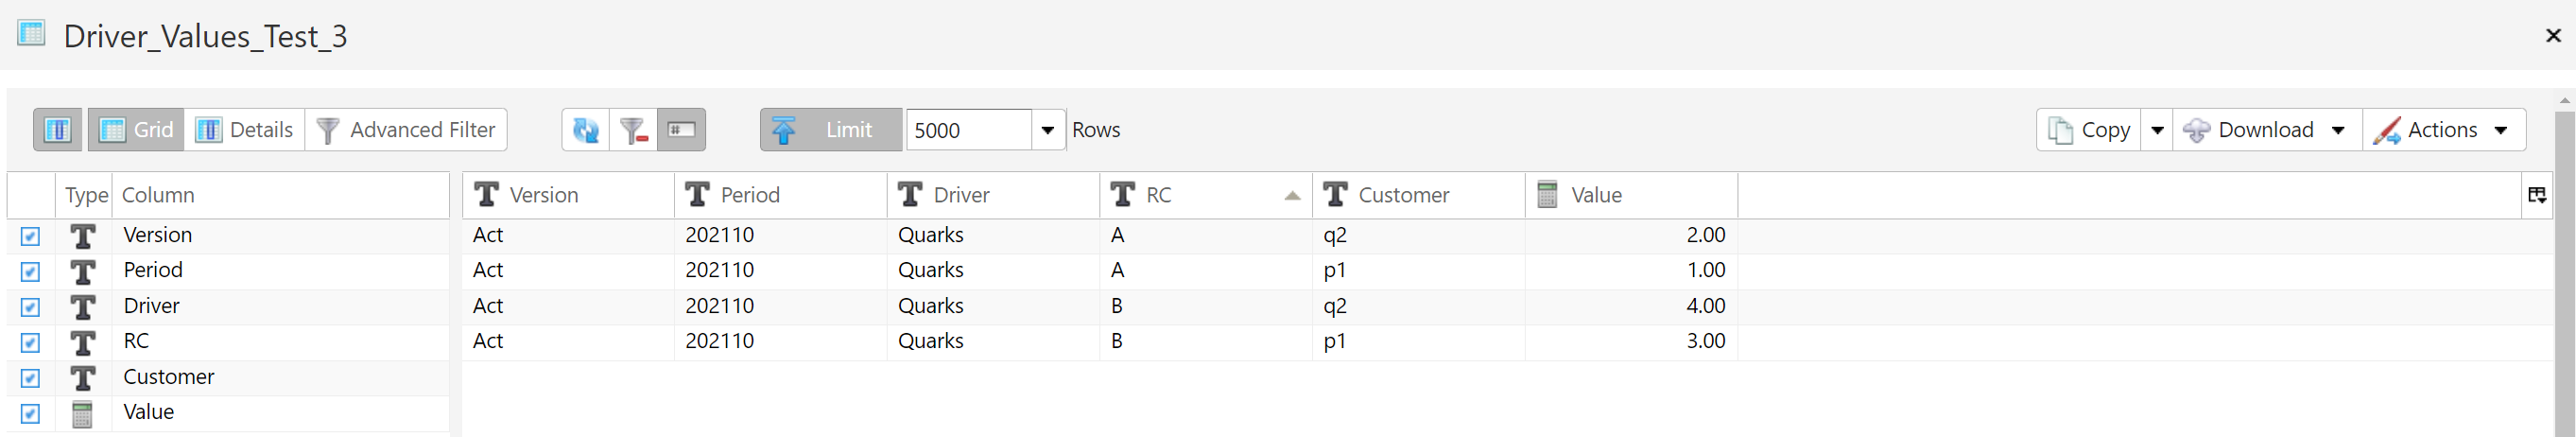
Com Context RC definido como Todos e Target RC definido como Origem, os dados do indutor incluirão todos os RC dos dados do indutor. O Context RC substitui a definição de Target RC.
Tabela de resultados da alocação
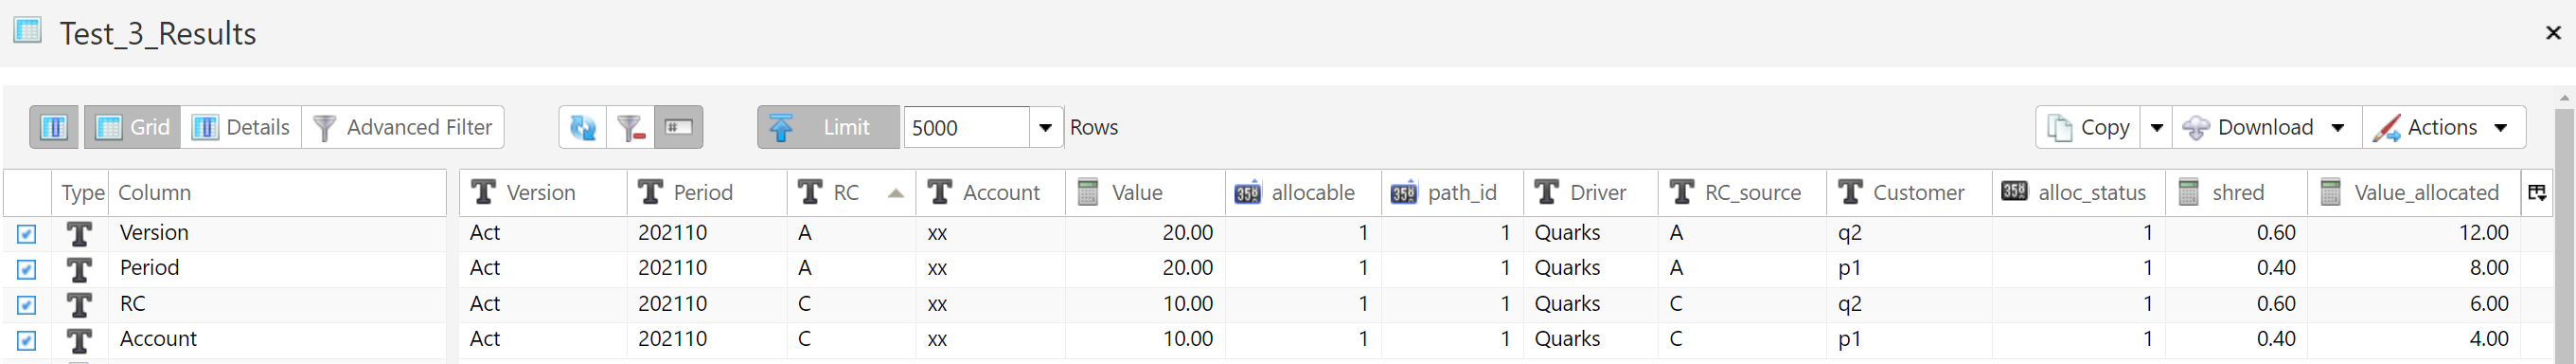
Exemplo 4
Seção intitulada “Exemplo 4”Tabela de valores a alocar
Tabela de dados de driver
Hierarquia da dimensão de atribuição
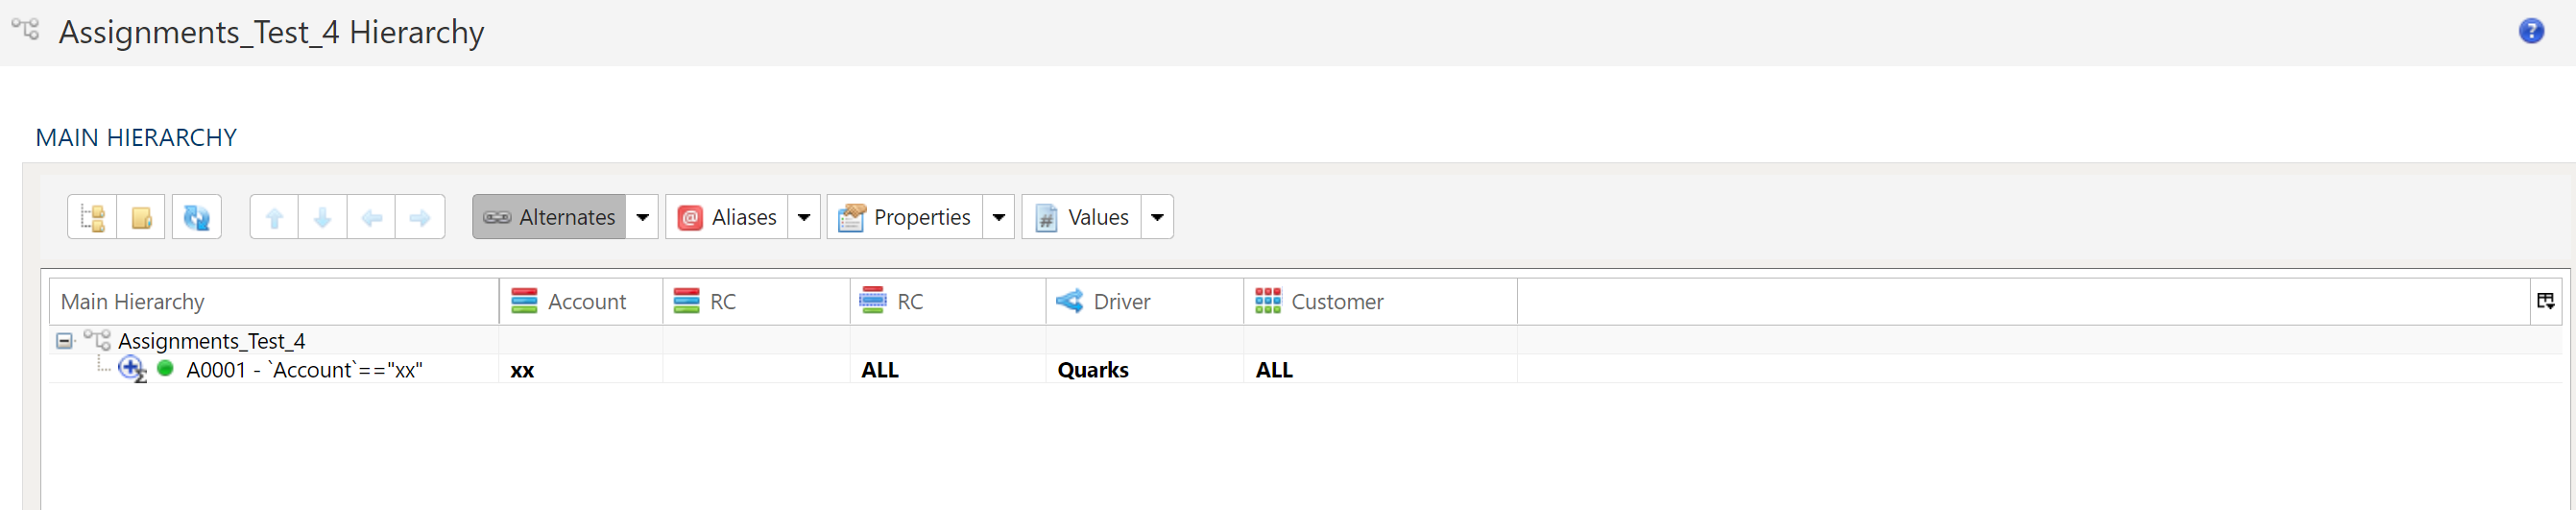
Com Context RC definido como Todos, os dados do indutor incluirão todos os RC dos dados do indutor.
Tabela de resultados da alocação