

Etapa Table Pivot
Descrição
Seção intitulada “Descrição”Usada para converter tabelas de dados longas e estreitas em tabelas de dados curtas e largas. As colunas selecionadas são transpostas, com os nomes das colunas convertidos em valores em várias colunas.
Talvez o exemplo mais fácil de entender seja pensar em uma tabela de dados com os meses listados como linhas:
Pivotar essa tabela de dados converteria todas as linhas de meses em colunas.
Month se tornam as colunas Jan/Feb, o inverso de Melt.Ao especificar quais colunas transpor e quais deixar como estão, isto se torna uma ferramenta poderosa. Fazer essa conversão em outras ferramentas de ETL poderia exigir uma dúzia de etapas a mais.
Parâmetros de origem e destino
Seção intitulada “Parâmetros de origem e destino”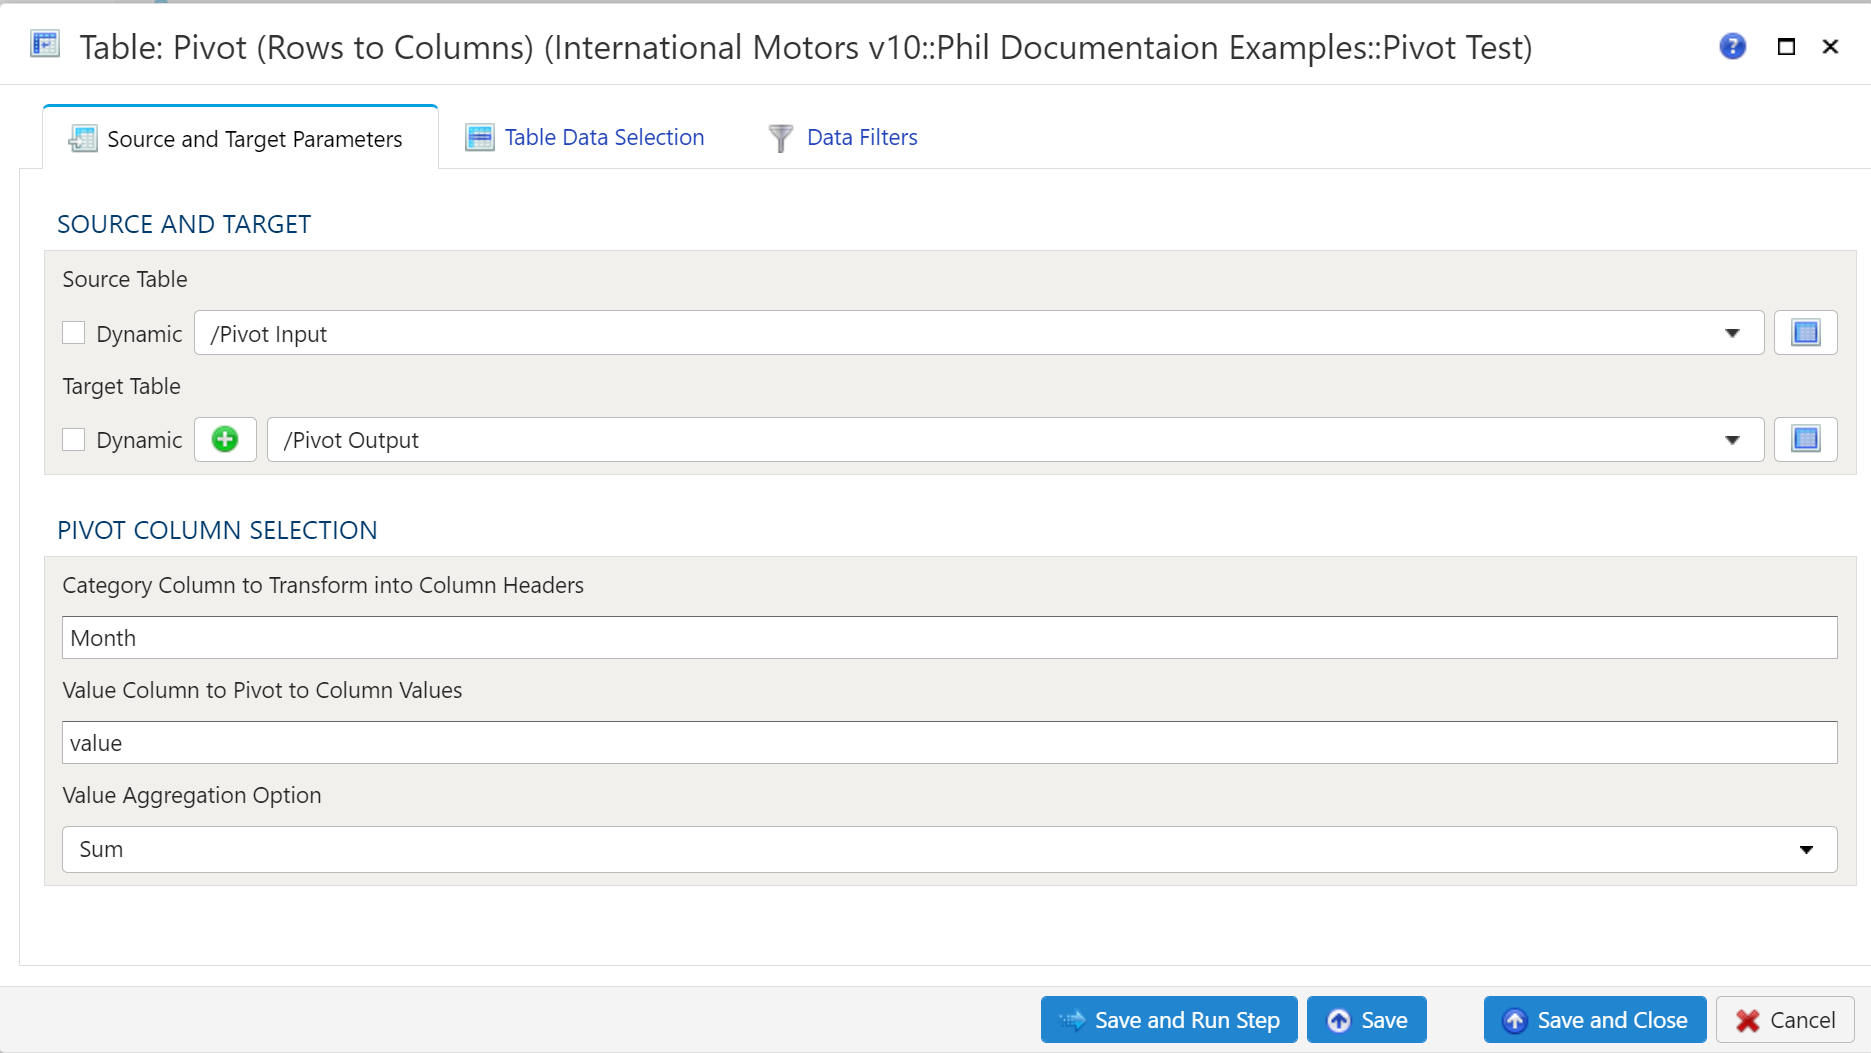
Seleção da tabela de origem
Seção intitulada “Seleção da tabela de origem”Para estabelecer a origem e o destino, primeiro selecione a tabela de dados da qual extrair usando o menu suspenso.
Quando a etapa é executada
As etapas Table Extract, Table Lookup, Table Inner Join, Table Cross Join, Table Outer Join, Table Anti Join, Junção de várias tabelas, Table Union Distinct, Table Union All, Table Pivot, Table Melt, Table In-Place Delete, Table Upsert e Table Append verificam suas tabelas de origem quando são executadas, antes de gravar qualquer coisa. A verificação compara a consulta que a etapa montou com cada tabela de origem como ela está naquele momento:
- Uma coluna que a etapa lê e que a tabela não tem, uma chave de junção que a tabela não tem ou que não está nas colunas de origem da etapa, ou uma tabela de origem que a etapa lê e que não foi construída interrompe a etapa. Um único erro nomeia todos os problemas, cada um com a sua própria correção. Uma tabela de destino que já existia permanece como estava, e uma que a etapa precisou criar fica vazia.
- Uma coluna que a etapa lista, mas não lê, e que a tabela não tem mais, gera um aviso. A etapa é executada sem ela.
- Table Union Distinct e Table Union All são a exceção para uma tabela de origem que não foi construída: elas a deixam de fora, sem aviso, e combinam as demais, como antes. Se nenhuma das tabelas de origem tiver sido construída, elas terminam com um aviso em vez de falhar.
Uma etapa cujo destino é uma visão apenas cria a visão, portanto as colunas e as chaves de junção que ela lista são verificadas em relação às suas tabelas somente quando o warehouse se recusaria a criar essa visão de qualquer forma. Nos demais casos, apenas uma tabela de origem que não foi construída ou uma chave de junção que a etapa não lista a interrompe, e nenhum aviso é adicionado.
Sempre que possível, o erro nomeia a etapa que constrói uma tabela e, quando a tabela tem uma coluna cujo nome é parecido com o de uma coluna ausente, por exemplo uma que difere apenas na caixa das letras, ele nomeia essa coluna também.
Seleção da tabela de destino
Seção intitulada “Seleção da tabela de destino”Tabela de destino

Para definir a tabela de destino, selecione uma tabela existente na lista suspensa Tabela de destino ou clique no sinal verde “+” para criar uma nova tabela como destino.
Criação de tabela
Ao criar uma nova tabela, você pode criá-la como Visão ou como Tabela.
Visões:
As visões são úteis porque o tempo necessário para executar uma etapa é bem menor do que quando se usa uma tabela. A desvantagem das visões é que elas não são úteis para explorar dados no modo Detalhes da tabela.
Tabelas:
Ao usar uma tabela como destino, a etapa leva mais tempo para ser executada, mas a exploração de dados no modo Detalhes é muito mais rápida do que com uma visão.
Seleção de colunas do pivô
Seção intitulada “Seleção de colunas do pivô”A Coluna de categoria a transformar em cabeçalhos de coluna é onde você especifica a coluna da Tabela de origem que será pivotada para linhas. A Coluna de valor a pivotar em valores de coluna é a coluna que contém os valores na Tabela de origem. A Opção de agregação de valores é onde você especifica como quer que os dados sejam agregados.
Ambas as colunas devem estar entre as colunas de saída da etapa na guia Colunas. Caso contrário, o salvamento é recusado, por exemplo com A coluna de categoria ‘month’ não é uma das colunas de saída da etapa.
O formulário também tem estes campos:
- Coluna com a posição de cada categoria (
column_order): uma coluna de origem que contém a posição de cada categoria. As colunas pivotadas vêm em ordem crescente dela, em vez de ordenadas por nome. Ela não é agrupada nem gravada. - Modelo de nome das colunas dinâmicas (
column_name_template): nomeia cada coluna pivotada por este texto, com{value}substituído pelo valor da categoria, como{value}+Sum.
Seleção de dados da tabela
Seção intitulada “Seleção de dados da tabela”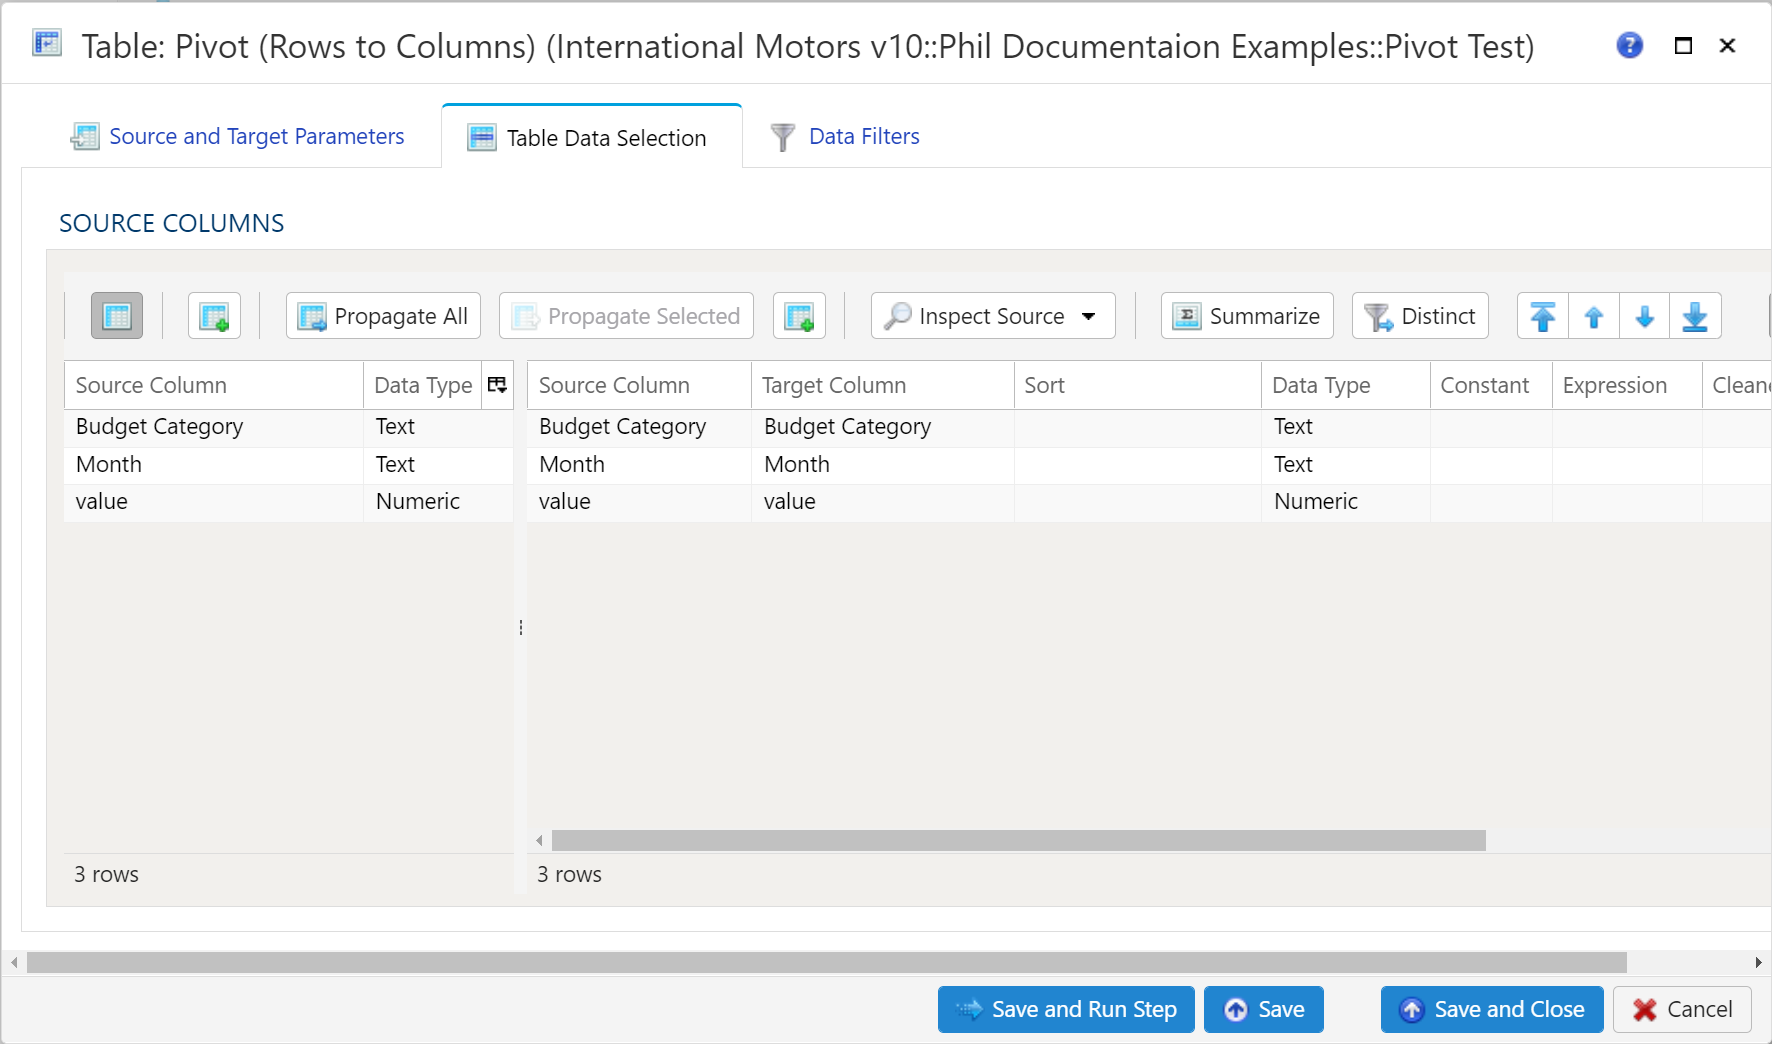
A guia Seleção de dados da tabela é usada para mapear colunas da tabela de dados de origem para a tabela de dados de destino. Todas as colunas de origem no lado esquerdo da janela são mapeadas automaticamente para a tabela de dados de destino representada no lado direito da janela. Usando o botão de menu Inspecionar origem, há algumas maneiras adicionais de mapear colunas da origem para o destino:
- Preencher ambas as tabelas de mapeamento: propaga todos os valores da tabela de dados de origem para a tabela de dados de destino. Este é o padrão.
- Preencher somente a tabela de mapeamento de origem: mapeia todos os valores somente na tabela de dados de origem. É útil ao modificar um fluxo de trabalho existente quando a estrutura de colunas de origem mudou.
- Preencher somente a tabela de mapeamento de destino: propaga todos os valores somente para a tabela de dados de destino.
Além de cada uma dessas opções, cada escolha oferece a capacidade de pré-visualizar os dados de origem.
Salvar com uma tabela de origem escolhida, mas sem colunas de origem ou sem colunas de destino, preenche o lado vazio a partir da origem, como faria Preencher ambas as tabelas de mapeamento.
Se as opções de colunas de origem e de destino não forem suficientes, outras colunas podem ser adicionadas à tabela de dados de destino de várias maneiras diferentes:
- Propagar tudo insere todas as colunas de origem na tabela de dados de destino, quer já existissem ou não.
- Propagar selecionadas insere somente as colunas de origem selecionadas.
- Clique com o botão direito no lado do destino e selecione Inserir linha para inserir uma linha imediatamente acima da linha atualmente selecionada.
- Clique com o botão direito no lado do destino e selecione Anexar linha para inserir uma linha na parte inferior (extrema direita) da tabela de dados de destino.
Para excluir colunas da tabela de dados de destino, selecione as colunas desejadas, clique com o botão direito e selecione Excluir.
Para reorganizar as colunas na tabela de dados de destino, selecione as colunas desejadas, clique com o botão direito e selecione Mover para o início, Mover para cima, Mover para baixo ou Mover para o final.
Para retornar apenas opções distintas, selecione a opção de menu Distintos. Isso alterna um conjunto de caixas de seleção para cada coluna da origem. Basta marcar qualquer caixa ao lado da coluna correspondente para retornar apenas resultados distintos.
Para agregar resultados, selecione a opção de menu Resumir. Isso alterna um conjunto de caixas suspensas para cada coluna da tabela de dados de destino. As seguintes opções de resumo estão disponíveis:
- Agrupar por (definido como padrão)
- Soma
- Mínimo
- Máximo
- Primeiro
- Último
- Contagem
- Média
- Mediana
- Moda
- Desvio padrão
- Variância
- Produto
- Valor absoluto
- Quantil
- Assimetria
- Curtose
- Desvio absoluto médio
- Soma cumulativa
- Mínimo cumulativo
- Máximo cumulativo
- Produto cumulativo
Filtros de dados
Seção intitulada “Filtros de dados”Para permitir a máxima flexibilidade, os filtros de dados estão disponíveis nos dados de origem e nos dados de destino. Para conjuntos de dados maiores, pode ser especialmente benéfico filtrar linhas na origem para que as demais operações sejam realizadas em um conjunto de dados menor.
Selecionar subconjunto de dados
Seção intitulada “Selecionar subconjunto de dados”Qualquer expressão Python válida é aceita para definir o subconjunto dos dados. Consulte Expressões
para mais detalhes e exemplos.
Aplicar filtro secundário aos dados do resultado
Seção intitulada “Aplicar filtro secundário aos dados do resultado”Qualquer expressão Python válida é aceita para definir o subconjunto dos dados. Consulte Expressões para mais detalhes e exemplos
Fatiamento final da tabela de dados (limite)
Seção intitulada “Fatiamento final da tabela de dados (limite)”Para limitar os dados, basta marcar a caixa Aplicar fatiador de linhas e depois especificar o seguinte:
- Linhas iniciais a ignorar: linhas de dados a ignorar (a linha de cabeçalho das colunas não entra na contagem)
- Terminar na linha: última linha de dados a incluir. Isso é diferente de simplesmente contar linhas no final para descartar